

Тестирование и обеспечение качества данных в Greenplum
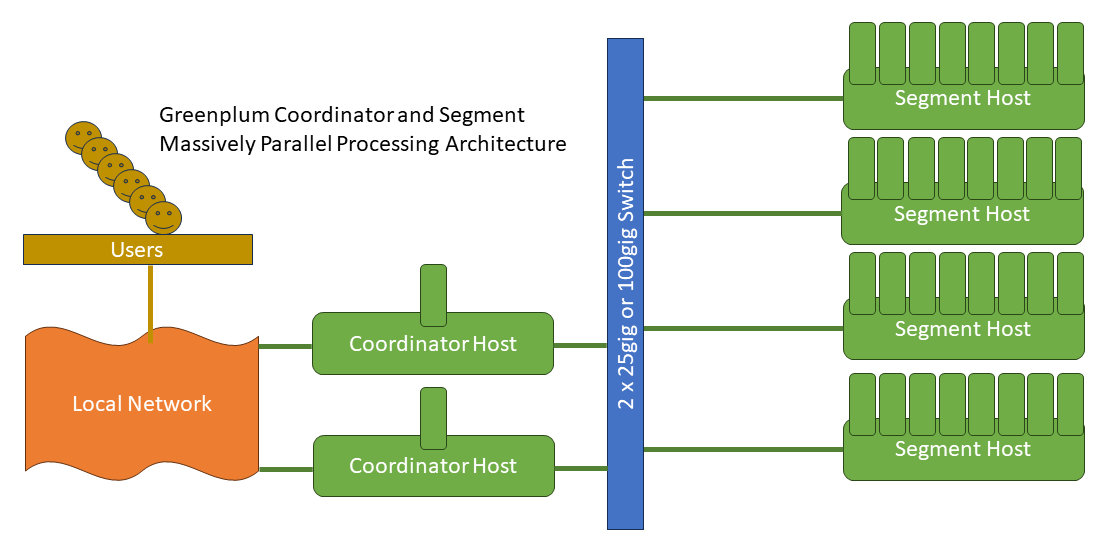
Качество данных является критическим фактором успешной цифровой трансформации. В контексте Greenplum, где данные распределены по сегментам и обрабатываются в massively parallel processing архитектуре, даже мелкие дефекты на входе могут перерасти в серьезные проблемы на витрине данных и в аналитических моделях. Эффективная стратегия тестирования требует архитектурной дисциплины, строгой валидации на каждом этапе ELT-процесса, а также автоматизации мониторинга и уведомлений. Данная глава фокусируется на архитектуре тестирования, фреймворках валидации, интеграции инструментов и практиках внедрения в конкретные сценарии построения ETL, витрин и аналитических моделей.
Мы рассмотрим, как организовать цикл обеспечения качества в условиях Greenplum: от профилирования данных и определения ограничений до контроля целостности и регрессионного тестирования, включая примеры практических SQL-запросов и концептуальные паттерны интеграций с внешними инструментами тестирования данных.
- Архитектура обеспечения качества данных в Greenplum: слои, роли и взаимодействие тестирования и мониторинга.
- Типы тестирования данных в контексте ELT-процессов: unit, integration, regression и performance тесты.
- Инструменты и паттерны интеграции: выбор и внедрение фреймворков тестирования данных, orchestration и CI/CD для данных.
- Практические кейсы: тестирование входных данных, трансформаций и витрин данных, а также регламент операционной готовности.
Архитектура обеспечения качества данных в Greenplum
Эффективная архитектура тестирования качества формирует несколько взаимосвязанных слоев: источники данных и staging, слой валидации и проверок, витрина данных и аналитические модели, а также инфраструктура мониторинга и аудита. В контексте Greenplum ключевые принципы следующие:
- Разделение обязанностей: staging-площадка подготавливает данные и обеспечивает первичные проверки, DW-слой - консолидацию и агрегацию, витрины - готовые для анализа. Версия данных и связанные метаданные должны храниться в едином каталоге качества (data quality catalog).
- Прозрачность и воспроизводимость: тестовые наборы должны быть реплицируемыми, тесты - детерминированными, а результаты - доступными через дашборды или отчеты для заинтересованных сторон.
- Контрольная точка качества на каждом этапе: профилирование данных и декларативная валидация на входе, тесты трансформаций и согласованности между staging, core-dw и витринами.
- Мониторинг и оповещение: интеграция с gpperfmon/gpmon и внешними инструментами мониторинга для своевременного обнаружения отклонений по метрикам качества, латентности и свежести данных.
- Левередж на данные и lineage: метаданные тестов и результаты должны поддерживать трассируемость данных по источнику, трансформациям и целевым витринам.
На практике это означает создание набора повторяемых сценариев тестирования, которые автоматически выполняются при каждом изменении данных в ETL/ELT-пайплайне или при развороте новых версий витрин. В Greenplum это достигается за счет тесной интеграции между слоями хранения, планирования запросов и инструментами для тестирования данных.
-- Пример простого теста на полноту данных по таблице staging.orders
SELECT
  'order_id' AS column_name,
  100.0 * SUM(CASE WHEN order_id IS NOT NULL THEN 1 ELSE 0 END) / COUNT(*) AS completeness_percentage
FROM staging.orders;
- Этот пример демонстрирует базовую проверку полноты. В реальной системе следует автоматизировать вычисление полноты по набору ключевых столбцов и сравнение с заданными порогами. Такой подход легко масштабируется на сотни столбцов во множестве таблиц через динамические скрипты или профильные таблицы качества.
Важно помнить, что архитектура тестирования не ограничивается только проверками на уровне таблиц. Она охватывает стратегию профилирования (чтобы знать статусы колонки, распределения значений и пропуски), стратегию валидации (какой набор ожиданий применим к конкретной таблице и стадии загрузки), а также методику мониторинга (как и что сигнализировать командам об отклонениях).
Типы тестирования данных и их применение
Эффективная практика обеспечивает всестороннюю проверку качества на разных уровнях ELT-процесса. Ниже выделены ключевые типы тестирования и подходы к их реализации в Greenplum.
- Unit-тесты трансформаций: проверки промежуточных результатов внутри ETL-скриптов или таблиц промежуточных вычислений. Цель - подтвердить корректность логики и отсутствие побочных эффектов. Обычно реализуются на уровне отдельных трансформаций с простыми входами и ожидаемыми выходами.
- Интеграционные тесты: проверяют согласованность данных между несколькими таблицами и слоями (staging → core_dw → витрины). Задача - обнаружить несогласованности, дубликаты, пропуски и нарушения бизнес-правил, которые возникают только в связке нескольких объектов.
- Регрессионные тесты: фиксируют конкретные сценарии, которые когда-либо приводили к ошибкам, и следят за тем, чтобы новые изменения не вернули проблему. В контексте Greenplum регрессионные тесты особенно важны при рефакторинге трансформаций или изменении схем витрин.
- Тесты полноты и валидности данных: проверяют, что данные соответствуют бизнес-правилам (например, набор значений в диапазоне, допустимые коды статусов, отсутствие нулевых значений там, где они недопустимы).
- Тесты производительности и латентности качества: оценивают, что тестируемые сценарии не приводят к деградации времени загрузки, обработки или обновления витрин при росте объема данных.
Стратегическая важность заключается в том, чтобы тесты были не просто формальными проверками, а частью управляемого процесса качества: тестовые наборы должны эволюционировать вместе с бизнес-правилами и структурой витрин. В идеале тесты должны быть заявлены в виде спецификаций качества (explicit quality specs), которые потом автоматически выполняются в CI/CD среде и регистрируются в каталоге качества.
## Пример интеграционного теста через SQL для проверки уникальности ключа в витрине
SELECT key_id, COUNT(*) AS cnt
FROM dw.fact_sales
GROUP BY key_id
HAVING COUNT(*) > 1;
Этот запрос служит детектором дубликатов в ключах витрины. В реальности набор подобных тестов должен быть частью автоматизированного регрессионного набора, выполняемого после каждого этапа загрузки.
Инструменты и паттерны интеграции
Для практической реализации тестирования качества данных в Greenplum применяют сочетание декларативных тестов, скриптов на языке высокого уровня и инструментов оркестрации. Ниже описаны ключевые паттерны и инструменты.
- Фреймворки для описания тестов: Modern data quality фреймворки позволяют формализовать ожидания по данным и автоматически исполнять их против БД. Среди наиболее известных - Great Expectations и Deequ. Эти инструменты дают возможность декларативно задавать ожидания по колонкам, строкам, диапазонам значений и уникальности, а затем интегрировать результаты в дашборды и CI/CD.
- Оркестрация и CI/CD: для устойчивости процессов тестирования необходима интеграция с Airflow, Dagster или аналогичной системой оркестрации. Распределение задач между стадиями загрузки, валидацией и публикацией витрин упрощает управление качеством и обеспечивает своевременную реакцию на дефекты.
- Интеграция с метаданными и lineage: хранение результатов тестов и связей между источниками, трансформациями и витринами облегчает аудит и восстанавливает traceability данных. Метаданные качества могут храниться в каталоге данных или внутреннем хранилище тестовых артефактов.
- Примеры инструментов:
- Great Expectations: декларативное описание ожиданий, поддержка различных источников данных, интеграция с CI/CD.
- Deequ: модульная, масштабируемая система тестирования в JVM-окружении, полезна для парсинга больших данных и проверки правил.
Подача практики может выглядеть так: определить набор тестов в виде Expectation Suites, затем открыть чекпойнты (checkpoints) для регулярной проверки данных. В CI/CD-пайплайне выполнение тестов должно блокировать прогресс, если тесты не проходят, и регистрировать причины отклонения.
## Иллюстративный пример интеграции Great Expectations
## (упрощенная иллюстрация, реальные сценарии требуют конфигурации контекста GE)
from great_expectations.dataset import SqlAlchemyDataset

class OrdersDataset(SqlAlchemyDataset):
    @property
    def expectations_suite_name(self):
        return "staging.orders_suite"

    def _validate(self):
        self.expect_column_values_to_not_be_null("order_id")
        self.expect_column_values_to_not_be_null("customer_id")
        self.expect_column_values_to_be_between("order_date", "2020-01-01", "2030-12-31")

## В реальном пайплайне запускается через чекпоинт в Airflow или Dagster
С точки зрения архитектуры, ключевой задачей является выбор баланса между декларативностью тестов и функциональностью, необходимой для оперативного реагирования на аномалии. В Greenplum следует учитывать параллелизм и распределение: тесты должны быть устойчивыми к распределению данных и не обременять планировщик избыточной синхронизацией.
Метрики качества данных и мониторинг
Эффективная система мониторинга качества данных строится на понятных и измеримых метриках. Ниже приведены базовые категории метрик, которые чаще всего применяются в контексте Greenplum и крупномасштабных ELT-процессов.
- Полнота (completeness): доля непустых значений по ключевым столбцам и полям измерений. Вовлеченные столбцы обычно выдерживаются в виде требования пороговых значений (например, > 99.95% заполненности).
- Валидность (validity): соответствие значений допустимым доменам и бизнес-правилам (диапазоны дат, коды статусов, ограничения по диапазонам).
- Уникальность (uniqueness): отсутствие дубликатов по ключевым идентификаторам или сочетаниям ключей.
- Согласованность (consistency): корректность ссылок между таблицами (межтабличные внешние связи, отношение между фактами и измерениями).
- Точность (accuracy): сравнение с источником истины или с агрегированными репликатионными зеркалами.
- Актуальность/своевременность (timeliness): насколько данные отражают актуальное состояние бизнеса, измеряемое через ближайшее время обновления и задержки загрузок.
- Цельность lineage (lineage traceability): возможность проследить путь данных от источников до витрин через все стадии трансформаций.
Таблица ниже иллюстрирует базовую схему метрик и пример их измерения.
| Метрика | Описание | Как измерять | Пороговые значения |
|---|---|---|---|
| Полнота | Доля не-null значений в критических столбцах | SQL-запросы по колонкам, агрегированные по таблицам | > 99.95% |
| Валидность | Соответствие бизнес-правилам | Проверки диапазонов, списков допустимых значений | 95-100% соответствия |
| Уникальность | Без дубликатов по ключам | Группировки по ключам с HAVING COUNT(*) > 1 | 0 дубликатов |
| Актуальность | Временная свежесть данных | Максимальное значение даты обновления в таблицах | freshness < определённое пороговое время |
| Согласованность | Корректность связей между таблицами | Checks по внешним ключам/relationship-соглашениям | 100% согласованности |
Пример мониторинга по времени обновления и живых строк:
SELECT
  table_schema,
  table_name,
  max(last_load_ts) AS last_load_ts
## FROM information_schema.tables
JOIN staging.load_history ON staging.load_history.table_name = information_schema.tables.table_name
GROUP BY table_schema, table_name;
Помимо SQL-метрик, рекомендуется внедрить дашборды в BI или в системы мониторинга (например, Grafana) поверх метаданных тестов и логов исполнения пайплайнов. В Greenplum эффективна ставка на операторскую видимость: сбор статистики через gpmon/gpperfmon, использование системных представлений pgstat* и расширенная аналитика по ним. Такая аналитика позволяет оперативно выявлять «узкие места» в загрузке, аномальные распределения в данных и задержки, которые влияют на качество витрин.
Практические сценарии тестирования в контексте ETL и витрин данных
Разработка тестирования должна быть тесно связана с реальными сценариями работы: загрузка данных из источников, трансформации, аккумулирование и публикация витрин. Ниже приведены наиболее типичные сценарии и соответствующие подходы.
- Сценарий 1: Проверка целостности после загрузки в staging. Необходимо подтвердить, что все данные из источников попали в staging без потери значений и с корректными типами.
- Сценарий 2: Валидность после трансформации. Убедиться, что бизнес-правила применены корректно, например, расчеты полей выверены и не приводят к неожиданным значениям.
- Сценарий 3: Дубликаты и срез витрин. Обнаружение дубликатов по ключам витрины и исключение нежелательных повторений в итоговой витрине.
- Сценарий 4: Согласованность между слоями. Удостовериться в соответствии агрегатов между staging и core DW и между витриной и источниками измерений.
- Сценарий 5: Регрессионные проверки после изменений кода трансформаций. Любые изменения должны сопровождаться запуском полного набора тестов.
-- Нахождение дубликатов по ключу витрины
SELECT key_id, COUNT(*) AS cnt
FROM dw.fact_sales
GROUP BY key_id
HAVING COUNT(*) > 1;

-- Проверка соответствия между staging и DW по датам обновления
SELECT s.table_name, MAX(s.load_ts) AS max_staging_load, MAX(d.load_ts) AS max_dw_load
## FROM staging.load_history s
JOIN dw.load_history d ON s.table_name = d.table_name
GROUP BY s.table_name;
Эти примеры иллюстрируют базовые проверки, которые следует автоматизировать и включать в регламент тестирования. В реальной практике они дополняются профилированием распределения, тестами на пропуски в критических столбцах, валидацией форматов данных и проверки на бизнес-правила на уровне каждой витрины.
Регламент внедрения и операционная готовность
Качество данных не может быть достигнуто за счет единичной проверки и разовой линейки тестов. Необходим систематизированный подход к внедрению и эксплуатации тестирования. Рекомендованы следующие принципы:
- Shift-left: тестирование качества начинается на стадии проектирования трансформаций и моделирования витрин. Это ускоряет обнаружение ошибок и снижает стоимость исправлений.
- Интеграция в CI/CD: каждое изменение в ETL/ELT пайплайнах должно запускать набор тестов, результаты сохраняются в каталоге качества и дают обратную связь разработчикам.
- Регламент тестирования: документированный набор тестовых сценариев, порогов, частоты выполнения и критериев приемки для каждой витрины и слоя данных.
- Управление данными тестирования: использование синтетических, а затем синхронно обновляемых тестовых наборов данных, чтобы обеспечить независимость от живого источника и защиту данных.
- Оповещение и эскалация: автоматические уведомления при нарушении порогов, с указанием источника, конкретной таблицы и типа нарушения.
- Архитектура аудита: хранение истории тестов, их результатов и изменений в тестовых сценариях для регуляторных и аудиторских целей.
Интеграция с конкретными инструментами возможна следующим образом:
- Great Expectations позволяет декларативно описывать ожидания и автоматически запускать их в пайплайне.
- Deequ обеспечивает масштабируемое тестирование на уровне данных через JVM-процессы и может быть полезен при интеграции с крупными потоками данных на стыке ETL и аналитических моделей.
- Инструменты оркестрации (Airflow, Dagster) позволяют запланировать и контролировать выполнение тестов на разных стадиях пайплайна, а также регистрировать результаты в централизованном хранилище.
Key takeaways
- Качество данных в Greenplum требует архитектурного подхода с разделением слоев: staging, DW и витрины, а также центра качества данных.
- Эффективная стратегия тестирования включает unit, integration и regression тесты, а также мониторинг полноты, валидности, уникальности и согласованности.
- Инструменты тестирования, такие как Great Expectations и Deequ, помогают формализовать ожидания и автоматизировать проверки в CI/CD.
- Мониторинг и атрибутивная аналитика по данным позволяют быстро обнаруживать отклонения и поддерживать актуальность витрин.
- Регламент внедрения и shift-left подход снижают стоимость исправлений и повышают устойчивость пайплайнов.
- Важно обеспечить трассируемость данных (data lineage) и хранение тестовых артефактов для аудита и регуляторных требований.
- Обязательно поддерживать последовательность между тестированием данных и бизнес-правилами, чтобы витрины действительно отражали нужный бизнес-контекст.
FAQ
- Что такое качественные тесты в контексте Greenplum и чем они отличаются от обычных unit-тестов?
- Качественные тесты в этом контексте проверяют не только корректность отдельных трансформаций, но и целостность данных на уровне нескольких слоев (стадия staging, core DW и витрины). Они включают проверки доменных ограничений, уникальности, согласованности между таблицами и регрессионные сценарии, чтобы гарантировать, что изменения в транзакциях не приводят к некорректности витрин. Unit-тесты остаются важными для отдельных трансформаций, но их недостаточно в условиях распределенной архитектуры Greenplum без дополнительных интеграционных проверок.
- Какие типы инструментов лучше использовать для обеспечения качества данных в Greenplum?
- Рекомендованы инструменты, которые позволяют декларативно задавать ожидания по данным и интегрируются с CI/CD, например Great Expectations для описания чеков и тестов, Deequ для JVM-оптимизированных сценариев и интеграции в крупные пайплайны. В качестве оркестрации можно использовать Airflow или Dagster для планирования выполнения тестов и фиксации результатов, а также gpmon/gpperfmon для мониторинга производительности и состояния системы.
- Как организовать тестовые данные без риска нарушения живых данных?
- Используется стратегия тестирования на разделяемых средах: staging и development с синтетическими данными, которые соответствуют реальному распределению, а затем перенос в production-подобную среду только после прохождения полного набора тестов. Необходимо поддерживать тестовые наборы с обновлением и синхронизацией по мере роста бизнес-правил. Удаление тестовых данных должно происходить в рамках безопасных процедур.
- Какие ключевые метрики стоит включать в дашборд мониторинга качества?
- Полнота, валидность, уникальность, согласованность, актуальность и регрессионная стабильность. В дополнение к ним полезны метрики freshness данных, латентности загрузки и средний размер ошибок тестирования. Важно показывать тренды по времени и сигналы тревоги на отклонения от порогов.
- Как организовать регрессионные тесты в CI/CD?
- Определить набор бизнес-правил и тестовых сценариев, которые должны проходить после каждого изменения трансформаций и схем витрин. Эти тесты должны быть изолированы, воспроизводимы и иметь четкую дефиницию порогов. Результаты тестирования следует сохранять в каталоге качества и использовать для автоматической блокировки диплопмента или выпуска в зависимости от статуса тестов.
- Какие риски возникают при неправильной конфигурации верификации в Greenplum?
- Основные риски: ложные срабатывания или пропуск реальных аномалий, чрезмерная нагрузка тестов на систему, задержки в пайплайне из-за неэффективной организации тестирования. В целях минимизации необходимо подбирать разумные пороги, оптимизировать SQL-запросы тестов и параллелизировать их по сегментам.
- Какой подход к версии тестов рекомендуется использовать?
- Версионирование тестов должно быть синхронно с версиями трансформаций и витрин. Это обеспечивает возможность воспроизведения дефектов по конкретной версии пайплайна и упрощает аудит. Внесение изменений в тестовые сценарии следует сопровождать ревью и документированием причин изменений.
- Какие ограничения следует учитывать при использовании ограничений (constraints) в Greenplum для обеспечения качества?
- В Greenplum ограничения, ориентированные на целостность данных, не всегда обеспечиваются столь же полно, как в однопроцессорной PostgreSQL, из-за распределенной архитектуры. Поэтому тесты и внешняя валидация остаются необходимыми. Ограничения NOT NULL и CHECK могут быть полезны на уровне схемы, но следует рассматривать их как дополнение к выставлению тестов, а не как основной механизм обеспечения качества.
- Как обеспечить трассируемость качества данных в витринах?
- Включить в процесс качественные тесты, которые фиксируют исходные источники и трансформации, а также результаты тестов. Сохранение метаданных тестов, версий скриптов и артефактов тестирования в едином каталоге качества упрощает аудит и регуляторную работу.
- Какие сценарии следует разворачивать в первую очередь при старте проекта?
- Начать с набора базовых тестов на полноту и уникальность в ключевых витринах, затем добавить проверки согласованности между staging и DW, а позже - регрессионные сценарии и мониторинг. По мере роста данных и бизнес-словаря тесты должны эволюционировать, расширяя coverage на новые витрины и новые трансформации.
Эта глава обеспечивает целостное понимание того, как проектировать, внедрять и эксплуатировать систему тестирования и обеспечения качества данных в Greenplum. Подход сочетает архитектурную дисциплину, декларативные тесты, автоматизацию и мониторинг с целью создания устойчивой и предсказуемой среды для ETL, витрин и аналитических моделей.


