

Polars с нуля: термины DataFrame, LazyFrame, Series и Expr
Polars - это высокопроизводительная библиотека для анализа данных на Rust с привязками к Python. Ее ключевые идеи - колоночное представление данных, эффективная память, векторизованные вычисления и ленивое выполнение запросов. В этой главе мы детально разберем базовую терминологию и архитектурные принципы, которые позволяют Polars достигать высокой скорости на реальных наборах данных: DataFrame, LazyFrame, Series и Expr. Понимание этих понятий необходимо для эффективного построения аналитических конвейеров и грамотной инвестиции времени в оптимизацию запросов.
В рамках данной главы рассматриваются не только определения терминов, но и их взаимосвязи и практическое применение в сценариях обработки больших датасетов. Особое внимание уделяется тому, как ленивое выполнение и выражения (Expr) позволяют отказаться от предварительной загрузки и повторной фильтрации данных, повысив эффективность как в пилотных проектах, так и в продукционных пайплайнах.
- Что такое DataFrame и как он связан с Series
- Что дает ленивое выполнение через LazyFrame и зачем нужны Expr
- Как архитектура Polars влияет на производительность и интеграцию с экосистемой Python
Краткое содержание главы
- Определения и взаимосвязи DataFrame, Series, LazyFrame и Expr
- Архитектура Polars: колоночное хранение, память и план выполнения
- Этапы построения запросов: от выражения к плану выполнения и исполнению
- Практические паттерны использования: от простых операций к сложным конвейерам
- Вопросы совместимости и миграции с другими инструментами анализа данных
Введение в концепции Polars
Polars строится на фундаменте колонарного хранения. Каждый DataFrame состоит из набора столбцов, где каждый столбец представлен как отдельно хранящаяся векторная структура типа Series. Этот подход, во-первых, снижает карусель памяти при операциях над выборками, и, во-вторых, упрощает применение SIMD-операций и векторизации. В Polars основное ядро реализовано на Rust, а Python-обертка обеспечивает удобное API на языке высокого уровня. Взаимодействие между слоями реализуется через понятия DataFrame и Series, которые, в контексте Polars, являются развернутыми представлениями колонок и их типов данных.
Ключевые преимущества такой архитектуры заключаются в возможности:
- эффективного распределения данных по памяти: каждый столбец независимо обрабатывается векторизированно;
- реализации оптимизаций на уровне конвейеров обработки: фильтрации и проекции выполняются на уровне планов;
- упрощения параллелизма: операции над столбцами легко распараллошиваются без кросс-операций между строками.
Понимание различий между eager- и lazy-циклами выполнения становится критичным в условиях больших данных. В Polars операции над DataFrame по умолчанию являются eager-подходом - изменения применяются и данные проходят через стек операторов немедленно. Однако значительная часть вычислений может быть переведена в ленивый режим через LazyFrame, что открывает возможности для глобальных и локальных оптимизаций запроса до фактического исполнения.
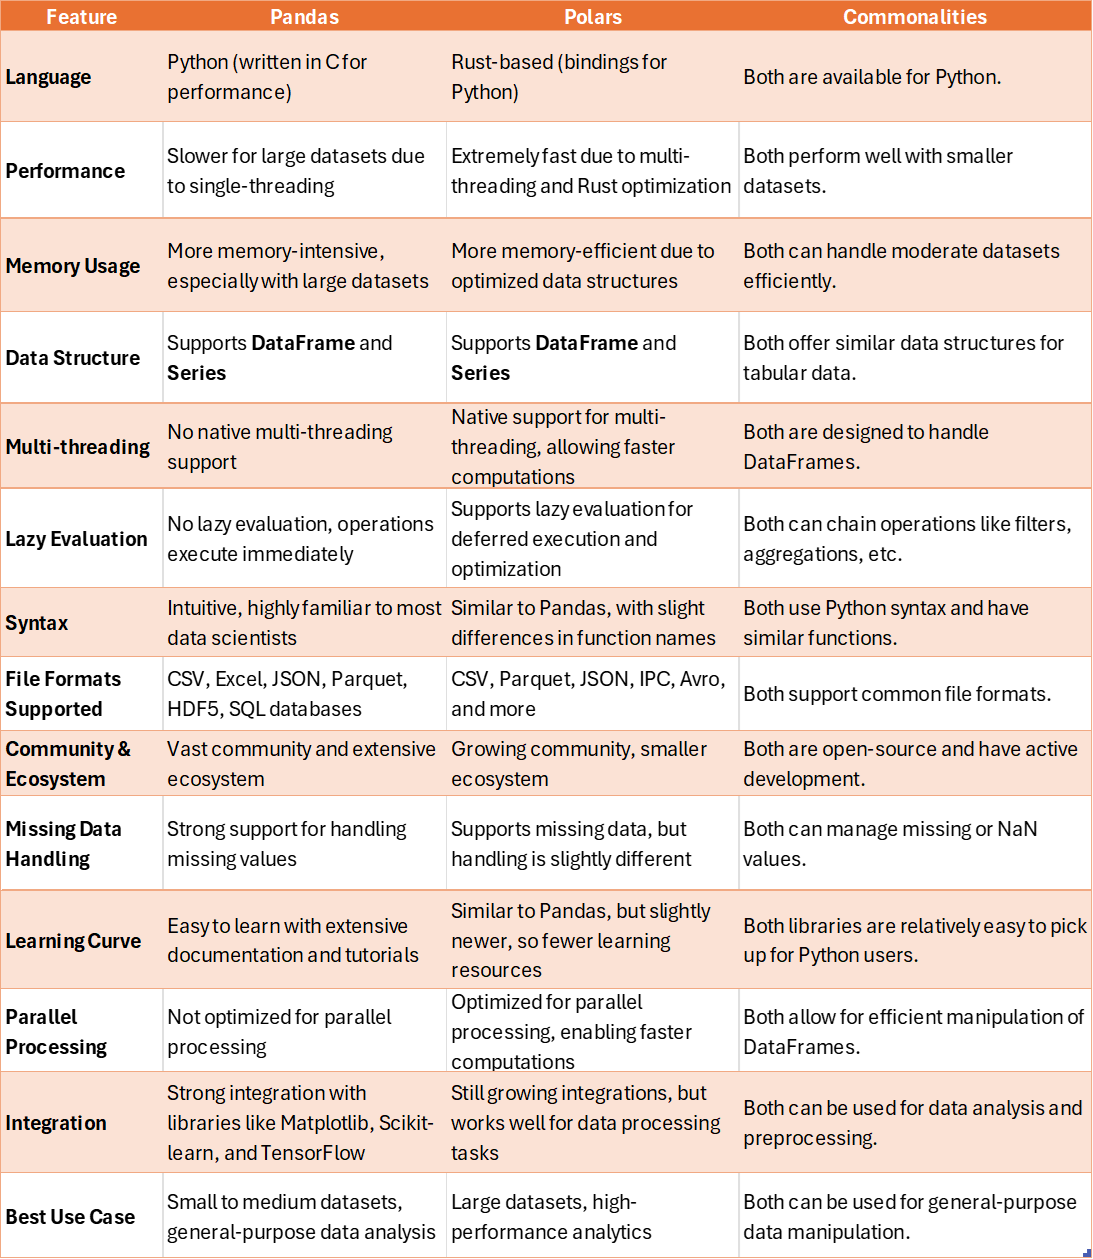
DataFrame: структуры данных и операции
DataFrame в Polars - это упорядоченная коллекция столбцов, где каждый столбец реализован как Series. Series представляет собой одномерный вектор значений фиксированного типа. Совокупность столбцов совместно образует двумерную таблицу, где каждое значение в строки соответствует позиционной индексации внутри каждого столбца. Важной особенностью является то, что DataFrame не требует физического дополняющего порядка между столбцами во время выполнения методов; изменения происходят через операции над столбцами и их схемами.
Архитекурная особенность DataFrame состоит в том, что большинство трансформаций реализуется через операции над столбцами: фильтрация, агрегации, склейка и ранжирование выполняются векторизованно, с использованием механизмов SIMD и переходов через Arrow-форматы памяти. Это обеспечивает высокую пропускную способность и меньшую накладную стоимость на копирование данных.
Некоторые характерные аспекты:
- каждый столбец имеет свой dtype и хранится отдельно, что упрощает локализацию вычислений и повышает кэш-эффективность;
- операции над DataFrame чаще всего выражаются через композицию операций над Series;
- совместимость с Apache Arrow облегчает обмен данными между системами и сторонними инструментами.
Пример типичной операции над DataFrame в старте проекта - выборка и вычисление новой колонки. В рамках этого раздела следует помнить, что в eager-режиме данные обрабатываются немедленно, без откладывания вычислений на потом. В реальных конвейерах такие операции часто приводят к множеству промежуточных копий памяти, что негативно сказывается на производительности. Для снижения таких издержек критически важно уметь распознавать моменты, когда перевод в ленивый режим и последующая оптимизация планов позволят улучшить загрузку процессора и память.
import polars as pl

## Создание DataFrame
df = pl.DataFrame({
    "id": [1, 2, 3, 4],
    "value": [10.0, 20.0, 30.0, 40.0],
    "flag": [True, False, True, True]
})

## Базовые операции
filtered = df.filter(pl.col("value") > 15)
selected = filtered.select(["id", "value"])
Данный пример иллюстрирует базовые операции eager-режима: создание, фильтрацию и проекцию. В реальных задачах следует рассуждать о возможности переноса этих действий в LazyFrame и применении плановых оптимизаций перед исполнением.
LazyFrame и ленивое вычисление
LazyFrame представляет собой декларативный граф трансформаций над DataFrame, который формирует выражения (Expr) и план выполнения без немедленного применения изменений. В таком режиме Polars строит дерево выражений, которое затем компилируется в оптимизированный план выполнения. Основные преимущества ленивого подхода состоят в том, что система может:
- выполнять предикатное вытягивание и проекцию на ранних стадиях конвейера;
- объединять несколько операций в единый проход над данными;
- переупорядочивать операции для минимизации затрат на чтение и перемещение данных;
- избегать создания лишних временных копий.
Expr - это строительный блок ленивых трансформаций. Большинство операций над полями DataFrame выражаются через Expr: выбор столбца, арифметика над столбцами, агрегации, логические и условные выражения, преобразования типов и многое другое. В рамках ленивого режима выражения позволяют описать полный алгоритм анализа данных до момента физического считывания и вычисления.
Важно понять, что работы с LazyFrame начинаются с перевода DataFrame в ленивую форму через вызов метода .lazy(). Далее применяются наборы выражений через API, похожий на функциональный стиль: pl.col("col_name") возвращает Expr, который можно комбинировать с операторами и методами. Итоговый план выполнения собирается и затем выполняется через .collect(), что приводит к физическому чтению данных и вычислению результатов.
Преимущества ленивого подхода особенно заметны на больших датасетах:
- снижение объема считываемых данных за счет проекции и фильтрации на раннем этапе;
- оптимизация порядка выполнения операций, что может существенно снизить общую сложность;
- возможность применения сложных цепочек выражений без явной побочной эффективности на каждом шаге.
Ключевым моментом в использовании LazyFrame является разумное формирование выражений. Пример ниже демонстрирует конструирование ленивого конвейера, который фильтрует данные по условию, проецирует нужные столбцы и добавляет новую колонку на основе существующих значений.
import polars as pl

## Исходный DataFrame
df = pl.DataFrame({
    "id": [1, 2, 3, 4],
    "value": [10.0, 20.0, 30.0, 40.0],
    "category": ["A", "B", "A", "B"]
})

## Ленивая обработка
lf = df.lazy() \
       .filter(pl.col("value") > 15) \
       .with_columns([
           (pl.col("value") * 2).alias("double_value"),
           pl.when(pl.col("category") == "A").then(1).otherwise(0).alias("is_A")
       ]) \
       .select(["id", "value", "double_value", "is_A"])

## Исполнение конвейера
result = lf.collect()
print(result)
В этом примере выражения pl.col(...) формируют выражения, которые комбинируются в цепочке методов. Финальное выполнение через .collect() приводит к созданию результирующего DataFrame. Заметим, что в ленивом режиме все фильтры и вычисления можно объединить в единый проход, что снижает накладные расходы и улучшает кэш-эффективность.
Ограничения и нюансы ленивого режима:
- не все операции доступны в виде Expr; некоторые специфичные функции реализованы через соответствующие методы пользователя;
- иногда целесообразно возвращаться к eager-режиму, если конвейер становится слишком сложной последовательностью, которая требует частых итераций и быстрой проверки промежуточных результатов;
- для сложных join-операций разумно управлять порядком сборки плана, учитывая фильтры и проекции.
Series и Expr: базовые элементы для выражений
Series - это физическое представление одной колонки данных внутри DataFrame. Это однонаправленная структура, которая хранит последовательность значений одного конкретного типа. Series служит базовой единицей, на которой строятся все выражения в Polars. В контексте LazyFrame выражения (Expr) - это функциональные строительные блоки, которые применяются к Series или наборам Series для описания трансформаций. Взаимосвязь этих понятий повторяет концепцию “колонка-ориентированного” подхода: каждый элемент в выражении работает над колонке, а итоговая агрегация формируется из комбинаций таких операций.
Expr можно рассматривать как декларативный язык запросов Polars. Он поддерживает доступ к столбцу через pl.col("название"), арифметические операции, логические условия, функции агрегации, условные выражения (if-then-else), привязку к алиасам и приведения типов. В результате комплексные вычисления могут быть построены как дерево выражений, которое затем компилируется в эффективный план.
Вот базовые примеры выражений:
- доступ к столбцу: pl.col("value")
- арифметика над столбцами: (pl.col("value") * 2) + pl.col("id")
- условные выражения: pl.when(pl.col("value") > 20).then(1).otherwise(0)
- преобразование типов: pl.col("value").cast(pl.Float32)
Эти примеры демонстрируют, как выражения позволяют абстрагироваться от конкретной реализации и сосредоточиться на логике вычислений. Когда выражения компилируются в план выполнения, Polars применяет различные оптимизации, включая:
- пропорциональное вытягивание (projection pushdown) - извлечение только необходимых столбцов;
- фильтрацию на ранних стадиях (predicate pushdown) - удаление ненужных данных до выполнения вычислений;
- упрощение выражений и устранение дубликатов операций.
Ключевые моменты по Expr:
- Expr - это декларативный конструктор вычислений над DataFrame;
- pl.col("name") - мост между физическим столбцом и логикой вычисления;
- составные выражения образуют дерево, которое затем исполняется как единый план;
- гигиена типов и приведения типов обеспечиваются на этапе выполнения.
Архитектура выполнения: от запросов к планам выполнения
Общий цикл выполнения в Polars с ленивыми конвейерами включает:
- формирование логического плана через цепочку выражений (Expr) и операций над столбцами;
- оптимизации на этапе компиляции плана, включая pushdown, упрощение выражений и переупорядочивание;
- конвертация в физический план исполнения, который учитывает доступные алгоритмы сканирования данных и агрегаций;
- выполнение физического плана и сбор результатов через collect().
Ленивый режим позволяет перенести вычисления за пределы непосредственного исполнения и позволяет аналитическим системам целостно рассчитать порядок выполнения. Это особенно важно на больших наборах данных, где неэффективная последовательность операций может привести к значительным накладным расходам.
Некоторые ключевые аспекты архитектуры выполнения:
- планирование выполняется на базе цепочки выражений, что позволяет централизованно внедрять оптимизации;
- Polars использует столбцовый подход к загрузке данных, что уменьшает объём считываемых данных и ускоряет расчет;
- интеграция с Apache Arrow ускоряет обмен данными между слоями и облегчает миграцию между системами.
Практическая иллюстрация архитектуры: при создании LazyFrame производится сборка дерева выражений, где pl.col("value") выступает узлом, а арифметические операции - их потомками. Затем план проходит через оптимизатор, который может деструктурировать выражения, исключать неиспользуемые столбцы и упорядочить выполнение так, чтобы минимизировать количество проходов над данными. Финальное исполнение запускается через collect(), которое возвращает DataFrame.
Интеграции и практическая сторона: API Python и взаимодействие с большими датасетами
Polars предоставляет удобный Python API, который абстрагирует детали реализации на Rust, сохраняя при этом высокую производительность. Взаимодействие с большой экосистемой данных реализуется через:
- прямой доступ к DataFrame и LazyFrame через понятный API, который поддерживает как eager-, так и lazy-режимы;
- совместимость с Pandas, NumPy и PyArrow, что позволяет гибко интегрировать Polars в существующие пайплайны;
- возможности чтения больших источников данных через сканированные операции и ленивые режимы чтения, которые позволяют минимизировать загрузку данных в память.
Практические паттерны использования включают:
- чтение больших csv/ Parquet файлов с lazy-подходом: scan_csv / scan_parquet с последующей фильтрацией и проекцией без загрузки всего набора;
- миграцию отдельных шагов из Pandas в Polars: переход к DataFrame-API или LazyFrame-API для ускорения критичных конвейеров;
- использование гибридного подхода: часть анализа выполняется в Polars, часть - в Pandas, с конвертацией результатов при необходимости.
Важно помнить, что выбор режима выполнения зависит от конкретного кейса: для коротких и средних наборов данных eager-режим может быть проще и быстрее за счет меньшей сложности управления планами; для больших датасетов ленивый режим обеспечивает значительную экономию памяти и вычислительных ресурсов за счет оптимизации.
Key takeaways
- DataFrame - это коллекция столбцов (Series), где каждый столбец хранится отдельно и имеет свой dtype.
- LazyFrame - декларативный конвейер выражений, который строит план выполнения и выполняет его только при вызове collect(), позволив осуществлять глобальные оптимизации.
- Expr - строительный блок ленивых трансформаций, позволяющий описать вычисления над столбцами: выбор, арифметику, агрегации, условия и приведение типов.
- Архитектура Polars обеспечивает колонарное хранение, эффективную память и преобразование планов выполнения, что критично для производительности на больших наборах данных.
- Сочетание DataFrame, LazyFrame и Expr позволяет гибко строить конвейеры: начинать с простых операций и переходить к ленивым, оптимизированным вычислениям.
- Интеграции с Python-экосистемой позволяют интегрировать Polars в существующие пайплайны и мигрировать участки кода без радикальных изменений.
- Для крупных данных ленивый режим обеспечивает значительную экономию ресурсов за счет проекции, фильтрации и оптимизации на уровне плана.
FAQ
- Чем отличается DataFrame и LazyFrame в Polars?
DataFrame - это конкретная структура данных, где операции выполняются немедленно (eager). LazyFrame - это декларативный конвейер выражений, который строит план выполнения и выполняет его только при явном вызове collect(). Это позволяет применять глобальные оптимизации и сокращать количество прочитанных данных, что особенно полезно на больших наборах.
- Что такое Expr и зачем он нужен?
Expr - это выражение, описывающее операцию над столбцом или над несколькими столбцами. Он служит строительным блоком для ленивых трансформаций: через Expr можно комбинировать выбор столбцов, арифметику, условия и приведения типов, формируя дерево вычислений, которое затем компилируется в эффективный план выполнения.
- Как начать работать с LazyFrame в реальном проекте?
Начните с преобразования DataFrame в ленивый режим через .lazy(), затем постепенно добавляйте фильтрацию, проекции и вычисления через цепочку выражений. В конце вызовите .collect() для получения результата. Такой подход позволяет минимизировать чтение данных и применить оптимизации плана.
- Какие преимущества ленивого выполнения на больших датасетах?
Основные преимущества: вытягивание только необходимых столбцов (projection pushdown), фильтрация раннего этапа (predicate pushdown), объединение нескольких операций в один проход и возможность переупорядочивания операций для снижения затрат на чтение и обработку.
- Как выражения помогают оптимизировать конвейеры?
Expr позволяют описать вычисления на уровне столбцов, что дает Polars возможность анализировать и упорядочивать операции, устранять дублирование и избегать промежуточных копий. Это критично для производительности, когда конвейер включает множество трансформаций.
- Как Polars взаимодействует с Pandas и PyArrow?
Polars предоставляет конверсию между DataFrame/Series и Pandas, а также совместим с PyArrow форматом. Это облегчает миграцию существующих пайплайнов и обмен данными между различными инструментами аналитики без потери производительности.
- Какие ограничения следует учитывать при переходе на Polars?
Не все функции и плагины из экосистемы Pandas прямо соответствуют API Polars. В некоторых случаях может потребоваться переписать часть логики на выражения или использовать eager-режим. Однако для большинства задач умение работать через DataFrame, LazyFrame и Expr позволяет достичь значительной скорости и экономии памяти.
- Как мигрировать существующий код из Pandas в Polars?
Начните с перехода на Polars DataFrame, затем постепенно переводите операции на ленивые выражения (LazyFrame) для сложных конвейеров. В ходе миграции полезно сохранить эквивалентные тесты и проверки результата, чтобы убедиться, что семантика вычислений сохраняется.
- Какие open-source или российские продукты стоит учитывать в контексте Polars?
Polars - это open-source проект на Rust с Python bindings. В контексте платформенной экосистемы полезно помнить о проектах, которые обеспечивают интеграцию с аналитикой и обработкой данных, например, Apache Arrow для общего формата памяти и обмена данными. В российской контексте разумно рассматривать локальные решения, которые обеспечивают совместимость с существующим стеком через интерфейсы PyO3-подобных оберток и поддержку локализации данных, но следует держать фокус на совместимость и стабильность API.
- Каковы реальные сценарии производительности Polars?
Типичные сценарии - обработка больших CSV/Parquet, агрегации по нескольким столбцам, сложные фильтрации и Join-операции в ленивом режиме. Практические кейсы показывают, что полярная архитектура и ленивые выражения позволяют снизить время выполнения на порядки по сравнению с экшн-ориентированными подходами, особенно при работе с тандемом фильтраций и проекций, где пропадение лишних чтений данных имеет критическое значение.


