

Планировщик запросов и движок выполнения
Потребность в эффективном планировании и исполнении аналитических запросов в StarRocks диктуется особенностями распределённой колоночной СУБД: необходимо гарантировать низкую задержку и высокую пропускную способность для больших объёмов данных, сохранить линейную масштабируемость при росте кластера и обеспечить предсказуемость исполнения. Эта глава посвящена тому, как в StarRocks реализованы планировщик запросов и движок выполнения: от семантики SQL до реальных операторов обработки данных в распределённых фрагментах, от алгоритмов оптимизации до механизмов обмена данными между узлами и сохранения данных. Особое внимание уделяется тому, почему принципы архитектуры и протоколы исполнения влияют на производительность и стабильность аналитических рабочих нагрузок.
Краткое содержание главы
- Архитектура планировщика запросов: как формируется и доводится план до исполнителей в распределённой среде.
- Модель планирования: от логического к физическому плану, роль статистики и выбор стратегий оптимизации.
- Движок выполнения: векторизированная обработка, конвейеры и распределённые фрагменты.
- Интеграции с хранением и сетью: протоколы обмена данными, взаимодействие с хранением столбцовых форматов и кэшами.
- Практические аспекты и диагностика: мониторинг, настройка, предотвращение узких мест.
Архитектура планировщика запросов
Планировщик запросов в StarRocks реализует явное разделение между парсингом, семантикой, оптимизацией и исполнением. Это разделение обеспечивает модульность и позволяет независимо развивать каждый компонент, сохраняя при этом строгие границы контрактов между этапами.
- parser и семантика. На вход поступает SQL, который сначала лексически и синтаксически обрабатывается, затем проверяется на смысловую корректность: соответствие таблицам, типам столбцов, именам функций. Роли этих компонентов - устранение неоднозначностей и приведение запроса к формату, удобному для дальнейшей обработки.
- логический план. После синтаксического анализа формируется логический план, состоящий из абстрактных операций над данными (проекция, фильтрация, агрегация, соединение и т.д.). Логический план не привязан к конкретному физическому исполнению и фокусируется на семантике запроса.
- оптимизатор. В базе применяются как эвристики, так и полноценная cost-based оптимизация. Оптимизатор использует статистику по данным (кардинальность, распределение значений, частоты встречаемости и т. п.) для оценки стоимости различных планов. В результате формируется один или несколько кандидатов физического плана.
- физический план и план-фрагменты. Физический план описывает конкретные реализации операций на физических узлах: типы сканирования, реализации join-алгоритмов, способы агрегации и упорядочения. План разбивается на фрагменты, которые могут исполняться на разных узлах кластера параллельно.
- планировщик распределения и диспетчеризация. Планировщик распределяет план по узлам, задаёт границы параллелизма и организует разнесение операций между узлами (data exchange, shuffle/broadcast и т. д.). Диспетчер следит за прогоном фрагментов, собирает результаты и возвращает их клиенту.
- исполнители и kernel-операторы. Движок исполнения реализует набор операторов (сканеры, фильтры, проекции, агрегации, сортировки, соединения, оконные функции и т. д.), выполненных векторизованно. Каждый оператор обрабатывает пакет данных - батч значений - с минимальным копированием и максимально эффективной локальной загрузкой данных в память.
Важной частью архитектуры является концепция data exchange: данные между узлами перемещаются через специально сигнальные узлы обмена, которые реализуют несколько стратегий передачи данных (shuffle, broadcast, merge) и обеспечивают согласованный процесс выполнения для всех фрагментов запроса. Это позволяет достигать высокой степени параллелизма и избегать узких мест на уровне сетевого обмена.
Компоненты планировщика и протоколы взаимодействия
- Планирования и диспетчеризации. План формируется один раз на стадии подготовки запроса и далее распределяется по фрагментам. Исполнение идёт параллельно на узлах кластера, а обмен между узлами минимизирует задержки за счёт конвейерной обработки и пакетной передачи.
- Статистика и каталог данных. Эффективность оптимизации зависит от наличия и свежести статистики: разбиения по значениям, гистограммы, частоты встречаемости и корреляции между столбцами. При отсутствии точной статистики план может быть выполнен с запасом по времени, но с меньшей эффективностью.
- Протоколы исполнения. В StarRocks реализованы надёжные и эффективные протоколы передачи данных между узлами: минимизация копирования, буферизация, последовательная загрузка батчей и детерминированные порядки выполнения. Протоколы допускают гибкую настройку параметров параллелизма и буферных размеров под конкретные нагрузки.
Модель планирования: от логического к физическому плану
Работа планировщика начинается с преобразования SQL-запроса в логический план, затем - к физическому плану, который может быть выполнен на распределённой архитектуре. Основной принцип здесь - разделение задач на три слоя: логический уровень, который описывает, какие операции необходимы, физический уровень, который задаёт конкретные реализации операций, и уровень исполнения, который обеспечивает передачу данных между узлами и реализацией операторов.
- Логический план - это declarative-представление запроса: какие операции нужно выполнить, без привязки к конкретным алгоритмам. Например: фильтрация по условию, соединение двух наборов, группировка по столбцам.
- Физический план - конкретизирует выбор алгоритмов и реализаций. Здесь планировщик выбирает такие реализации как hash-join или sort-merge join, метод агрегации (hash-агрегация или streaming-агрегация), стратегию сканирования (учёт столбцовых форматов и индексов), а также способы сортировки и оконных функций.
- Фрагментация и распределение - физический план разбивается на фрагменты, которые будут исполняться на узлах кластера. Фрагменты включают операции обработки данных на локальных участках данных и операции обмена между участниками плана (Exchange).
На этапе оптимизации критически важны несколько аспектов:
- Кардинальность и селективность. Оценка количества строк после применения фильтров напрямую влияет на выбор порядка соединения и метод агрегации.
- Применение предикатов и авто-пушдаун. Фильтры могут быть перенесены ближе к источнику данных (например, к сканеру), что позволяет уменьшить объём данных, загружаемого в память.
- Примером здесь служит создание фильтров в раннем этапе выполнения, которые затем применяются к данным под нагрузкой, снижая расход ресурсов.
- План-фрагменты и локальность. Распределение вычислений по узлам учитывает данные размещены ли в локальной памяти, какие узлы участвуют в агрегациях и как минимизировать дорогой обмен данными.
- Эвристики против затрат. В зависимости от характеристик нагрузки применяется либо эвристика, либо полноценная cost-based optimization. Часто используются гибридные подходы: быстрые эвристики для часто встречающихся паттернов и детальная оптимизация для критических операций.
## Псевдокод: упрощённый интерфейс планировщика
class LogicalPlan { /* ... */ }
class PhysicalPlan { /* ... */ }

function optimize(LogicalPlan lp) -> PhysicalPlan {
  stats = collectStatistics(lp)
  candidates = generatePhysicalPlans(lp, stats)
  best = selectBestPlan(candidates, stats)
  return best
}
Этот упрощённый пример демонстрирует идею: планировщик получает логический план, через статистику строит кандидаты физических планов и выбирает оптимальный.
Движок выполнения: конвейеры, векторизация и исполнение
Движок выполнения StarRocks реализует парадигму векторизованной обработки данных и конвейерной архитектуры, где данные обрабатываются пакетами (батчами) столбцов, а операторы образуют конвейер, через который идут непрерывные потоки данных.
- Векторизированные операторы. Каждая операция (Scan, Filter, Project, Join, Aggregate, Sort, Window и т.д.) реализуется как набор kernel-операторов, которые работают над батчами столбцовых значений. Такой подход снижает неэффективность обработки по строкам и лучше использует память и кэш.
- Конвейеры и потоковая обработка. Операторы выстраиваются в конвейер, где результат одного оператора немедленно подаётся на вход следующего. Это минимизирует промежуточное копирование и задержки, повышает локальность данных и уменьшает задержку исполнения.
- Память и сжатие. Векторная обработка требует аккуратного управления памятью: буферы под батчи, аллоцированная память под временные результаты, использование компрессии столбцов там, где это уместно, и автоматическое управление жизненным циклом данных в рамках Execution Engine.
- Распределённое исполнение. Fragment-уровень исполнения может работать локально на узле и параллельно с другими фрагментами. Обмен данными между узлами осуществляется через оптимизированные механизмы передачи данных, что позволяет поддерживать высокий уровень параллелизма и устойчивость к задержкам сети.
- Варианты агрегаций и соединений. В сценариях аналитики часто применяются hash-агрегации и hash-join, а также сортированные и оконные операции. Выбор подходящего алгоритма делается на этапе физического планирования и зависит от статистики и сортировочных требований.
Движок исполнения поддерживает динамическую адаптацию параметров выполнения: загрузка с учётом текущего состояния кластера, балансировка между узлами на базе реальных характеристик нагрузки и перераспределение ресурсов на время выполнения. Это позволяет удерживать предсказуемую задержку запросов даже при изменениях нагрузки и конфигурации кластера.
Технологические принципы векторной архитектуры
- Батчи как единицы обработки. Обработка батчами уменьшает накладные расходы на управление памятью и улучшает предсказуемость латентности в рамках конвейера.
- Препроцессинг данных. Фильтры и расчёты часто выполняются на шаге чтения данных, чтобы минимизировать объём передаваемых через сеть данных.
- Память и кэш. Эффективное использование кэшей и буферов критически важно для устойчивости к пиковым нагрузкам. Планировщик учитывает эти факторы при выборе физических планов.
Оптимизация запросов: стратегии и алгоритмы
Оптимизация запросов строится на нескольких взаимодополняющих направлениях: предикатное вытягивание, перестройка планов, агрегации и сортировка, а также эффективная работа с распределённой архитектурой. В StarRocks применяются как эвристические техники, так и элементы cost-based оптимизации, что обеспечивает баланс между временем компиляции плана и качеством исполнения.
- Предикатное вытягивание (predicate pushdown). Фильтры перемещаются ближе к источникам данных (сканерам), чтобы уменьшить объём читаемой и передаваемой информации. Это снижает загрузку памяти и ускоряет начало выполнения.
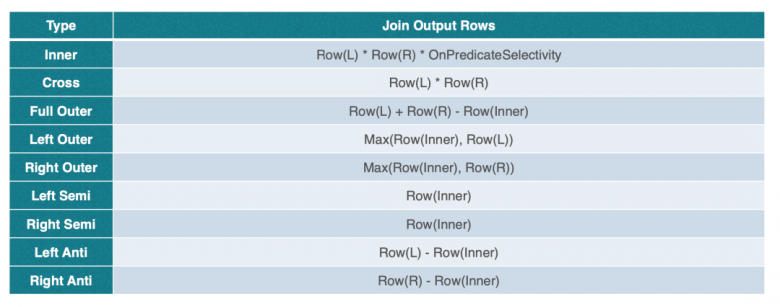
- Примеры join-алгоритмов и перестановка планов. Для крупных данных выбираются эффективные алгоритмы соединения: хеш-соединение для равенств, сортировочное соединение и потенциальная перестановка порядка соединения для минимизации объема данных на ранних стадиях выполнения.
- Промежуточные материалы и агрегации. Применение агрегаций на ранних этапах и использование агрегаций с частичной аггрегатной агрегированием позволяют уменьшить размер промежуточных результатов и ускорить завершающие стадии.
- Промежуточное projection и prune. Применение projection-подсказок для удаления неиспользуемых столбцов, что уменьшает объём передачи данных между узлами и экономит вычислительные ресурсы.
- Статистика и модель затрат. Кардинальность, селективность и корреляции - ключевые параметры для принятия решений на этапе оптимизации. В случае отсутствия точной статистики применяется безопасная эвристика, чтобы избежать экстремальных выборов плана.
- Динамическая фильтрация и кэширование. В некоторых сценариях возможно применение динамических фильтров на этапе исполнения на основе результатов частичной обработки. Это позволяет быстро сузить область поиска и усилить производительность следующих операций.
Примерный набор операторов и распределение нагрузки
- Сканеры. Векторизованные сканеры читают данные из столбцовых сегментов, применяя фильтры до загрузки данных в конвейер.
- Фильтры и проекторы. Фильтры применяются как можно раньше; проекции удаляют лишние столбцы, минимизируя расход памяти.
- Соединения. Реализация соединения зависит от статистики и размера входов: хеш-соединение для больших входов, мердж-соединение при двух упорядоченных потоках.
- Агрегации. Векторизованные агрегаторы обрабатывают батчи и, по возможности, частично аггрегируют во время чтения данных.
- Сортировка и оконные функции. Для оконных операций применяется структура сквозной сортировки и буферизация результатов.
Интеграции с хранением и сетью
Эффективность планирования и исполнения во многом определяется тем, как тесно интегрированы планировщик и движок с хранением данных и сетевыми протоколами. StarRocks проектируется как система, где планировщик, движок и хранение тесно взаимодействуют посредством хорошо определённых контрактов.
- Хранение столбцов и форматы. Векторизированный движок естественным образом работает с столбцовыми форматами хранения, что позволяет быстро фильтровать и агрегировать данные без распаковки. Сжатие столбцов уменьшает нагрузку на сеть и ускоряет чтение.
- Протоколы межузельной коммуникации. Для передачи данных между узлами применяются устойчивые и производительные протоколы передачи батчей. Предпочтение отдаётся минимизации копирования и эффективной сериализации, что снижает задержки и повышает пропускную способность.
- Кэширование и локальность. Локальные кэши данных на узлах уменьшают частоту обращений к центральному хранилищу и ускоряют повторные запросы. Планировщик учитывает кэш-радары и распределение памяти.
- Мониторинг и диагностика. Набор метрик по планам, данным и исполнению, а также трассировки фрагментов позволяют trace- и performance-тесты, что важно для выявления узких мест на уровне планирования и исполнения.
Практические аспекты: диагностика и управление
- Настройка статистики. Регулярное обновление и поддержка статистики (кардинальности, гистограмм и распределения значений) критически важны для эффективности cost-based оптимизации.
- Мониторинг плана исполнения. Анализ планов во время выполнения и сравнение с ожидаемыми затратами помогают обнаружить неэффективности, например, из-за недостоверной статистики или невыбранного алгоритма.
- Тюнинг конфигураций. Параметры параллелизма, буферов и размера батча влияют на латентность и пропускную способность. Правильная настройка зависит от характера нагрузки и характеристик оборудования.
- Диагностика узких мест. Узкие места часто возникают на стадии обмена между узлами или на стадии сложных джоинов. Инструменты профилирования и трассировки позволяют локализовать проблему и принять corrective action.
Key takeaways
- Планировщик запросов в StarRocks представляет четкое разделение между логикой запроса, физическими реализациями и исполнением на кластере, что обеспечивает модульность и масштабируемость.
- Эффективность исполнения зависит от векторизированной архитектуры операторов, конвейерной обработки и оптимального распределения задач между узлами.
- Оптимизация запросов строится на предикатном вытягивании, выборе эффективных алгоритмов соединения, проекции и prune, а также на надёжной статистике и модели затрат.
- Интеграция с хранением столбцов и сетью играет ключевую роль: формат хранения, протоколы обмена и кэширование напрямую влияют на задержку выполнения.
- Мониторинг и диагностика должны быть встроены в цикл разработки и эксплуатации: обновление статистики, анализ планов, настройка параметров и быстрый ответ на узкие места.
- Концепция план-фрагментов и распределённой обработки позволяет достигать эффективной горизонтальной масштабируемости и устойчивости к изменениям нагрузки.
- Правильная настройка параметров и стратегий исполнения требует баланса между скоростью компиляции плана и качеством выбора плана, особенно в смешанных нагрузках.
FAQ
- Чем отличается логический план от физического плана в StarRocks?
Логический план описывает, какие операции над данными необходимы без привязки к конкретной реализации. Физический план выбирает конкретные алгоритмы и реализации операций (например: hash-join против merge-join), учитывая статистику и распределение данных. Разделение позволяет оптимизатору исследовать альтернативы на уровне логики, затем перейти к конкретной реализации, соответствующей архитектуре кластера.
- Как строится и поддерживается статистический набор в рамках планирования?
Статистика формируется по данным каталога: кардинальность столбцов, гистограммы, распределение значений, корреляции между столбцами. В ходе эксплуатации статистика обновляется по расписанию или по событиям обновления данных. Своевременная статистика критична для качества оценки затрат и выбора эффективных планов.
- Какие алгоритмы соединения чаще применяются в StarRocks и когда?
Для больших входов и равенств - хеш-соединение; для упорядоченных входов или когда есть сортировка - сортировочно-объединённое соединение. Порядок выполнения соединений обычно выбирается с учётом объёмов данных и селективности фильтров, чтобы минимизировать объем промежуточных данных.
- Что означает концепция Exchange в физическом плане?
Exchange отвечает за распределение данных между узлами: shuffle, broadcast или merge-передачи. Это ключевой элемент в распределённой архитектуре: он обеспечивает корректное разделение работ между фрагментами запроса и согласованность результатов.
- Как обеспечивается производительность при изменении нагрузки в реальном времени?
Движок выполнений поддерживает конвейеры и динамическое перераспределение ресурсов. Планировщик может адаптировать параметры параллелизма, буферов и объём данных на каждом узле в зависимости от текущей загрузки. Мониторинг позволяет оперативно выявлять узкие места.
- Какие практики диагностики применяются для ускорения исправления проблем исполнения?
Используются трассировки планов и исполнения, анализ времени на каждом этапе, сравнение планов с реальными затратами, просмотр статистик по узлам и обмену между ними. Изменение конфигураций и повторная активация плана помогают подтвердить гипотезы.
- Какие примеры интеграций с системами хранения чаще всего встречаются?
На практике - интеграции с локальными столбцированными форматами и внешними источниками данных через коннекторы. В open-source контексте аналогичные решения встречаются в системах, которые поддерживают совместное использование форматов columnar и эффективную фильтрацию на уровне сканирования.
- Насколько важна архитектура векторизированного исполнения для производительности?
Векторизованная архитектура позволяет обрабатывать данные пакетами и лучше использовать кэш. Это снижает расходы на управление памятью и повышает пропускную способность, что особенно критично для аналитических запросов над большими объёмами данных.
- Как подход к планированию влияет на стабильность сервиса?
Чёткие интерфейсы между компонентами, модульный подход к оптимизации и распределение исполняемых задач по фрагментам позволяют обслуживать множество запросов параллельно, сохраняя предсказуемые задержки и стабильность сервиса даже при росте нагрузки.
- Какие направления развития ожидать в плане планировщика и движка исполнения?
Планируемые направления включают усиление cost-based оптимизации на основе более богатой статистики, более гибкой адаптации планов под динамические нагрузки, расширение набора эффективных join-алгоритмов, улучшение интеграции с новыми формами хранения и расширение возможностей диагностики и мониторинга для ускоренного исправления узких мест.


