

StarRocks для аналитического машинного обучения - от витрин к ML-фичам
Современные системы машинного обучения требуют не только алгоритмов, но и эффективной архитектуры данных, способной обеспечивать быстрый доступ к качественным и согласованным признакам. В этом контексте аналитические базы данных нового поколения, такие как StarRocks, начинают играть ключевую роль — переходя от традиционных витрин данных к полноценной платформе для подготовки и использования ML-фичей.
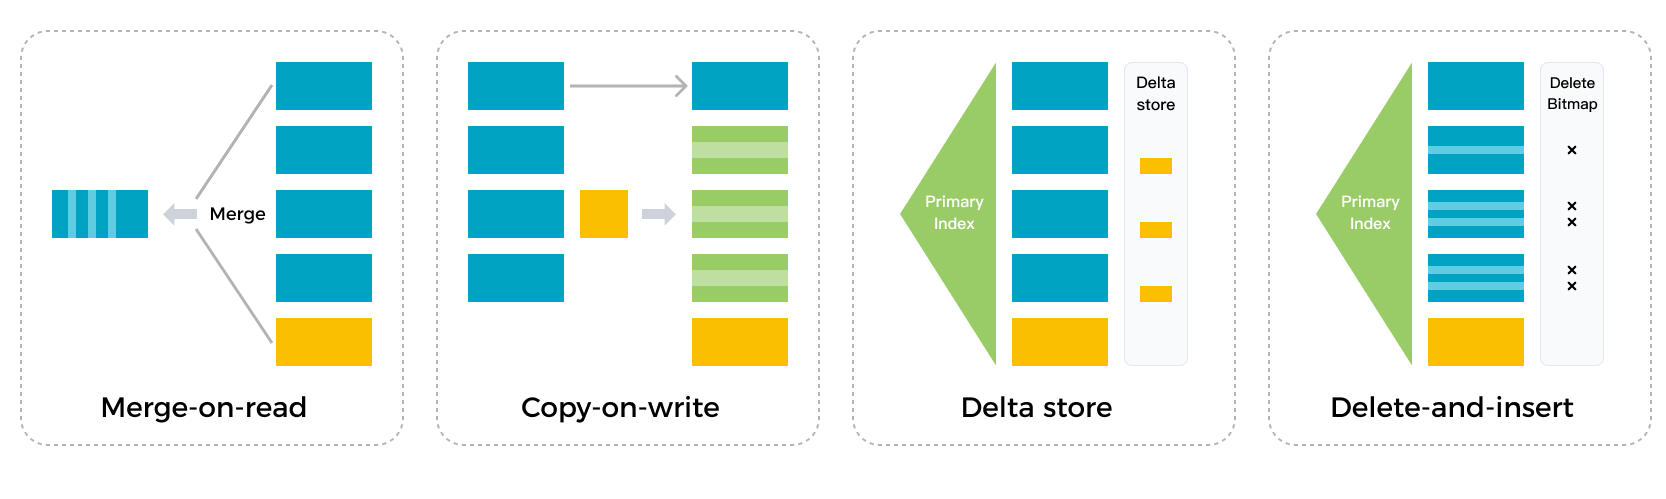
В этом разделе рассматривается, как использовать StarRocks в качестве основы для аналитического машинного обучения: от построения витрин данных и формирования признаков до интеграции с ML-пайплайнами и системами обучения моделей. Особое внимание уделяется вопросам производительности, управлению жизненным циклом фичей, качеству данных, репродуцируемости экспериментов и интеграции с инструментами DataOps и MLOps. Такой подход позволяет создать масштабируемую инфраструктуру, где данные и модели работают как единая система, поддерживающая современные AI-решения.
- Стратегия внедрения StarRocks в аналитическое машинное обучение: цели, принципы, бизнес-варианты
- Терминология и концепции: витрина данных, ML-фичи, feature store
- Архитектура StarRocks: слои, модули и принципы эволюции
- Хранение и индексирование: колоночное представление, сегменты, компрессия, Bloom-фильтры
- Обеспечение производительности запросов: планирование, параллелизм, векторизация
- Инфраструктура развёртывания: облако, локальная инфраструктура, Kubernetes
- Многоарендность и масштабирование: паттерны multi-tenant и кластеризации
- Интеграции источников данных: потоковые и пакетные источники, CDC
- Коннекторы и протоколы доступа: JDBC/ODBC, REST, SQL-порталы
- Архитектура ML-пайплайна вокруг витрины: от сборки фич до модели
- Концепции ML-фичей: источники данных, типы фич, валидные значения
- Жизненный цикл фичей: создание, хранение, обновление, версионирование
- Метаданные, качество данных и управление данными: lineage, data quality
- Архитектура моделей данных для ML-витрин: схемы схемы и совместимость
- Инструменты подготовки данных и пайплайны: Flink, Spark, Airflow, Dagster
- Обучение моделей и их интеграция: TensorFlow, PyTorch, Scikit-learn, model serving
- Проверка качества фичей и устойчивость пайплайнов: тесты, drift, валидность
- Визуализация и доступ к витринам: BI-платформы и SQL-инструменты
- Репродуктивность экспериментов и контроль версий артефактов
- Управление схемами и миграциями данных: эволюция витрин и фичей
- Безопасность, контроль доступа и соответствие требованиям: IAM, аудит, шифрование
- Управление данными жизненного цикла и lineage: provenance, audit trails
- Надёжность и Disaster Recovery: копии, аварийные сценарии, резервное копирование
- Мониторинг, телеметрия и производительность: метрики, логи, алерты
- Риски, ограничения и антириски: латентность, задержки, дрейф данных
- Кейс-исследования: примеры внедрений StarRocks в ML-проекты
- Практикумы и мастер-классы: чек-листы, шаблоны проектов
- Стратегия развития продукта: roadmaps и расширения экосистемы
- Этические и правовые аспекты: приватность, регуляторика, ответственное использование
- Перспективы развития StarRocks в аналитическом ML: тренды и новые возможности


