

Стратегия внедрения StarRocks в аналитическое машинное обучение: цели, принципы, бизнес-варианты
В условиях растущих требований к скорости аналитики и качеству ML-решений, StarRocks выступает как мощный слой обработки и хранения для витрин и фичей машинного обучения. Эта глава посвящена тому, как выстроить стратегию внедрения StarRocks: какие цели формулировать, какие принципы архитектурной организации соблюдать, какие бизнес-модели реализовать и как управлять трансформацией данных от витрин к ML-фичам. Рассматриваются практики интеграции, организационные изменения и процессы оценки ROI в рамках цифровой трансформации.
StarRocks позволяет объединить реалтайм-аналитику и быстрый доступ к предиктивным признакам в едином стекe: от источников данных до встраивания ML-моделей, где SQL-словарь становится мостом между бизнес-запросами и ML-пайплайнами. В фокусе главы - принципы построения устойчивой архитектуры, подходы к управлению данными и фичами, а также сценарии внедрения в разных бизнес-контекстах. Важно помнить: цель внедрения - обеспечить единое, управляемое и доступное место для анализа, подготовки фич, обучения моделей и оперативного применения предсказаний без деградации производительности и с прозрачной оценкой расходов и пользы.
- Цели внедрения StarRocks в аналитическое машинное обучение
- Архитектурная модель и принципы реализации
- Интеграции, операционные паттерны и управление фичами
- Бизнес-варианты внедрения и ROI
Архитектурные принципы и целевые паттерны
Стратегия использования StarRocks в аналитическом ML опирается на четкое разделение ролей между витринами данных и ML-фичами, а также на реализацию управляемого конвейера данных от источников к моделям. Основная идея состоит в том, чтобы StarRocks служил единым хранилищем, где подготавливаются витрины и где формируются фичи для обучающих и онлайн-приемников. Такая архитектура позволяет обеспечить минимальную задержку между обновлением исходных данных и доступностью соответствующих признаков для моделей, а также упрощает отслеживание версии данных и воспроизводимость экспериментов.
Прежде всего, следует зафиксировать концептуальную модель данных: фактовые таблицы с событиями, связанные размерные таблицы и таблицы фич. Каждая фича должна иметь четко определяемый источник, срок годности (TTL) и условия обновления. В StarRocks это достигается через продуманную схему хранения: первичные ключи для быстрого соединения, физическую агрегацию через материализованные представления (MV) и стратегию инкрементального обновления. Такой подход позволяет избежать повторной переработки большой части данных при каждом обновлении, сохраняя при этом воспроизводимость и трассируемость изменений.
- starrocks как слой ускоренного аналитического вычисления и магнит к ML-пайплайнам
- разделение витрин и фичей как основа управления данными
- принципы моделирования: immutable features, time-aware features, point-in-time correctness
Эффективная архитектура предполагает три уровня: сырой фонд данных (raw), предобработанный слой (curated) и слой фичей (features). Витрины могут быть реализованы как готовые к использованию наборы данных для BI, а также как источники для ML-потребностей. В рамках этой архитектуры важно реализовать полноту и целостность данным, обеспечить "time travel" для воспроизведения состояний на конкретный момент времени и поддерживать согласованность между обучением и таргетированными онлайн-применениями.
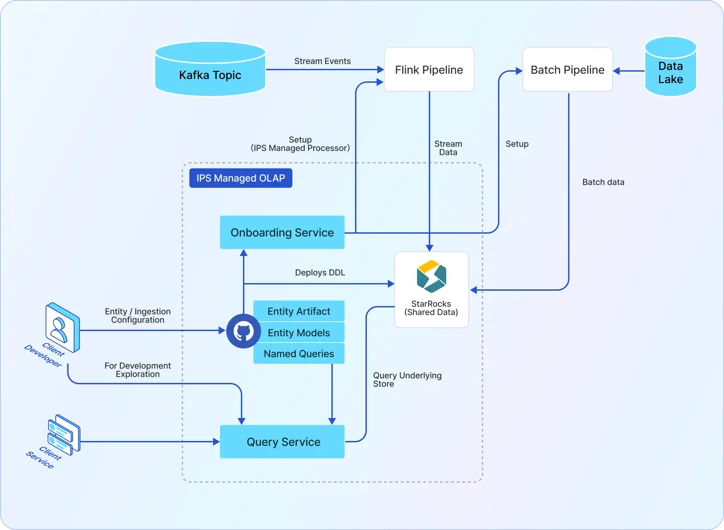
- поддержка потоковой и пакетной загрузки данных: StarRocks способен принимать данные через потоковую загрузку и пакетные загрузки, что критично для оперативной подачи новых признаков;
- управление схемами и эволюцией: гибкое добавление столбцов и групп признаков без нарушения существующих пайплайнов;
- безопасность и соответствие: разграничение прав доступа на уровне таблиц и столбцов, аудит изменений, соответствие регулятивным требованиям.
Информация об интеграции доступна через открытое API StarRocks и поддерживаемые коннекторы к источникам: датасеты в data lake, источники потоковых данных, а также экспорт данных в Python- и Spark-оркестрационные среды. В рамках данной стратегии ключевым становится не только техническое требование к скорости вычислений, но и управляемость среды, включая версионирование фичей, контроль качества данных и прозрачность lineage.
Моделирование витрин и ML-фич в StarRocks
Эффективное проектирование витрин и фич требует формирования парадигм повторного использования и совместной эксплуатации между BI и ML. В витринах следует фиксировать «walls» между сырыми данными и предобработанными данными, а во фичах - между обучением и онлайн-применением. Важно выделить:
- стабильные наборы признаков: они должны быть легко повторяемыми и детерминированными;
- временные признаки: поддержка временных окон, сквозной учет времени событий, обеспечение point-in-time корректности;
- управляемость версий фичей: каждой версии присваивается идентификатор, сохранение линейного журнала изменений, возможность отката;
- связь фичи с моделью: хранение зависимостей и контекста (описание вычислений, источники данных, условия обновления);
- мониторинг качества фичей: автоматические проверки на отсутствие пропусков, аномалий, drift.
Совокупность этих паттернов обеспечивает устойчивость пайплайнов и упрощает повторное использование фич в нескольких моделях и сценариях. В StarRocks особое значение имеет способность быстро агрегировать и соединять витрины с дополнительными данными, а затем выдавать готовые фичи для обучающих партий и онлайн-применения через единый SQL-путь.
Эффективность запросов, консистентность и обновления
Ключевые принципы включают:
- предвычисление часто используемых агрегатов через MV и materialized views;
- использование построенных индексов и распределенной архитектуры для снижения задержек;
- инкрементальное обновление витрин и фичей, минимизация перерасхода ресурсов;
- поддержка кэширования и кэш-могущества для ускорения повторных запросов;
- строгое управление временем жизни данных и точностью сборок (Point-in-Time) для соответствия моделям и контрольных наборов.
Архитектура должна поддерживать параллелизм запросов и обеспечение SLA по задержке, особенно для онлайн-предсказаний. Это требует продуманной политики хранение и обновления фичей, а также эффективной организации параллельного выполнения SQL-операций, которые относятся и к агрегациям, и к соединениям много таблиц.
Ингестинг, безопасность и соответствие
В рамках стратегии следует определить требования к безопасности данных, управлению доступом, аудиту и соответствию требованиям регуляторов. StarRocks поддерживает уровни доступа и сетевую сегментацию, а также возможности аудита изменений. Инженерные команды должны внедрять практики управления ключами, шифрования данных в покое и в движении, а также ретроспективный анализ доступа к данным и фичам.
Интеграции и операционные паттерны
Непосредственно на практике важна связка StarRocks с остальной экосистемой: источниками данных, оркестраторами рабочих процессов и инструментами для ML-экспериментов. Основные направления:
- интеграция с источниками данных: подключение к data lake, системам потоковой передачи (Kafka/Pulsar), базам данных и данным из ERP/CRM;
- оркестрация и MLOps: тесная работа с Airflow, Kubeflow, Dagster для управления пайплайнами от извлечения данных до обучения моделей и применения предсказаний;
- управление фичами и репозиторием: использование концепции feature registry, включая версионирование, контроль качества и повторное использование;
- совместная работа BI и ML: единая платформа позволяет BI-пользователям запускать быстрые бизнес-запросы на витринах и для ML-инженеров - доступ к фичам и данным для обучения.
Источники данных и коннекторы
Эффективная интеграция требует унифицированного доступа к источникам с минимальной задержкой. Архитектура должна поддерживать:
- потоковую загрузку новых данных в витрины и фичи;
- пакетную загрузку для исторических данных и ретроспективной тренировки;
- управление схемами и миграциями без простоев.
Выбор конкретных коннекторов зависит от инфраструктуры: у крупных предприятий часто присутствуют как облачные, так и локальные источники, что диктует необходимость гибкой конфигурации коннекторов и адаптеров.
MLOps и оркестрация
В рамках паттернов эксплуатируемой архитектуры важно выстроить устойчивую практику MLOps: контроль версий данных и фичей, проверку качества данных и автоматизацию тестирования пайплайнов. В идеале StarRocks интегрируется с пайплайнами моделирования, позволяя автоматически обновлять фичи и подготавливать новые наборы для обучения. Важно обеспечить согласованность между режимами обучения и онлайн-применения: выбор версии набора фичей и сопутствующих параметров модели должен быть зафиксирован в репозитории артефактов и связан с настройками пайплайна.
Управление версиями фичей и репозиторием
Эффективное управление версиями требует:
- явной записи источников и условий вычисления каждой фичи;
- хранение линейного журнала изменений и истории версий;
- обеспечения возможности отката к предыдущей версии без потери воспроизводимости;
- обеспечения совместимости между версиями фичей и моделями, использующими их.
Стратегия трансформации данных: от витрины к ML-фичам
Эта часть главы фокусируется на логике эволюции данных в рамках корпоративной архитектуры. Витрины представляют собой основную точку доступа для бизнес-аналитики и подготовленного обзора, тогда как ML-фичи - это конструктор обучающих и онлайн-моделей. В ходе трансформации данные проходят через несколько стадий: от сырых данных к предобработанным витринам, затем к признакам, которые используют модели для обучения и онлайн-предсказаний. Важна последовательность и согласованность, чтобы избежать рассогласований между тем, что обучено и что применяется в реальных сценариях.
Паттерны витрин, фичей и их повторного использования
- Витрины должны быть достаточно абстрагированы от конкретной модели и сценария применения: они должны поддерживать широкий набор аналитических запросов и быть пригодными для повторного использования в разных моделях.
- Фичи должны быть информации с понятной процедурой вычисления и безопасными источниками - это повышает воспроизводимость и упрощает аудит пайплайнов.
- Взаимосвязь витрины и фичи следует документировать: какие витрины поддерживают какие признаки, как их обновлять и как их использовать в обучении.
Управление временем: точность и корректность PIT (Point-In-Time)
Поскольку ML-модели чувствительны к задержкам и временным сдвигам, критически важно обеспечить PIT-корректность. Это значит, что расчеты признаков должны зависеть только от данных, доступных на момент запроса или обучения, исключая «future leakage». В StarRocks можно реализовать временные ключи и временные окна, обеспечивающие правильное объединение событий с их исходниками.
Безопасность и соответствие
В рамках стратегии следует закрепить требования к конфиденциальности и соответствию: кто имеет доступ к витринам и фичам, какие данные можно использовать для обучения и онлайн-применения, как хранится журнал изменений и как осуществляется аудит. Внедрение политики минимальных прав доступа, сегментации данных и журналирования действий обеспечивает большую управляемость и доверие к ML-решению.
Бизнес-варианты внедрения и ROI
Стратегия внедрения StarRocks должна учитывать разнообразие контекстов: от централизованных дата-центров до гибридных и облачных конфигураций. В каждом случае оцениваются затраты, риск, время вывода на рынок и ожидаемая полезность.
Размещение и масштабирование: on-prem, cloud, hybrid
- On-premises: повышенная управляемость и контроль над данными, но большие капитальные затраты и необходимость поддержания инфраструктуры.
- Облачное или гибридное решение: более быстрая масштабируемость, меньшие операционные издержки и гибкость в выборе регионов и услуг, однако требует строгого управления затратами и безопасности в облаке.
- Гибридная модель: данные в одном месте, обработка и обучение в другом, что может снизить задержки и оптимизировать стоимость, но требует четкой стратегии синхронизации и согласованности.
Экономика и ROI
ROI следует оценивать по совокупности факторов: ускорение времени до первых предсказаний, повышение точности моделей за счет более качественных и актуальных фичей, снижение времени простоя бизнес-процессов, сокращение затрат на хранение и повторную переработку данных. Ключевые метрики включают:
- latency для онлайн-предсказаний и обучения;
- скорость создания и обновления фичей;
- количество повторно используемых витрин и фичей;
- улучшение бизнес-метрик (например, конверсия, точность рекомендаций, снижение оттока);
- суммарная стоимость владения (TCO) и окупаемость проекта.
Управление рисками и регуляторика
Необходимо определить набор рисков: задержки в загрузке данных, некорректности PIT, несовместимости версий фичей и моделей, регуляторные риски в отношении персональных данных. В рамках процессов управления следует внедрить контроль качества данных, регистр изменений и аудит доступа. Это позволяет снижать риск непреднамеренных ошибок и повышает доверие бизнес-стейкхолдеров к ML-инициативам.
Примеры бизнес-сценариев
- Централизованный дата-центр решений: единая платформа, где витрины и фичи обслуживают несколько бизнес-юнитов, что обеспечивает масшабируемость и консистентность.
- Облачная платформа: быстрая адаптация к пиковым нагрузкам и тестированию новых фичей; ускорение вывода моделей в продакшн.
- Гибридная архитектура: локальные источники данных чувствительны к IR/PII, обработку и хранение фичей выполняют в облаке, а локальные источники идей и данные - в локальной среде.
Организационные и процессные аспекты
Технологическая архитектура должна дополняться соответствующей организационной структурой и процессами. Эффективное внедрение требует ясного разделения ролей, процессов и стандартов.
Организационная структура и роли
- Data Engineer/Architects: проектирование и сопровождение архитектуры витрин и фичей, интеграции и миграций.
- ML Engineer: разработка и обучение моделей, верификация и перенос моделей в продакшн.
- Data Scientist: формирование требований к признакам и эксперименты с новых признаков.
- Data Governance/Compliance: контроль за качеством данных, безопасностью и регуляторикой.
- DevOps/MLOps: автоматизация циклов разработки, тестирования, выпуска и мониторинга пайплайнов.
Процессы MLOps и QA
- CI/CD для фичей: автоматическая проверка качества данных, совместимости версий фичей с моделями, регрессионное тестирование.
- Мониторинг и алерты: отслеживание drifting, деградации моделей и задержек пайплайнов.
- Верификация данных: процедуры валидации данных на каждом этапе пайплайна, от источников до фичей.
Организационные изменения и обучение
Необходимо обеспечить обучение сотрудников новым паттернам работы с витринами и фичами, развитие концепции «data literacy» в бизнесе. Вводятся регламенты по совместной работе BI и ML, правила обмена данными и совместного использования витрин и фичей, прозрачность версионности и процесса обновления.
Key takeaways
- StarRocks выступает как мощный слой для витрин и ML-фич, ускоряя доступ к данным и упрощая воспроизводимость экспериментов.
- Архитектура должна быть построена вокруг четкого разделения витрин и фичей, обеспечивая PIT-правильность и консистентность данных.
- Интеграции с источниками данных, MLOps и репозиториями фичей критически важны для устойчивой эксплуатации и повторного использования.
- Бизнес-варианты внедрения включают on-prem, cloud и гибридные схемы; ROI оценивается по скорости вывода на рынок, точности моделей, затратах на хранение и управлении данными.
- Организационные изменения и процессы управления данными, качеством данных и безопасностью являются неотъемлемой частью успешной реализации.
- Управление версиями фичей и прозрачность lineage позволяют воспроизводимость экспериментов и устойчивость к изменениям в моделях и данных.
- Вовлечение бизнес-пользователей и ML-команды требует единого подхода к данным, понятной документации и адаптивной архитектуры.
FAQ
- Как StarRocks помогает снизить задержку между обновлением источников данных и доступностью фичей онлайн?
- StarRocks обеспечивает мощную обработку SQL-запросов, поддержку MV и инкрементальных обновлений, что позволяет быстро обновлять витрины и фичи. За счет параллелизма и распределенной архитектуры снижаются задержки на стадии подготовки признаков и выполнения онлайн-запросов, что критично для оперативной инфраструктуры ML.
- Какие паттерны моделирования витрин и фичей стоит применять в рамках этой стратегии?
- Рекомендуется использовать слои raw, curated и feature, с четкой привязкой к источникам и времени. Фичи должны быть версионируемыми, иммутабельными, с поддержкой PIT-корректности и понятными зависимостями. Повторное использование фичей между моделями и сценариями снижает дублирование работы и ускоряет экспериментирование.
- Как обеспечить PIT-корректность в пайплайнах на StarRocks?
- Реализуйте временные ключи и окна, фиксируйте момент времени для обучения и онлайн-применения, чтобы не было утечки будущих данных. Документируйте логику агрегирования и обновления признаков с указанием временных ограничений.
- Какие риски присущи миграции к StarRocks и как их минимизировать?
- Риски включают задержки миграции, несоответствие версий фичей и моделей, проблемы безопасности. Минимизируйте их за счет поэтапной миграции, тестирования версий фичей, четких политик доступа, аудита и регламента изменений.
- Какие сценарии размещения предоставляют наибольшую гибкость?
- Гибридные схемы часто эффективны: данные остаются локально там, где это требуется по регуляторике, обработка и обучение выполняются в облаке, а единый слой витрин и фичей - в StarRocks. Это сочетает контроль над данными и гибкость масштабирования.
- Какие KPI стоит использовать для оценки ROI внедрения StarRocks в ML-проекты?
- Latency онлайн-предсказаний, время обновления фичей, точность и качество моделей, общее время цикла обучения, стоимость хранения и вычислений, скорость вывода новых фичей в продакшн и влияние на бизнес-метрики.
- Как поддерживать качество данных и соответствие требованиям в рамках архитектуры?
- Внедрите автоматизированные пайплайны тестирования данных, регистр изменений фичей и lineage, мониторинг drift и качество данных. Обеспечьте аудит доступа и прозрачность операций в рамках регуляторных требований.
- Какие роли в организации критически важны для успеха проекта?
- Архитектор/инженер данных, ML-инженер, Data Scientist, специалист по MLOps, специалист по Governace и Compliance, менеджер проекта. Важна координация между бизнес-аналитиками, BI и ML-командами.
- Как обеспечить воспроизводимость экспериментов и переносимость моделей?
- Ведите журнал версий фичей и схем данных, фиксируйте параметры моделей и связанные версии фич. Связывайте артефакты экспериментов с конкретной конфигурацией пайплайна и версией витрины/фичи в StarRocks.
- Какие примеры открытых решений стоит учитывать при внедрении?
- В качестве ориентиров можно рассмотреть открытые решения для управления фичами и балансирования между OLAP-запросами и ML-пайплайнами. При этом выбирайте решения, которые минимизируют перегрузку архитектуры и позволяют держать данные в совместном, управляемом слое. Также полезны примеры интеграции с инструментами MLOps и коннекторами к источникам данных, которые обеспечивают единый доступ к данным.
Глава завершает взгляд на стратегию внедрения StarRocks в аналитическое машинное обучение через призму сочетания архитектурных паттернов, интеграционных практик и бизнес-ориентированных вариантов. Подход hybrid позволяет достичь баланса между производительностью, управляемостью и эффективностью инвестиций, обеспечивая единое место для подготовки фич, обучения моделей и оперативного применения предсказаний.


