

Заключение и резюме урока: табличная модель StarRocks
Заключительная глава курса систематизирует принципы работы табличной модели в StarRocks, объединяя архитектуру, проектирование данных и практику внедрения. В ходе обзора выделяются ключевые концепции звездной схемы, принципы обработки запросов и принципы интеграции с инфраструктурой аналитических приложений. Важнейшее внимание уделено тому, как связаны выбор схем, механизмы агрегации и механизмы загрузки данных с реальными сценариями эксплуатации.
План главы отражает логику перехода от теоретических основ к конкретным паттернам реализации и методам оптимизации в типичных производственных условиях. Главная идея заключается в том, что табличная модель StarRocks - это не только набор таблиц, но и целостная стратегия управления данными, их потоком и запросами, которые формируют ориентированную на бизнес аналитику производственную архитектуру.
- Обобщение принципов звездообразной модели в StarRocks и роль фактных и размерных таблиц.
- Актуальные подходы к построению, агрегации и оптимизации запросов в контексте векторизированного исполнения.
- Практические паттерны внедрения: загрузка данных, консистентность схем, мониторинг производительности.
- Взаимодействие StarRocks с экосистемой: источники данных, коннекторы и BI-инструменты.
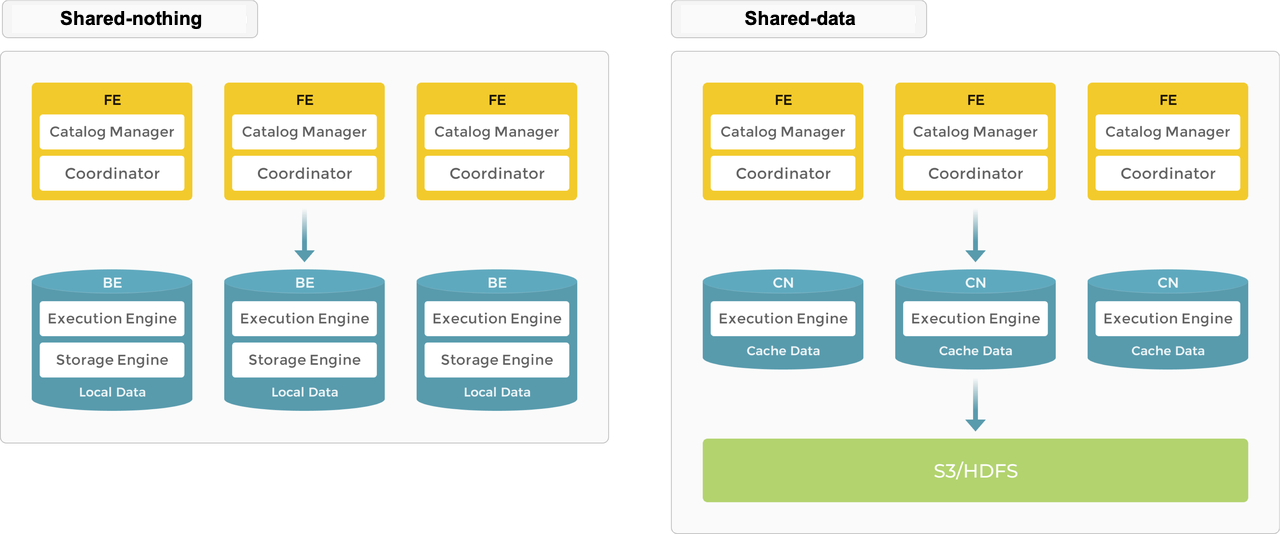
Архитектура табличной модели StarRocks
В основе табличной модели в StarRocks лежит концепция звездной схемы: одну крупную фактную таблицу (fact) дополняют наборы размерных таблиц (dimension), которые служат контекстом для измеряемых величин. Такая структура упрощает реализацию агрегаций и ускоряет фильтрацию по измерениям за счет предикатов по ключам размерных таблиц и предикатов по датам, продуктам, регионам и т. п. StarRocks реализует парадигму распределенного анализа данных, в которой данные размещаются по разделам (partitions) и распределяются по узлам кластера. Это обеспечивает масштабируемость и параллелизм выполнения запросов, характерный для современных OLAP-решений.
Ключевые элементы архитектуры включают:
- Фактные таблицы, где собранные числовые метрики представляют бизнес-геометрию (выручка, количество заказов, маржинальность и т. д.). Эти таблицы обычно имеют высокий объём и требуют эффективной агрегации по нескольким осям измерений.
- Размерные таблицы, которые содержат описания измерений: даты, продукты, клиенты, каналы продаж и т. д. Они поддерживают конформированность и согласованность между фактами.
- Распределение и сортировка: данные распределяются по ключам (какие именно ключи зависят от бизнес-потребностей) и сортируются по часто используемым в запросах полям, что повышает эффект черновых операций и ускоряет сканирование и агрегацию.
- Векторизированный движок исполнения: StarRocks опирается на колоночное хранение и пакетное выполнение операций над столбцами, что даёт высокий пропускной канал и эффективную компрессию.
- Механизмы оптимизации запросов: фильтры по столбцам, Bloom-фильтры для ускорения доступа к большому числу строк, предикаты по дате и по ключам размерных таблиц, а также стратегии объединения и агрегации (hash-join, sort-merge и пр.) в зависимости от характера данных и размера таблиц.
- Материализованные представления и Rollup: возможности ускорения повторяющихся запросов за счёт предварительно агрегированных версий данных, что особенно важно для часто используемых показателей в финансовой аналитике.
- Интеграционные каналы: поддержка загрузки данных (batch и streaming), коннекторы к источникам, а также совместимость с BI-инструментами, что обеспечивает быстрое внедрение в аналитическую экосистему.
Стабильность и предсказуемость производительности достигаются через продуманный дизайн схем, грамотное управление ключами, учет размеров и частоты обновления размерных таблиц, а также через регулярное обслуживание коллекций и дефрагментацию разделов. Важнейшим фактором является совпадение зерна фактов с реальным бизнес-аналитическим запросом: неверная гранулярность приводит к избыточным расчётам, издержкам хранения и задержкам в ответах на запросы.
Однако архитектура - это не только техника, но и набор методологических решений: как проектируются ключи, какие поля включать в роль sort ключей, как распределяются данные между узлами, какие индексы и фильтры применяются. В контексте StarRocks значительный вклад в производительность вносят компрессия и кодирование, выбор правильной стратегии распределения и продуманное использование rollups и материализованных представлений. Все эти элементы работают в единой системе, обеспечивая эффективное вычисление агрегатов и точное управление латентностью под высокие пиковые нагрузки.
Моделирование данных: факты и измерения
Проектирование схем в табличной модели требует глубокого понимания бизнес-процессов и частых сценариев анализа. Гранулярность фактов и характер измерений определяют, насколько легко и быстро можно формировать нужные аналитические показатели. В StarRocks рекомендуются следующие принципы:
- Определение зерна фактов: выбор максимального уровня детализации, который обеспечивает необходимую точность, не создавая перегрузок. Часто зерноируется по сочетанию ключей дат, продукта и региона, что позволяет легко строить агрегаты по времени, продукту и продавцу.
- Размещение по ключам: назначение распределения по ключам, которые часто используются в фильтрах и соединениях. Распределение по хешу date_key и product_key может обеспечить равномерную загрузку и ускорить совпадения по двум аспектам - времени иProduct.
- Размерные таблицы и конформированность: размерные таблицы содержат бизнес-атрибуты и служат для фильтрации и группировки. Конформированные размеры обеспечивают согласованность между фактами, если источники данных обновляются или меняются со временем.
- Типы SCD (Slowly Changing Dimensions): подходы к обработке изменений размеров - Type 1 (перезапись), Type 2 (историзация) и их сочетания. В аналитике часто применяется Type 2 для сохранения истории изменений атрибутов размерных таблиц, что особенно важно для аналитических отчётов и аудита бизнеса.
- Денормализация против нормализации: звездная схема по своей природе денормализована в отношении измерений с целью ускорения запросов. Однако целесообразно сохранить связь между фактами и размерами, чтобы не дублировать данные и сохранять единообразие атрибутов.
- Деперсонализация и роль surrogate keys: для устойчевости к изменениям внешних идентификаторов применяются суррогатные ключи. Это обеспечивает стабильность связей между фактами и размерными таблицами и упрощает обработку SCD.
В практике это выражается в создании минимального набора размерных таблиц, который охватывает наиболее частые контексты анализа (даты, клиенты, товары, каналы, регионы), и одной или нескольких фактных таблиц, отражающих основной аналитический процесс (продажи, события, посещения). Такой подход облегчает построение гибких и расширяемых отчётов, упрощает внедрение новых атрибутов и поддерживает консистентность данных при изменении источников.
Для иллюстрации приведём упрощённый пример структуры:
- dim_date: date_key, full_date, year, quarter, month, day
- dim_product: product_key, product_name, category
- dim_store: store_key, store_name, region
- sales_fact: order_id, date_key, product_key, store_key, revenue, quantity
Такой набор позволяет быстро формировать агрегаты по времени, продуктам и каналам продаж, а также дополнять факты контекстом из размерных таблиц без лишней денормализации. Важно, чтобы ключи размерных таблиц сопровождались понятными атрибутами и чтобы константы атрибутов не приводили к противоречиям в данных и в запросах.
// Пример упрощённой схематизации (абстрактная SQL-подобная запись)
CREATE TABLE dim_date (
  date_key INT,
  full_date DATE,
  year INT,
  quarter INT,
  month INT,
  day INT
);

CREATE TABLE dim_product (
  product_key INT,
  product_name VARCHAR(100),
  category VARCHAR(50)
);

CREATE TABLE dim_store (
  store_key INT,
  store_name VARCHAR(100),
  region VARCHAR(50)
);

CREATE TABLE sales_fact (
  order_id BIGINT,
  date_key INT,
  product_key INT,
  store_key INT,
  revenue DECIMAL(18,2),
  quantity INT
);

## ALTER TABLE sales_fact
  DISTRIBUTED BY HASH(date_key, product_key)
  BUCKETS 16;
Такой подход позволяет строить быстрые объединения между фактами и измерениями и накапливать агрегации по времени, категориям и регионам без существенных затрат на JOIN-операции.
Обработка запросов и план выполнения
Запросы в StarRocks к табличной модели строятся на уровне абстракций SQL-аналитики, но реальное исполнение опирается на планировщик и движок, оптимизирующий стратегии соединений и агрегаций. Основные принципы:
- Векторизированное исполнение: обработка данных по столбцам с эффективной компрессией и минимизацией чтения неиспользуемых столбцов. Это снижает задержки и повышает пропускную способность при больших объёмах данных.
- Фильтры и предикаты: фильтры по размерным ключам и датам позволяют сузить объём данных, обрабатываемый на этапах агрегации. Bloom-фильтры используются для ускорения точечного доступа к данным.
- Стратегии соединений: в типичных случаях применяются хеш-join для соединения фактной таблицы с размерными по ключам. При небольших размерных таблицах возможно применение broadcast-join. Оптимизатор выбирает наиболее выгодную стратегию в зависимости от статистики таблиц.
- Агрегации и Rollups: для ускорения повторяющихся запросов применяются материализованные представления и Rollup-таблицы, что позволяет отвечать на аналитические запросы без повторных вычислений над исходными данными.
- План объяснения: команда EXPLAIN позволяет разработчику увидеть план выполнения запроса, оценить затраты по времени на чтение данных, применение фильтров, выбор стратегии соединения и порядок агрегаций. Это критично для оптимизации сложных запросов и выявления узких мест.
- Партитивка и prune: разделение данных на партиции помогает ускорить сканирование, поскольку запросы ограничивают диапазоны по дате или по другим признакам, снижая объем данных, который необходимо прочитать.
Эти принципы позволяют достигать очень высоких скоростей анализа даже на больших объёмах данных. Важно помнить, что оптимизация запросов для табличной модели требует внимания к зерну фактов, выбору ключей распределения и составу необходимых индексов и фильтров. Регулярная проверка планов выполнения и мониторинг задержек помогают поддерживать продуктивность в условиях реального использования.
Интеграция и инфраструктура
Эффективное внедрение табличной модели предполагает тесную интеграцию с данными источниками, инструментами загрузки и BI-слоем. В контексте StarRocks важны следующие аспекты:
- Загрузка данных: StarRocks поддерживает различные режимы загрузки, включая пакетную загрузку (batch) и потоковую загрузку (streaming). Это позволяет оперативно обновлять фактовые таблицы, поддерживая актуальность аналитических показателей.
- Источники данных и коннекторы: для интеграции используются коннекторы к системам ERP, CRM, логистике и другим источникам. В них важны корректные схемы, соответствие типов данных и настройки задержек.
- CDC и временные метки: для поддержки аудита и исторических анализов применяются методы CDC, которые позволяют фиксировать изменения в размерных и фактных таблицах и переносить их в StarRocks без потери консистентности.
- Инструменты загрузки и контроля качества: пайплайны ETL/ELT включают процессы валидации схем, проверки целостности ключей и согласования бизнес-правил. В идеале used-правила Data Quality покрываются автоматическими тестами и мониторингом.
- Интеграция с BI и аналитикой: SQL-совместимость StarRocks обеспечивает совместимость с JDBC/ODBC-совместимыми инструментами бизнес-аналитики (Tableau, Power BI, Superset и др.), что ускоряет внедрение и упрощает обучение пользователей.
- Метаданные и каталогизация: поддержка каталога схем, версий таблиц, истории изменений и миграций обеспечивает прозрачность и управляемость в условиях эволюции моделей и источников данных.
Эта часть главы подчёркивает необходимость планирования инфраструктуры как неотъемлемого элемента проекта: без надлежащей загрузки, мониторинга и качественного управления схемами реальная польза от звездной модели может быть снижена. В реальных проектах архитектура данных должна быть адаптивной к изменяющимся требованиям бизнеса и устойчивой к росту объёмов данных.
Практические паттерны внедрения и эксплуатации
Реализация табличной модели в StarRocks требует сочетания проектирования, организации процессов и операционной дисциплины. Ниже приведены ключевые паттерны, которые применяются в большинстве проектов:
- Пакетная загрузка с предвидением: для больших исторических наборов данных следует планировать этапы загрузки и применения Rollup-агрегаций, чтобы минимизировать влияние на производительность в пиковые часы.
- Историзация размерных данных: SCD Type 2 применяется для сохранения истории атрибутов размерных таблиц. Встраивается в процесс обновления размерных таблиц и требует корректного управления суррогатными ключами.
- Конформированность размеров: обеспечение единообразия измерений по всем фактам упрощает аналитические сценарии и снижает риск ошибок в отчетности.
- Rollups и агрегаты: для часто встречающихся показателей (например, общая выручка по месяцам и по сегментам) создаются Rollup-таблицы, чтобы ускорить ответы на бизнес-вопросы и снизить нагрузку на основную таблицу фактов.
- Мониторинг и профилирование: регулярное использование EXPLAIN, мониторинг задержек и пропускной способности, а также анализ планов выполнения позволяют своевременно внедрять корректировки.
- Эволюция схем: изменение схемы** - нормальная часть жизненного цикла проекта. Важно иметь стратегии миграции, совместимости и отката, чтобы минимизировать риск прерываний.
- Гигиена данных и качество: поддержка целостности и согласованности данных в фактах и измерениях, а также регулярные проверки соответствия между источниками и целевыми таблицами.
Эти паттерны формируют практическую основу для жизненного цикла проекта: от проектирования модели и планирования загрузки до мониторинга производительности и поддержки изменений в ходе эксплуатации. Реализация требует дисциплины и ясной дорожной карты проекта, чтобы бизнес-аналитика получала своевременные и точные данные.
Примеры реализации и типовые решения
В этом разделе приведён упрощённый пример реальной реализации табличной модели в StarRocks, иллюстрирующий соответствие теории практическим требованиям. Рассмотрим звездообразную схему для розничной торговли, где аналитика строится на продажах, временных интервалах и атрибутах продуктов.
- dim_date: date_key, full_date, year, quarter, month, day
- dim_product: product_key, product_name, category
- dim_store: store_key, store_name, region
- sales_fact: order_id, date_key, product_key, store_key, revenue, quantity
// Упрощённая DDL-логика (абстрактная, не привязана к конкретному синтаксису)
// Размерные таблицы
CREATE TABLE dim_date (date_key INT, full_date DATE, year INT, quarter INT, month INT, day INT);
CREATE TABLE dim_product (product_key INT, product_name VARCHAR(100), category VARCHAR(50));
CREATE TABLE dim_store (store_key INT, store_name VARCHAR(100), region VARCHAR(50));

// Фактовая таблица
CREATE TABLE sales_fact (order_id BIGINT, date_key INT, product_key INT, store_key INT, revenue DECIMAL(18,2), quantity INT);

// Распределение и индексы
ALTER TABLE sales_fact DISTRIBUTED BY HASH(date_key, product_key) BUCKETS 16;
Такая реализация обеспечивает эффективное выполнение запросов типа:
- общая выручка за период по категориям продуктов;
- выручка по региону и по месяцу;
- средняя цена продажи по товарным группам и периодам.
Важно подчеркнуть, что приведённый пример носит иллюстративный характер. В реальной среде следует учитывать конкретные требования к громоздкости таблиц, частоте обновлений и нюансы бизнес-аналитики. Правильная настройка распределения, сортировки и агрегирования требует анализа типичных запросов и профилирования планов выполнения.
Key takeaways
- Табличная модель StarRocks строится на звездообразной схеме, где фактная таблица дополняется размерными таблицами для ускорения аналитики и агрегаций.
- Архитектура и движок StarRocks поддерживают векторизированное исполнение, колоночное хранение, фильтры и эффективные стратегии соединений, что обеспечивает высокую производительность аналитических запросов.
- Выбор зерна фактов, распределение данных и конформированность размерных таблиц критически влияют на скорость выполнения запросов и устойчивость к изменениям источников данных.
- Интеграция с источниками данных, потоковой загрузкой и бизнес-инструментами требует продуманной инфраструктуры и контроля качества данных.
- Практические паттерны: Rollup, Materialized Views, SCD-управление размерными данными, мониторинг планов выполнения и миграции схем - являются основой устойчивой эксплуатации.
- Эффективная производственная реализация требует чёткой дорожной карты, включая загрузку (batch/stream), контроль качества, мониторинг и управление изменениями схем.
- Визуальная и программная поддержка совместимости с BI-инструментами обеспечивает быструю адаптацию пользователей к новой аналитической среде.
FAQ
- Какова основная идея табличной модели StarRocks и зачем она нужна?
- Табличная модель в StarRocks строится вокруг звезды: одна или несколько фактных таблиц, окружаемых размерными таблицами, что обеспечивает эффективные агрегации и быстрые ответы на аналитические запросы. Такая организация упрощает фильтрацию по измерениям и ускоряет вычисления, связанные с временем, пространством и атрибутами продуктов. Она подходит для больших объёмов данных и сценариев бизнес-аналитики, где требуется точная и быстрая агрегация по разным измерениям.
- В чем отличие звёздной схемы от снежной схемы и когда стоит выбрать каждую из них?
- Звёздная схема использует минимальное число размерных таблиц и денормализует их, что ускоряет запросы за счёт простых JOIN-операций. Снежная схема нормализует размерные таблицы, уменьшая дублирование, но увеличивает сложность запросов. В StarRocks чаще предпочтительна звёздная схема из-за скорости аналитических запросов, но снежная схема может быть полезна при ограничении дублирования и требовании высокой консистентности размерных атрибутов.
- Какие механизмы оптимизации особенно полезны в табличной модели?
- Векторизированное исполнение, фильтры по столбцам, Bloom-фильтры и стратегия распределения по ключам. Дополнительные паттерны включают Rollup-агрегации и материализованные представления для ускорения часто задаваемых запросов, а также продуманное использование сортировок и ключей агрегации для снижения затрат на обработку.
- Как реализовать управляемую загрузку данных в StarRocks?
- Используются batch и streaming режимы загрузки, CDC для учёта изменений и контроль целостности. Важно синхронизировать источники данных и целевые таблицы, обеспечить consistency checks и обеспечить мониторинг потока изменений и задержек.
- Какие подходы к моделированию SCD наиболее применимы в StarRocks?
- Type 2 (историзация изменений) часто применяется для размерных таблиц. Он позволяет хранить историю изменений атрибутов и поддерживать аналитические запросы по состоянию на конкретный момент времени. В то же время, Type 1 может применяться для данных, которые не требуют сохранения истории.
- Как определить подходящую гранулярность фактов?
- Гранулярность должен определять баланс между точностью и размером данных. Она должна соответствовать бизнес-потребностям: слишком детальные факты увеличивают объём хранения и задержку, слишком агрегированные - снижают аналитическую точность. Рекомендуется начинать с разумной гранулярности и затем корректировать её по результатам анализа реальных запросов.
- Какие существуют признаки и способы мониторинга производительности табличной модели?
- Анализ планов выполнения (EXPLAIN) и профилирование выполнения запросов, мониторинг задержек и пропускной способности, анализ использования ресурсов (CPU, память, IO) на уровне кластера и отдельных узлов, а также контроль за обновлениями данных и временем задержки между источниками и целевыми таблицами.
- Какие проекты требуют особого внимания к миграции схем?
- При изменении бизнес-правил, добавлении новых атрибутов или изменении состава размерных таблиц необходимо планировать миграцию схем и соответствующее обновление Rollup/материализованных видов. Важно обеспечить обратную совместимость и минимизировать простои в аналитических сервисах.
- Как обеспечивается качество данных в контексте табличной модели?
- Включает проверки целостности ключей, соответствие схем источников и целевых таблиц, регулярную валидацию количества строк, сравнение агрегатов между источниками и целевой моделью, а также автоматизированные тесты и контрольные наборы для регрессионной проверки.
- Какие сценарии внедрения наиболее характерны для StarRocks?
- Внедрение в зрелые бизнес-департаменты, которые требуют высокой скорости аналитики по большому объёму данных; миграции из традиционных аналитических систем в рамках строительства единого хранилища по звездообразной схеме; интеграции с BI-инструментами и потоковой загрузкой данных из корпоративных источников.


