

Ландшафт разработки данных с открытым исходным кодом к 2025 году
Уже второй год подряд публикуется "Ландшафт разработки данных с открытым исходным кодом". Цель состоит в том, чтобы выявить и продемонстрировать ключевые действующие проекты и выдающиеся инструменты в области разработки данных, а также предоставить всесторонний обзор динамичной экосистемы разработки данных, ключевых тенденций и разработок.
Хотя этот обзор публикуется ежегодно, сопровождающий его репозиторий на GitHub регулярно обновляется в течение всего года. Не стесняйтесь вносить свой вклад, если заметите какой-либо недостающий компонент.
Методология исследования
Проведение таких обширных исследований требует значительных усилий и времени. Я постоянно занимаюсь исследованиями и стремлюсь быть в курсе важных изменений в экосистеме обработки данных в течение всего года, включая новости, мероприятия, тенденции, отчеты и достижения.
В прошлом году я создал свою собственную небольшую информационную платформу для отслеживания событий в публичном репозитории GitHub, что позволило лучше анализировать связанные с GitHub показатели инструментов с открытым исходным кодом, такие как активность кода, звездочки, вовлеченность пользователей и разрешение проблем.
Стек включает в себя data lake (S3), Parquet в качестве формата сериализации, DuckDB для обработки и аналитики, Apache NiFi для интеграции данных, Apache Superset для визуализации и PostgreSQL для управления метаданными, а также другие инструменты. Эта настройка позволила мне собрать около 1 ТБ необработанных данных о событиях на GitHub, состоящих из миллиардов записей, а также агрегированный набор данных, который обновляется ежедневно, общим объемом более 500 миллионов записей на 2024 год.

Критерии выбора инструмента
Доступные проекты с открытым исходным кодом для каждой категории, очевидно, обширны, что делает непрактичным включение каждого инструмента и проекта в представленный ландшафт.
В то время как на странице GitHub представлен более полный список инструментов, ежегодно публикуемый landscape содержит только активные проекты, исключая неактивные и относительно новые проекты, не достигшие минимальной зрелости или привлекательности. Однако не все включенные инструменты могут быть полностью готовы к работе; некоторые из них все еще находятся на пути к зрелости.
Без лишних слов, вот ландшафт разработки данных с открытым исходным кодом на 2025 год:
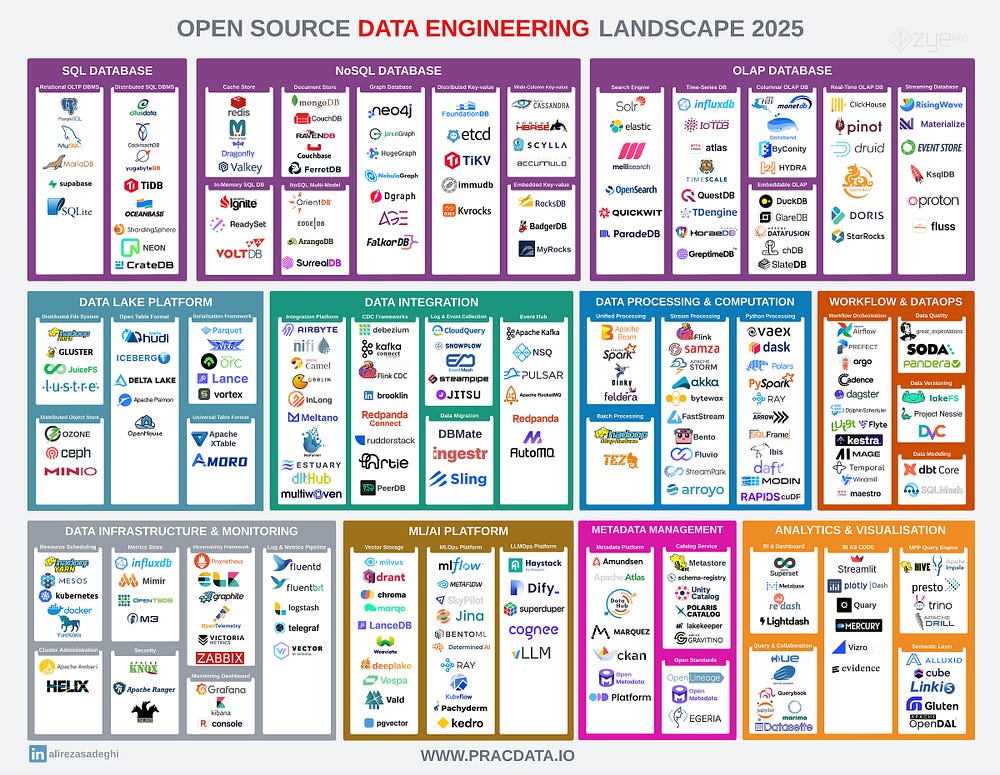
Состояние открытого исходного кода в 2025 году
В 2024 году экосистема разработки данных с открытым исходным кодом значительно расширилась: в этом году было добавлено более 50 новых инструментов и удалено около 10 неактивных и заархивированных проектов. Хотя не все эти инструменты были запущены в 2024 году, они представляют собой важные дополнения к экосистеме.
Несмотря на то, что этот рост свидетельствует о продолжающихся инновациях, в течение года также произошли некоторые изменения, касающиеся лицензирования. Такие известные проекты, как Redis, CockroachDB, ElasticSearch и Kibana, перешли на более закрытые и проприетарные лицензии, хотя Elastic позже объявила о возвращении к лицензированию с открытым исходным кодом.
Однако эти сдвиги были уравновешены значительным вкладом в сообщество разработчиков с открытым исходным кодом от крупных игроков отрасли. Вклад Snowflake в разработку Polaris, создание каталога Unity с открытым исходным кодом от Databricks, пожертвование OneHouse Apache XTable и выпуск Netflix Maestro продемонстрировали неизменную приверженность лидеров отрасли разработке с открытым исходным кодом.
Apache Foundation сохранил свои позиции ключевого разработчика информационных технологий, активно поддерживая несколько многообещающих проектов в течение 2024 года. В число наиболее заметных проектов, находящихся на стадии разработки, входят Apache XTable (универсальный табличный формат), Apache Amoro (управление lakehouse), Apache HoraeDB (база данных временных рядов), Apache Gravitino (каталог данных), Apache Gluten (промежуточное программное обеспечение) и Apache Polaris (каталог данных).
Linux Foundation также укрепил свои позиции в информационном пространстве, продолжая принимать у себя такие выдающиеся проекты, как Delta Lake, Amundsen, Kedro, Milvus и Marquez. В 2024 году фонд расширил свое портфолио новыми значительными дополнениями, включая vLLM, предоставленный Калифорнийским университетом в Беркли, и OpenSearch, который был передан из AWS в Linux Foundation.
Open Source против Open Core против Open Foundation.
Не все из перечисленных проектов являются полностью совместимыми и независимыми от поставщика инструментами с открытым исходным кодом. Некоторые из них работают по модели с открытым ядром, в которой не все компоненты системы доступны в версии с открытым исходным кодом. Как правило, такие важные функции, как безопасность, управление и мониторинг, доступны только в платных версиях.
Остаются вопросы об устойчивости бизнес-модели open core. Эта модель сталкивается со значительными трудностями, из-за чего некоторые считают, что она может уступить место модели Open Foundation. При таком подходе программное обеспечение с открытым исходным кодом служит основой коммерческих предложений, гарантируя, что оно остается полностью пригодным для производства продуктом со всеми необходимыми функциями.
Обзор категорий
Сфера разработки данных разделена на 9 основных категорий:
- Платформа Data Lake: Инструменты и фреймворки для создания и управления хранилищами данных.
- Системы хранения данных: Базы данных и механизмы хранения, охватывающие OLTP, OLAP и специализированные решения для хранения данных.
- Обработка и интеграция данных: фреймворки для пакетной и потоковой обработки, а также инструменты обработки данных на Python.
- Организация рабочих процессов и DataOps: инструменты для организации конвейеров передачи данных и управления операциями с данными.
- Интеграция данных: Решения для обработки данных, CDC (сбора данных об изменениях) и интеграции между системами.
- Инфраструктура данных: Основные компоненты инфраструктуры, включая управление контейнерами и мониторинг.
- Платформа ML/AI: Инструменты, ориентированные на платформы ML, MLOps и векторные базы данных.
- Управление метаданными: Решения для каталогов данных, управления ими и управления метаданными.
- Аналитика и визуализация: Инструменты BI, платформы визуализации и аналитические движки.
В следующем разделе кратко рассматриваются последние тенденции, инновации и текущее состояние основных продуктов в каждой категории.
1. Системы хранения данных
В 2024 году в области систем хранения данных произошли значительные архитектурные изменения, особенно в области систем баз данных OLAP.
База данных DuckDB стала примером большого успеха, особенно после ее выпуска версии 1.0, который продемонстрировал готовность к использованию на предприятии. Новая категория встраиваемых OLAP-систем пополнилась такими новыми пользователями, как chDB (созданная на базе ClickHouse), GlareDB и SlateDB, что отражает растущий спрос на облегченные возможности аналитической обработки.

Расширения OLAP и HTAS
Значительным событием стало распространение новых расширений OLAP, особенно в экосистеме PostgreSQL.
Эти расширения позволяют легко расширять базы данных OLTP, преобразуя эти системы в HTAP (Hybrid Transactional/Analytical Processing) или новый движок баз данных HTAS (Hybrid Transactional Analytical Storage), которые объединяют автономные хранилища данных, такие как data lakes и lakehouses, с системами транзакционных баз данных.
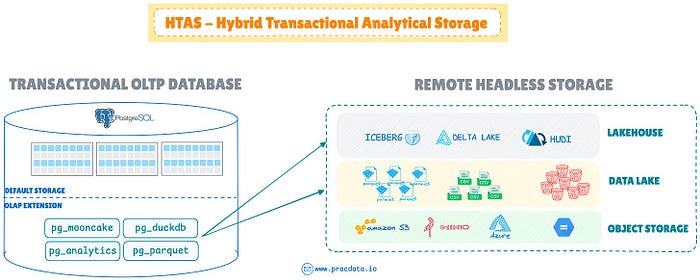
Выпуск MotherDuck pg_duckdb стал крупным достижением, позволившим DuckDB выступать в качестве встроенного OLAP-движка в PostgreSQL. За этим последовало расширение pg_mooncake, предоставляющее встроенные возможности хранения столбцов в открытых табличных форматах, таких как Iceberg и Delta. Crunchy Data и ParadeDB внесли аналогичный вклад в pg_parquet и pg_analytics соответственно, предоставив возможность прямой аналитики по файлам Parquet в озерах данных.
Архитектура с нулевым диском
Архитектура с нулевым диском стала, пожалуй, самой революционной тенденцией в системах хранения данных, в корне изменившей то, как системы баз данных управляют хранилищами и вычислительными уровнями.
Такой архитектурный подход полностью устраняет необходимость в локально подключенных дисках, вместо этого в качестве основного уровня сохраняемости используются удаленные решения для глубокого хранения данных, такие как S3 object storage.
Помимо OLAP-систем хранения, таких как облачные хранилища данных и открытые табличные форматы, мы наблюдаем значительное распространение этого шаблона в NoSQL, системах реального времени, потоковых системах и системах транзакций.
Основным компромиссом между дисковыми и бездисковыми системами является соотношение цены и производительности, а также задержка ввода-вывода при чтении и записи данных в физическое хранилище. В то время как дисковые системы могут выполнять быстрый ввод-вывод за доли миллисекунд, системы с нулевым диском обеспечивают экономию за счет дешевого масштабируемого объектного хранилища за счет задержек до одной секунды при чтении и записи данных в службу хранения объектов.
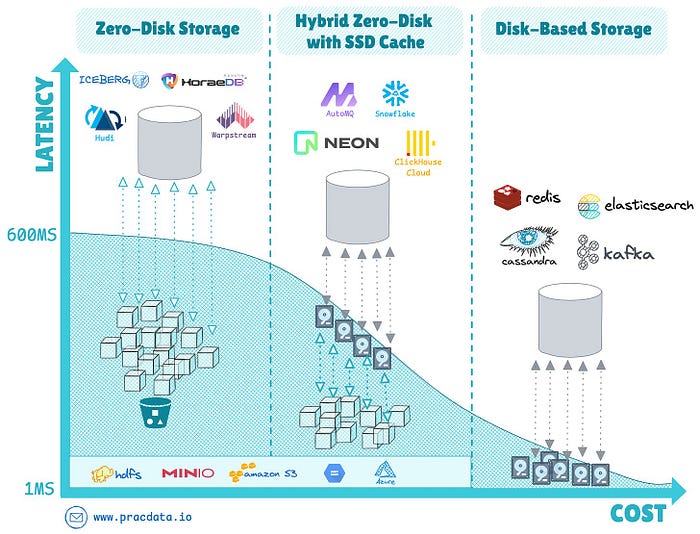
Новые системы баз данных, включая базу данных временных рядов SlateDB и Apache HoraeDB, были созданы с нуля с использованием этой архитектуры, в то время как устоявшиеся системы, такие как Apache Doris и StarRocks, приняли ее в 2024 году. Другие движки реального времени, такие как AutoMQ и InfluxDB 3.0, все чаще используют парадигму нулевого диска.
Другие заметные разработки
После перехода Redis на проприетарную лицензию в 2024 году Valkey стала ведущей альтернативой с открытым исходным кодом, став самой популярной системой хранения данных на GitHub в 2024 году. Крупные облачные провайдеры быстро внедрили его: Google интегрировал его в Memorystore, а Amazon поддерживает через сервисы ElastiCache и MemoryDB.
Другие заметные разработки включают ParadeDB, альтернативу Elasticsearch, построенную на движке PostgreSQL, и новые гибридные потоковые системы хранения данных, такие как Proton от TimePlus и Fluss, представленные Ververica. Эти системы нацелены на интеграцию функций потоковой передачи данных и OLAP с основой столбчатого хранилища.
2. Платформа Data Lake
Поскольку пионер в области баз данных Майкл Стоунбрейкер (Michael Stonebraker) одобрил архитектуру lakehouse и форматы открытых таблиц как "архетип OLAP СУБД на следующее десятилетие", data lakehouse продолжает оставаться самой популярной темой в области разработки данных.
В 2024 году ситуация с форматами открытых столов продолжала существенно меняться. Apache Paimon, четвертый крупный формат открытых столов, завершил инкубацию, предоставив возмоности потоковой передачи в lakehouse благодаря интеграции с Apache Flink. Apache XTable появился как новый проект, ориентированный на двунаправленное преобразование форматов, в то время как Apache Amoro приступил к разработке своей платформы управления lakehouse.
В 2024 году Apache Iceberg зарекомендовал себя как ведущий проект среди фреймворков формата open table, отличающийся расширением экосистемы и показателями репозитория GitHub, включая большее количество звездочек, форков, запросов на извлечение и коммитов.

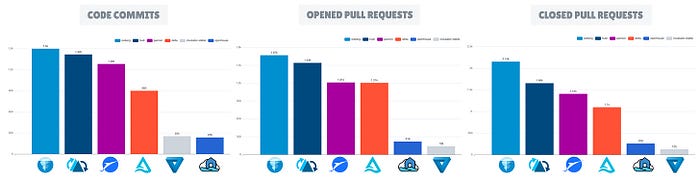
Все основные поставщики SaaS и облачных сервисов совершенствуют свои платформы для поддержки доступа к форматам открытых таблиц. Однако поддержка записи была менее распространена, и Apache Iceberg стал предпочтительным выбором для комплексной интеграции CRUD (создание, чтение, обновление, удаление).
Управляемые таблицы Google BigLake, позволяющие изменять таблицы Iceberg в облачном хранилище, управляемом клиентами, недавно анонсированном Amazon. Таблицы S3 с встроенной поддержкой Iceberg и другие основные инструменты SaaS, такие как Redpanda, запускающий темы Iceberg, и Crunchy Data Warehouse, глубоко интегрированный с Apache Iceberg, являются примерами все более широкого внедрения и глубокой интеграции с Iceberg в экосистеме.
В будущем универсальные табличные форматы, такие как Apache XTable и Delta UniForm (универсальный формат Delta Lake), могут столкнуться со значительными трудностями, связанными с потенциальным расхождением функций в различных форматах, и судьба открытых табличных форматов может повторить судьбу открытых файловых форматов, когда Parquet стал стандартом де-факто.
Поскольку экосистема lakehouse продолжает расти, ожидается, что внедрение совместимых открытых стандартов и фреймворков в рамках платформы открытых данных Lakehouse приобретет все большую популярность.
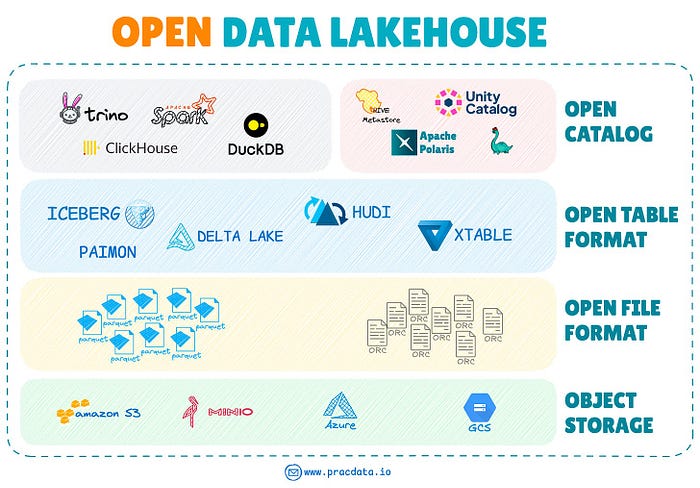
Появление собственных библиотек табличного формата
В экосистеме lakehouse наметилась новая тенденция, направленная на разработку нативных библиотек на Python и Rust. Цель этих библиотек - обеспечить прямой доступ к открытым табличным форматам без использования сложных фреймворков, таких как Spark.
В качестве примера можно привести Delta-rs, нативную библиотеку Rust для Delta Lake с привязками к Python; Hudi-rs, реализация Rust для Apache Hudi с API на Python, и PyIceberg, развивающаяся библиотека на Python, разработанная для расширения доступа к табличному формату Iceberg за пределами стандартного движка Spark.
3. Обработка данных и интеграция
Развитие одноузловой обработки
Распространение одноузловой обработки данных представляет собой фундаментальный сдвиг в обработке данных, бросающий вызов традиционным распределенным подходам.
Недавний анализ показывает, что многие компании переоценили свои потребности в больших данных, что привело к переоценке требований к обработке данных. Даже в организациях с большими объемами данных примерно 90% запросов остаются в пределах допустимой рабочей нагрузки и выполняются на одном компьютере, сканируя только свежие данные.
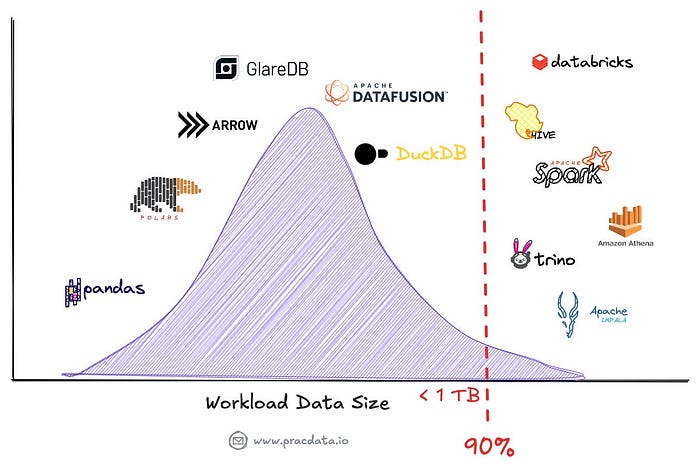
Современные одноузловые системы обработки данных, такие как DuckDB, Apache DataFusion и Polars, стали мощной альтернативой, способной справляться с рабочими нагрузками, для которых ранее требовались распределенные системы, такие как Hive/Tez, Spark, Presto или Amazon Athena.
Потоковая обработка данных
В 2024 году экосистема потоковой обработки продолжала расширяться, и Apache Flink еще больше укрепил свои позиции в качестве ведущего потокового движка, в то время как Apache Spark сохраняет свои сильные позиции.

Отмечая свое 10-летие, компания Flink выпустила версию 2.0, которая стала первым крупным обновлением с момента выхода Flink 1.0 восемь лет назад. Экосистема Apache Flink значительно расширилась благодаря внедрению формата Apache Paimon open table и новой версии с открытым исходным кодом. Потоковый движок Fluss. В 2024 году ведущие поставщики облачных сервисов все чаще интегрируют Flink в свои управляемые сервисы, последним из которых стало решение Google BigQuery Engine для Apache Flink без сервера.
Среди новых движков потоковой передачи - Fluvio, Arroyo и FastStream, которые стремятся конкурировать с этими известными конкурентами. Fluvio и Arroyo выделяются как единственные движки на базе Rust, которые направлены на устранение накладных расходов, обычно связанных с традиционными движками потоковой обработки на базе JVM.
В основных новостях о потоковом вещании с открытым исходным кодом Redpanda приобрела Benthos.dev, переименовав его в Redpanda Connect и переведя на более закрытую лицензию. В ответ WarpStream разветвила проект Benthos, переименовав его в Bento и обязавшись на 100% поддерживать лицензию MIT.
Платформы для обработки данных на Python
В экосистеме обработки данных Python Polars в настоящее время является доминирующей высокопроизводительной библиотекой фреймворков данных для рабочих нагрузок, связанных с разработкой данных (за исключением PySpark). В 2024 году Polars получила впечатляющие 89 миллионов загрузок, что стало важной вехой с выходом версии 1.0.
Однако Polars теперь сталкивается с конкуренцией со стороны DuckDB DataFrame API, который привлек внимание сообщества благодаря своей удивительно простой интеграции с внешними системами хранения и интеграции с нулевым копированием (прямое совместное использование памяти между различными системами) с Apache Arrow - аналогично Polars. Обе библиотеки вошли в топ-1% самых скачиваемых библиотек Python в прошлом году.
Apache Arrow укрепила свои позиции в качестве фактического стандарта представления данных в памяти в экосистеме обработки данных Python. Фреймворк обеспечивает глубокую интеграцию с различными платформами обработки данных на Python, включая Apache DataFusion, Ibis, Daft, cuDF и Pandas 3.0.
Ibis и Daft - это другие инновационные проекты DataFrame с большим потенциалом. Ibis предлагает бесшовный внутренний интерфейс для различных баз данных на базе SQL, а Daft предоставляет возможности распределенных вычислений, созданные с нуля для поддержки распределенной обработки фреймов данных.
4. Организация рабочего процесса и обработка данных.
В 2025 году категория "Оркестрация рабочих процессов с открытым исходным кодом" продолжает оставаться одним из наиболее динамично развивающихся сегментов экосистемы разработки данных, в которой представлено более 10 активных проектов, начиная от устоявшихся платформ, таких как Apache Airflow, и заканчивая новыми движками с открытым исходным кодом, такими как Maestro от Netflix.
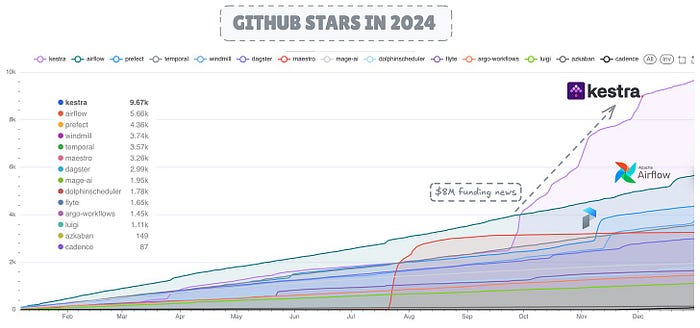
Спустя десятилетие Apache Airflow по-прежнему остается наиболее широко используемым механизмом организации рабочих процессов с ошеломляющим количеством загрузок (320 млн) только в 2024 году, несмотря на растущую конкуренцию со стороны таких компаний, как Dagster, Prefect и Kestra.

Интересно, что в 2024 году Kestra набрала больше всего звезд на GitHub, и этот всплеск был напрямую связан с объявлением о финансировании в размере 8 миллионов долларов в сентябре, которое было опубликовано на TechCrunch. С точки зрения работы с кодом, Dagster продемонстрировал выдающуюся активность в разработке, выполнив впечатляющие 27 тыс. коммитов и закрыв около 6 тыс. запросов на извлечение в 2024 году.
Качество данных
Great Expectations продолжает оставаться ведущим фреймворком на Python для обеспечения качества данных и проверки достоверности, который также представлен в Databrick's Топ-10 проектов в области обработки данных и искусственного интеллекта 2024 года, за которыми следуют Soda и Pandera в области разработки данных. Однако есть несколько разочаровывающих новостей: проект Data-Diff был заархивирован его главным разработчиком, компанией Datafold, в 2024 году.
Управление версиями данных
Управление версиями данных остается актуальной темой в 2024 году, поскольку продолжаются усилия по внедрению возможностей современных систем контроля версий, таких как Git, в data lakes и lakehouses.
Такие проекты, как LakeFS и Nessie, расширяют возможности современных хранилищ данных и открытых табличных форматов, таких как Iceberg и Delta Lake, за счет расширения их уровней транзакционных метаданных.
Преобразование данных
Сфера применения dbt для преобразования данных выходит за рамки первоначального подхода к моделированию данных в системах хранилищ данных. В настоящее время dbt внедряется во внешние хранилища, такие как data lakes, благодаря новым интеграциям и плагинам, которые используют эфемерные вычислительные механизмы, такие как Trino.
В настоящее время dbt сталкивается с конкуренцией, в первую очередь со стороны SQLMesh. Заметным противостоянием в 2024 году стали дебаты между SQLMesh и dbt, на которые обратил внимание генеральный директор Tobiko, заявивший в социальных сетях, что SQLMesh настолько хорош, что его запретили на конференции dbt Coalesce!
5. Интеграция данных
В области интеграции данных Airbyte сохранила лидирующие позиции, достигнув впечатляющего результата, закрыв 13 тыс. запросов на обновление в рамках подготовки к версии 1.x. Платформа dlt продемонстрировала значительное развитие в версии 1.0, в то время как Apache SeaTunnel завоевал популярность как привлекательная альтернатива.
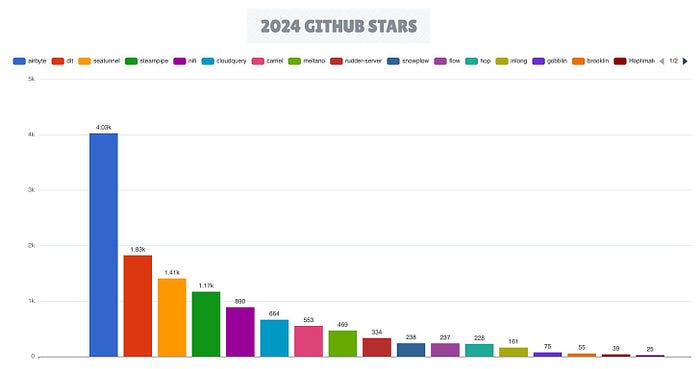
Фреймворк для сбора данных об изменениях (CDC) пополнился новыми инструментами, включая Artie Transfer и PeerDB (приобретены ClickHouse), в то время как коннекторы Flink CDC завоевывают популярность среди платформ, использующих Flink в качестве основного механизма потоковой передачи.
Event-центры (потоковые публичные/вспомогательные сервисы).
Одним из наиболее заметных нововведений в области интеграции данных в 2024 году стало развитие системы потоковой передачи данных. Существенным архитектурным сдвигом в этой категории является разделение функций хранения и вычислений в сочетании с внедрением объектного хранилища в архитектуре с нулевым использованием диска. WarpSteram является пионером в области внедрения этой архитектуры в потоковом пространстве в режиме реального времени.
Эта модель также обеспечивает гибкую стратегию развертывания в "Собственном облаке" (BYOC), поскольку как вычислительные ресурсы, так и хранилища могут размещаться в предпочитаемой инфраструктуре заказчика, в то время как поставщик услуг поддерживает уровень управления.
Успех WarpStream побудил основных конкурентов перейти на аналогичные архитектуры. Redpanda запустила Cloud Topics, расширив свои предложения, в то время как AutoMQ внедрила гибридный подход с использованием уровня быстрого кэширования для повышения производительности ввода-вывода.
Кроме того, StreamNative представила движок Ursa для Apache Pulsar, а Confluent в 2024 году представила свои собственные облачные транспортные кластеры. В конечном итоге Confluent решила приобрести WarpStream, расширив свое предложение за счет модели BYOC. Между тем, замечательный Apache Kafka находится на перепутье, которое может определить его будущее направление в экосистеме.
6. Инфраструктура данных
Инфраструктура обработки данных в 2024 году оставалась в целом стабильной: Kubernetes отпраздновала свое 10-летие, сохранив при этом позиции ведущего механизма планирования ресурсов и виртуализации в облачных средах.
В области обеспечения наблюдаемости InfluxDB, Prometheus и Grafana продолжили доминировать, а Grafana Labs привлекла значительное финансирование в размере 270 миллионов долларов, что укрепило долгосрочную жизнеспособность их основных продуктов, таких как Grafana, в качестве универсальных решений для обеспечения наблюдаемости.
7. Платформа ML/AI
С 2023 года векторные базы данных набирают обороты, и Milvus становится лидером наряду с Qdrant, Chroma и Weaviate. В настоящее время в категорию входят десять активных проектов по созданию векторных баз данных, что отражает растущую важность возможностей векторного поиска в современных архитектурах данных с поддержкой искусственного интеллекта.

Появление LLMOps (также называемых GenOps) в качестве отдельной категории в представленном в этом году обзоре ознаменовалось быстрым ростом новых проектов, таких как Dify и vLLM, специально созданных для управления моделями LLM.
8. Управление метаданными
Платформы для управления метаданными в последние годы получили значительный импульс, и DataHub лидирует в области открытого исходного кода благодаря активному развитию и вовлечению сообщества.
Однако наиболее заметные изменения в 2024 году произошли в области управления каталогами. В то время как в 2023 году преобладала конкуренция в формате открытых столов, 2024 год ознаменовался началом войны за каталоги.
В отличие от предыдущих лет, 2024 год принес на рынок волну новых решений для создания открытых каталогов, включая Polaris (с открытым исходным кодом от Snowflake), Unity Catalog (с открытым исходным кодом от Databricks), LakeKeeper и Apache Gravitino.
Такое распространение отражает осознание того, что появляющимся платформам data lakehouse, которые в значительной степени основаны на форматах открытых таблиц, не хватает расширенных встроенных возможностей управления каталогами для бесперебойной работы с несколькими движками.
Все эти проекты потенциально могут установить новый стандарт для независимых от поставщиков сервисов открытых каталогов на платформах data lakehouse. Подобно тому, как Hive Metastore стал стандартом де-факто для платформ на базе Hadoop, эти новые каталоги могут, наконец, заменить давнее доминирующее положение Hive Metastore в управлении каталогами на платформах открытых данных.
9. Аналитика и визуализация
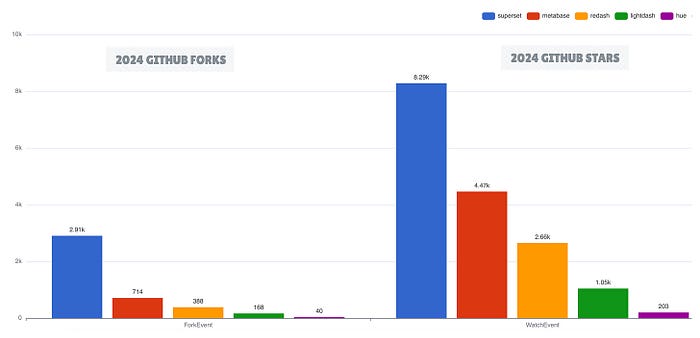
В области бизнес-аналитики с открытым исходным кодом Apache Superset и Metabase остаются ведущими BI-решениями. В то время как Superset лидирует по популярности на GitHub, Metabase демонстрирует наибольшую активность в разработке. Компания Lightdash стала многообещающим новичком, обеспечив финансирование в размере 11 миллионов долларов и продемонстрировав рыночный спрос на облегченные BI-решения.
Решения BI-as-Code
Технология BI-as-Code выделилась в отдельную категорию благодаря постоянному успеху Streamlit, которая сохранила свои позиции самого популярного решения для работы с BI-as-Code.
Эти инструменты позволяют разработчикам создавать интерактивные приложения и облегченные информационные панели BI с использованием кода, SQL и шаблонов, таких как Markdown или YAML, объединяя лучшие практики разработки программного обеспечения, такие как контроль версий, тестирование и CI/CD, в рабочий процесс разработки информационной панели.
В дополнение к Streamlit и хорошо известным Evidence, новые участники, такие как Quary и Vizro, получили поддержку, причем Quary, в частности, внедрил подход, основанный на Rust, который отличается от стандарта, ориентированного на Python.
Компонуемый стек BI.
Эволюция системной декомпозиции не ограничивается системами хранения данных; она также повлияла на стеки бизнес-аналитики (BI). Появляется новая тенденция, которая сочетает в себе легкие, бездонные инструменты BI (которые не имеют внутреннего сервера) с простыми встраиваемыми OLAP-решениями, такими как Apache DataFusion, Apache Arrow и DuckDB.
Эта интеграция устраняет несколько пробелов в стеке BI с открытым исходным кодом, таких как встроенная возможность запрашивать внешние хранилища данных, сохраняя при этом преимущества облегченных, дезагрегированных архитектур.
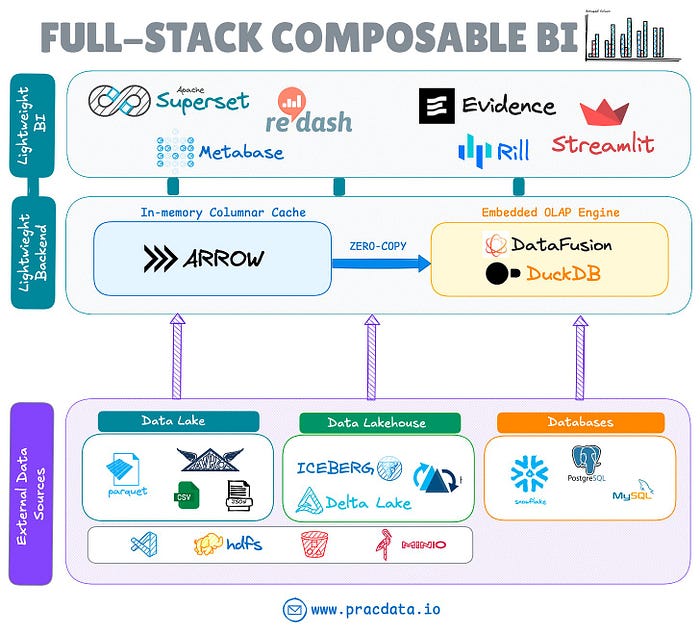
Продукты BI, такие как Omni, GoodData, Evidence и Rilldata, уже включили эти движки в свои инструменты BI и исследования данных. Как Apache Superset (использующий библиотеку duckdb-engine), так и Metabase теперь поддерживают встроенные подключения к базе данных DuckDB.
Движки запросов MPP
В эпоху после Hadoop было мало инноваций и внедрения новых систем MPP (массово параллельной обработки) с открытым исходным кодом, в то время как существующие движки продолжают совершенствоваться.
Несмотря на то, что доля Hive сокращается, Presto и Trino по-прежнему остаются ведущими системами обработки запросов MPP с открытым исходным кодом, используемыми в производстве, несмотря на жесткую конкуренцию со стороны Spark как единого движка и управляемых облачных MPP-продуктов, таких как Databricks, Snowflake и AWS Redshift Spectrum plus Athena.
Перспективы на будущее и выводы
Экосистема данных с открытым исходным кодом вступает в фазу зрелости в таких ключевых областях, как data lakehouse, для которой характерна консолидация на основе проверенных технологий и повышенное внимание к операционной эффективности.
Рынок продолжает развиваться в направлении облачных, компонуемых архитектур при одновременной стандартизации доминирующих технологий. К ключевым областям, на которые стоит обратить внимание, относятся:
- Продолжающееся развитие архитектур с нулевым использованием дисков в системах реального времени и транзакционных системах
- Дальнейшая консолидация в формате open table
- Стремление к созданию единого интерфейса lakehouse
- Развитие LLMOps и технологий искусственного интеллекта
- Расширение экосистемы data lakehouse в таких областях, как интеграция открытых каталогов и разработка собственных библиотек
- Растущее распространение одноузловой обработки данных и встроенной аналитики


