

Модель метаданных и таксономия
Модель метаданных и таксономия являются центральными элементами любого проекта по внедрению Data Catalog в компании. Это фундамент, на котором строится понимание того, какие данные существуют, как они устроены, кто отвечает за них, как они связаны между собой и как ими можно безопасно пользоваться. В рамках курса по внедрению Data Catalog в компании каталог данных мы разберём, что такое метаданные, какие виды метаданных нужны для эффективного каталога, как формируется таксономия и глоссарий, какие методологии применяются на практике, какие технические решения можно использовать как в открытом доступе, так и в рамках российского рынка, а также какие риски и ограничения следует учитывать на разных этапах проекта.
Термины и базовые понятия
- Метаданные: информация, которая описывает данные. Они помогают понять происхождение данных, их структуру, качество, владельца, контекст использования и многие другие характеристики. Метаданные делят на технические (структура таблиц, схемы, форматы файлов, источник) и бизнес-метаданные (термины бизнеса, ответственность за данные, цели использования, политика доступа).
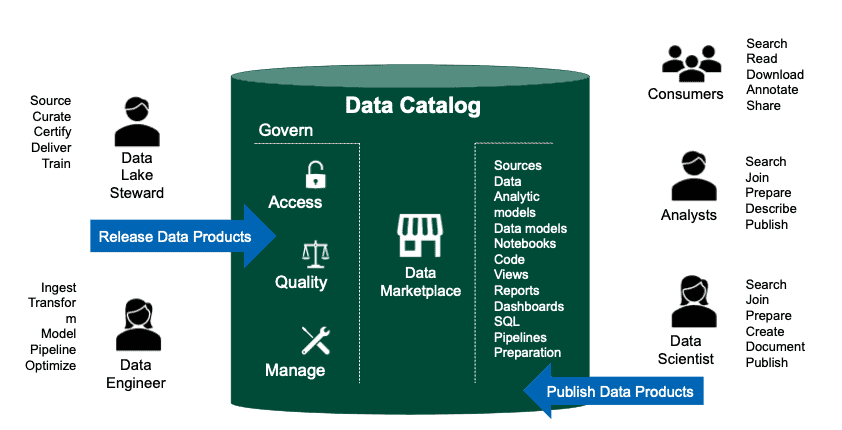
- Каталог данных (Data Catalog): системный репозиторий метаданных, включающий инструменты поиска, навигации, обогащения метаданных, управления доступом и визуализации контекста данных. Цель каталога — ускорить поиск, понять контекст и обеспечить ответственное использование данных.
- Таксономия: формальная система категоризации, которая описывает иерархическую структуру понятий. В каталоге таксономия помогает группировать данные по бизнес-тематике, субтемам и атрибутам, облегчает поиск и согласование терминов между подразделениями.
- Глоссарий терминов (Glossary): набор определений бизнес-терминов и их атрибутов, связанных с данными. Глоссарий дополняет таксономию, давая единые определения для общих понятий и терминов.
- Онтология: более формальная модель знаний, объединяющая термины и их взаимоотношения в виде графа, который может использоваться для семантического поиска и автоматических выводов.
- Модель метаданных: набор сущностей и их связей, описывающий, как устроен каталог и что именно он хранит. Обычно выделяют концептуальную, логическую и физическую уровни моделей.
- DCAT: стандарт Data Catalog Vocabulary, используемый для описания наборов данных и их ресурсов в каталогах данных. В европейском контексте часто применяется DCAT-AP (DCAT Application Profile), адаптированное под национальные требования.
- OpenLineage, lineage: набор стандартов и практик получения и передачи информации о происхождении и трансформациях данных между источниками и потребителями.
- Правила политики доступа и соответствия: регламенты, которые описывают, кто может видеть, изменять и публиковать метаданные и сами данные, с учётом требований безопасности и законодательства.
Теоретическая модель данных в каталоге
Уровни абстракции: концептуальный (что такое dataset и как он используется бизнесом), логический (как данные организованы внутри системы: таблицы, поля, зависимости) и физический (реальные источники данных, файлы, базы данных, хранилища).
Основные сущности каталога:
- DataSet/DataAsset: единица данных, часто таблица, файл или представление.
- DataColumn/DataAttribute: отдельный столбец в наборе данных или поля внутри файла.
- DataSource/SourceSystem: источник данных (БД, хранилище, поток).
- Owner/Steward: лица, ответственные за данные.
- BusinessTerm/GlossaryTerm: термины бизнеса и их определения.
- DataQualityRule/QualityMetric: правила и метрики качества данных.
- Lineage/Provenance: источники происхождения и трансформационные процессы данных.
- Tag/GlossaryTermRelation: теги и связи между терминами.
Виды метаданных по функциям:
- Операционные метаданные: времена обновления, частота загрузок, зависимости между процессами.
- Технические метаданные: структура, формат, схемы, хранения, версии.
- Бизнес-метаданные: смысл, контекст использования, назначение, нормативные требования.
Взаимодействие между моделями: глоссарий и таксономия служат ориентиром для классификации, в то время как слой lineage и политики доступа связывают данные с операциями и требованиями регуляторов.
Таксономия и управление лексикой
- Цели таксономии: унификация терминологии, упрощение поиска, снижение двойного учета данных, упрощение обучения сотрудников.
- Структура таксономии: верхний уровень (область бизнеса), после идут более детальные классы (функциональные области, предметные области, подпредметные области) и внизу конкретные термины и их атрибуты.
- Связь таксономии и метаданных: каждый набор данных и его элементы могут быть привязаны к одному или нескольким терминам, что позволяет осуществлять поиск по бизнес-контексту (например, "финансы", "клиент", "покупка").
- Глоссарий в рамках таксономии: термины должны иметь четкие определения, примеры использования и допустимую грамматику для именования.
- Методы разработки: участие бизнес-координаторов, итеративное добавление терминов (bottom-up) в сочетании с руководством сверху (top-down), обратная связь с пользователями, регулярные ревизии и удаление устаревших терминов.
- Управление изменениями: версионирование терминов, эволюционные изменения, документирование причин изменений и уведомления для пользователей каталога.
Архитектура внедрения и интеграции
- Архитектура каталога обычно включает следующие компоненты: хранилище метаданных, движок поиска индекса, REST/GraphQL API, пользовательский интерфейс, коннекторы к источникам метаданных, механизмы обогащения метаданных, модуль lineage, модуль управления доступом и аудит.
- Источники метаданных: РСУБД (PostgreSQL, Oracle, MySQL), хранилища данных (Hive, HDFS, S3, Hudi), BI-инструменты (Power BI, Tableau), поточные системы (Kafka), ETL/пакеты обработки (Spark, Airflow), документы и файлы (Parquet, CSV, JSON).
- Методы наполнения и обогащения: прямой импорт, автоматическое извлечение схем, парсинг документации, интеграция с OpenLineage, ручной ввод и утверждение.
- Безопасность и соответствие: интеграция с системой идентификации и управления доступом (IdP, RBAC/ABAC), аудит изменений, защита PII и других чувствительных данных, поддержка локализации и гражданских требований.
- Метрики успеха: полнота заполненности критических наборов, точность описания бизнес-терминов, скорость поиска, качество линий передачи данных, число активных пользователей и число публикаций новых терминов.
Методологии внедрения
- Поэтапный подход: начиная с пилота на нескольких бизнес-направлениях, затем расширение на всю компанию.
- Принципы совместной разработки: вовлечение бизнес-пользователей, ИТ и правоохранительных органов в разработку таксономии и политики.
- Управление изменениями: средства коммуникации, обучение сотрудников, документация, поддержка новой практики.
- Гештинг и качество: создание процессов проверки и очистки метаданных, регулярная ревизия терминосистемы, мониторинг использования каталогов.
- Выбор стратегий межеобразования: top-down для ключевых терминов и bottom-up для повседневного использования, чтобы быстро охватить реальный контент и поддержать пользователя в рабочем процессе.
Практические примеры
1. Открытые источники (open-source)
- Apache Atlas: один из ведущих проектов для управления метаданными и lineage в экосистеме Hadoop. Он позволяет определить типы метаданных (DataSet, DataTable, DataColumn, DataSource, DataProcess и т.д.), задать свойства, связи между ними и настроить политики доступа. Привязка таксономии осуществляется через пользовательские типы и термины; для бизнес-терминов можно встроить глоссарий и словарь, а также подключить внешнюю справочную систему терминов. Для примера можно создать тип DataSet с атрибутами name, description, owner, ownerTeam, ownerEmail, dataCategory (из таксономии), lineage к DataProcess, который описывает источник данных и преобразование.
- Amundsen: легковесное решение для построения каталога данных с упором на поиск и контекст данных. В Amundsen есть понятия Dataset, Column, Tag и Glossary Term. В рамках таксономии можно использовать теговую систему и внешнюю справочную таблицу терминов. Пример практического сценария: при импорте набора данных из Hive создаётся Dataset и его Columns; каждому Dataset назначаются теги по бизнес-терминам, а через интеграцию с Glossary Terms добавляются определения. Это позволяет сотрудникам быстро понять контекст набора и требования к нему.
- DataHub: современная платформа каталога данных с поддержкой концептов Dataset, Aspect, GlossaryTerm, Domain и других. DataHub удобен для визуализации связей между наборами данных и их источниками, а также для управления глоссариями и таксономиями в формате графа. Пример: создать домен финансов, в который входят наборы данных продаж, бюджет и прочие; привязать к терминологии бизнес-термины и описания. OpenLineage может использоваться для пополнения lineage между источниками и преобразованиями.
- CKAN (популярная платформа для открытых данных): CKAN хорошо подходит для создания институциональных catalog-порталов, которые требуют гибкую схему полей и плагинов. В CKAN можно определить поля для бизнес-метаданных, добавить плагин для интеграции с глоссарием и настроить фильтры по таксономии. В рамках проекта можно реализовать минимальный набор терминов и связать их с наборами данных через теги и расширения.
2. Российские решения и практики
- Государственные порталы открытых данных: российский портал data.gov.ru реализован на базе CKAN и сопутствующих технологий; этот проект демонстрирует практику применения открытых данных на базе отечественных решений и позволяет посмотреть, как организована таксономия, глоссарий и наборы метаданных в крупном масштабе. В рамках такого кейса можно изучать подходы к управлению метаданными, соответствию требованиям регуляторов, а также интеграцию с отечественными системами ИБ и управления доступом.
- Вендорные и интеграционные кейсы в РФ: отечественные интеграторы и поставщики услуг предлагают решения по внедрению каталогов на базе открытых проектов (CKAN, Apache Atlas, DataHub) с адаптациями под российские требования безопасности и локализации. Эти кейсы обычно включают настройку RBAC/ABAC, интеграцию с IdP, настройку контроля доступа к данным, обеспечение аудита и соответствия требованиям национального законодательства.
- Практики построения глоссариев и таксономий в российских организациях: на реальном примере можно видеть создание бэклогов бизнес-терминов, участие бизнес-единиц в формировании терминов, регулярные ревизии и согласование новых терминов. Важно учитывать требования регуляторов к локализации данных и регионализации данных, что влияет на выбор архитектуры и инструментов.
Практические шаги в рамках проекта
- Шаг 1. Определение объёма и целей: какие подразделения будут пользоваться каталогом, какие наборы данных планируются каталогизировать в первую очередь; формирование минимально необходимого набора бизнес-терминов.
- Шаг 2. Формирование таксономии и глоссария: совместная работа бизнес-подразделений; создание и утверждение ключевых терминов и их определений; установление правил именования.
- Шаг 3. Выбор технологической основы: решение между Atlas, Amundsen, DataHub или CKAN в зависимости от инфраструктуры, требований к lineage, поддержки Russian requirements и доступности специалистов.
- Шаг 4. Интеграция источников метаданных: подключение к РСУБД, Data Lake/хранилищам, потоковым системам; настройка экспорта схем и структур, а также автоматическое извлечение части метаданных.
- Шаг 5. Обогащение и качество: добавление бизнес-терминов, описание набора данных, определение владельцев, назначение ответственных за данные; внедрение базовых метрик качества.
- Шаг 6. Публикация и обучение пользователей: настройка доступа, создание обучающих материалов, внедрение процесса обновления метаданных и подготовки данных к потреблению.
- Шаг 7. Мониторинг и эволюция: регулярная ревизия таксономии, введение новых терминов, мониторинг использования каталога и корректировка подхода.
Модель метаданных и примеры структур
Основные сущности:
  DataSet: id, name, description, owner, steward, sourceSystem, dataCategory (ссылка на термин таксономии), frequency, lastUpdated, lineageInfo.
  DataColumn: id, name, dataType, isNullable, description, businessTerm (ссылка на термин глоссария), columnOrder.
  DataSource: id, name, type (RDBMS, Hadoop, S3, Kafka и т.д.), connectionInfo.
  BusinessTerm: id, term, definition, domain (ссылка на раздел таксономии), synonyms.
  GlossaryTerm: id, term, definition, relatedTerms, examples.
  Lineage: sourceDataset, targetDataset, processName, transformationLogic, timestamp.
  DataQualityRule: id, ruleName, description, metric, threshold, owner.
Пример JSON-структуры для DataSet в рамках REST API:
  {
    "name": "sales.orders",
    "description": "Заказы клиентов за прошедший период",
    "owner": "FInanceDataTeam",
    "steward": "DataStewardTeam",
    "sourceSystem": "ERP_Sales",
    "dataCategory": "Finance",
    "frequency": "Daily",
    "lastUpdated": "2025-09-01T00:00:00Z",
    "columns": [
      {"name": "order_id", "dataType": "STRING", "isNullable": false, "description": "Идентификатор заказа", "businessTerm": "Order ID"},
      {"name": "order_date", "dataType": "DATE", "isNullable": false, "description": "Дата заказа", "businessTerm": "Order Date"},
      {"name": "amount", "dataType": "DECIMAL(18,2)", "isNullable": true, "description": "Сумма заказа", "businessTerm": "Order Amount"}
    ],
    "lineage": [
      {"processName": "ETL_Sales_Orders", "sourceDataset": "raw_sales.orders_raw", "targetDataset": "sales.orders"}
    ],
    "quality": {"rules": [{"name": "not_null_order_id", "description": "order_id не может быть NULL", "threshold": "NOT NULL"}]}
  }
Стандарты и форматы описания
- DCAT/DCAT-AP: применяется для описания наборов данных и цепочек их публикации; поддерживает поля таких категорий, как title, description, keywords, themeTaxonomy (ссылка на термины таксономии), dataAccessURI, distribution, frequency, modified, publisher.
- Schema.org: полезен для интеграции со внешними поисковыми системами и внутренними сервисами; может использоваться для описания набора данных и его связанных ресурсов.
- Dublin Core: базовые элементы описания (title, creator, subject, description, publisher, date, type, format, identifier, language, relation, coverage, rights).
Интеграция и технологии
- Хранилище метаданных: PostgreSQL/MySQL как традиционные SQL-решения; графовые базы данных (JanusGraph, Neo4j) для сложных графовых связей таксономий и lineage; индексные слои на Elasticsearch/OpenSearch для ускоренного поиска.
- Поиск и индексация: OpenSearch/Elasticsearch как движок полнотекстового поиска; cosine-меры и ранжирование по релевантности и контексту.
- API и UI: REST или GraphQL API; веб-интерфейс для просмотра метаданных, управления терминами и утверждениями; возможность экспорта данных в DCAT-JSON/TTL.
- Интеграция источников: коннекторы к БД (через JDBC), к хранилищам (HDFS, S3), к потокам (Kafka Connect), к ETL-инструментам (Airflow, Prefect); использование OpenLineage для автоматического извлечения lineage.
- Безопасность: интеграция с IdP (SAML/OAuth2/OIDC), RBAC/ABAC, аудит изменений, шифрование метаданных в покое и в передаче.
Пример архитектурного решения
- Компоненты: источник данных (RDBMS/HDFS/Kafka), коннектор метаданных, слой метаданных (каталог), индекси поиска, API и UI, модуль lineage, модуль политики доступа.
- Потоки данных: сбор метаданных из источников → нормализация и обогащение → сохранение в хранилище метаданных → индексирование в поисковом слое → доступ пользователя через UI/API.
- Применение OpenLineage: обеспечение стандартизированного обмена данными о lineage между системами источников и целевых систем каталога.
Риски и ограничения внедрения
- Сложность проектирования таксономии: если таксономия не отражает бизнес-реальность, пользователи будут воспринимать каталог как «мусор» и не будут его использовать.
- Качество метаданных: неполные, устаревшие или противоречивые метаданные снижают полезность каталога.
- Масштабирование: большие пайплайны и огромное количество наборов данных требуют горизонтального масштабирования хранилища и быстрого индекса поиска.
- Совместимость и интеграция: разные источники и форматы требуют адаптеров и консистентной политики обновления метаданных.
- Безопасность и конфиденциальность: обработка ПД, чувствительной информации и соблюдение локального законодательства (например, требований к локализации данных) критически важны.
- Регуляторные и юридические риски: несоблюдение норм может привести к штрафам и reputational damage.
- Временные издержки и ресурсы: создание и поддержка метаданных требует времени от экспертов по бизнес-логике и инженеров данных; поддержка должен быть встроена в процессы.
- Привязка к конкретной платформе: риск «vendor lock-in» при выборе коммерческих решений; для open-source это риск зависимости от сообщества и уровня поддержки.
- Эволюция терминологии: термины бизнеса меняются, и требуется регулярное обновление таксономии и глоссария.
Советы по минимизации рисков
- Начните с пилота на нескольких бизнес-областях, чтобы протестировать терминологию и сценарии поиска.
- Включайте бизнес-пользователей в процесс разработки таксономии и глоссария; поддерживайте документирование изменений.
- Автоматизируйте сбор и обновление метаданных там, где это возможно (Lineage, схемы баз данных, схемы в хранилищах).
- Обеспечьте прочную политику доступа и аудит; разделяйте роли владельцев данных и пользователей.
- Планируйте миграцию и эволюцию таксономии; сохраняйте версии терминов и прозрачные уведомления об изменениях.
- Развивайте культуру качества данных: внедряйте базовые правила качества и отчётность по ним.
- Придерживайтесь рекомендаций по локализации и регулятивным требованиям, особенно в отношении персональных данных.
Модель метаданных и таксономия — это не просто набор полей и словарей. Это управляемый и эволюционирующий контекст, который связывает людей, данные и процессы. Правильно выстроенная таксономия упрощает поиск, повышает качество использования данных и облегчает соблюдение регуляторных требований. Внедрение каталога требует баланса между техническими решениями и организационными практиками: комфортное взаимодействие бизнес-пользователей с техническими специалистами, четкие правила управления метаданными, а также постепенное внедрение и расширение по мере зрелости практик управления данными. В открытом пространстве есть достойные инструменты (Atlas, Amundsen, DataHub, CKAN), которые позволяют начать работу и постепенно развивать таксономию и глоссарий, а также существуют российские практики применения на базе CKAN и локальных решений для удовлетворения требований локализации и регуляторной совместимости. Важно помнить: каталог становится полезным не сам по себе, а через качество и полноту метаданных, актуальность терминов и ясность бизнес-контекста, который он передает пользователям.
Вопрос–Ответ (FAQ)
1) Что именно включает в себя понятие «модель метаданных» в контексте каталога?
Модель метаданных описывает сущности каталога и их связи: наборы данных (DataSet), столбцы (DataColumn), источники данных (DataSource), владельцы и ответственные лица (Owner/Steward), бизнес-термины (BusinessTerm) и термины глоссария (GlossaryTerm), а также линии происхождения (Lineage) и правила контроля качества (DataQualityRule). Модель имеет уровни абстракции: концептуальный, логический и физический, что позволяет строить гибкую архитектуру, пригодную как для бизнес-потребностей, так и для технических реализаций.
2) В чем принципиальная разница между таксономией и глоссарием?
Таксономия — это иерархическая классификационная структура, которая группирует термины по темам и областям бизнеса. Глоссарий — это набор определений бизнес-терминов и их описаний. Таксономия обеспечивает навигацию и классификацию, глоссарий — единые определения и уточнения смысла терминов для всех пользователей. Вместе они позволяют не только находить данные, но и понимать их контекст и требования к использованию.
3) Какие открытые решения стоит рассмотреть для старта проекта?
К популярным открытым решениям относятся Apache Atlas, Amundsen, DataHub и CKAN. Atlas хорошо подходит для сложной метаданных и lineage в рамках экосистем Hadoop. Amundsen и DataHub ориентированы на поиск и контекст данных, имеют удобные модели для интеграции глоссариев и терминов. CKAN — мощный инструмент для порталов открытых данных и может быть адаптирован под внутренний каталог в рамках корпоративной инфраструктуры. Выбор зависит от инфраструктуры, потребностей в lineage и подходах к безопасности.
4) Какие примеры практического внедрения можно привести в российских условиях?
Российские практики включают использование CKAN в рамках порталов открытых данных и адаптацию под требования локализации и регуляторной совместимости. Примеры такого подхода можно наблюдать в государственных открытых данных (data.gov.ru) и в кейсах российских интеграторов, которые реализуют каталоги на базе открытых проектов с учетом локальных требований безопасности и данных. В рамках корпоративных проектов в РФ часто применяется гибридная архитектура на базе открытых технологий с локализацией и дополнительными модулями для аудита и соответствия регуляторным требованиям.
5) Какую роль играет DCAT/DCAT-AP в каталоге?
DCAT — единый формат описания наборов данных и их распределений, что упрощает обмен метаданными между системами и порталами. DCAT-AP адаптирует этот стандарт под региональные и отраслевые требования. Использование DCAT позволяет экспортировать и импортировать данные о наборах в виде структурированных JSON/TTL/XML документов, облегчая интеграцию между внутренними каталогами и внешними порталами.
6) Какие технические решения и архитектуры чаще всего выбирают для масштабирования?
Чаще всего используются сочетания: реляционные базы данных (PostgreSQL/MySQL) для хранения основной метадаты, графовые базы данных (JanusGraph/Neo4j) для сложных графовых связей и lineage, индексные слои на Elasticsearch/OpenSearch для быстрого поиска, а также API-слои (REST/GraphQL) и UI. При больших объемах данных критично продумать импорты и обновления, а также обеспечить горизонтальное масштабирование и эффективный контроль доступа.
7) Какие риски наиболее критичны на этапе внедрения?
Ключевые риски включают неэффективную или противоречивую таксономию, плохое качество метаданных, сложности интеграции с источниками данных, проблемы с безопасностью и соответствием, а также риск «vendor lock-in» при выборе проприетарных решений. Эти риски снижаются через пилотные проекты, участие бизнес-пользователей, автоматизацию импорта метаданных, строгие политики доступа и регулярные ревизии терминов и данных.
8) Какой подход к управлению изменениями в терминах и таксономии можно порекомендовать?
Рекомендуется использовать версионирование терминов и таксономии, документировать причины изменений, уведомлять пользователей о важных обновлениях и внедрять процессы согласования между бизнес-единицами. Важно сохранять историю терминов и поддерживать четкую коммуникацию о том, какие термины устарели и какие замещают их.
9) Как поддерживать каталог после запуска?
После запуска следует поддерживать процесс обогащения и качества метаданных: регулярно обновлять схемы, синхронизировать данные из источников, привлекать бизнес-лиц к внесению изменений, проводить периодическую чистку устаревших терминов, продвигать культуру ответственного использования данных, а также проводить обучение пользователей и обновлять документацию по методологии таксономий.
10) Где можно найти дополнительные ресурсы и обучение?
Полезные ресурсы включают открытые проекты Atlas, Amundsen, DataHub и CKAN, а также официальную документацию DCAT и DCAT-AP. Для российского рынка полезны кейсыdata.gov.ru и практики российских интеграторов по адаптации к требованиям локализации и регуляторики. Дополнительно можно изучать публичные материалы по управлению метаданными, разработке глоссариев и методологиям управления качеством данных.


