

Нетипичные сценарии использования BI-системы (Apache Superset)
Статья представлена для ознакомления и удобства пользователей, оригинал опубликован на Хабре, автор: @plotn1
Сегодня поговорим о немного нетипичной для меня теме, а именно - Apache Superset. Обычно я пишу длинные "философские" статьи "на свободную тему", но в этот раз - это будет туториал. Так что кому-то может показаться банальностью, но, опять таки, вдруг кому поможет. Почему-то именно по суперсету на Хабре оскорбительно мало материалов. Да, у него в целом неплохая документация, но она все же - документация, поэтому в меру сухая, в ней нет дополнительных объяснений, примеров.
Небольшое введение, почему Superset
Мы достаточно долго занимаемся темой BI, много работали на OBIEE, MS Power BI, но времена изменились, наступило время импортозамещенных и опенсорс решений, и здесь как никогда кстати пришелся суперсет со своим открытым исходным кодом - хочешь, так бери, хочешь, бери и допиливай.
Немного поговорим о классике BI, упомянем особенности:
- MOLAP - MS Power BI (в девичестве, если не ошибаюсь, MSAS), Qlik и им подобные. Яркие представители, которые сначала загружают данные в свой (достаточно эффективный) формат, после чего показывают их достаточно быстро
- OBIEE, очень старый и очень достойный кандидат (от Oracle). Он уже грузит данные напрямую из БД, но при этом в нем есть несколько уровней (3) представления данных и это достаточно заморочно, сложно для понимания и как мне кажется подход несколько устарел
- Другие ROLAP - системы, которые берут данные "без затей" из БД (таблица, представление, запрос) и их отображают. Не так быстро как п.1., но зато гибко. Причем нет эффекта «подмороженности», т. е. данные можно брать из нужных таблиц максимально свежими. Здесь вспомню Prognoz (ныне Foresight) Platform и героя нашего обзора
- Конечно, есть много чего другого (Tableau, ...), но мы с ними не работали, поэтому - пишем только про то, что знаем

Как работает BI-система
Окей, идем дальше - опишем схематично работу BI. Если совсем просто - это примерно как сводная таблица в Excel - есть атрибуты (разрезы), есть меры (значения). Атрибуты мы размещаем по "осям" X, Y, Z; меры - в пересечениях, с применением, как правило, агрегатной функции (сумма, среднее и т.д.).
Если поэтапно, то чуть подробнее механика выглядит так:
- Пользователь вводит параметры, они же фильтры (например период и любые другие)
- Система делает запрос в БД, получает нужные данные, подфильтровывает их (здесь интересен технический момент - подфильтровывает она их с самого начала, добавляя соответствующие условия во where или же подфильтровывая итоговый результат - от этого, конечно же, зависит вопрос производительности)
- Система (уже своими силами) формирует результат, рассчитывая меры в разрезе атрибутов
Продвинутые требования
Пока все просто, но давайте усложним. Вернее даже не так - в жизни каждого биайщика возникает тот неловкий момент, когда хочется реализовать дополнительную логику на функциях / процедурах БД. В эпоху OBIEE мы делали это на pipelined-функциях Oracle, в современную же эпоху ... - а посмотрим! Но сначала определим что надо, потом - зачем надо:
- Чтобы вводимые фильтры вели себя как параметры, т.е. чтобы можно было на основе введенных (в них) значений определенным образом рассчитать результат, а также:
- Дополнительно: чтобы они могли вести себя и «как фильтры и параметры вместе», либо — просто как параметры, без подфильтровки результата по их значениям
Пример 1. Расчет долей
Давайте с примером, так попроще. Допустим у нас есть (таблица) «служебные записки» (СЗ), у которых есть (поле в таблице) «количество кругов согласования», и их анализ ведется в разрезе регионов. При этом нам надо посчитать долю согласованных СЗ в общем числе в разрезе кругов. Как будем считать:
- Выберем все СЗ за период (период - это фильтр = две даты)
- Разложим количества СЗ по регионам и по кругам согласования
- Поделим число по региону и кругу на общее число (и умножим на 100%)
"Это, в целом, можно и на агрегатах самого суперсета сделать, зачем тут что то мудрить?", — спросит внимательный читатель.
Усложним - допустим пользователь выбрал только 2 региона - Урал и Юг, но расчет должен быть - по всем регионам. Т.е. доля Урала = [Число по Уралу] / [Число по всем регионам] * 100%. А если идти стандартной дорогой - то за "полный объем" суперсет будет считать только отобранное - т.е. только Урал и только Юг и, при этом, за полный объем он как раз возьмет количество только по этим двум регионам, что нам категорически не надо.
Окей, и как?
А нормально, в целом, но не слишком просто. Но именно про это и туториал.
Для начала определим ограничения - мы говорим про БД PostgreSQL, в которой есть замечательная вещь - функции, которые возвращают "резалтсет" (т.е. набор строк).
Чем они лучше таблиц и представлений? В данном случае очевидно - в них можно передать параметры, а они учтут логику формирования результата исходя из него.
Посмотрим, что может предложить нам суперсет - это шаблонизирование через jinja
Для начала погуглим.
Документация в целом достаточно неплохая, но немного суховата, не сразу понятно с чего начать (при этом, как выяснилось, есть и неточности).
Есть немного подробнее на сайте preset.io тоже почитаем.
Ладно, начнем пробовать. Но начнем со стороны PostgreSQL. Напишем функцию, которая принимает на вход параметры - текстовые значения. При этом сразу оговорим, что параметры могут использовать мультивыбор значений - и это надо учесть, но в функции это все равно будет один параметр - строка, разделенная разделителями. Например так (выберем редкий символ): "Юг~Сибирь~Урал" (пример для регионов), или 1~2~4~10 (пример для количества кругов согласования - интересно с точки зрения преобразования типов строка-целое).
Итого функция получилась примерно такой:
CREATE OR REPLACE FUNCTION user_plotn.f_get_test_fraction(p_cycles text, p_regions text)
 RETURNS TABLE(val numeric, int_cycle integer, region text, this_sum numeric, total_sum numeric, frac_sum numeric)
 LANGUAGE plpgsql
 SECURITY DEFINER
AS $function$
declare l_regions text[];
declare l_cycles text[];
begin
    -- Получим из строк вида "Юг~Сибирь~Центр" массивы значений
    l_cycles := string_to_array(p_cycles, '~');
    l_regions := string_to_array(p_regions, '~');
    -- Если параметры пустые - вставим одно "служебное" значение в массивы
    if coalesce(array_length(l_cycles, 1), 0) = 0 then
      l_cycles := array_append(l_cycles, '-1');
    end if;
    if coalesce(array_length(l_regions, 1), 0) = 0 then
      l_regions := array_append(l_regions, '###');
    end if;
    return query
    with filtered as (
        select
          tr.val,
          tr.int_cycle,
          tr.region
        from
          user_plotn.test_fraction tr
        -- Здесь, по сути - как раз работает подфильтровка по параметрам
        join unnest(l_cycles) as cycles on cycles.cycles::int4=tr.int_cycle
          -- Этот блок как раз отвечает, чтобы в случае пустых параметров - мы
          -- брали все строки - вариант для целых чисел
          or cycles.cycles::int4=-1
        join unnest(l_regions) as regions on regions.regions=tr.region
          -- вариант для строк
          or regions.regions='###'
    ),
    calculated as (
    select
      f.val,
      f.int_cycle,
      f.region,
      (select sum(ff1.val) from filtered ff1
        where ff1.int_cycle = f.int_cycle and ff1.region = f.region) as this_sum,
      (select sum(ff.val) from filtered ff) as total_sum
    from
      filtered f
    )
    select
      c.val,
      c.int_cycle,
      c.region,
      c.this_sum,
      c.total_sum,
      case when c.total_sum > 0 then c.this_sum / c.total_sum else 0::numeric(15,2) end as frac_sum
    from calculated c
    ;
end;
$function$
;
-- Permissions
ALTER FUNCTION user_plotn.f_get_test_fraction(text, text) OWNER TO b2g2_bi;
GRANT ALL ON FUNCTION user_plotn.f_get_test_fraction(text, text) TO b2g2_bi;
Пример данных:
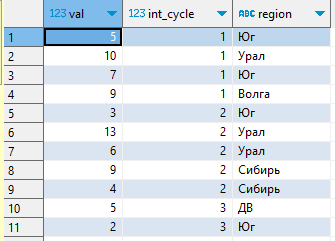
Тестовые данные
Пример запуска:
select * from user_plotn.f_get_test_fraction('1~2', 'Юг~Сибирь');
Результат:
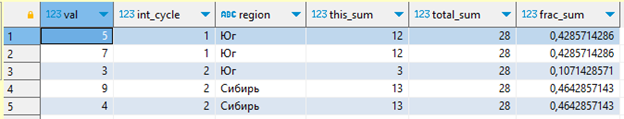
Работа функции
Теперь пойдем в superset. Первым шагом надо включить параметр ENABLE_TEMPLATE_PROCESSING в конфигурации, этот шаг у нас сделал девопс-инженер.
Идем в SQLLab, здесь мы будем оттачивать наш запрос к функции и использовать шаблоны. Результатом у нас будет - созданный виртуальный запрос в суперсете:
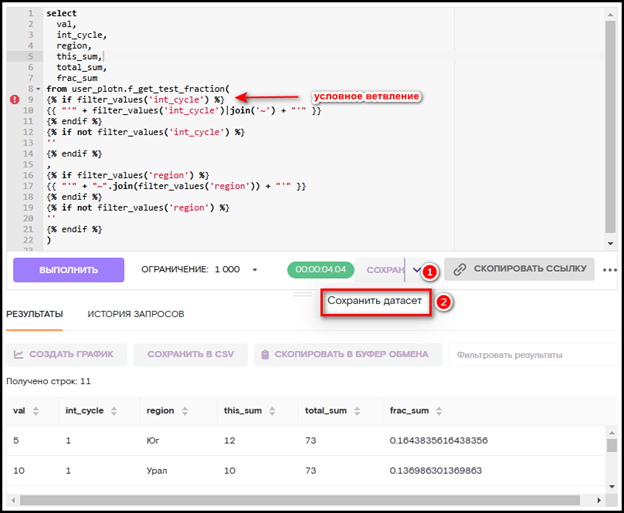
Запрос в SQLLab в суперсете
На самом деле все сделано достаточно по-дурацки. Дело в том, что "при реальной работе" в запрос (в шаблон) будут передаваться значения фильтров и другие служебные значения (см. filter_values), но при конструировании запроса в SQLLab - они еще не передаются и нужно использовать условные секции, чтобы их "обойти". Зачем? Вот мне самому непонятно зачем, но вам уже даже на этом этапе нужно, чтобы запрос выполнился успешно - именно потому.
Отдельно скажу за язык в шаблонах jinja - вроде бы изначально он выглядит похожим на python, но это на самом деле не совсем питон. Обратите внимание на формирование строки из массива целых чисел (|join). Сначала мы пошли гуглить как это делается в питоне, но выяснилось, что это не подходит.
Поиск решения
Любопытно - для того, чтобы найти это решение мы вдвоем с нашим AI/ML специалистом ушли - я гуглить, а он - спрашивать у нашей внутренней нейронки "Василиса" (РТК Нейро). К результату пришли одновременно, причем одинаковому.
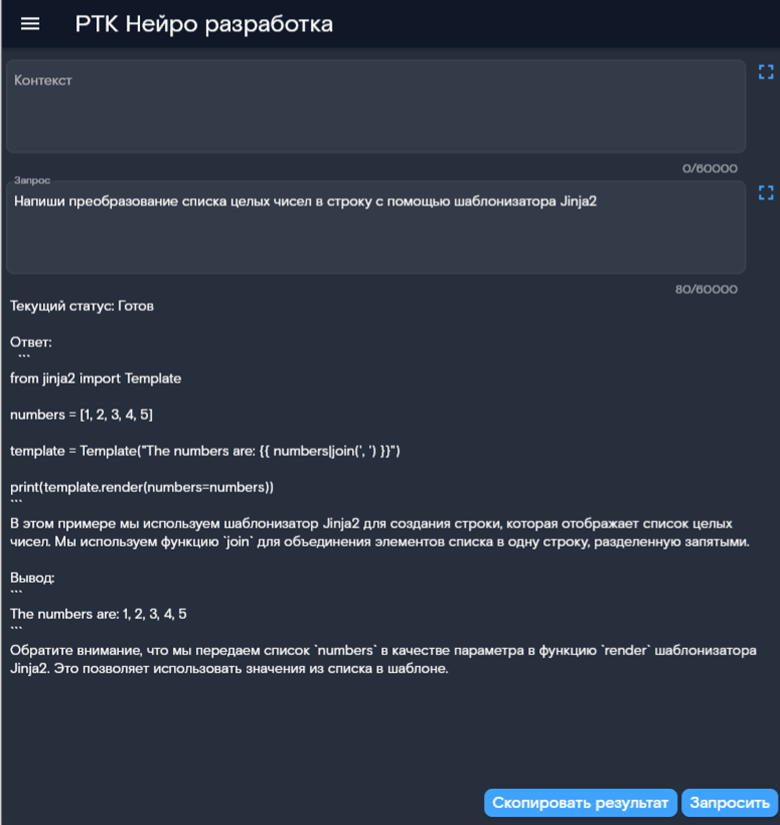
Василиса за работой
В итоге в коде запроса получилась такая "колбаса" с шаблонами. Как по мне - сильно нечитаемо, и поэтому очень хочется как можно быстрее уйти в plpgsql (хотя, конечно, можно обойтись и без функций, но мне так удобнее).
Запускаем запрос, видим результат.
После этого есть возможность сохранить виртуальный датасет, который потом мы можем использовать как источник для чартов и дэшбордов.
Сохранили, пошли пробовать - создадим чарт в виде обычной таблицы, на его основе создадим дэшборд, настроим фильтры:
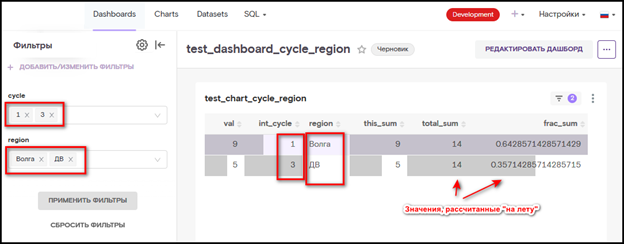
Тестовый чарт внутри тестового дэшборда
Результат - все работает как хотели. Пару слов насчет подфильтровки. При таком использовании - мы фильтруем фактически дважды - один раз это делается внутри функции PostgreSQL (естественным образом, на джойнах), потом, поверх этого фильтрует еще сам суперсет. Понятно, что он уже ничего не фильтрует, но он все равно старается ) Чтобы этого избежать - можно использовать следующий трюк - убирание фильтров из фильтров также с помощью шаблонов jinja.
Пример 2. Временные ряды
Давайте рассмотрим еще один пример - с датами.
Вводная - у нас есть система, которая загружает и рассчитывает показатели на основе данных из внешних систем. Загрузки и расчеты у нас проводит и запускает Airflow, при этом мы ведем некоторую таблицу протокола, в которой отмечаем все подробности - когда, что мы грузили, успешно или нет, когда считали и т.д.
Airflow предоставляет достаточно хороший визуал для мониторинга, но нам хотелось собрать некоторые дэшборды со статистикой. При этом мы захотели разложить все по временной шкале с шагом в 1 день. А в таблице протокола фиксируются только события за те даты, за которые они происходили. Т.е. чтобы определить, например, что "вчера загрузка, по каким либо причинам, запущена не была" мы формируем запрос на основе generate_series и соединяем его с данными протокола. А вот границы формируемого диапазона, правильно, получаем из шаблонов суперсета. В итоге, получилось такое симпатичное решение:
CREATE OR REPLACE FUNCTION cmu_log.f_get_log_data(p_date_from date, p_date_to date)
 RETURNS TABLE(date_stat date, id_log bigint, src_id bigint, entity_name text, date_from timestamp without time zone, date_to timestamp without time zone, cnt_rows numeric, date_load_start timestamp without time zone, date_load_finish timestamp without time zone, status_load smallint, date_dwh_start timestamp without time zone, date_dwh_finish timestamp without time zone, status_dwh smallint, comment_process text, entity_display_name text, entity_dag_name text, cnt_rows_load_ok numeric, cnt_rows_dwh_ok numeric, cnt_load_errors numeric, cnt_dwh_errors numeric)
 LANGUAGE plpgsql
 SECURITY DEFINER
AS $function$
begin
  return query
    select
      dd.dd::date as date_stat,
      l.id_log,
      l.src_id,
      ei.entity::text as entity_name,
      l.date_from,
      l.date_to,
      l.cnt_rows,
      l.date_load_start,
      l.date_load_finish,
      l.status_load,
      l.date_dwh_start,
      l.date_dwh_finish,
      l.status_dwh,
      l.comment_process,
      ei.entity_display_name,
      ei.entity_dag_name,
      case when l.status_load = 1 then l.cnt_rows else 0 end::numeric cnt_rows_load_ok,
      case when l.status_dwh = 1 then l.cnt_rows else 0 end::numeric cnt_rows_dwh_ok,
      case when l.status_load = 1 then 0 else 1 end::numeric cnt_load_errors,
      case when l.status_dwh = 1 then 0 else 1 end::numeric cnt_dwh_errors
    from
      generate_series(p_date_from, p_date_to, '1 day'::interval) dd
      left join cmu_log.entity_info ei on 1=1
      left join cmu_log.loading_logs l on dd.dd::date = l.date_load
                                      and l.entity = ei.entity;
end;
$function$
;
Выглядит вот так:
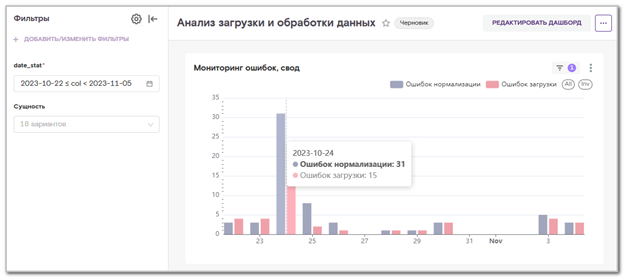
Анализ загрузки и обработки данных
В суперсете запрос выглядит вот так (обратите внимание на "if not from_dttm" - в документации написано "if from_dttm is not none", но это как раз и не работает):
select * from cmu_log.f_get_log_data(
{% if from_dttm %}
'{{ from_dttm }}'
{% endif %}
{% if not from_dttm %}
current_date - 14
{% endif %}
,
{% if to_dttm %}
'{{ to_dttm }}'
{% endif %}
{% if not to_dttm %}
current_date
{% endif %}
)
Фигура вторая, печальная
На самом деле название «главы» уже устарело (статья все таки пишется не за один день), так как я нашел решение. Но изначально, думал, что у меня не получится и хотел рассказать про «сценарий, который не привел к успеху» и спросить совета в комментариях.
Проблематика ввод данных в BI-системах
Иногда нам хочется не только посмотреть на данные, покрутить их в разных разрезах - в таблицах и на графиках, но и обеспечить пользовательский ввод. Т.е. конкретно - где-то вводить данные, чтобы они запоминались (в БД), а также использовались (в расчетах, в формированиях наборов данных).
Тот же самый (что и выше) внимательный читатель (будем считать что он еще не ушел, а с нами) может сказать - данные вносятся в исходные системы, а BI нам нужен только для анализа данных, однако же:
- Иногда нам надо ввести сравнительно немного - какие-либо коэффициенты, параметры для расчетных моделей и т.д.
- Иногда есть специфические требования, например один заказчик попросил у нас возможность редактирования отчетов после их формирования
И в этих кейсах можно пойти двумя путями:
-
Сделать честное веб-приложение, с бэкендом, с фронтом и обеспечить весь пользовательский ввод в нем. Это хорошо и правильно. Но не всегда хочется и причины бывают разные:
- Нет ресурса фронт/бэк разработчика
- Не хочется "городить огород" с дополнительными приложениями / серверами
- Использовать встроенные функции BI-систем, обычно они называются Write Back Functionality:
- У OBIEE мы эту фишку так и не попробвали - и коллеги упорно отговаривали, аргументируя, что там это реализовано очень криво
- Зато вполне неплохо это сделано (тоже с ограничениями) у Prognoz Platform и это мы успешно использовали - там это сделано на манер редактирования таблицы в Excel
- А вот у Superset такого мы не нашли, поэтому - снова дадим волю творчеству:
- Решение по пользовательскому вводу с использованием Apache Superset
Поиск решения
Для начала немного рассуждений. Изначально мы хотели пойти дорогой разработки плагина визуализации, в который на самом деле хотели встроить интерфейс ввода данных. Какие тут плюсы:
- Есть очень подробный туториал
- Это интересно технически
- Это (нативно) бы встроилось в интерфейс суперсета
- и не нужно отдельный фронт
- а может быть и бэк, если как то "подсесть" на вебсервер суперсета, т.е. мы как минимум не усложняем "инфру"
И минусы:
- Да, это полноценная фронт-разработка, и бэк - т.е. если у нас не было этого ресурса, то он и не появится
- И притом крайне специфическая, не все захотят, не все смогут
Окей, мы ещё немного подумали и пришли к решению из предыдущей главы. Ну а собственно, почему бы и нет? Возьмем все тоже самое, что и "в первой главе", нарисуем функцию которая вставляет данные, попробуем:
CREATE OR REPLACE FUNCTION user_plotn.f_get_test_user_input(p_do_input text, p_val1 text, p_val2 text)
 RETURNS TABLE(do_input text, val1 text, val2 text)
 LANGUAGE plpgsql
 SECURITY DEFINER
AS $function$
begin
    if (p_do_input = '1') then
        perform user_plotn.test_user_input(p_val1, p_val2);
        insert into user_plotn.test_user_input values (
          p_do_input,
          p_val1,
          p_val2
        );
        return query
        select
          p_do_input,
          p_val1,
          p_val2;
    else
        return query
        select
          c.do_input,
          c.val1,
          c.val2
        from user_plotn.test_user_input c
        ;
    end if;
end;
$function$
;
Как видно - у функции два режима работы - если в p_do_input передали '1' она сохранит переданные данные в таблицу, а на выход отдаст их же. Иначе - просто выгребет данные из этой таблицы целиком. Разумеется, это только для тестирования.
Потестируем функцию в dbeaver. Все работает, строки в таблице появляются. Прикрутим к суперсету:
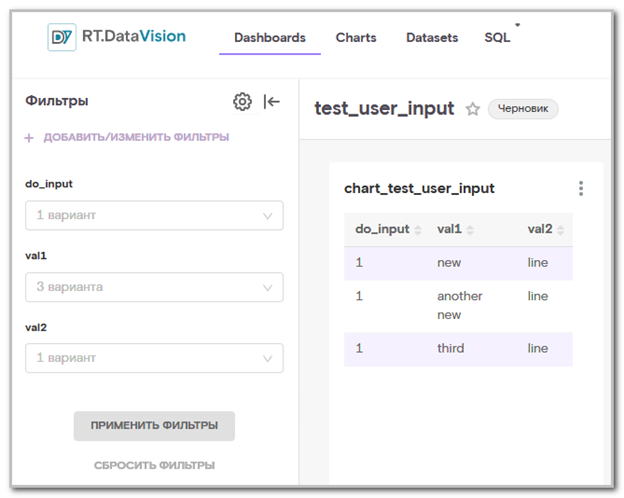
Тестирование пользовательского ввода
Ну, вот собственно из-за этого и родился изначальный заголовок этой главы - в суперсете все примерно также, но данные в таблице не сохраняются. Наверное у него "под капотом" не делается commit при выборке данных (сходу видится скорее эта причина).
Решение
И вот здесь мне пришла в голову мысль - а можно же попробовать использовать автономную транзакцию (почему сразу то не пришла?). Разработаем функцию асинхронной вставки:
CREATE OR REPLACE FUNCTION user_plotn.test_user_input(p_val1 text, p_val2 text)
 RETURNS void
 LANGUAGE sql
AS $function$
   select public.dblink('host=x.x.x.x port=5432 user=XXX password=YYY dbname=ZZZ'::text,
    format('insert into user_plotn.test_user_input select 1, %L, %L', p_val1, p_val2));
$function$
;
И доработаем предыдущую:
...
if (p_do_input = '1') then
        perform user_plotn.test_user_input(p_val1, p_val2);
        return query
        select
          p_do_input,
          p_val1,
          p_val2;
...
Не забудем отключить кеширование датасета (в суперсете, редактирование):
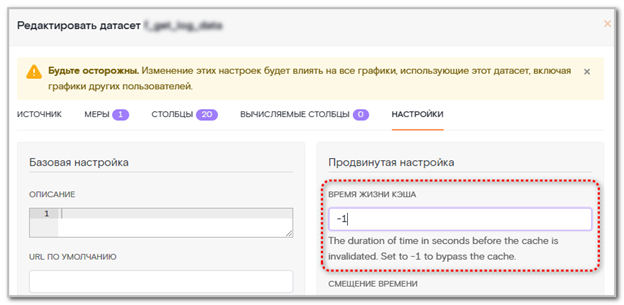
И все работает!
Какие это открывает нам горизонты помимо, собственно, самого ввода данных?
- Можно запускать достаточно тяжелые расчеты, результат которых будет какое-то время формироваться (асинхронно в фоне). Вот отличный материал про асинхронность в PostgreSQL
- Можно сделать даже таблицу мониторинга расчетов и выводить ее в отдельный дэшборд, давая возможность формировать другие дэшборды по готовности данных
Выводы
Конечно же, мы еще только набираем обороты в новом инструменте, особенностях и нюансах. Но отмечу - мы его уже полюбили. У нас в организации развивается форк - RT.DataVision и, хоть статья и все таки, о "чистом Superset" скажу, что коллеги помогли нам стартануть и все что сказано выше - в целом максимально применимо и к нашему форку.
Что можно отметить еще:
- Новые инструменты не менее интересны чем "хорошо себя зарекомендовавшие", мы с большим интересом исследовали возможности и нюансы и нам многое понравилось. Да, он достаточно простой, например в той же Prognoz Platform внутри работает "своя Delphi - начиная от редактора форм, продолжая своим языком программирования Fore", но насколько часто это надо для BI? Да и порог входа достаточно велик
- В инструменте реализована неплохая ролевая модель - причем можно настроить как классическую RBAC, с конфигурированием состава ролей, так и сделать Row-Level доступ - т.е. давать доступ к части данным
-
Конечно, есть ограничения - они во всем - в фильтрах, в визуализациях, примеры:
- Неудобный компонент выбора периода - как будто "программисты делали для программистов":
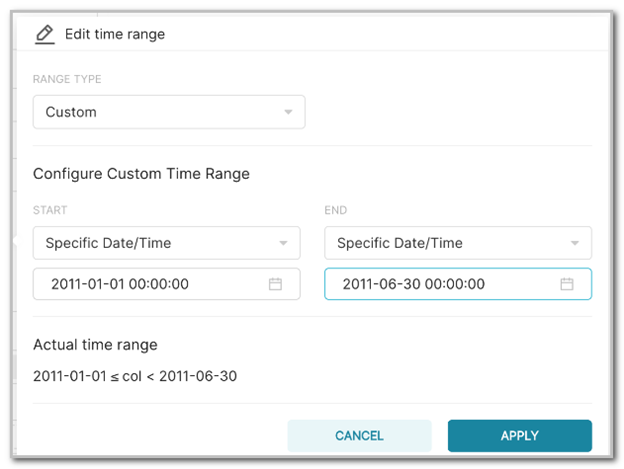
Выбор периода
- "Рандомные" цвета колбасок на графиках - тогда как заказчик просит "плохое" покрасить в красный, а хорошее в зеленый, а инструмент сам решает
- Перечислять можно и дальше, так как мы много с чем столкнулись
- Однако - мы все это переделаем (!!!). Инструмент с открытым кодом дает на много больше свободы действий и принятия решений, чем «биться головой о коробку». Более того, мы планомерно это уже делаем и, возможно, напишем продолжение материала с описанием доработок визуализаций отчетов и графиков "по фронту". Могли ли мы подумать об этом, например в OBIEE? Определенно нет, использовали только то, что он мог нам предоставить.
Всем приятного суперсета!
Автор: блог Ростелеком


