

Новые виды архитектур для организации современной инфраструктуры данных
Рост индустрии инфраструктуры данных нисколько не замедлился с тех самых времен, когда мы опубликовали несколько статей на тему архитектуры данных в конце 2020 г. Практически все ключевые показатели отрасли достигли рекордных значений за прошедший год, а новые категории продуктов появлялись так быстро, что большинство специалистов по работе с данными просто не успевали отслеживать их.
Чтобы помочь специалистам по работе с данными не отставать от изменений, происходящих в отрасли, мы публикуем обновленный список архитектур инфраструктуры данных. В них представлены самые лучшие в своем классе стеки аналитических и операционных систем, полученные от многочисленных операторов, с которыми мы общались в течение последнего года. Каждый архитектурный чертеж содержит краткое описание того, что изменилось по сравнению с предыдущей версией.
Мы также попытаемся объяснить причины этих изменений. Основные системы обработки данных в течение последнего года оставались относительно стабильными, в то время как вспомогательные инструменты и приложения быстро развивались. Мы считаем, что вполне возможно, что в экосистеме данных начинают появляться платформы, и это помогает объяснить те особенности, которые мы наблюдаем в эволюции современного стека данных.
При составлении данной статьи мы опирались на мнение десятков экспертов в области данных, список которых приведен в конце этой статьи. Без них этой работы просто не было бы, так что большое Вам спасибо!
Обновленные архитектуры
Прежде чем углубиться в детали, представим Вашему вниманию обновленную диаграмму архитектур. Она была составлена с помощью лидеров в области данных.
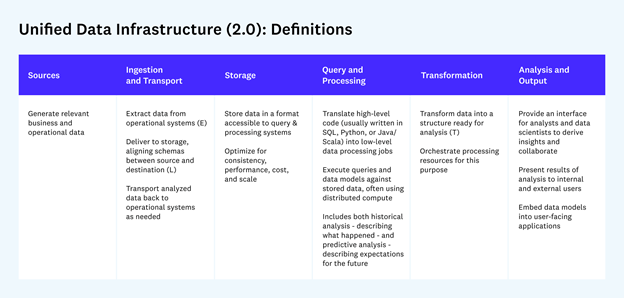
Первый рисунок отображает объединенный обзор сразу нескольких инфраструктур данных:
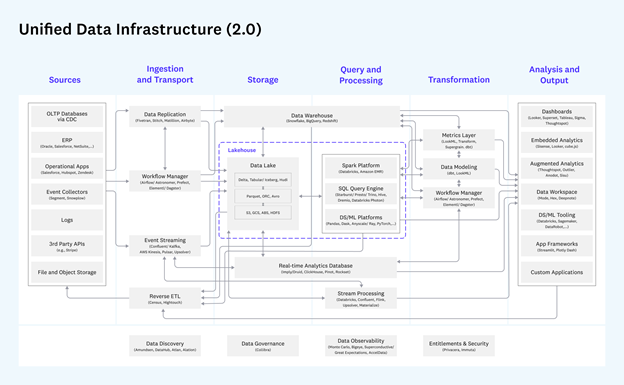
Важно: не включает в себя OLTP, анализ журналов и приложения SaaS.
Далее остановимся на Машинном обучении:
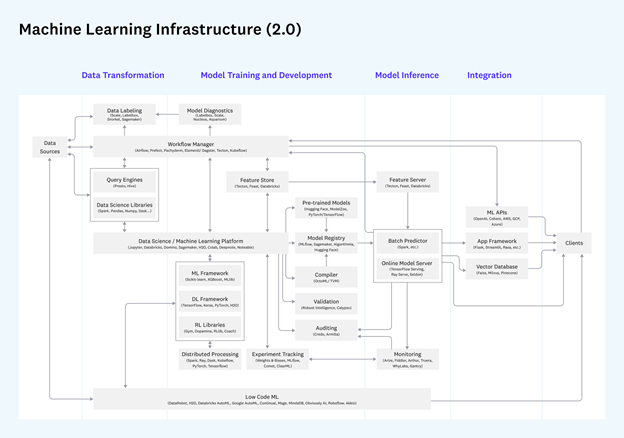
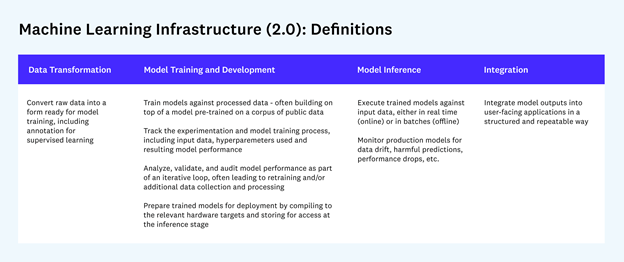
В оставшейся части этой статьи мы прокомментируем, что изменилось с момента появления первой версии стека данных, а также рассмотрим основные факторы, лежащие в его основе.
Журнал изменений
Что осталось неизменным
Несмотря на ажиотаж, вызванный деятельностью в области инфраструктуры данных за последний год, достаточно удивительно констатировать тот факт, что в некоторых областях мало что изменилось…
В нашей самой первой статье мы описали различия между аналитическими системами, поддерживающими принятие решений на основе данных, и операционными системами, обеспечивающими работу продуктов на основе данных. Затем мы сопоставили эти категории с тремя схемами, которые зачастую реализуются ведущими командами, работающими с данными.

Один из ключевых вопросов заключался в том, произойдет ли сближение этих архитектурных моделей. Прошел год, и мы видим, что ничего подобного не произошло …
В частности, продолжают развиваться аналитическая и операционная экосистемы. Облачные хранилища данных, такие как Snowflake, стремительно развиваются, ориентируясь в основном на пользователей SQL и решения для бизнес-аналитики. Однако ускорилось внедрение и других технологий - например, такие хранилища данных, как Databricks, пополняются клиентами быстрее, чем когда-либо. Многие специалисты по работе с данными, с которыми мы беседовали, подтвердили, что гетерогенность в стеке данных, скорее всего, останется.
Другие основные системы работы с данными - а именно, их ввод и преобразование - оказались столь же долговечными. Это особенно заметно в современной модели бизнес-аналитики, где сочетание Fivetran и dbt (или аналогичных технологий) стало практически повсеместным. Но в определенной степени это справедливо и для операционных систем, где появились такие стандарты де-факто, как Databricks/Spark, Confluent/Kafka и Astronomer/Airflow.
Что нового
В целом наибольшая активность наблюдалась в двух областях:
- Новые инструменты, предназначенные для поддержки ключевых процессов и рабочих процессов с данными, таких как обнаружение данных, наблюдаемость или аудит ML-моделей;
- Новые приложения, позволяющие командам, работающим с данными, и бизнес-пользователям генерировать ценность из данных новыми, более мощными способами, такими как рабочие пространства данных, обратный ETL и фреймворки приложений ML.
Кроме того, мы наблюдаем появление новых технологий, призванных усовершенствовать основные системы обработки данных. В частности, активно обсуждается слой метрик в аналитической экосистеме и схема "озерного дома" для операционных систем, причем обе эти концепции сходятся к полезным определениям и архитектурам.
Ключевые нововведения
Мы подробно остановимся на каждом из основных моментов обновленной инфраструктуры данных. В каждом разделе ниже приведена обновленная диаграмма и анализ ключевых изменений. Эти разделы предназначены в первую очередь для команд разработчиков данных, внедряющих стеки данных; их прочтение не является обязательным для понимания остальной части статьи.
1. Современная бизнес-аналитика
Облачные BI решения
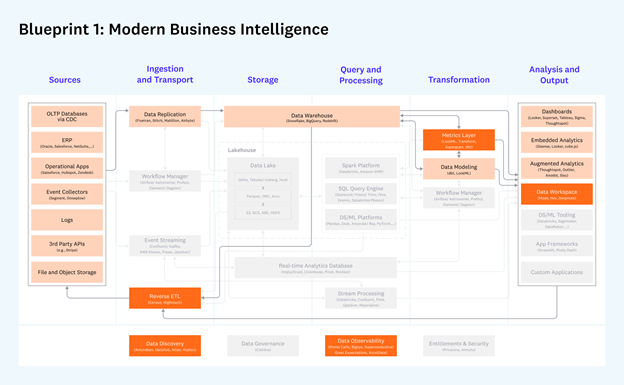
Более темные квадраты - новые или существенно измененные с момента появления первой версии архитектуры 2020 г.; квадраты, окрашенные в более светлые цвета, в основном остались прежними. Серые же блоки менее значимы для данного проекта.
Что осталось без изменений:
- Основу этой модели по-прежнему составляет сочетание репликации данных (например, Fivetran), облачных хранилищ данных (например, Snowflake) и моделирования данных на основе SQL (например, dbt). Использование этих технологий значительно выросло, что привело к финансированию и быстрому развитию конкурентов (например, Airbyte и Firebolt).
- Наиболее распространенными приложениями остаются дашборды, такие как Looker, Tableau, PowerBI и новые разработки, напрмер, Superset.
Что появилось нового:
- В последнее время наблюдается всплеск интереса к слою метрик - системе, предоставляющей собой стандартный набор определений поверх хранилища данных. Вопросы о том, какими возможностями он должен обладать, кто из производителей должен его создать и какой спецификации он должен следовать, до сих пор вызывают ожесточенные споры. Пока мы видим несколько надежных чистых продуктов (например, Transform и Supergrain), а также расширение этой категории компанией dbt;
- Значительно развились поставщики обратного ETL, особенно Hightouch и Census. Цель этих продуктов - обновление операционных систем, таких как CRM или ERP, с помощью выходных данных и информации, полученной из хранилища данных;
- Специалисты по работе с данными проявляют повышенный интерес к новым приложениям, дополняющим их стандартные дашборды. В целом, появление новых приложений, скорее всего, является следствием растущей стандартизации облачных хранилищ данных - если данные четко структурированы и легко доступны, специалисты по работе с данными, естественно, хотят извлечь из этого максимальную пользу;
- Компании, специализирующиеся на обнаружении и наблюдении данных, разрастаются и привлекают значительные капиталы (особенно Monte Carlo и Bigeye). Хотя преимущества этих продуктов очевидны - например, более надежные конвейеры данных и более эффективная совместная работа, - их внедрение все еще находится на относительно ранней стадии - пока заказчики только лишь определяют соответствующие сценарии их использования и бюджеты. (Важно: несмотря на наличие нескольких новых надежных поставщиков в области обнаружения данных - например, Select Star, Metaphor, Stemma, Secoda, Castor, - мы не включили в диаграмму компании, находящиеся на начальной стадии развития).
2. Мультимодальная обработка данных
Развитые озера данных, поддерживающие как аналитические, так и операционные сценарии использования
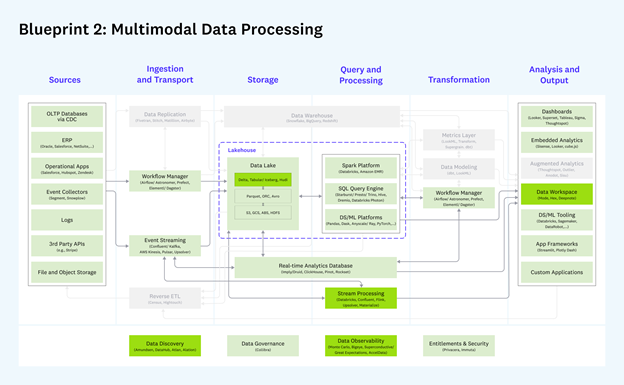
Примечание: Более темные графы - новые или существенно изменившиеся с момента появления первой версии архитектуры в 2020 г.; графы, окрашенные в более светлые тона, в основном остались прежними. Серые же блоки менее значимы для данного проекта.
Что осталось неизменным:
- Основные системы обработки данных (например, Databricks, Starburst и Dremio), транспорта (например, Confluent и Airflow) и хранения данных (AWS) продолжают быстро развиваться и составляют основу этого проекта;
- Мультимодальная обработка данных остается разнообразной по своей сути, что позволяет компаниям использовать системы, наиболее полно отвечающие их конкретным потребностям, как в аналитике, так и в оперативных данных.
Что нового:
- Архитектура Lakehouse получает все большее и большее признание. Мы видим, что этот подход поддерживается широким кругом известных поставщиков (включая AWS, Databricks, Google Cloud, Starburst и Dremio) и пионеров в области хранилищ данных. Фундаментальная ценность данной архитектуры заключается в том, что надежный слой хранения данных сочетается с массивом мощных средств обработки данных, таких как Spark, Presto, Druid/Clickhouse, библиотеки Python и т.д.;
- Сам слой хранения получил обновление. Хотя такие технологии, как Delta, Iceberg и Hudi, сами по себе далеко не новы, их внедрение ускоряется, и они органично встраиваются в существующие коммерческие продукты. Некоторые из этих технологий (например, Iceberg) также взаимодействуют с облачными хранилищами данных, такими как Snowflake. Если гетерогенность останется, то она, вероятно, станет ключевой частью стека мультимодальных данных.
- Наблюдается всплеск внедрения потоковой обработки (т.е. аналитической обработки данных в реальном времени). Хотя технологии первого поколения, такие как Flink, все еще не стали массовыми, новые участники с более простыми моделями программирования (например, Materialize и Upsolver) получают раннее признание, и, по некоторым данным, использование продуктов для потоковой обработки от лидеров Databricks и Confluent также начало расширяться.
3. Искусственный интеллект и машинное обучение
Стек для надежной разработки, тестирования и эксплуатации моделей машинного обучения
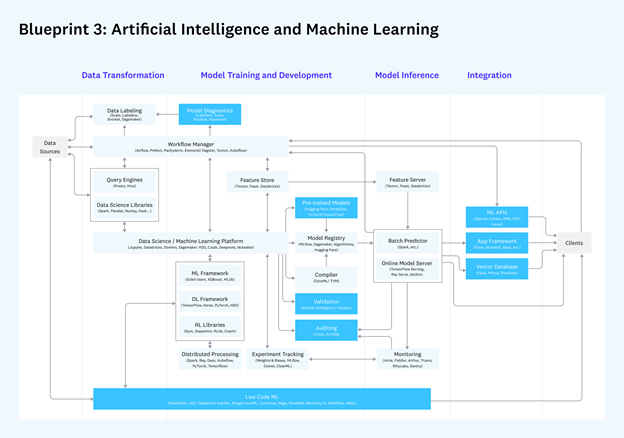
Примечание: Более темные графы - новые или существенно изменившиеся с момента появления первой версии архитектуры в 2020 г.; графы, окрашенные в более светлые тона, в основном остались прежними. Серые же блоки менее значимы для данного проекта.
Что осталось неизменным:
- Инструментарий для разработки моделей сегодня во многом схож с тем, что было в 2020 году, включая основных поставщиков облачных вычислений (например, Databricks и AWS), фреймворки ML (например, XGBoost и PyTorch) и некоторые инструменты (например, Weights & Biases и Comet);
- Управление экспериментами фактически выделило визуализацию и настройку моделей в самостоятельные категории;
- Построение и эксплуатация стека машинного обучения сложны и требуют специальных знаний. Этот план не для слабонервных, а внедрение ИИ в производство все еще остается сложной задачей для многих команд, работающих с данными.
Что нового:
- Индустрия ML консолидируется вокруг подхода, ориентированного на данные, делая упор на сложное управление данными, а не на постепенное совершенствование моделирования. Это имеет ряд последствий:
- Быстрое развитие маркировки данных (например, Scale и Labelbox) и растущий интерес к замкнутым системам обработки данных, в значительной степени созданным по образцу конвейеров обработки данных Autopilot компании Tesla;
- Рост популярности хранилищ функций (например, Tecton), как для пакетного использования, так и в режиме реального времени, в качестве средства для совместной разработки производственных ML-данных;
- Возрождение интереса к низкокодовым ML-решениям (например, Continual и MindsDB), которые хотя бы частично автоматизируют процесс ML-моделирования. Эти новые решения нацелены на привлечение новых пользователей (аналитиков и разработчиков ПО) на рынок ML;
- Использование предварительно обученных моделей становится общепринятым, особенно в НЛП, и создает благоприятные условия для таких компаний, как OpenAI и Hugging Face. При этом остаются значимые проблемы, связанные с тонкой настройкой, стоимостью и масштабированием.
- Операционные инструменты для ML (иногда называемые MLops) становятся все более зрелыми и строятся вокруг мониторинга ML как наиболее востребованного варианта использования и непосредственного бюджета. В то же время появляется множество новых операционных инструментов, включая, в частности, проверку и аудит, конечный рынок которых еще не определен;
- Все больше внимания уделяется тому, как разработчики могут легко интегрировать модели ML в приложения, в том числе с помощью готовых API (например, OpenAI), векторных баз данных (например, Pinecone) и фреймворков с более выраженным мнением.
Гипотеза платформы данных
Вкратце: За последний год в инфраструктуре данных наблюдалась значительная стабильность основных систем и быстрое распространение вспомогательных инструментов и приложений. Чтобы объяснить причины этого, мы вводим понятие платформы данных.
Что такое платформа?
Слово "платформа" в экосистеме данных перегружено, его часто используют для описания всего технологического стека или для продажи слабо связанных между собой наборов продуктов.
В более широком смысле платформа - это то, что другие разработчики могут создавать на ее основе. Платформы, как правило, сами по себе представляют ограниченную ценность - большинство пользователей не заинтересованы, например, в доступе к «внутренностям» Windows или iOS. Однако они предоставляют целый ряд преимуществ, таких как общий интерфейс программирования и большая база установленных систем, которые позволяют разработчикам создавать и распространять те приложения, которые в конечном итоге важны для пользователей.
Определяющей чертой платформы, с точки зрения индустрии, является взаимная зависимость - как техническая, так и экономическая - между влиятельным поставщиком платформы и большим количеством сторонних разработчиков.
Что такое платформа данных?
Исторически сложилось так, что стек данных не совсем подходит под определение платформы. Определенная взаимозависимость, конечно, есть - например, между поставщиками ETL, хранилищ данных и отчетности, - но модель интеграции, как правило, "один к одному", а не "один ко многим", и в значительной степени дополняется профессиональными услугами.
По мнению ряда экспертов в области данных, с которыми мы беседовали до написания статьи, ситуация может вскоре измениться.
"Бэкэнд" стека данных, который условно можно определить как сбор, хранение, обработка и преобразование данных, начал консолидироваться вокруг относительно небольшого набора облачных вендоров. В результате данные о клиентах собираются в стандартном наборе систем, и вендоры вкладывают значительные средства в то, чтобы сделать эти данные легкодоступными для других разработчиков - в качестве фундаментального принципа проектирования в таких системах, как Databricks, и с помощью стандартов SQL плюс пользовательских вычислительных API в таких системах, как Snowflake.
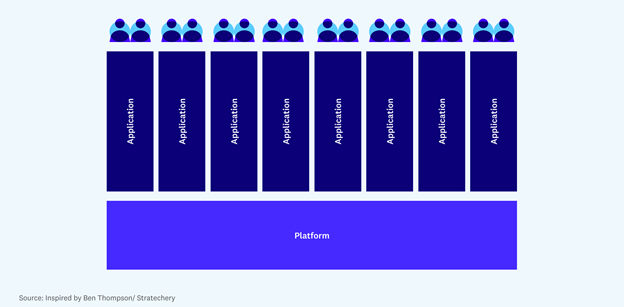
Разработчики "фронтенда", в свою очередь, воспользовались этой единой точкой интеграции для создания целого ряда новых приложений. Они полагаются на чистые, объединенные данные в хранилище данных/озерном хранилище, не задумываясь о том, как они туда попали. Один заказчик может покупать и создавать множество приложений на базе одной основной системы данных. Мы даже начинаем видеть, как традиционные корпоративные системы, такие как финансовая или продуктовая аналитика, перестраиваются на основе "хранилищно-нативной" архитектуры.
Картинка может выглядеть следующим образом:
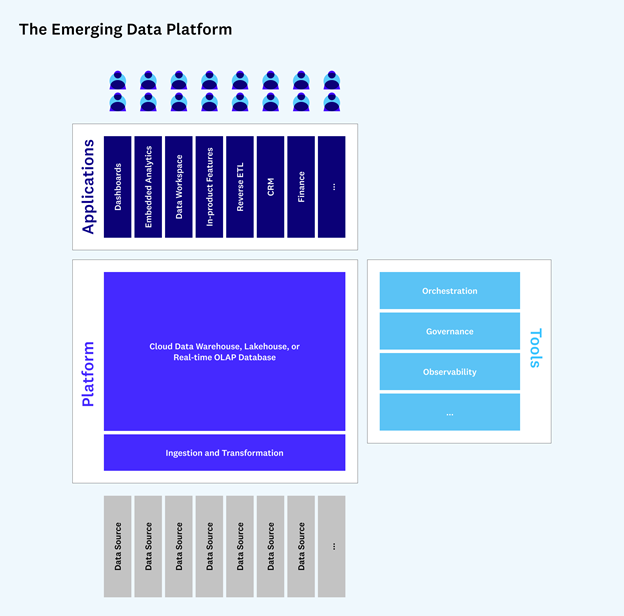
Это не означает, что базы данных OLTP или другие важные технологии бэкенда исчезнут в ближайшем будущем. Но собственная интеграция с OLAP-системами может стать критически важным компонентом разработки приложений. И со временем все больше бизнес-логики и функциональности приложений может перейти на эту модель. Возможно, мы увидим целый класс новых продуктов, построенных на этой платформе данных.
Появление приложений для работы с данными?
Гипотеза о платформе данных до сих пор остается весьма спорной. Однако мы наблюдаем рост числа сложных вертикальных SaaS-решений, реализуемых в качестве горизонтальных слоев поверх платформ данных. Поэтому, хотя и на ранней стадии, мы бы утверждали, что изменения, происходящие в стеке данных, по крайней мере, согласуются с идеей о том, что платформы набирают силу.
Например, существует множество причин, по которым такие компании, как Snowflake и Databricks, стали устойчивыми элементами стека данных, включая поставку отличных продуктов, эффективные отделы продаж и т.д. Но есть и доводы в пользу того, что их устойчивость усиливается динамикой развития платформы: после того как заказчик построил и/или интегрировал ряд приложений для работы с данными с помощью одной из этих систем, переход на другую часто не имеет смысла.
Аналогичный аргумент можно привести и в отношении резкого роста числа новых продуктов инфраструктуры данных за последние годы. Типичные объяснения этой тенденции связаны с огромными массивами данных, ростом корпоративных бюджетов и обилием венчурного финансирования. Однако все это, по всей видимости, было верно на протяжении десятилетий. Причина появления такого количества новых продуктов может быть связана с платформами, а именно с тем, что никогда еще не было так просто внедрить новое приложение для работы с данными и никогда еще не было так важно правильно поддерживать платформу в рабочем состоянии.
Наконец, гипотеза платформ дает определенную предсказательную силу в отношении динамики конкуренции. В масштабах компании платформы могут быть чрезвычайно ценными. Поставщики основных систем обработки данных сегодня могут вести агрессивную конкурентную борьбу не только за текущие бюджеты, но и за долгосрочные позиции платформы. Впечатляющие оценки стоимости компаний, занимающихся сбором и преобразованием данных, или особенно жаркие споры вокруг новых категорий, таких как слой метрик или обратный ETL, также имеют смысл, если вы считаете, что они являются основной частью формирующейся платформы данных.
Взгляд в будущее
Мы все еще находимся на ранних стадиях определения аналитической и операционной платформы данных, а ее составные части находятся в непрерывном движении. Поэтому, скорее всего, это понятие больше подходит в качестве аналогии, чем в качестве строгого определения. Однако она может оказаться полезным инструментом для отсеивания сигнала от шума и для выработки понимания того, почему рынок движется именно так, как он движется. В настоящее время команды по работе с данными имеют больше инструментов, ресурсов и организационного импульса, чем когда-либо (вероятно) с момента изобретения базы данных. И мы с нетерпением ждем, как будут развиваться платформы данных.


