

Оптимизация работы с Big Data с помощью опции автомасштабирования Presto
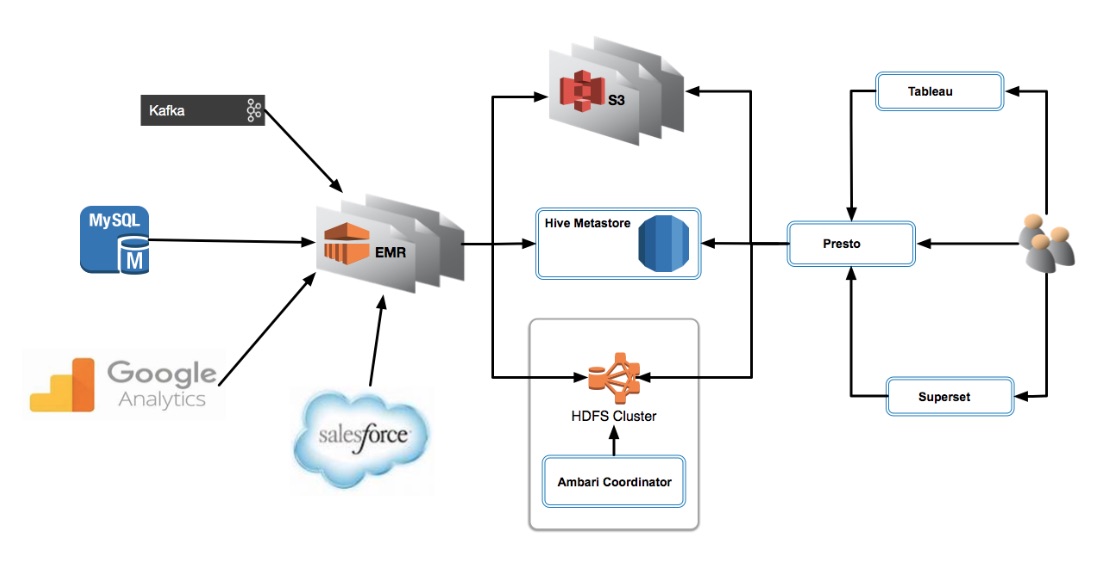
Недавно команда дата-иженеров, работающих в Eventbrite, кардинальным образом изменила корпоративную экосистему данных, внеся в нее несколько изменений. Так, нововведения коснулись инфраструктуры КХД и инструментов, используемых для аналитики данных.
Что именно было изменено или усовершенствовано:
- Переход на новый кластер Hadoop. В результате была создана более надежная, безопасная и производительная среда для хранения данных.
- Обновление Tableau до последней версии и перенос серверов Tableau в ту же инфраструктуру AWS, что и Presto. Настройка Tableau на подключение через собственный выделенный кластер Presto. Скорость передачи данных, особенно из Tableau, увеличилась как минимум в 10 раз!
- Обновление Presto до последней версии и настройка распределения ресурсов (с помощью AWS Auto Scaling) в целях оптимизации работы аналитиков. Теперь Presto работает гораздо быстрее и стабильнее.
В этой статье мы поговори о том, как Eventbrite использует AWS Auto Scaling для Presto с помощью Auto Scaling Group, Scaling Policy и Launch Configuration. Такое решение позволило компании удовлетворить рабочие потребности дата-инженеров, аналитиков и специалистов по изучению данных, обеспечив тем самым более высокую производительность работы экосистемы при минимальных затратах.

Хранилище данных в AWS
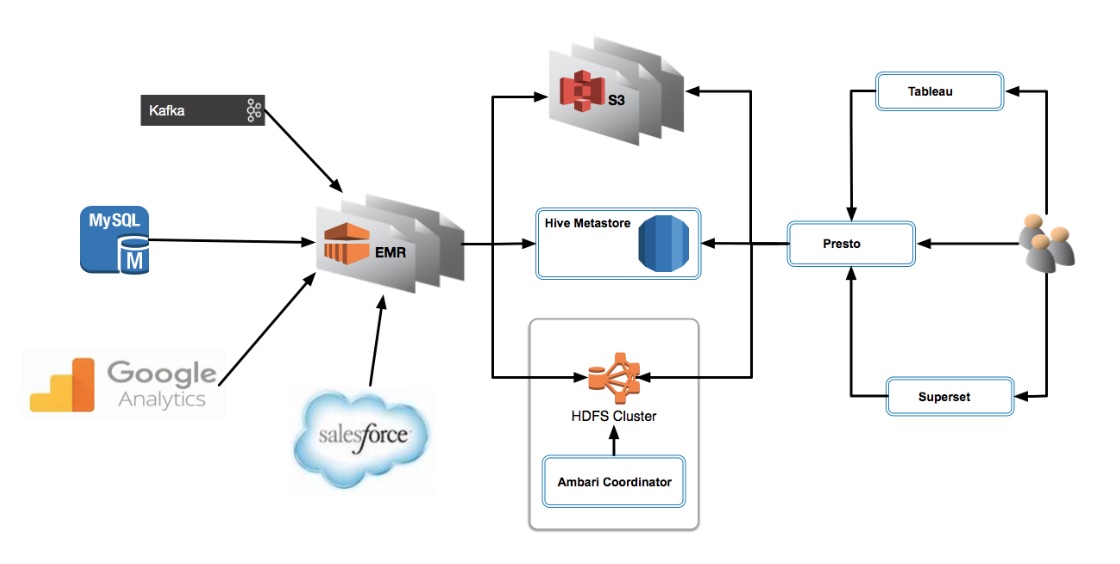
Компания Eventbrite работает с AWS, предлагающим несколько сервисов хранения. Давайте посмотрим на структуру КХД организации.
Superset и Tableau
Для доступа к данным, хранящимся в нашем хранилище данных, мы используем Presto. Presto - это инструмент, предназначенный для оптимизации работы с Big Data за счет использования распределенных запросов. Он поддерживает стандарт ANSI SQL, включая сложные запросы, агрегации и объединения данных. Команда разработчиков Presto создала его как альтернативу инструментам, запрашивающим HDFS с помощью конвейеров заданий MapReduce. Данный продукт подключается непосредственно к метахранилищу Hive, что позволяет пользователям совместно использовать одни и те же данные из Hive, Spark и других инструментов экосистемы Hadoop.
Кроме того, компания работает с Apache Superset, поставляемый вместе с Presto. Superset - это веб-приложение для изучения данных, которое позволяет пользователям обрабатывать данные самыми различными способами, включая написание SQL-запросов, создание новых таблиц и загрузку данных в формате CSV. Среди прочих инструментов компания сделала свой выбор в пользу IDE SQL Lab от Superset, дающего возможность изучения и предварительного просмотра таблиц в Presto, составления SQL-запросов и сохранения выходных файлов в формате CSV.
Что касается визуализации данных, большинство запросов обрабатывается с помощью Tableau . Однако в этом плане сотрудники компании экспериментирует и с Superset, изучая его возможности создавать информативные графики и диаграммы, а также сводить их в единый дашборд. .
Одно из главных преимуществ Superset заключается в том, что это экономически эффективное open-source решение. Однако и у него, как у любого другого инструмента, есть свои недостатки, в частности ему не хватает некоторых полезных функций, таких как создание триггеров на графиках и всплывающих подсказок, а также выполнение операций, не связанных с построением запросов SQL. Именно поэтому основным инструментов визуализации корпоративных данных является Tableau, а не Superset, и все же компания планирует в будущем реализовывать подобные проекты и с помощью одной из мощнейших платформ данных.
И Tableau, и Superset подключаются к Presto, который извлекает данные из таблиц Hive, расположенных на S3 и HDFS, обычно хранящихся в формате Parquet.
Автомасштабирование
Amazon EC2 AutoScaling позволяет избежать ручного выделения мощностей Amazon EC2 для решения широкого круга задач. Например, мы можем использовать политики масштабирования и выбирать метрики рабочих нагрузок для нашего приложения, например загрузку CPU.
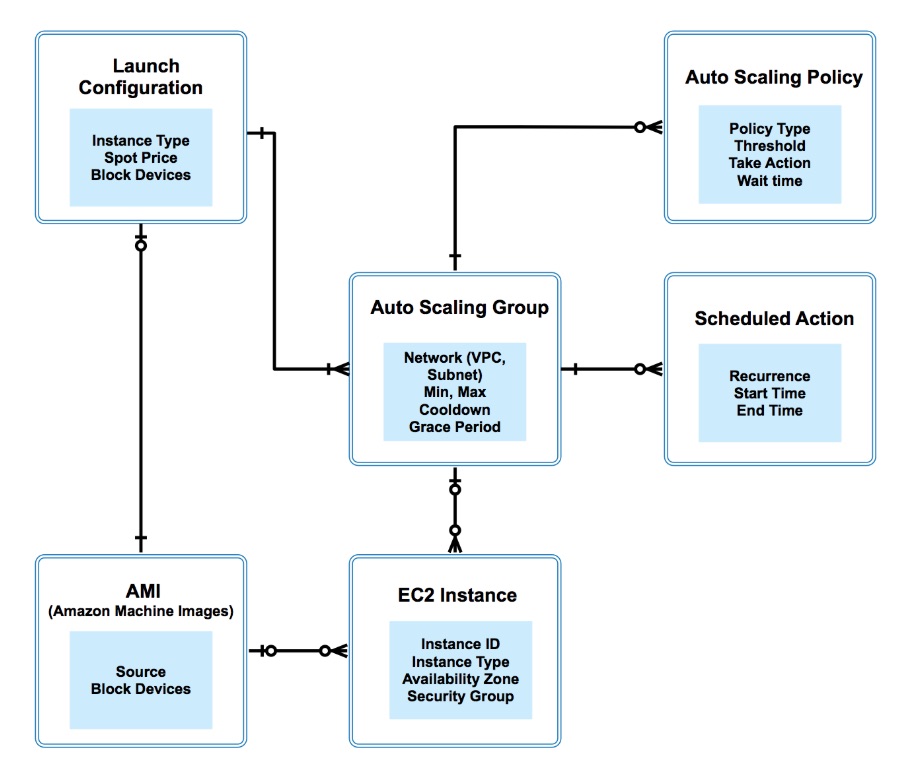
Очень важно разбираться в терминологии AWS Auto Scaling. Такие инструменты, как«Launch Configuration», «Auto Scaling Group» и «Auto Scaling Policy» являются жизненно важными компонентами сервиса , о которых мы поговорим чуть позже. Ниже представлена диаграмма, отражающая взаимосвязь между основными компонентами AWS Auto Scaling. Как представитель старой школы, я предпочитаю мыслить терминами сущностей и их взаимосвязей, отраженных в модели ERD.
Автомасштабирование Presto
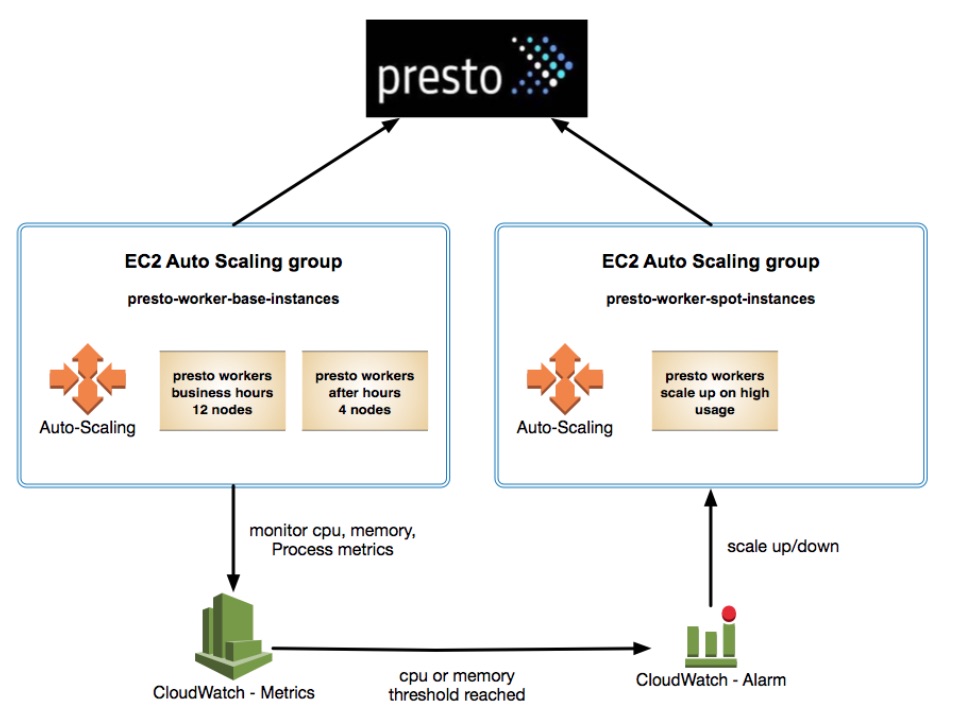
Мы используем автоматическое масштабирование AWS для наших «точечных» экземпляров Presto на основе (I) использования процессора и (II) количества запросов (используется только для уменьшения масштаба). Вот наша настройка автоматического масштабирования EC2 для Presto.
Вот несколько примеров политик:
Тип №1: Простое масштабирование (I)
Выполняйте политику в том случае, когда: нагрузка на процессор >= 50 в течение 60 секунд.
Какое действие необходимо предпринять: предоставьте 10 экземпляров EC2
Тип № 2: Простое масштабирование (II)
Выполняйте политику в том случае, когда: выполнение запросов <= 0 в течение 2 последовательных периодов по 300 секунд.
Какое действие необходимо предпринять: установите 0 для всех экземпляров.
NB: Команда дата-инженеров Eventbrite разработала собственный скрипт на языке Python, позволяющий обмениваться данными с Cloudwatch. Он обрабатывает состояния гонки в случае, когда во время процесса уменьшения масштаба поступает другой запрос. Мы добавили «защиту от завершения», которая использует этот скрипт Python а каждом рабочем узле Presto. Если эта настройка обнаруживает, что на этом узле в данный момент выполняется какой-либо запрос, то он не будет уменьшать масштаб.
Планирование действий Tableau
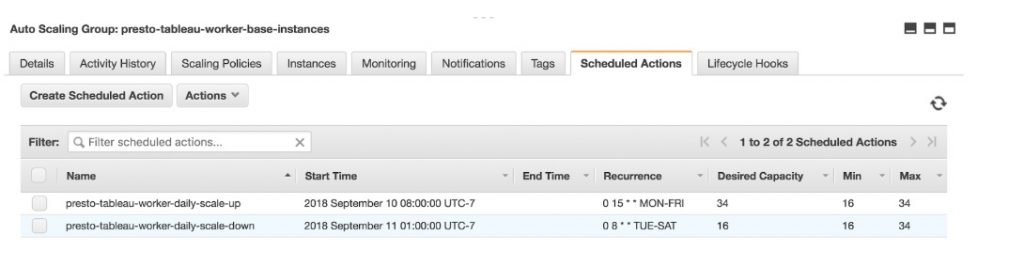
Мы используем функцию «Масштабирование по расписанию» для наших экземпляров Tableau Presto, а также для наших «базовых» экземпляров, используемых для Presto, таким образом, мы увеличиваем количество экземпляров утром и уменьшаем вечером. Мы настроили масштабирование по расписанию на основе предсказуемых рабочих нагрузок.
«Масштабирование по расписанию» требует настройки запланированных действий, которые заставляют Amazon EC2 Auto Scaling работать в определенные промежутки времени. Для каждого запланированного действия мы указываем время начала, а также минимальный, максимальный и желаемый размер группы.
Cloudwatch
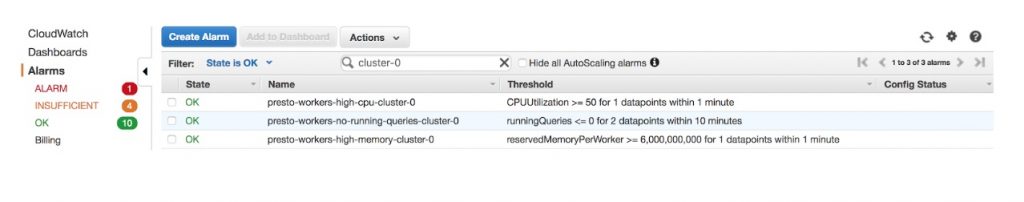
Для выявления изменений мощности с помощью AWS CloudWatch Alarms мы включили метрики Auto Scaling Group. При срабатывании эти сигналы будут заставлять группы автомасштабирования выполнять политику при превышении установленного порога. В некоторых случаях мы используем оповещения EC2, а в других - отправляем в Cloudwatch пользовательские метрики с помощью скриптов Python.
Примеры AWS CloudWatch Alarms :
Несколько кластеров Presto
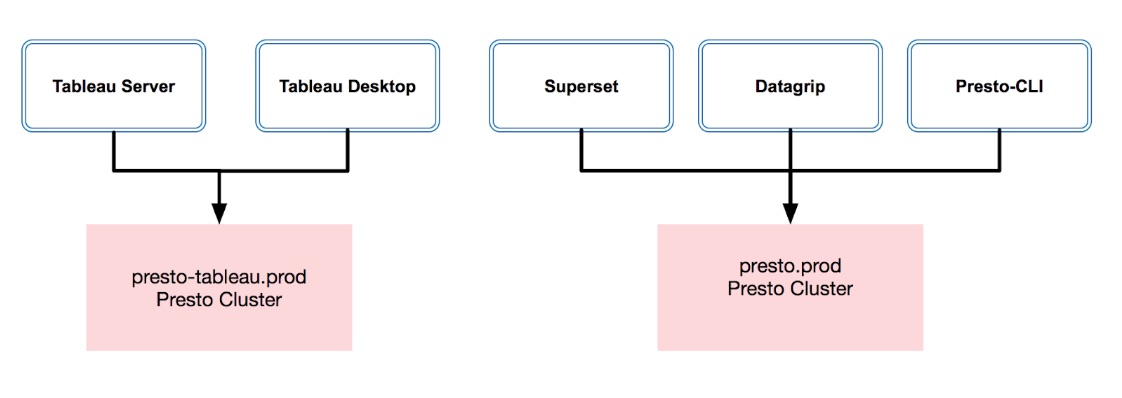
Мы разделили соединения Tableau и специальные соединения Presto. Это позволило нам выявить использование специальных запросов от случая использования Tableau.
EMR
Наши сотрудники, работающие с Presto, оперируют данными, которые записываются нашими постоянными кластерами EMR. Задания по вводу данных и процессы ETL выполняются на EMR кластерах ежечасно, имея доступ к Spark, Hive и Sqoop. Использование EMR позволяет нам отделить хранение данных от вычислений, используя комбинацию S3 и собственный кластер HDFS. Главное это то, что мы платим за вычисления только тогда, когда используем их!
У нас есть несколько кластеров EMR, которые записывают данные в таблицы Hive, поддерживаемые S3 и HDFS. Мы запускаем кластеры EMR для выполнения процессов ETL, которые ежедневно/ежечасно загружают таблицы нашего хранилища данных. В настоящее время мы не привязываем наши кластеры EMR к автомасштабированию.
По умолчанию EMR хранит информацию о метахранилище Hive в базе данных MySQL. Это центральное хранилище метаданных Apache Hive, хранящее такую информацию, как структура схемы, расположение и разделы. Когда кластер завершается, мы теряем локальные данные, поскольку файловые системы узлов используют эфемерное хранилище. Нам нужно сделать так, чтобы метахранилище сохранялось, поэтому мы создали внешнее метахранилище, организованное вне кластера.
Мы не используем каталог данных AWS Glue, вместо этого наши дата-инженеры управляют метахранилищем Hive на Amazon Aurora. Если что-то пойдет не так, мы сможем исправить это своими силами.
Команда дата-инженеров создала постоянный одноузловой «кластер» EMR, используемый Presto для доступа к метахранилищу Hive. Рабочие модули Presto взаимодействуют с кластером, передавая ему информацию о местонахождении данных, разделах и структурах таблиц.
Заключение
Итак, мы поговорили о модернизации инфраструктуры хранилища данных и совершенствовании инструментов, используемых для аналитики данных Eventbrite. Автоматическое масштабирование AWS позволило нам повысить эффективность работы наших аналитиков и при этом сэкономить средства.
Основными достижениями проделанной нами работы являются следующие:
- Снижение затрат
AWS Auto Scaling позволяет нам платить только за те ресурсы, которыми мы пользуемся. Когда спрос на сервисы падает, AWS Auto Scaling удаляет излишки ресурсов, что позволяет нам избежать перерасхода средств.
- Повышение адаптации к изменениям
AWS Auto Scaling позволяет нам увеличивать или уменьшать емкость хранилища по мере необходимости. Кроме того, мы избавились от проблем снижения производительности, вызванных нетривиальных ошибок, появившихся вследствие неудачных запросов из-за проблем с пропускной способностью.
- Улучшение контроля
Для того, чтобы убедиться в том, что наша система работает как запланировано, мы используем метрики Amazon CloudWatch.


