

Потоковая загрузка данных и обновления
Потоковая загрузка данных и обновления являются одним из краеугольных камней современного анализа больших данных. В контексте Apache Doris это особенно важно: Doris спроектирован как аналитическая платформа колоночного типа, ориентированная на быстрый ответ на запросы по огромным объемам данных. Чтобы поддерживать актуальность актуальных данных в аналитических дэшбордах и отчетах, организации используют потоковую загрузку (streaming ingestion) и постоянные обновления данных. Это позволяет не ждать вечерних пакетных загрузок, а видеть новые события и изменения в кластере Doris почти в реальном времени.
Эта глава призвана помочь вам, новому сотруднику, понять, зачем нужна потоковая загрузка и обновления в Doris, какие концептуальные подходы существуют, какие инструменты и методы применяются на практике, как устроены типичные конвейеры, какие технические детали следует учитывать при проектировании и эксплуатации, а также какие риски и ограничения сопровождают внедрение такого подхода. Мы рассмотрим как открытые решения, так и российские практики, приведем практические примеры и сценарии, чтобы вы могли подобрать подходящий стек под задачи вашей компании.
Ключевые понятия и терминология
- Потоковая загрузка (streaming ingestion): процесс непрерывной передачи данных из источников в хранилище аналитического типа, с минимальной задержкой между появлением события и его доступностью для аналитики.
- Режим Stream Load: механизм отправки данных в Doris через HTTP API в виде пакетов/потоков, которые Doris обрабатывает и загружает в целевые таблицы. Позволяет достигать высокой скорости загрузки и поддерживает повторные попытки.
- Рутинная загрузка (Routine Load): механизм периодической или непрерывной загрузки из внешних источников файловых систем или хранилищ данных (например, HDFS, S3-совместимые объекты). Позволяет настраивать долговременные задания, которые следят за появлением новых файлов и загружают данные в Doris.
- Источники данных: потоковые источники (Kafka, Pulsar, Kinesis), CDC-системы (Debezium, Confluent), логи приложений и баз данных, данные из файловых систем (HDFS, S3), 1C и др.—в зависимости от конвейера.
- Преобразование и обогащение: этапы ETL/ELT, где данные приводят к нужной схеме, валидируются, обогащаются и приводятся к совместимым форматам перед загрузкой в Doris.
- Схема и типы данных Doris: Doris имеет собственную нотацию и типы колонок, совместим остальной аналитической нагрузке. Важно заранее согласовать схему входных данных с существующей таблицей в Doris, чтобы избежать несовместимости типов, ошибок преобразования и дорисовок столбцов.
- Размещение и распределение: выбор ключей разбиения (distribution keys) и партиционирование в Doris критично для производительности запросов и равномерной загрузки. Потоковые конвейеры должны учитывать географическое распределение данных и балансировку нагрузки.
- Идempotентность и повторные попытки: в потоковых конвейерах возможны дубликаты из-за повторных попыток передачи или повторной обработки. Важно проектировать загрузку так, чтобы повторные пачки не портили консистентность данных.
- Мониторинг и операционная устойчивость: мониторинг скорости загрузки, задержек, ошибок, долговременная устойчивость конвейеров, алерты и автоматическое ретриирование.
Зачем нужна потоковая загрузка в Doris
- Актуальность данных: аналитика может опираться на данные почти в реальном времени, что облегчает оперативное принятие решений.
- Эффективность обновлений: вместо ежечасных пакетных загрузок можно поддерживать таблицы в состоянии близком к постоянному обновлению.
- Масштабируемость: Doris строится на распределенной архитектуре, которая хорошо масштабируется по объему данных и по скорости загрузки.
- Гибкость интеграций: потоковые конвейеры позволяют подключать различные источники, от корпоративных транзакционных БД до логов приложений и внешних файлов.
Архитектурные подходы к потоковой загрузке в Doris
- Классический потоковый конвейер: источник данных (Kafka/Pulsar) — обработка и преобразование (например, в Flink) — пакетная загрузка в Doris через Stream Load. Этот подход обеспечивает высокую скорость и гибкость обработки и позволяет внедрять проверки качества данных.
- CDC-центрированный подход: средства CDC (Debezium, собственные коннекторы) захватывают изменения в БД и публикуют события в поток, откуда они попадают в Doris через преобразование и загрузку. Подходит для ситуаций, когда требуется минимальная задержка между изменением в источнике и доступностью изменений в аналитике.
- Файловый подход с Routine Load: данные с периодическими обновлениями попадают в файловые хранилища (HDFS, S3 и др.), Routine Load автоматически считывает новые файлы и загружает их в Doris. Хорошо подходит для больших объемов архивной или веб-логовой информации.
Методология проектирования потоковых конвейеров
- Определение целей и SLA: какие задержки допустимы, какие данные должны задержаться, какие транзакции должны поддерживать exactly-once delivery.
- Выбор источников и форматов: какие источники, какие форматы (JSON, Parquet, CSV, ORC), как обрабатывать схемы и эволюцию схем.
- Модель данных и схема: выравнивание схемы источников с целевой схемой Doris; согласование типов данных, правил преобразования и валидности.
- Управление схемой и эволюцией: как обрабатывать изменение структуры источников; какие механизмы версии схем, схемные эволюции и миграции.
- Этапы обработки: минимизация ошибок, обработка ошибок загрузки, повторные попытки, очистка дубликатов, контроль качества данных (валидаторы, бизнес-правила).
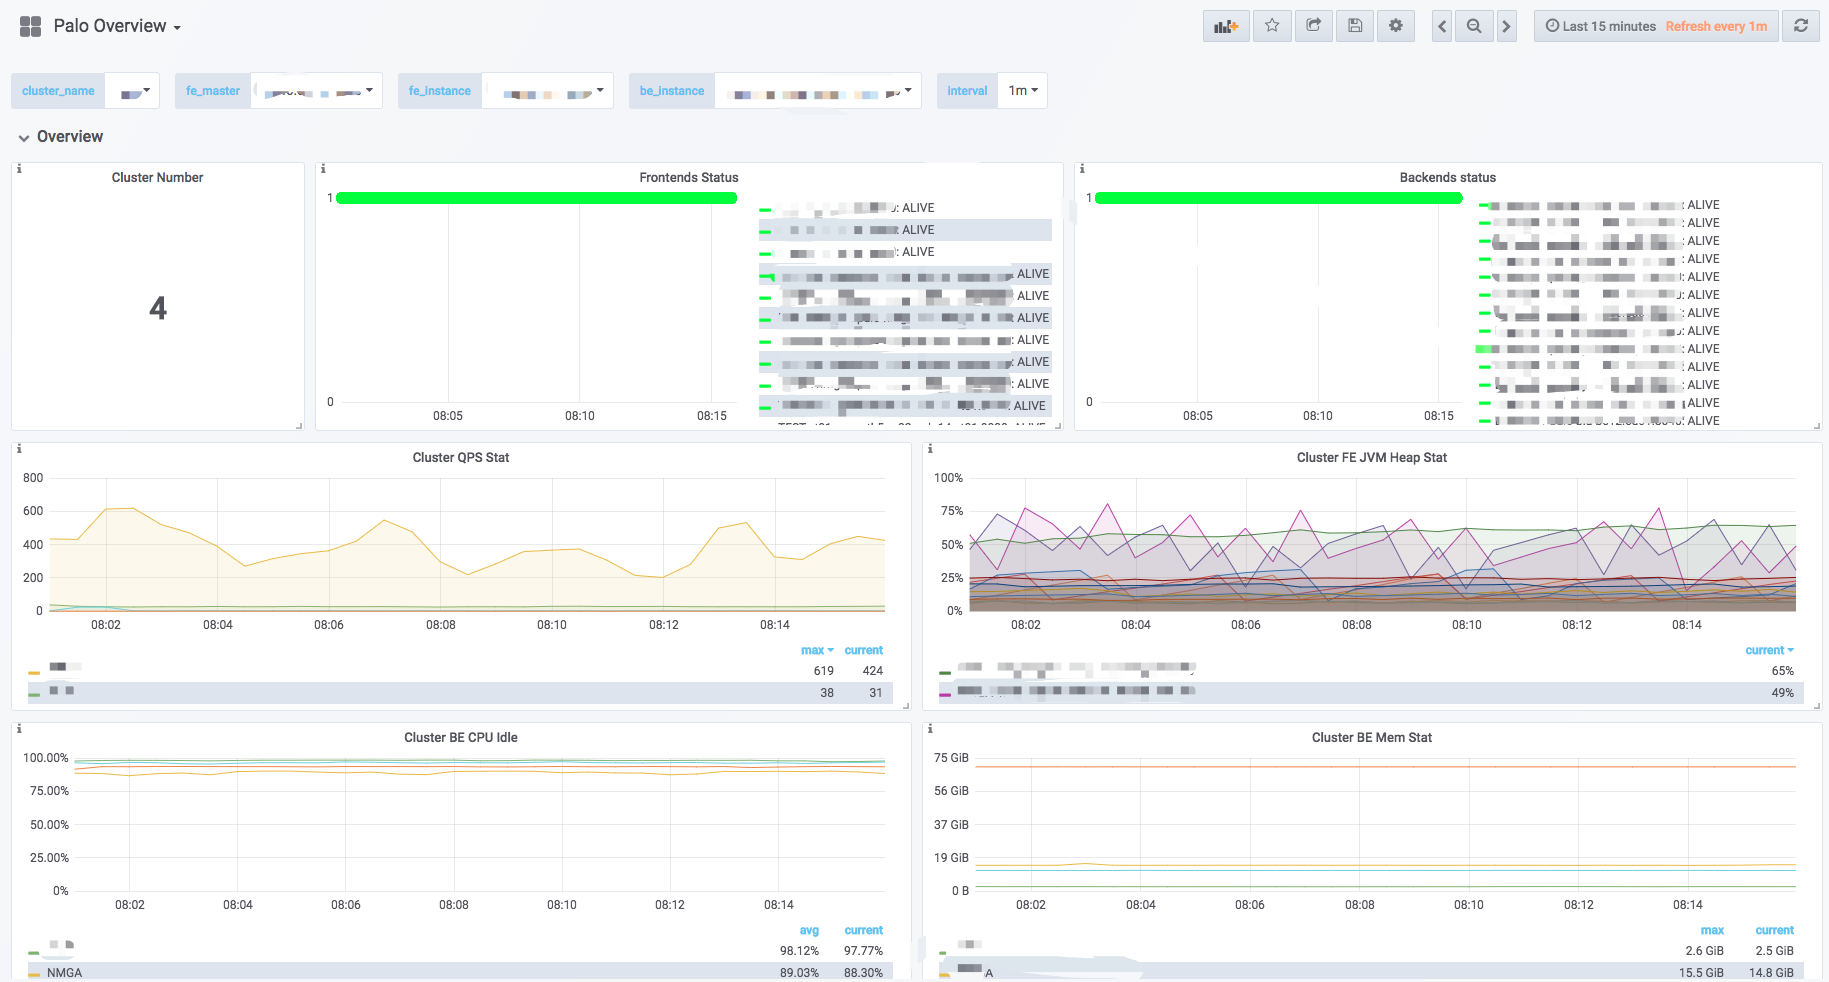
- Мониторинг и алертинг: какие метрики важны (скорость загрузки, задержка, количество ошибок, доля пропущенных ключей), какие инструменты используются (Prometheus, Grafana, внутренние дэшборды Doris).
- Безопасность и доступ: шифрование при передаче, аутентификация к API загрузки, контроль доступа, аудит операций.
- Надежность и устойчивость: ретраи, offload, гидравлическое разворотное переключение (blue-green), тестирование конвейеров в продакшене.
Практические примеры
Пример 1. Реализация потоковой загрузки из Kafka в Doris с помощью Stream Load и обработки на Apache Flink (open-source стек)
Контекст: требуется оперативная аналитика по событиям веб-приложения. Источникских данных — события клиентов в формате JSON в Kafka. Нужно обеспечивать минимальную задержку, сохранять порядок внутри разделов (partition) и поддерживать повторные попытки.
Архитектура:
- Источник: Kafka топики с событиями пользователей.
- Обработка: Apache Flink в режиме потока читает данные из Kafka, преобразует их в формат пригодный для загрузки в Doris (например, строковый формат или компактный JSON-строки, согласованный со схемой таблицы Doris).
- Загрузка: потоковая отправка данных в Doris через Stream Load API. Каждый пакет данных сопровождается уникальной меткой (label) и флагами контроля качества. В ответ Doris возвращает статус загрузки и обработку ошибок, что позволяет Flink осуществлять повторную отправку только для тех пачек, которые не удалось загрузить.
- Хранилище Doris: целевая таблица, разнесенная по партициям/распределительным ключам для равномерной загрузки и быстрого анализа.
Практическая реализация (приближенная схема действий):
- Создайте таблицу в Doris с необходимой схемой и распределением по ключу(ям). Убедитесь в соответствии типов данных полям входных JSON.
- Настройте Kafka источник в Flink: потребление JSON-сообщений с корректной схемой, обработку временных меток, возможно, коррекцию часовых поясов.
- Реализуйте Sink в Flink, который пакетирует события в разумные блоки данных (например, пачку по 10–100 тысяч строк) и отправляет их через HTTP-Stream Load запрос к Doris.
- В payload-пакете формируйте строки данных, соответствующие формату загружаемой таблицы Doris, включая настройку формата данных, символов-разделителей, пропуска и обработки пустых значений.
- Управляйте уникальным label для каждой отправки, чтобы поддерживать идемпотентность и простую отладку.
- Обработка ошибок: если Doris возвращает ошибку по какому-либо пакету, повторно отправляйте только проблемную часть, детализируйте логи, фиксируйте ошибку и создайте тикет на исправление.
- Мониторинг: следите за задержкой между появлением события и доступностью в Doris, за размером пачек и эффективностью нагрузки на Doris. Включите алертинг при задержке выше порога или росте ошибок.
Преимущества данного подхода:
- Гибкость обработки: можно в реальном времени обогащать данные, фильтровать невалидные записи, конвертировать форматы.
- Контроль над порядком: в рамках каждой пачки можно сохранять относительный порядок, что важно для некоторых аналитических сценариев.
- Механизмы повторного выполнения и детализированное журналирование.
Ограничения и риски:
- Неполная идемпотентность на уровне стейта источника может привести к дубликатам, особенно при повторной отправке пакетной загрузки.
- Неполная обработка ошибок может привести к пропуску важных событий. Требуется детальная обработка ошибок Doris и повторные попытки.
- Задержки сети и нестабильность потоков могут повлиять на латентность, особенно при высокой частоте обновления.
Пример 2. CDC-поток из MySQL в Doris через Debezium + Kafka + Flink
Контекст: необходимо синхронизировать изменения транзакционной базы данных MySQL в Doris для оперативной аналитики.
Архитектура:
- Источник изменений: MySQL, через Debezium CDC извлекает изменения и публикует их в Kafka.
- Поток обработки: Flink читает колонки изменений из Kafka, преобразует каждое изменение в напрям формат, пригодный для загрузки в Doris, обогащает данные и управляет семантикой временных меток.
- Загрузка: как и в примере 1, пакеты данных отправляются в Doris через Stream Load с уникальными label и параметрами контроля над форматом.
- Хранение: целевая таблица Doris отражает схему транзакций, поддерживает обновления и аналитический доступ.
Преимущества:
- Непрерывная синхронизация транзакций, почти в реальном времени.
- IQ-матрица изменений позволяет строить детальные аналитику и аудит изменений.
Риски и нюансы:
- CDC-поток требует точной настройки временных зон и точной конвертации типов.
- В некоторых случаях изменения могут приходить out-of-order; необходимы механизмы коррекции порядка и идентификации дубликатов.
- Сложная цепочка из Debezium → Kafka → Flink может усложнить мониторинг и отладку; требуется централизованный логинг и трассировка.
Пример 3. Локальная интеграционная платформа на базе Apache NiFi (российские проекты/решения)
Контекст: крупная российская организация хочет иметь визуальную оркестрацию потоков данных и возможность быстро настраивать конвейеры.
Архитектура:
- Источники: файлы в HDFS/S3, базы данных, сообщения в MQ, веб-лог.
- Оркестрация: NiFi управляет потоками, маршрутизирует данные, выполняет преобразование, валидирует и записывает в Doris.
- Загрузка: NiFi может отправлять данные через HTTP-интерфейс Doris для Stream Load, а также может выгружать данные в Doris через JDBC-доступ, если требуется временная миграция.
- Мониторинг и управление: NiFi предоставляет детализированные логи и визуальные дашборды.
Преимущества:
- Визуальная настройка без глубокого программирования.
- Быстрая адаптация под новые источники и данные.
Риски и нюансы:
- Требуется дополнительная инфраструктура и поддержка NiFi.
- Обновление схем и совместимости с Doris требует контроля версий конвейера.
Пример 4. Routine Load из файловых хранилищ (HDFS/S3) с использованием Routine Load
Контекст: регулярная загрузка больших архивов журналов, выгруженных из систем через ночные пакетные выгрузки.
Архитектура:
- Файловое хранилище: новые файлы периодически появляются в HDFS или S3.
- Routine Load: Doris сканирует источники файлов, загружает новые данные в целевую таблицу.
- Трансформация: данные очищаются/преобразуются до загрузки (можно использовать внешние преобразования перед загрузкой или сделать преобразование во время загрузки).
Преимущества:
- Простота эксплуатации для больших объемов архивной информации.
- Высокая пропускная способность загрузки за счет пакетной загрузки.
Риски и нюансы:
- Задержка между появлением файла и загрузкой зависит от расписания Routine Load.
- Эволюция схемы может потребовать миграций.
Технические детали
Схема данных и таблицы Doris
- Правильная настройка схемы: приводите входные данные к совместимой схеме таблицы в Doris. Это включает согласование имен столбцов, типов данных и форматов дат/времен.
- Разделение и распределение: используйте подходящие distribution keys и партиционирование, чтобы избежать перегрузки конкретных узлов и обеспечить равномерную загрузку и быстрые запросы.
- Модель времени: если данные содержат временные штампы, используйте эффективное хранение времени и согласование часовых поясов между источником и Doris.
- Эволюция схемы: разработайте план эволюции схемы, чтобы адаптироваться к изменению форматов входных данных без потери единообразия и без ошибок загрузки.
Форматы данных и совместимость
- JSON/CSV/Parquet: Doris хорошо поддерживает текстовые форматы (JSON, CSV) и колонночный Parquet/ORC для внешних источников схемной части, в зависимости от конвейера.
- Преобразование форматов: используйте обработчики конвейеров (Flink, NiFi, Debezium) для нормализации данных к целевой схеме Doris.
Конфигурация загрузки и параметры
- Stream Load: конвейер отправляет данные в Doris через HTTP-API для загрузки. Важно обеспечивать уникальные метки загрузки, управлять форматом данных и корректно обрабатывать ответы Doris.
- Routine Load: устанавливайте параметры для источников (путь к файлам, интервалы сканирования, правила обработки дубликатов, схема), чтобы Doris мог автоматически обрабатывать новые данные без ручного вмешательства.
- Масштабирование: на больших объемах рассмотрите параллелизацию загрузки, настройку нескольких параллельных задач загрузки, а также контроль за ресурсами кластеров Doris (CPU, память, дисковое пространство).
Безопасность и доступ
- Аутентификация и авторизация к Doris: используйте безопасные методы доступа, TLS/HTTPS, контроль прав на уровне таблиц и баз данных.
- Шифрование данных в движении и на диске: используйте TLS для передачи и, при необходимости, шифрование данных на диске.
- Аудит: ведите журнал операций загрузки, ошибок и изменений схем.
Мониторинг и качество данных
- Метрики: скорость загрузки, задержка данных, количество ошибок, доля повторной отправки, состояние конвейера, использование ресурсов.
- Валидаторы и сигналы качества: реализуйте проверки количества строк, контроль уникальности ключей, аудит схем, проверку частоты ошибок.
- Алерты: настройте уведомления об увеличении задержки, падении скорости загрузки и росте числа ошибок.
Риски и ограничения внедрения
1) Задержки и латентность
- Потоковые конвейеры зависят от источников и сетевой инфраструктуры; задержки могут быть вызваны сетевыми перебоями, задержками в обработке и загрузке.
- Решение: проектируйте конвейеры с буферизацией, мониторингом задержек и шагами по снижению задержек на критических участках (облегчение преобразований, параллелизация и т. п.).
2) Дубликаты и консистентность
- В сетях и при повторной отправке пакетов могут возникать дубликаты. Ваша задача — минимизировать дубли и обеспечивать идемпотентность загрузки.
- Решение: использовать уникальные идентификаторы пачек и транзакций, хранение состояния в конвейере, детальная обработка ошибок и повторные попытки только для проблемных данных.
3) Эволюция схемы
- Изменения входной схемы (добавление/удаление столбцов, изменение типов) могут привести к несовместимостям.
- Решение: внедрить схему-менеджмент: версионирование схем, миграции на стороне конвейера и специальных тестов на совместимость.
4) Взаимное влияние конвейеров и нагрузок Doris
- Большие объемы нагрузок могут повлиять на производительность Doris во время пииков.
- Решение: ограничение параллелизма, тщательная настройка ресурсов кластера Doris, мониторинг и гибкое масштабирование.
5) Безопасность и соответствие требованиям
- Потоки могут содержать чувствительные данные; необходимо обеспечить защиту данных и соблюдение регуляторных требований.
- Решение: безопасные каналы передачи, политике минимального права доступа, аудит и мониторинг доступа к данным.
6) Управление изменениями и поддержка
- Ваша инфраструктура может включать несколько инструментов и версий конвейеров; может потребоваться поддержка по обновлениям и совместимости.
- Решение: документируйте архитектуру, создайте единообразные политики выпуска и обновления, организуйте регламент по тестированию изменений.
7) Инструменты и экосистема
- Выбор инструментов между open-source-решениями и коммерческими продуктами влияет на стоимость владения и скорость внедрения.
- Решение: начинайте с минимальной рабочей конфигурации, затем наращивайте функциональность на основе реальных требований и доступных кадров.
Потоковая загрузка данных и обновления в Doris — мощный инструмент для достижения актуальности аналитики и ускорения бизнес-операций. Правильный выбор архитектуры конвейера, точная настройка схемы, эффективная обработка ошибок и устойчивый мониторинг позволяют строить надежные потоки данных из самых разных источников. В основе успешной реализации лежат ясные цели, хорошо спроектированная архитектура, корректная работа со схемами и форматом данных, а также внимательное отношение к рискам и ограничениям. Важно помнить, что каждый конвейер уникален: начинать следует с конкретного сценария, минимального набора инструментов и детального плана мониторинга, а затем постепенно расширять функциональность, добавляя новые источники, методы обработки и варианты нагрузок.
- Потоковая загрузка и обновления являются естественным продолжением архитектуры Doris при работе с большими данными и необходимы для оперативной аналитики.
- Важно строить конвейеры с учетом идемпотентности, корректной обработки ошибок и согласованной схемы данных.
- Выбор инструментов и подходов зависит от конкретного источника данных, требований к задержке и доступности, а также от финансовых и кадровых ресурсов.
- Решения должны сопровождаться мониторами, алертами и планами реагирования на инциденты.
- В России широко применяются как открытые стеки (Flink, Kafka, NiFi), так и прикладные локальные решения для интеграции и оркестрации потоковых конвейеров.
Вопрос–Ответ (FAQ)
1. Что такое Stream Load и чем он отличается от Routine Load в Doris?
Stream Load — это механизм загрузки данных в Doris в режиме потоковой передачи через HTTP API. Он предназначен для высокоскоростной загрузки данных из конвейеров в режиме реального времени или near-real-time с контролем по уникальному label, обработкой ошибок и повторными попытками. Routine Load же ориентирован на долговременные задачи загрузки из внешних файловых систем (HDFS, S3 и т.д.). Он автоматически обнаруживает новые файлы и пополняет таблицы Doris без явной интерактивной загрузки. В рамках Routine Load данные обычно загружаются пакетами из файловой системы, тогда как Stream Load — это более гибкий и оперативный поток, часто используемый вместе с Flink/Kafka.
2. Какие источники данных наиболее подходят для потоковой загрузки в Doris?
Наиболее характерные источники: Kafka/Pulsar для потоков событий, CDC-решения (Debezium и т. п.) для захвата изменений в базах данных, файлы в HDFS/S3 для Routine Load, логи приложений и веб-лог, данные из транзакционных БД через CDC-подход. В зависимости от требований задержки и структуры данных можно комбинировать подходы: например, Kafka+Flink+Stream Load для минимальных задержек и Debezium для точной истории изменений.
3. Как обеспечить idempotentность потоковой загрузки?
Используйте уникальные идентификаторы пачек загрузки (labels) и держите в конвейере статус загруженных данных. В Doris можно повторно отправлять только неудачные части, а успешно обработанные данные помечать как завершенные. В конвейере необходимо хранить состояние, чтобы повторная отправка не приводила к дубликатам в таблице без поддержки уникальных ключей и дубликат-детектора на уровне клиентов.
4. Какие риски связаны с эволюцией схем и как их минимизировать?
Изменения во входной схеме могут привести к несоответствию между источником и целевой таблицей Doris. Чтобы минимизировать риски, используйте версионирование схем, тестируйте миграции на отдельных средах, применяйте «мягкие» миграции (добавление новых столбцов без удаления старых), и реализуйте преобразование данных в конвейере до загрузки.
5. Что лучше использовать для российских проектов?
Выбор зависит от наличных ресурсов и компетенций. Открытые решения (Apache Flink, Kafka, NiFi) широко применяются в России и позволяют построить гибкую архитектуру. Российские проекты часто используют локальные решения по оркестрации и интеграции данных, включая NiFi в комбинации с Doris. В любом случае рекомендуется начать с минимального конвейера и постепенно добавлять источники и функциональность, чтобы обеспечить управляемость и поддержку.
6. Какие проблемные области характерны для потоковой загрузки и как их избегать?
Наиболее частые проблемы — задержки, дубликаты, ошибки в данных, несовместимость схем, нехватка ресурсов. Эффективные меры: мониторинг задержек и ошибок, настройка параллелизма и ресурсов кластера Doris, строгие политики обработки ошибок, тестовые окружения, автоматизация ретриирования и валидаций данных на входе.
7. Как проектировать конвейер под SLA?
Определите целевые задержки для каждого источника данных, выберите соответствующую архитектуру (Stream Load для минимальной задержки, Routine Load для больших архивов), внедрите устойчивые механизмы ретриирования и обработку ошибок, обеспечьте мониторинг и алертинг, и создайте план масштабирования на случай роста объема данных или пиковых нагрузок.
8. Какую роль играет согласование форматов данных?
Согласование форматов критично: неверная сериализация или несоответствие типов могут привести к ошибкам загрузки и потере данных. В конвейере следует явно определить формат входных данных, схему и правила преобразования перед загрузкой, а также обеспечить обратную совместимость схем.
9. Какие инструменты чаще всего применяют в связке Doris и потоковой загрузки?
Чаще всего применяют Apache Flink как обработчик стрима, Apache Kafka как источник сообщений, Apache NiFi для визуальной оркестрации, Debezium для CDC, S3/HDFS как источники Routine Load, и собственные REST API Doris для Stream Load. Мониторинг ведется через Prometheus/Grafana и внутренние дашборды Doris.
10. Какие практические шаги начать внедрять сегодня?
- Определите источник данных и требования к задержке.
- Спроектируйте схему целевой таблицы в Doris и параметры разнесения.
- Соберите минимальный поток: источник → обработчик → загрузчик в Doris (Stream Load).
- Введите базовую мониторинг и алертинг.
- Постепенно добавляйте источники и усложняйте конвейеры, учитывая риски и ограничения, описанные выше.
Начинайте с конкретной бизнес-задачи и готового набора данных: выберите источник (например, Kafka) и целевую таблицу Doris, реализуйте минимальный конвейер с Stream Load, внедрите базовый мониторинг и тестирование на предмет ошибок. Затем постепенно расширяйте конвейер: добавляйте новые источники, развивайте преобразования, улучшайте обработку ошибок и обеспечивайте устойчивость к пиковым нагрузкам. Не забывайте о документации и совместном использовании стандартов в команде, чтобы новый сотрудник мог быстро влиться в процесс.


