

Интеграция источников: HDFS, S3, Kafka, JDBC-источники
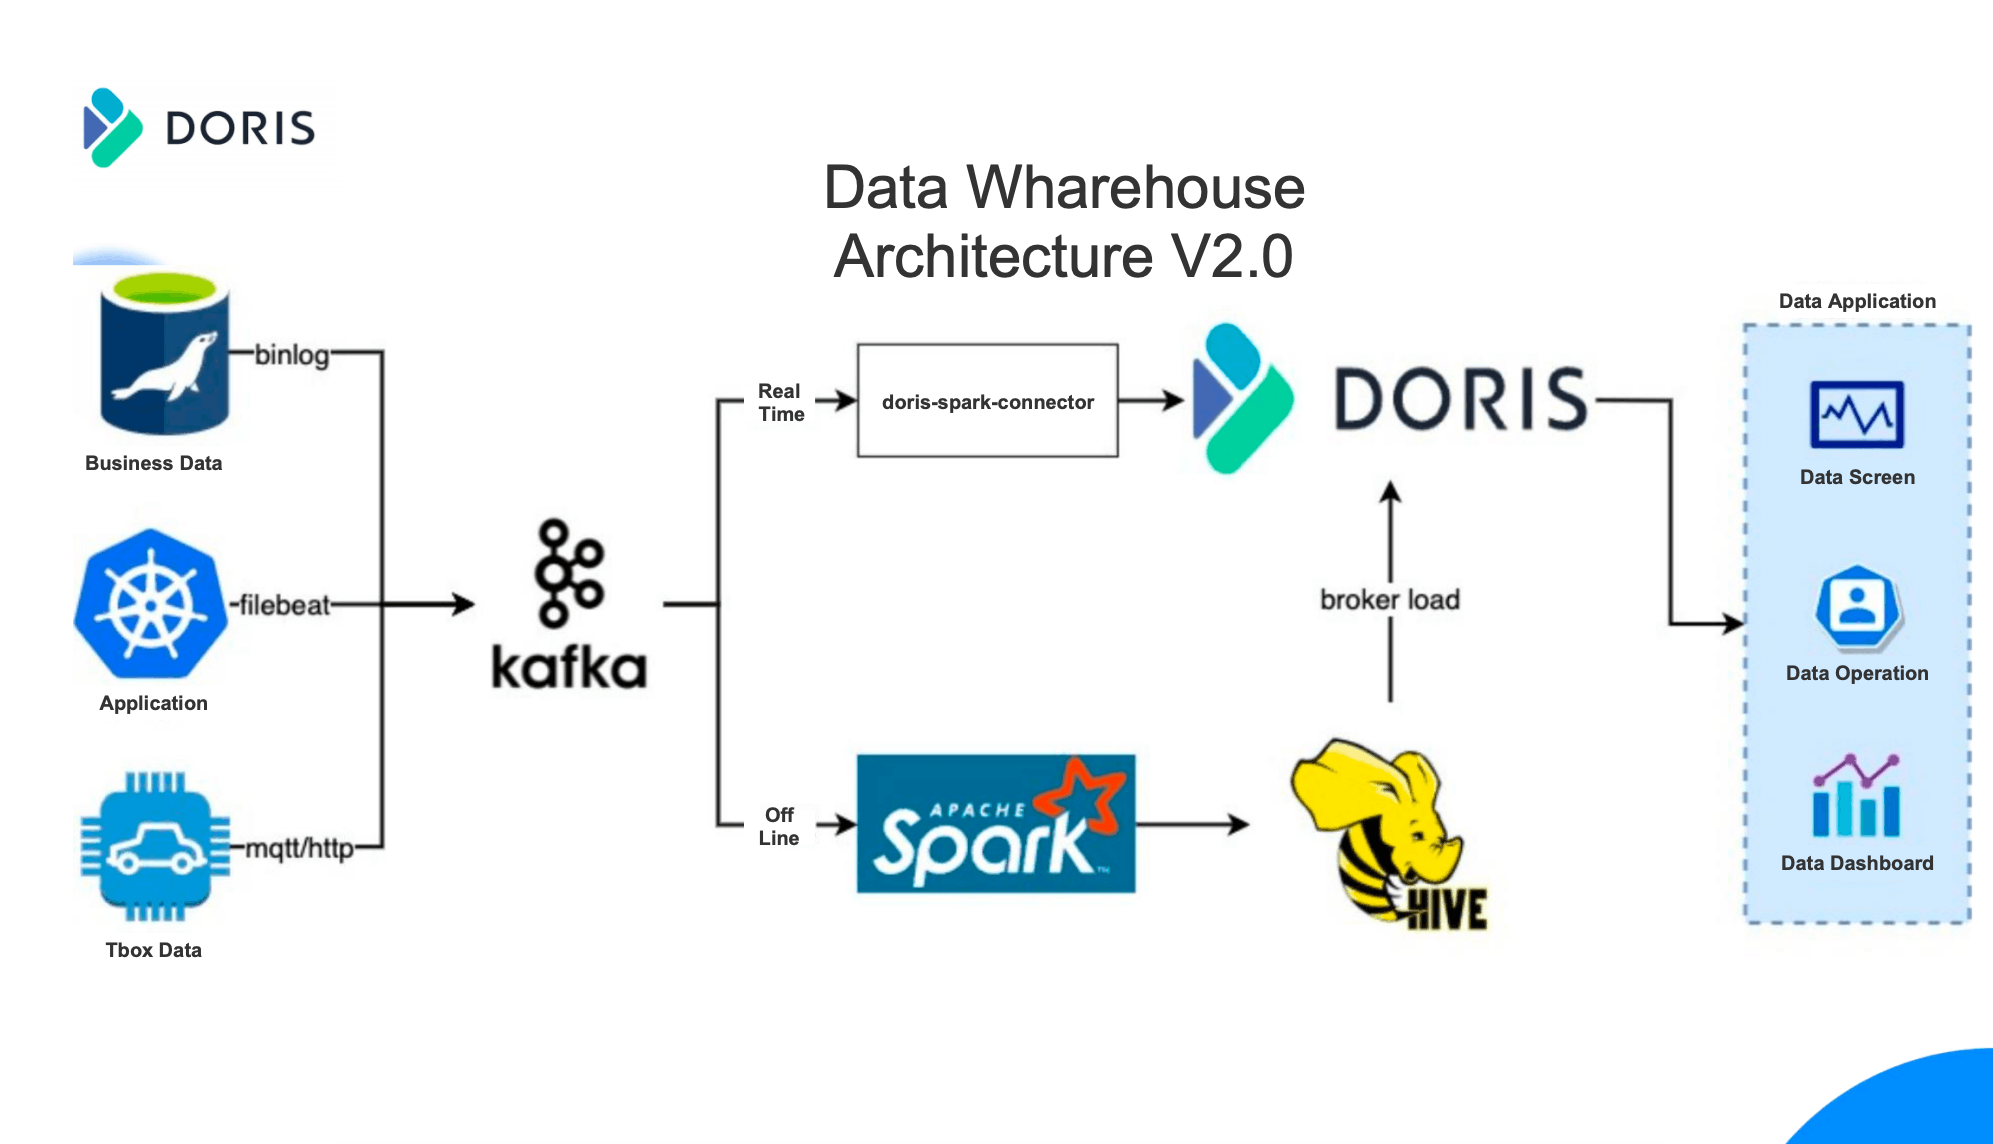
Интеграция источников данных в аналитическую платформу — одна из ключевых задач современного дата-архитектора. В курсе по Apache Doris мы уделяем особое внимание тому, как Doris может работать с внешними источниками: файловыми системами HDFS и S3-совместимыми хранилищами, потоковыми источниками Kafka и реляционными СУБД через JDBC. Цель этой главы — не просто перечислить возможности, но и дать практические шаги, типовые конфигурации, а также оценки рисков и ограничений, которые возникают на пути внедрения.
Что такое интеграция источников в Doris
Apache Doris — это распределённая колонночная аналитическая база данных, рассчитанная на высокую скорость выполнения запросов и масштабируемость. В Doris принято различать внутренние данные, которые хранятся внутри кластера Doris, и внешние источники, к которым можно подключаться для загрузки данных или выполнения запросов как часть аналитического потока. Основной механизм для работы с внешними источниками — концепция BROKER и внешних таблиц. BROKER — это модуль в Doris, который абстрагирует доступ к данным во внешнем источнике: HDFS, S3, Kafka и др. Внешняя таблица (external table) обозначает расположение и формат данных, которые Doris может прочитать или загрузить в собственную аналитическую модель.
Ключевые понятия
- HDFS: распределённая файловая система Hadoop. Часто используется как источник больших наборов данных в формате Parquet, ORC, CSV и т. п. В Doris подключение к HDFS реализуется через BROKER типа HDFS.
- S3 и S3-совместимые хранилища: объектное хранилище, обеспечивающее хранение больших объёмов данных. Doris поддерживает доступ через BROKER типа S3; практические примеры чаще используют AWS S3 или локальные аналоги с поддержкой S3-совместимого API (например, Яндекс.Облако Объектное хранилище, Tencent Cloud COS, MinIO и т. п.).
- Kafka: потоковый источник данных. Через интеграцию Kafka Doris может «потреблять» или «подписываться» на события и загружать их в таблицы в режиме near real time.
- JDBC-источники: реляционные базы данных и иные СУБД, подключаемые через драйвер JDBC. В рамках Doris интеграция JDBC чаще реализуется через ETL-процессы (Sqoop, Apache NiFi, Spark) или через прямую загрузку через REST/Loader-потоки после извлечения данных в промежуточное хранилище.
Где это применяется
- Интеграция HDFS и S3 нужна для построения единых аналитических пайплайнов, где данные лежат в разных слоях: «сырые данные» в файловых системах, агрегированные данные в Doris.
- Kafka обеспечивает потоковую загрузку для оперативной аналитики и ближнего к реальному времени BI-предикций.
- JDBC-источники позволяют интегрировать устоявшиеся реляционные базы данных в аналитическую модель Doris, не прерывая существующие бизнес-процессы.
Технические принципы работы
- Стратегия вытягивания данных: Doris поддерживает чтение данных из внешних источников через BROKER и внешнюю таблицу, после чего данные могут перебираться в локальные таблицы Doris при помощи операций INSERT INTO SELECT или через регулярную загрузку.
- Форматы данных: Parquet, ORC, JSON, CSV — наиболее распространённые форматы. Parquet и ORC предпочтительны для больших объёмов данных благодаря эффективной колоночной упаковке и схеме.
- Задание схемы: внешняя таблица по сути описывает схему данных во внешнем источнике. Вариативность форматов и совместимость типов требует внимания к соответствию между внешними данными и целевой схемой Doris.
- Безопасность: для доступа к HDFS/S3/Kafka и другим источникам часто требуются учётные данные (ключи доступа, пароли, IAM-роли). В продакшн-окружении важно держать секреты в безопасном хранилище и использовать ограниченные по времени креденшалы, шифрование в покое и в передаче, а также сетевые политики.
Практические примеры
Ниже приведены практические кейсы с типовыми конфигурациями. В примерах использованы общие синтаксические конструкции. Ваша версия Doris может отличаться от приведённых примеров по синтаксису и поддерживаемым опциям: обязательно сверяйтесь с документацией для конкретной версии и окружения.
1) Интеграция HDFS в Doris
Цель: читать данные, хранящиеся в Parquet, из HDFS и загрузить их в Doris в виде обычной таблицы.
Шаги:
- Определение BROKER для доступа к HDFS.
- Определение внешней таблицы, указывающей путь к данным и формат.
- Загрузка данных в целевую таблицу Doris.
Команды (пример):
CREATE BROKER hdfs_broker TYPE hdfs WITH ("fs.defaultFS" = "hdfs://namenode:9000", "hadoop.username" = "hadoop");
CREATE EXTERNAL TABLE ext_sales (
  sale_id INT,
  product_id INT,
  amount DECIMAL(10,2),
  sale_time DATETIME
) ENGINE=OLAP
PROPERTIES ("broker" = "hdfs_broker", "path" = "/data/sales/parquet/", "format" = "parquet");
INSERT INTO dw.sales
SELECT * FROM ext_sales;
Пояснения:
- fs.defaultFS указывает корневую файловую систему HDFS.
- path задаёт директорию или конкретный файл в HDFS, который Doris будет читать.
- Формат parquet выбирается потому, что это эффективный колоночный формат с хорошей компрессией и схемой.
2) Интеграция S3/Яндекс.Облако Объектное хранилище (S3-совместимое)
Цель: использовать S3-совместимое хранилище как источник данных для внешних таблиц и загрузить данные в Doris.
Шаги:
- Определение BROKER для S3-совместимого хранилища.
- Определение внешней таблицы с указанием пути и формата.
Команды (пример для Яндекс.Облако Объектного хранилища, S3-совместимый API):
CREATE BROKER s3_broker TYPE s3 WITH (
  "endpoint" = "https://storage.yandexcloud.net",
  "access_key" = "YOUR_ACCESS_KEY",
  "secret_key" = "YOUR_SECRET_KEY",
  "region" = "ru-central1",
  "path" = "/dorissource"
);
CREATE EXTERNAL TABLE s3_ext_sales (
  sale_id INT,
  item_id INT,
  amount DECIMAL(10,2),
  sale_ts TIMESTAMP
) ENGINE=OLAP
PROPERTIES ("broker" = "s3_broker", "path" = "bucket/doris/sales/", "format" = "parquet");
INSERT INTO dw.sales
SELECT * FROM s3_ext_sales;
Пояснения:
- endpoint и region настраиваются под конкретное облако и регион.
- Правильное управление ключами доступа требует использования безопасного хранилища секретов.
- Формат parquet — рекомендуется для больших наборов данных.
3) Интеграция Kafka для потоковой загрузки
Цель: приводить данные из Kafka в Doris для анализа в реальном времени или ближнем к нему.
Шаги:
- Настройка BROKER для Kafka.
- Определение внешней таблицы с указанием формата (часто JSON или AVRO).
- Обеспечение корректной обработки сериализации и сдвигов времени.
Команды (пример, концептуальные):
CREATE BROKER kafka_broker TYPE kafka WITH (
  "bootstrap_servers" = "kafka1:9092,kafka2:9092",
  "topic" = "sales_events",
  "group.id" = "doris_ingest",
  "format" = "json"
);
CREATE EXTERNAL TABLE kafka_sales_events (
  event_id BIGINT,
  user_id BIGINT,
  amount DECIMAL(10,2),
  event_time DATETIME
) ENGINE=OLAP
PROPERTIES ("broker" = "kafka_broker", "format" = "json");
--Ингestion в реальную таблицу
INSERT INTO dw.sales_stream
SELECT * FROM kafka_sales_events;
Пояснения:
- Kafka-брокер обеспечивает подключение к топику и потребление сообщений.
- Формат JSON подходит для гибкой схемы событий; можно использовать AVRO или protobuf, если требуется более жёсткая схема.
- В реальной эксплуатации рекомендуется обрабатывать смещения, дублирование сообщений и схему сообщений (schema registry может помочь).
4) JDBC-источники: подход через ETL и промежуточное хранение
Цель: перенос данных из реляционных СУБД в Doris без прямого драйвера JDBC внутри Doris (часто требуется через ETL-продукты).
Типовая архитектура:
- Источник JDBC (например, MySQL, PostgreSQL) → ETL-инструмент (Sqoop, Apache NiFi, Spark) → промежуточное хранилище (HDFS, S3) → Doris через BROKER.
Пример с использованием Sqoop и HDFS как промежуточного слоя:
- Sqoop импортирует таблицу customers из MySQL в HDFS в формате Parquet:
sqoop import \
  --connect jdbc:mysql://dbhost:3306/salesdb \
  --table customers \
  --as-parquetfile \
  --target-dir /data/mysql/customers_parquet \
  --username user --password pass
Затем создаётся HDFS-брокер и внешняя таблица:
CREATE BROKER hdfs_broker TYPE hdfs WITH ("fs.defaultFS" = "hdfs://namenode:9000", "hadoop.username" = "hadoop");
CREATE EXTERNAL TABLE customers_ext (
  id INT,
  name STRING,
  email STRING,
  created_at DATETIME
) ENGINE=OLAP
PROPERTIES ("broker" = "hdfs_broker", "path" = "/data/mysql/customers_parquet", "format" = "parquet");
INSERT INTO dw.customers
SELECT * FROM customers_ext;
Альтернативные пути:
- Apache NiFi может напрямую извлекать данные через JDBC и писать в Parquet/ORC в HDFS или S3, откуда Doris может сделать загрузку через BROKER.
- Spark-вариант: Spark Structured Streaming может выводить данные в Parquet/S3, затем Doris считывает их как внешнюю таблицу или через пакетную загрузку.
Технические детали
Настройки безопасности и эксплуатационные аспекты
- Безопасность доступа к HDFS: использовать Kerberos или безопасные механизмы аутентификации, обеспечить ограничение прав доступа к путям данных.
- Безопасность доступа к S3-совместимым хранилищам: применяйте IAM-ролии, временные креденшелы, роль-источник для сервисов Doris, используйте политики минимальных прав.
- Шифрование: шифрование данных в покое и в транзите. TLS для доступа к S3-совместимым API и между компонентами Doris.
- Управление секретами: не держите креденшелы в явном виде в конфигурациях; используйте Vault, AWS Secrets Manager, Яндекс.Секреты и аналогичные решения.
Производительность и формат данных
- Выбор форматов: Parquet/ORC для больших наборов данных; CSV/JSON — для промежуточной загрузки или частичных задач.
- Схема и эволюция: внешняя таблица двигается к существующей схеме Doris. При изменении форматов или полей умеют потребовать миграцию и повторную работу.
- Параллелизм и разделение данных: при работе с HDFS/S3 желательно держать данные в разделах (partitions) и использовать параллельную загрузку.
Стратегии консистентности и повторного воспроизведения
- Поддержка идемпотентной загрузки: использовать уникальные ключи и детерминированные операции вставки, чтобы повторные загрузки не приводили к дублированию.
- Репликация и отказоустойчивость источников: HDFS и S3 обычно обеспечивают высокий уровень доступности, но сервисы Kafka требуют конфигурации реплик и сохранения смещений для предотвращения потери данных.
- Мониторинг: настройте алертинг по задержкам при чтении из внешних источников, состоянию брокеров и задержкам загрузки.
Риски и ограничения
- Совместимость форматов и типов: различия между формами Parquet, ORC и CSV могут привести к несовпадению типов в внешних таблицах и целевых таблицах Doris; корректируйте типы и значения, особенно для временных меток и числовых типов.
- Задержки и DATETIME: работа с временными данными в разных системах требует согласования часовых поясов и форматов.
- Эволюция схем внешних источников: если внешняя схема меняется часто, требуется регулярная поддержка миграций внешних таблиц и загрузок.
- Производительность чтения: доступ к внешним источникам может стать узким местом; оптимизируйте 파аркетизацию, разделение данных и настройки сети.
- Безопасность: хранение ключей доступа в незасекреченных источниках чревато утечками; используйте ограниченные ресурсы и периодическую ротацию ключей.
- Совместимость и версии: функциональные возможности по работе с брокером и внешними таблицами могут различаться между версиями Doris; обязательно тестируйте на стенде перед продакшн-внедрением.
Интеграция источников — важная часть экосистемы Doris. Правильная настройка HDFS, S3, Kafka и JDBC-источников позволяет строить мощные аналитические пайплайны: от пакетной загрузки больших наборов данных до стриминг-аналитики в реальном времени. Основные принципы — использование BROKER как абстракции доступа к внешним данным, грамотное проектирование схем внешних таблиц под форматы данных и обеспечение безопасности, мониторинга и устойчивости. В рамках практики важно экспериментировать с различными форматами данных, тестировать производительность загрузок, а также внимательно планировать миграции схем и обновления источников.
Сложности внедрения следует рассматривать как управляемые риски: заранее оценить latency и throughput, определить стратегии повторной загрузки и идемпотентности, выбрать подходящие инструменты ETL для JDBC-источников и продумать архитектуру вокруг S3-совместимых хранилищ (включая региональные особенности, требования к разрешениям и сетевые настройки).
FAQ — Вопрос–Ответ
1) Что такое BROKER в Doris и зачем он нужен для интеграции внешних источников?
BROKER в Doris — компонент, который обеспечивает доступ к данным во внешних хранилищах (HDFS, S3, Kafka и др.) без необходимости копирования данных в internos Doris. Внешняя таблица с ссылкой на BROKER описывает схему данных и путь к ним, после чего Doris может читать или загружать эти данные в свои таблицы. Это позволяет централизованно управлять источниками и сокращает дублирование данных.
2) Какие форматы данных чаще всего используются при работе с внешними источниками и почему?
Наиболее распространены Parquet, ORC, CSV и JSON. Parquet и ORC — колоночные форматы, обеспечивающие эффективную компрессию и быстрый сканинг. CSV и JSON удобны для промежуточной загрузки и гибкости форматов, но занимают больше место и требуют более тщательной обработки типов. Выбор формата зависит от объёма данных, требований к производительности запросов и удобства ETL-процессов.
3) Какую роль играет безопасность при подключении к HDFS и S3?
Безопасность критически важна. Для HDFS часто применяют Kerberos и аутентификацию по ключам. Для S3-совместимых хранилищ — IAM-роли, временные креденшелы и политики минимальных прав. В обоих случаях стоит шифровать данные в покое и в транзите, использовать TLS и управлять секретами через надёжные хранилища секретов. Регулярно обновляйте ключи доступа и ограничивайте доступ по принципу наименьших привилегий.
4) Какие риски связаны с потоковой загрузкой данных из Kafka в Doris?
Ключевые риски — потеря данных из-за неподхвата смещений, дублирование сообщений при повторной обработке и задержки в обработке. Необходимо настроить корректное управление смещениями, обработку дубликатов, мониторинг задержек и устойчивую схему сериализации (например, AVRO или JSON с явной схемой). Рекомендуется тестировать сценарии перезапуска и восстановления после сбоев.
5) Как можно реализовать интеграцию JDBC-источников в Doris без прямого JDBC-драйвера внутри Doris?
Чаще всего через ETL-инструменты: Sqoop, Apache NiFi, Apache Spark. Эти инструменты извлекают данные из JDBC-бази и записывают их в промежуточное хранилище (HDFS/S3) в формате Parquet/ORC, после чего Doris читает данные через BROKER. Это обеспечивает гибкость и устойчивость к изменениям источников и упрощает управление загрузками.
6) Какие практические рекомендации по конфигурации для работы с Яндекс.Облако Объектное хранилище (S3-совместимое) в Doris?
Используйте эндпойнт и регион соответствующего региона (ru-central1). Храните ключи доступа безопасно, применяйте минимальные права, используйте временные креденшелы и мониторинг доступа. Учитывайте задержки сети и финансовые аспекты (стоимость операций на чтение/запись). При необходимости используйте региональные политики и временные ключи для снижения риска утечки.
7) Какие ограничения существуют при работе с внешними источниками в Doris?
- Ограничения совместимости форматов и типов: внешняя таблица должна соответствовать формату и типам данных, сюрфейсинг может потребовать приведения типов.
- Задержки: чтение данных из внешних источников может быть медленнее локальных таблиц Doris, что влияет на задержку обновления результатов.
- Эволюция схем: изменение структуры внешних данных требует обновления внешних таблиц и возможно повторной миграции данных.
- Безопасность и управление доступом: хранение секретов и ключей требует надёжного управления и аудита.
- Совместимость между версиями: конкретные возможности и конфигурации могут различаться в разных версиях Doris; тестируйте обновления в стенде.
8) Что рекомендуется для минимизации рисков при внедрении интеграции источников?
- Прогнать полный цикл тестирования на стенде: загрузка, обновления схем, сценарии сбоев и повторной загрузки.
- Использовать идемпотентные механизмы и уникальные ключи для предотвращения дублирования.
- Организовать мониторинг и алертинг по времени чтения, задержкам, статусам брокеров и объёмам данных.
- Разделить обязанности между командами: DevOps отвечает за инфраструктуру брокеров/хранилищ, дата-инженеры — за схемы, загрузку и качество данных, аналитики — за корректность и использование данных.
9) Какие практические источники и инструменты можно использовать в связке с Doris для JDBC-источников?
- Sqoop: простая утилита для переноса данных из реляционных БД в Hadoop-окружение и обратно.
- Apache NiFi: графическое управление потоками данных, удобен для интеграции JDBC и передачи данных в HDFS/S3.
- Apache Spark: гибкая платформа для ETL и потоковой обработки; можно реализовать конвейеры, которые выгружают данные в Parquet, затем загружают в Doris через BROKER.
- В некоторых случаях можно писать собственные коннекторы или использовать REST-интерфейсы Doris для инкрементной загрузки.
10) Что ожидать от будущих обновлений Doris в части интеграции внешних источников?
Вероятно усиление поддержки форматов и форматов потоковых данных, улучшение стабильности и масштабируемости брокеров, более гибкие механизмы безопасного управления секретами, а также расширение возможностей по автоматизации миграций схем и более удобные инструменты для работы с JDBC-источниками через готовые коннекторы и ETL-решения.
Эта глава охватывает теорию и практику интеграции источников данных в Doris: HDFS, S3, Kafka и JDBC-источники. Мы рассмотрели общую архитектуру, шаги по настройке и примеры практических конфигураций, обсудили требования к безопасности и риски, с которыми сталкиваются команды на этапе внедрения. В реальных проектах успешное внедрение зависит от продуманной архитектуры пайплайнов, тестирования на стенде и постоянного мониторинга. Помните: внешние источники — это источник огромных возможностей для аналитики, но они требуют дисциплины в управлении данными, версиями схем и безопасностью.


