

Представляем Lakehouse 2.0: Что изменится?
Первое поколение компьютеров, в состав которых входили устройства размером с комнату, работающие на вакуумных лампах, было революционным. Впервые люди смогли автоматизировать сложные вычисления, моделировать баллистические траектории и погодные условия.
Но за это пришлось заплатить: они были массивными, хрупкими, дорогими и сложными в обслуживании. И все же институты цеплялись за них. Почему? Потому что они инвестировали в инструменты, обучали людей предохранять вакуумные трубки от перегрева и строили рабочие процессы с учетом своих ограничений. Мир был построен с учетом этого. Правительства потратили миллионы. Университеты обучили целые отделы поддерживать их в рабочем состоянии. Техническое обслуживание было работой, а не сноской. Перфокарты были обычным делом. Люди знали, как обращаться с машиной.
Затем появилось второе поколение. Машины на транзисторах. Они были меньше, быстрее, дешевле и значительно надежнее. Технологический скачок, который буквально за одну ночь заставил старый способ казаться примитивным. И все же сопротивление было реальным. Организации не хотели отказываться от своих инвестиций. Инженеры, специализирующиеся на обслуживании вакуумных ламп, почувствовали, что их накопленный с таким трудом опыт устарел. Руководители компаний опасались риска внедрения технологии, которая, хотя и была многообещающей, все же оставалась "новой".
В то же время волна поддержки возросла. Правительственным учреждениям, вынужденным из-за обострения экономической ситуации, вызванной войной, требовались более быстрые и надежные машины. Университеты воспользовались возможностью для развития вычислительной техники. Предприятия, увидев экономию средств и повышение производительности, быстро последовали этому примеру.
Экономика изменилась. К началу 1960-х годов вакуумные лампы были практически устаревшими. Победило не только техническое превосходство. Именно сочетание улучшенной экономической ситуации, более широкой поддержки и насущной необходимости привело к более быстрому переходу, чем кто-либо ожидал.
Переход ко второму поколению архитектуры Lakehouse
Первая версия the Lakehouse обещала единую платформу для всех видов обработки данных: аналитики, искусственного интеллекта и в режиме реального времени. Но в ранних версиях были свои собственные "ограничения вакуумной трубки": централизованные каталоги, собственные вычислительные механизмы, привязка к поставщикам, хрупкая интеграция. Команды научились обходить их. Они создали конвейеры, обучили специалистов, вложили значительные средства. Мир был построен с учетом этих ограничений.
Но теперь кое-что изменилось.
Форматы открытых таблиц, такие как Apache Iceberg, Delta (open spec) и Hudi, переосмысливают основы. Хранилища и вычислительные ресурсы отделены друг от друга. Управление и метаданные переходят к открытым унифицированным стандартам. Модели искусственного интеллекта, приложения реального времени и бизнес-аналитика теперь могут использовать одну и ту же архитектуру, не привязываясь к стеку одного поставщика.
Актуальность изменилась, но не менее реальна. На этот раз за ускорение борется искусственный интеллект. Каждая компания нуждается (больше, чем “хочет”) в более быстром получении аналитических данных, более интеллектуальных приложениях и аналитической информации в режиме реального времени. А старые ограничения слишком велики, чтобы их можно было переносить в будущем.
Lakehouse 2.0 - это не повторение, а реализация первоначального замысла. Вторая попытка воплотить концепцию Lakehouse, на этот раз с правильными примитивами: форматы открытых таблиц, движки с возможностью замены, независимое управление и подлинное владение данными.
Архитектура Lakehouse 2.0: Компонуемая по дизайну
Итак, как на самом деле выглядит эта новая архитектура? Помимо технического обновления, это изменение структуры, методов работы и мышления. Lakehouse 2.0, основанный на открытости, модульности и функциональной совместимости в режиме реального времени, избавляется от вертикальных блоков прошлого и использует компонуемый дизайн.
Архитектору данных поручено спроектировать невидимый каркас, на котором данные передаются, преобразуются и, в конечном счете, создают ценность. Речь идет не только о системном проектировании, но и о приведении структуры данных в соответствие с тем, как организация мыслит, действует и развивается.
Это означает, что семантические модели, онтологии и графы знаний должны быть встроены в архитектуру не как второстепенные, а как основополагающие элементы. Эти компоненты придают форму необработанным данным, помогая им сохранять смысл, контекст и структуру при перемещении по системам. Архитектор данных гарантирует, что данные не просто существуют — они поддаются интерпретации, управлению и согласованию с ментальными моделями бизнеса.
Давайте разберем это.
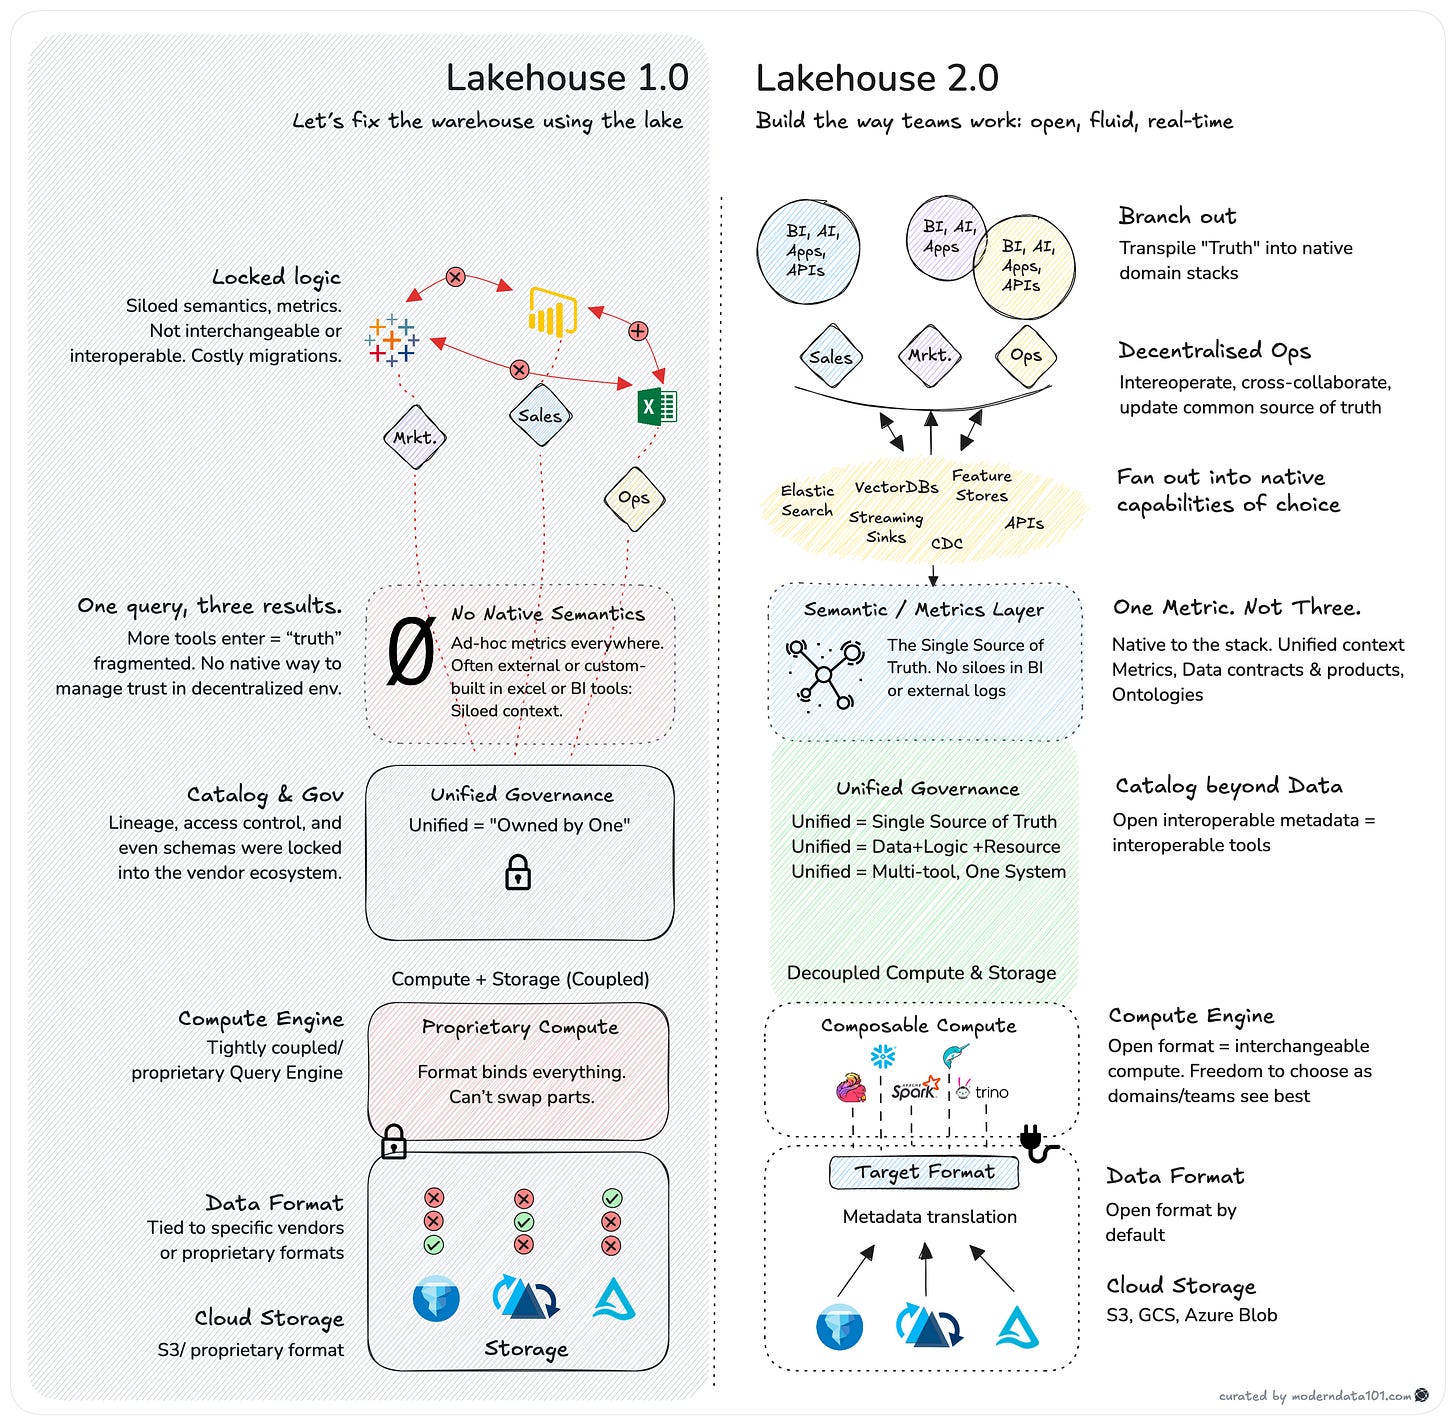
Наглядный пример сравнения архитектур Lakehouse 1.0 и Lakehouse 2.0\
Уровень потребления
На самом верхнем уровне данные становятся реальными и отображаются в информационных панелях BI, моделях искусственного интеллекта, внутренних API и пользовательских приложениях. Этот уровень больше не ограничивается пассивной аналитикой.
Вам больше не нужно вручную воссоздавать одну и ту же логику в пяти разных инструментах BI.
Допустим, ваши команды используют как Power BI, так и Tableau, и в каждом из них разные команды анализируют пять таблиц. Сегодня все они моделируют одно и то же по отдельности в каждом инструменте. Они определяют взаимосвязи, метрики и измерения внутри этих инструментов, которые не являются совместимыми, версионными или доступными для специалистов по обработке данных или других систем.
Это не работает.
Вместо этого в новой архитектуре семантическая модель определяется один раз, декларативно, как часть продукта обработки данных. А затем мы переносим это определение в собственные модели для Power BI, Tableau, Superset или даже Jupyter Notebook.
Представьте, что вы пишете на Java. Вы не пишете для каждой операционной системы: вы пишете один раз, компилируете в байт-код, а JVM обрабатывает все остальное. Если вы относитесь к Power BI, Tableau и т.д. как к различным JVM, вы пишете один раз, генерируете байт-код, и работа становится привычной везде.
Семантический уровень / уровень метрик
Важное новое дополнение. Семантика ваших данных (метрики, определения, правила) теперь является частью архитектуры. Это уровень, который обеспечивает доверие и ясность. Этот уровень стандартизирует значения для разных команд и инструментов. Именно здесь начинают формироваться контракты данных: они реализуются не только с помощью кода, но и с помощью архитектуры.
В современной экосистеме фрагментированных данных у нас есть разные инструменты, такие как Power BI и Tableau, которые часто моделируют одни и те же базовые данные. Давайте рассмотрим розничный магазин, использующий обе платформы. В игре пять таблиц, каждая из которых моделируется отдельно в Tableau и Power BI, при этом разные команды работают в разных средах.
Хотя оба инструмента определяют взаимосвязи, формулы для показателей и измерений, они делают это изолированно. Это проблематично, поскольку конечные пользователи, такие как аналитики и специалисты по обработке данных, исключены из этого процесса. Они не могут напрямую получить доступ к логике этих инструментов или модифицировать ее.
Именно здесь в игру вступает сила унифицированной семантики. Вместо того чтобы использовать отдельные определения для каждого инструмента, вы можете декларативно определить семантическую модель как часть продукта обработки данных. Затем автоматически преобразовать эту модель в форматы, которые могут использоваться Tableau, Power BI, Superset и даже Jupyter Notebooks.
Централизуя логику, вы обеспечиваете подлинную децентрализацию операций в предметной области. Мы устраняем сложность и гарантируем, что потребление данных не зависит от того, как применяется логика. Модель становится ядром продукта, что делает логику легко доступной и контролируемой версиями.
Например, сегодня вы можете подключить Power BI к реплике для чтения вашей операционной базы данных, будь то PostgreSQL, DB2 или MySQL, но этого недостаточно. Остается важный вопрос: где бизнес-логика? Где формулы для показателей? Где же сама семантическая модель?
Сегодня эти элементы находятся в двух разных местах. Одно из них - в инструментах обработки данных, а другое - в операционной базе данных. И управление ими и управление версиями становится сложной задачей. Но благодаря унифицированной семантике вы не только обеспечиваете бесперебойную работу инструментов, но и создаете единый, проверяемый и согласованный источник достоверности для всей вашей экосистемы данных. В этом суть настоящего продукта для обработки данных: разумно спроектированный, легко управляемый и невероятно мощный в своей простоте.
Вычислительные и поисковые системы (с возможностью компоновки)
Больше не нужно использовать один движок, чтобы управлять ими всеми. Snowflake, Trino, Flink, Duckdb, Spark — выбирайте сами. Lakehouse 2.0 создан для поддержки нескольких движков, а не для того, чтобы каким-то образом их допускать. Вычисления становятся компонуемыми. С возможностью замены. Даже необязательными. Вы добавляете движок, и архитектура адаптируется.
Идея заключается в том, чтобы сделать данные доступными для запросов правильным образом, для правильного варианта использования, с правильным соотношением затрат и производительности.
Например, вы можете подключить BigQuery и настраивать модули для каждого запроса за сеанс пользователя. Это здорово, когда вы хотите гибко масштабировать, но не возражаете против снижения производительности или задержек и оптимизируете затраты. Или, скажем, вы решаете очень специфическую бизнес-задачу, например, подключаете информационные панели с помощью Power BI. Вы можете назначить выделенный кластер Trino именно для этого. Он создан специально для этой цели, быстр и имеет широкий охват.
Если ваш набор данных невелик, вам вообще не нужно использовать такой мощный движок, как BigQuery. Вы можете запустить легкий сервис, который потребляет мало памяти и предоставляет интерфейс Postgres. Он будет работать молниеносно и будет адаптирован для сценариев использования, управляемых API.
Основная идея заключается в том, что мы рассматриваем вычислительные механизмы, интерфейсы и уровни запросов как строительные блоки и составляем их в зависимости от назначения продукта обработки данных. Система адаптируется к потребностям, а не наоборот.
Управление (унифицированные API) + Метаданные + Формат открытой таблицы
Это новое стратегическое поле битвы. Благодаря открытым табличным форматам, разделяющим хранилища, сеть метаданных становится мозгом. Именно здесь находятся доступ, происхождение, роли и политики.
В этом суть изменений. Apache Iceberg, Apache Hudi и Delta Lake (открытая спецификация) больше не являются дополнениями, а являются базовой версией. Метаданные больше не являются скрытыми или индивидуальными. Они структурированы, доступны для обнаружения и взаимодействия. Это то, что обеспечивает многопользовательский доступ, путешествия во времени и эволюцию схем. Это соединительная ткань современного lakehouse.
Облачное хранилище (открытое, децентрализованное)
В основе - ничего запатентованного. Простое объектное хранилище (S3, GCS, ADLS), поддерживаемое открытыми форматами. Вы являетесь владельцем своих данных. Вы контролируете свой доступ. The lakehouse - это уже не просто дешевое хранилище, а основа программируемой децентрализованной экосистемы данных.
Больше возможностей, связанных с архитектурой
Встроенные возможности Plug-and-play. Гибкая архитектура позволяет создавать специальные архитектурные решения, соответствующие специфике бизнеса.
- Elasticsearch / OpenSearch: прямое расширение для индексации поиска в режиме реального времени
- Векторные базы данных: Для поиска по встраиваемым файлам на основе RAG / LLM
- Хранилища функций: Потоковые и пакетные функции для ML-систем
- Сбор данных об изменениях (CDC): Распространение изменений по доменам или системам
- Приемники потоковой передачи: Встроенная поддержка Kafka, Pulsar, EventBridge и т.д.
- Графические движки: Оверлейные топологии или модели взаимосвязей
- Контракты с данными: проверка и публикация схем в восходящем и нисходящем потоках
Второе поколение Lakehouse по своей сути поддерживает децентрализацию
Когда мы говорим об использовании Lakehouse в качестве центральной точки для управления данными, мы не выступаем за монолитную инфраструктуру. Что мы на самом деле предлагаем, так это централизацию методов работы и стратегический выбор технологий.
Допустим, один домен выбирает Databricks в качестве базовой технологии, а другой - Snowflake. Это вполне приемлемо. Обе технологии могут предоставлять API, и обе могут быть совместимы через эти интерфейсы.
Однако, когда работа, выполняемая одним доменом со своими данными, пересекается с работой, выполняемой другим доменом, мы сталкиваемся с проблемой несоответствия технологического импеданса.
Таким образом, речь не идет о стандартизации в рамках одного технологического стека. Вместо этого мы рекомендуем использовать целостную декларативную структуру для решения этих задач. Думайте об ИТ как об архитектуре, ориентированной в первую очередь на облако, где базовая инфраструктура (управляемая такими поставщиками, как Amazon) становится неактуальной. Виртуальные машины - это просто виртуальные машины; важно то, что они доступны через интерфейс Terraform, что обеспечивает гибкость в управлении ими согласованным образом. Вам не нужно заботиться о том, будет ли это GPU, центральный процессор или высокопроизводительный узел; главное - единообразие доступа и работы.
Новая архитектурная парадигма lakehouse не предполагает, что каждый домен должен совместно использовать один и тот же экземпляр lakehouse. Вместо этого каждый домен должен решать свои проблемы, используя конструкцию lakehouse или аналогичную структуру API.
Ключевая идея заключается в том, что, даже если у нас есть большой конвейер ETL, предоставляющий API, мы должны иметь возможность повторно использовать части этой работы в разных доменах. Организация в целом становится компактнее и эффективнее, поскольку базовая технология остается неизменной. У меня может быть свой собственный экземпляр lakehouse, у вас может быть свой. Наши системы предоставляют API-интерфейсы друг другу, и если требуется взаимная корреляция, мы можем это сделать, поскольку технологическая основа согласована.
Представьте, что вы создаете общее руководство для организации, похожее на руководство по стилю программирования. Каждый, кто пишет код в компании, придерживается ряда стандартов документации, соглашений об именовании и методов модульной разработки. В этом суть платформы разработчика данных (DDP), тесно связанной с концепцией Внутренней платформы разработчика (IDP). Точно так же, как крупные инженерные организации устанавливают стандарты в отношении выбора технологий, библиотек и стиля комментариев, сама новая архитектура обеспечивает такой же уровень согласованности и дисциплины в системах обработки данных.
В конечном счете, речь идет не о стандартизации конкретной технологии, а о стандартизации нашего мышления, подхода к решению задач и структуры нашей работы. Чтобы наше мышление и действия были такими же последовательными и эффективными, как и сама технология. И это, по сути, фундаментальный сдвиг.
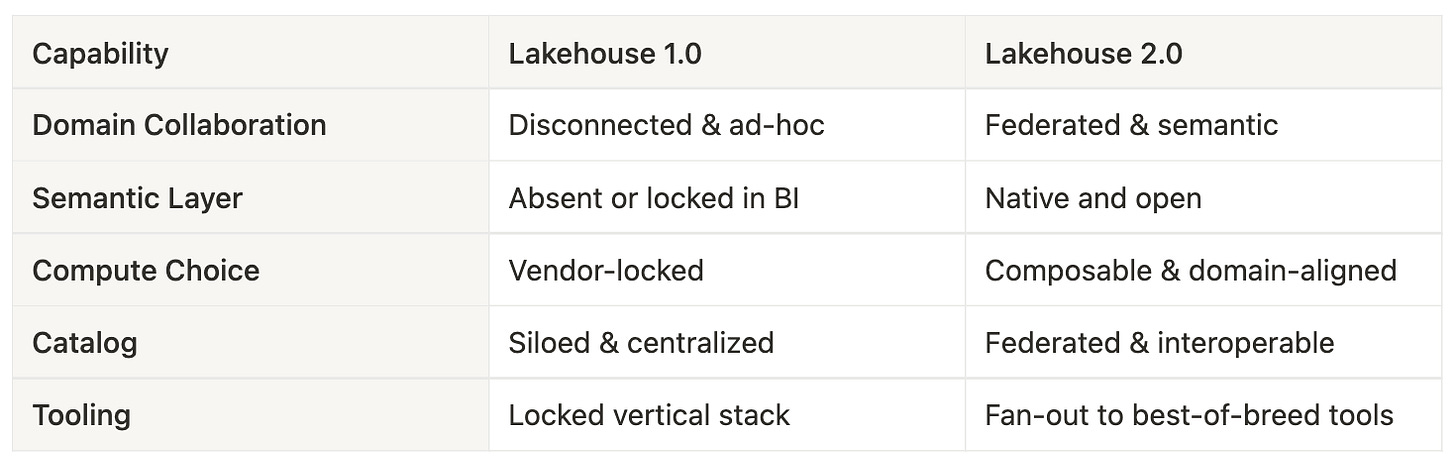
Децентрализованные операции и автономия домена
В Lakehouse 1.0 логика и семантика были изолированы в инструментах BI или электронных таблицах. Такие команды, как отдел продаж, маркетинга и оперативный отдел, работали в разрозненных “пузырях”, постоянно переиначивая понятие "истина".
Новая архитектура the Lakehouse обеспечивает децентрализованную работу, в которой области (продажи, маркетинг, операционный отдел) могут взаимодействовать, осуществлять перекрестную совместную работу и понимать общий контекст, то есть источник информации. Централизованные ИТ-службы не блокируют работу команд. Вместо этого они владеют локальными моделями и развивают их, внося свой вклад в глобальную достоверность.
Уровень семантики и метрик как единый источник достоверности
Семантический уровень является центральным элементом децентрализации. Он предоставляет общие определения для метрик, контрактов на данные и онтологий продуктов. В инструментах BI больше нет жестко заданных показателей; теперь есть единый управляемый уровень, к которому подключаются все домены. Этот уровень обеспечивает семантическую совместимость.
Компонуемые вычислительные системы и взаимозаменяемые движки
Вычислительная система больше не привязана к форматам хранения или таблиц. Домены могут подключать Spark, Trino, Dremio и т.д., все, что подходит лучше всего, для чтения/записи одних и тех же таблиц открытого формата. Это позволяет создавать архитектуры, ориентированные на предметную область, без привязки к платформе.
Расширяйте возможности по своему выбору
Поскольку вы продолжаете увеличивать и уменьшать рабочие нагрузки, вам в конечном итоге придется перейти к другим инструментам, таким как Elasticsearch, для работы с такими вещами, как возможности поиска. Но теперь вы сталкиваетесь с другой проблемой: система не может масштабироваться так эффективно, как это необходимо. По мере увеличения объема данных вы вынуждены сталкиваться с увеличивающимися задержками и затратами, особенно когда пытаетесь быстро проиндексировать данные в Elasticsearch.
На этом этапе решение становится более сложным. Вы добавляете уровни инфраструктуры только для управления рабочей нагрузкой: более крупные кластеры, отдельные индексаторы, выделенные процессы поиска — все это увеличивает операционную сложность и стоимость. И какова конечная цель? Предоставить продукт обработки данных где-то за пределами системы.
Именно здесь проявляется элегантность новой архитектуры lakehouse. Вместо того, чтобы втиснуть все в одну монолитную систему, lakehouse позволяет эффективно распределять рабочую нагрузку по встроенным возможностям, которые легко масштабируются.
Например, вы можете создать векторную базу данных или хранилище функций для машинного обучения. Эти возможности являются естественными для среды lakehouse и не требуют дополнительной настройки сложных, разрозненных систем, таких как Elasticsearch или кластеры обработки данных.
Прелесть этой архитектуры заключается в простоте и масштабируемости. Lakehouse служит единой основой, но с его помощью вы можете легко перейти к другим сервисам, используя весь спектр современных возможностей обработки данных. Вам не нужно беспокоиться об управлении разрозненными технологиями или об узких местах. Все это интегрировано, и принятие решений становится намного проще:
Используйте правильный инструмент для правильной работы, и все это в рамках единой экосистемы.
Последствия: Почему Lakehouse 2.0 так важен
Изменения в архитектуре - это изменения в том, как работают команды, компании и вся экосистема в целом. Для групп обработки данных компонуемость означает свободу. Свобода выбора подходящего инструмента для работы. Будь то DuckDB для локальной разработки, Trino для федеративных запросов или Flink для потоковой передачи. Больше не нужно быть привязанным к одному вычислительному механизму или платформе.
У вас есть свой стек, и это меняет способ построения.
Для бизнеса это означает контроль и эффективность. Lakehouse 2.0 устраняет зависимость от вертикально интегрированных поставщиков. Вы не платите за вычислительные ресурсы, которые вам не нужны, и не привязаны к базам данных и лимитам использования. Ваши затраты становятся предсказуемыми. Ваши рычаги влияния улучшаются. Вы ведете переговоры, опираясь на силу.
А для экосистемы в целом это ключ к успеху. Компонуемая архитектура обеспечивает реальную совместимость, что означает, что стартапы могут создавать более совершенные инструменты, а облака могут сосредоточиться на инфраструктуре, а не на управлении самолетами. Инновации расширяются, а не сокращаются. Может расцвести тысяча инструментов, и все они будут говорить на одном языке.


