

Агентский ИИ на ClickHouse: архитектура, конвейеры расширенной аналитики и управление данными в реальном времени
Введение: роль аналитики в реальном времени на ClickHouse с агентским ИИ
Современная корпоративная аналитика немыслима без способности обрабатывать данные в реальном времени и превращать их в целевые действия. В условиях быстроменяющихся бизнес-условий решения должны приниматься на основе актуальных данных, а не ретроспективных снимков. Агентский искусственный интеллект, базирующийся на крупных языковых моделях (LLM), выступает в роли автономного аналитического агента: он не просто отвечает на запросы пользователя, но и самостоятельно инициирует исследования, формирует гипотезы, ищет данные во внешних и внутренних источниках, оценивает их качество и обобщает результаты в понятные выводы. В этом контексте платформа ClickHouse выступает не только как хранилище больших объемов данных, но и как вычислительная база с высокой скоростью чтения и возможности параллельной обработки. OLAP-архитектура[col] существенно отличается от традиционных OLTP систем: она оптимизирована под анализ больших объектов данных, поддерживает агрегации по времени, многомерный анализ и эффективное хранение ML-фичей. Однако для агентских систем на основе LLM необходимы дополнительные конвейеры: управление контекстом, хранение и доступ к эмбеддингам, интеграцию с внешними источниками и корректное управление доступами и безопасностью. Введение такого подхода требует системного взгляда на архитектуру, конвейеры расширенной аналитики, а также на теоретические основы агентного ИИ и регуляторные принципы эксплуатации. Данная статья систематизирует путь от стратегических решений до практических реализаций, акцентируя внимание на синергии OLAP ClickHouse и агентского ИИ: какие архитектурные принципы лежат в основе, какие данные и процессы нужны, какие риски и как их снижать.
Важно подчеркнуть концептуальное ядро: агентский ИИ оперирует на основе данных в реальном времени, применяет Retrieval-Augmented Generation (RAG) для нахождения информации, использует кэширование и материализованные представления, а также учитывает требования к доступу, мониторингу и безопасности. Такой подход обеспечивает непрерывное обновление моделей, устойчивую производительность и управляемость в условиях многогранной архитектуры. В следующих разделах будет рассмотрено обоснование выбора ClickHouse как OLAP-хранилища, декомпозиция компонентов, теоретические основы агентного ИИ на базе LLM, а также практические конвейеры RAG, интеграцию внешних источников, методы оптимизации запросов и вопросы безопасности, масштабирования и управления жизненным циклом токенов. Стратегия выстраивания архитектуры опирается на принципы модульности, устойчивости к перегрузкам и прозрачности данных, чтобы аналитические агенты могли работать автономно, но при этом под контролем бизнес-целевых показателей.
Обоснование выбора ClickHouse: архитектура OLAP и требования к агентским системам на основе LLM
Выбор OLAP-архитектуры для агентского ИИ определяется двумя ключевыми фактами: требования к скорости анализа и потребность в масштабируемом хранении признаков моделей и эмбеддингов. ClickHouse, как колоночная аналитическая база данных, обеспечивает низкую латентность чтения, высокую пропускную способность и эффективную параллелизацию запросов, что критично для интерактивного диалога с пользователем и для многозадачных агентских сценариев. В отличие от OLTP-хранилищ, ориентированных на транзакционные операции и оперативную обработку отдельных записей, OLAP-базы оптимизированы под агрегации, скользящие окна, временные ряды и сложные аналитические вычисления. Эти возможности особенно важны для задач агента ИИ: обнаружение тенденций, выявление аномалий, прогнозирование и генерация результатов на основе больших объемов данных.
Одновременно с достоинствами OLAP-архитектуры возникает новая нагрузка: интеграция LLM и конвейеров расширенной аналитики требует хранения и быстрого доступа к данным для обучения и вывода моделей, к эмбеддингам и к ML-фичам. ClickHouse поддерживает хранение структурированных данных, полей сложной природы (массивы, структуры), а также встроенные или внешние индексы для ускорения поиска. В контексте агентского ИИ важна возможность:
- хранения ML-фичейв колоночной форме с эффективной компрессией и агрегацией;
- поддержки схем, где временные ряды и события сопоставляются с контекстом LLM;
- быстрого доступа к данным через адаптивное кеширование и материализованные представления;
- интеграции с внешними источниками и синергии внутренних и внешних данных.
Эти свойства позволяют агентскому ИИ работать автономно в реальном времени, формировать контекст, запрашивать дополнительные данные и кэшировать результаты для повторного использования. В то же время ARP (архитектура реального времени) требует продуманного управления ресурсами: квотирование, мониторинг, балансировку нагрузки и механизмов отказоустойчивости. ClickHouse предоставляет инструменты для масштабирования, такие как шардинг и репликацию на уровне нод, параллельные исполнители запросов и репликацию журналов изменений, что поддерживает устойчивость к перегрузкам и гибкость в отношении количества агентов.
Таким образом, выбор ClickHouse как основы для агентского ИИ с LLM строится на сочетании: (1) сильной OLAP-архитектуры, (2) эффективной поддержки больших объемов данных и ML-фич, (3) возможностей интеграции с конвейерами RAG и внешними источниками, (4) богатых возможностях по обеспечению безопасности, мониторинга и управляемости. В следующих разделах будет рассмотрена структура компонентов и их взаимодействие, чтобы обеспечить целостную и управляемую архитектуру агентского ИИ на ClickHouse.
Декомпозиция технических компонентов и их взаимодействие
Архитектура агентского ИИ на базе ClickHouse строится как сеть взаимосвязанных компонентов, где каждый элемент отвечает за узкую функциональность и допускает масштабирование независимо от соседних модулей. Основные строительные блоки можно условно разделить на четыре слоя: источник данных и инжекция; хранилище и обработка в ClickHouse; конвейеры расширенной аналитики (RAG, встраивания, поиск); и управляющий слой, обеспечивающий безопасность, оркестрацию и мониторинг. Рассмотрим взаимосвязи детально.
-
Источники данных и инжекция. Внутренние данные клиента формируются в ClickHouse в режиме потоковой или пакетной загрузки. Внешние источники включают открытые и коммерческие API, документы, PDF, изображения и другие мультимодальные источники. Интеграционные конвейеры должны поддерживать схему извлечения данных, нормализацию структур, ретрансляцию и управление качеством. В этом слое важно обеспечить низкую задержку между поступлением данных и их доступностью для агентов.
-
Хранилище и обработка. ClickHouse служит основной базой данных для аналитических запросов и хранения ML-фич. Стратегия хранения должна учитывать частоту обновления фичей, версионирование данных и управляемый TTL. Важны хранилища справочников (data catalog), схемы описания и единое место для описания бизнес-правил. Для ускорения анализа агентской логики применяются материализованные представления и кеши, которые ускоряют повторные запросы и повторные вычисления.
-
Конвейеры расширенной аналитики (RAG). В этой зоне размещаются модули извлечения информации (retrieval), генерации (generation) и агрегации (aggregation). Элементы включают:ély retriever, reader, memory компонент, встраивания эмбеддингов и индексы ближайших соседей. Взаимодействие ClickHouse с встраиваниями реализуется через внешние слои или через встроенные функции, поддерживающие векторные данные и поиск по ним. Важной задачей является устойчивость к задержкам и согласование контекстов между запросами к данным и генерацией ответов.
-
Управляющий слой. Этот слой выполняет оркестрацию агентов: создание и удаление агентов, планирование задач, контролируемый доступ к данным, управление токенами, мониторинг нагрузки, аудит и безопасность. Он обеспечивает правило «безопасной автономности» для агентов: какие источники они могут запрашивать, какие данные могут комбинировать, какие внешние ресурсы допускаются к использованию. В слое управления прописаны политики кэширования, ограничение скорости запросов и механизмы отклонения действий, если риск превышает пороги.
Коммуникации между слоями реализуются через семантику API, очереди и событий. Взаимодействие агентских модулей с ClickHouse должно происходить через промежуточный слой API, который валидирует токены, проверяет ролям и трансформирует сложные запросы LLM в безопасные SQL- или SQL-подобные операции. Такой подход обеспечивает контроль над ресурсами и предотвращает опасные паттерны поведения агентов, например попытки выполнить полное сканирование таблиц или утечку чувствительных данных.
Формирование контекста для LLM требует синхронной и асинхронной обработки: быстрые запросы к ClickHouse получают краткий контекст для оперативной генерации, а более длительные циклы исследования используют распараллеливание задач и кэширование результатов. В дальнейшем разделе рассмотрены теоретические принципы, на основe которых строится агентский ИИ, и обоснование выбора подходов к конвейерам и данным.
Теоретическая база и объяснение основ агентского ИИ на основе больших языковых моделей
Агентский ИИ - это не простой набор инструкций, а система, которая может автономно планировать, исследовать данные, выводить результаты и адаптироваться к изменяющимся условиям. В основе лежат идеи больших языковых моделей, которые обобщают знания из большого корпуса текстов и способны к контекстному выводу. Однако для реального применения в корпоративной аналитике требуется не только генерация ответов, но и планирование исследовательских действий, управление контекстом, соблюдение правил безопасности и этики, а также способность к онлайн-обучению и самообогащению данных.
-
Роль LLM и их ограничения. LLM предоставляют способность к гибкому формированию текста, объяснению процессов, синтезу знаний и генерации гипотез. Но кроме текста, агенту нужно не только «знать» данные, но и «уметь» их искать и комбинировать источники. Это достигается через архитектуру RAG и интеграцию с эмбеддингами. Важной особенностью является то, что LLM работают лучше, когда контекст ограничен и структурирован. Поэтому система должна преобразовывать данные ClickHouse и внешних источников в управляемый контекст, а затем калибровать формулировки, чтобы минимизировать риск ошибок и противоречий.
-
Retrieval-Augmented Generation (RAG). RAG объединяет два аспекта: retrieval (поиск) и generation (генерацию). В контексте ClickHouse это означает: (1) извлекать релевантные документы и данные (через поиск по эмбеддингам, текстовым полям, структурированным данным, файлам), (2) подбирать контекст и формулировать вывод с учётом найденной информации, (3) при необходимости обогащать данные новыми источниками. Эффективная реализация RAG требует стратегий кэширования, управления памятью и контроля качества источников. Важный элемент - хранение эмбеддингов и встраиваний непосредственно рядом с данными, чтобы минимизировать задержки между источником и агентом.
-
Самообучение и адаптация. В теории агентного ИИ существует подход к онлайн-исследованиям: агент ставит гипотезу, проверяет ее через запросы и обновляет свое знание. Реализация таких циклов требует механизмов безопасной адаптации и версииирования моделей, чтобы любые изменения не приводили к неконтролируемым последствиям. В ClickHouse это достигается через управление версиями фич, журнал изменений и аудит действий.
-
Управление контекстом и документация. Агентам необходима машиночитаемая документация о наборах данных, правилах, ограничениях и форматах. Это обеспечивает прозрачность, повторяемость и возможность аудита. Выделяются принципы: описания наборов данных (DESCRIBE, SHOW), стандартизированные формы документации и адаптация к формату, удобному для LLM.
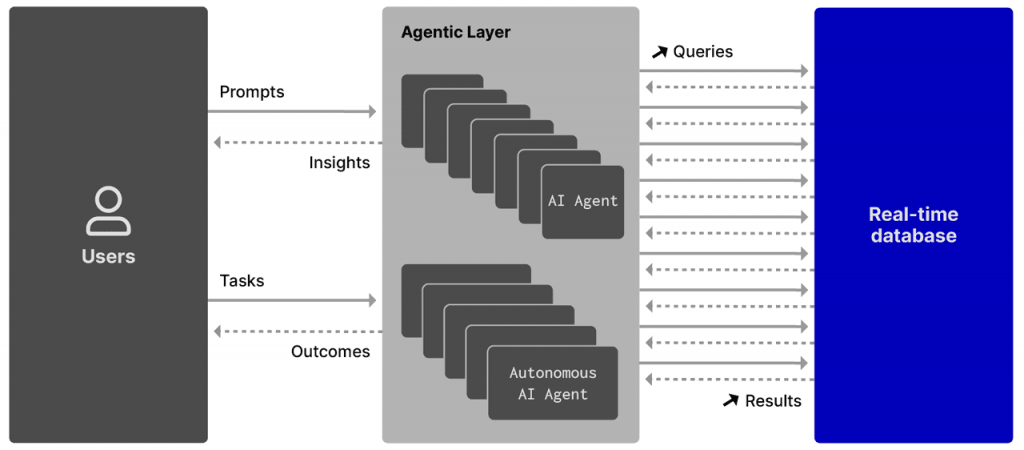
Теоретическая база подчеркивает ключевые принципы: (1) разделение функций и ответственность между слоями, (2) управление контекстом и качеством источников, (3) безопасная автономия через политики, (4) устойчивость к задержкам и нагрузке за счет кэширования и MV-решений, (5) машиночитаемость и прозрачность данных. В дальнейшем эти принципы переходят к практическим конвенциям, которые позволят агентам эффективно работать на платформе ClickHouse и взаимодействовать с RAG и внешними источниками.
Конвейеры расширенной аналитики и Retrieval-Augmented Generation (RAG)
Конвейеры расширенной аналитики представляют собой связку модулей, обеспечивающих непрерывную работу агентского ИИ: от извлечения данных до генерации финального вывода, обогащения контекста и контроля над качеством. RAG выступает как центральная концепция в таких конвейерах, позволяя агенту сочетать внутреннюю логику построения выводов с внешними источниками знаний.
-
Retriever. Этот компонент отвечает за поиск релевантных данных и документов. В ClickHouse Retriever может использовать встраивания (embeddings) текстовых и мультимодальных источников, чтобы быстро находить схожие фрагменты по семантике. Важна точность ранжирования источников и минимальная задержка. Эффективная реализация предполагает использование векторных индексов (например, HNSW) и гибкой политики кэширования результатов.
-
Reader/Generative модуль. Reader превращает найденную информацию в контекст для LLM, формулирует запросы к модели и получает ответы. В контексте RAG важно обеспечение корректности источников, предотвращение «hallucinations» и поддержание согласованности контекста между несколькими источниками. Генеративный модуль дополняет данные выводами, прогнозами и рекомендациями.
-
Memory и контекст. Контекстная память необходима для удержания релевантной информации между сессиями или повторными запросами. В ClickHouse память может реализовываться через временные таблицы, кэшированные результаты и обобщающие совокупности, которые агент может повторно использовать без повторного обращения к источникам.
-
Встраивания и поиск по ним. Хранение эмбеддингов для документов, таблиц и фичей обеспечивает семантический поиск и сопоставление между запросами агента и данными в ClickHouse. Это критично для скорости и качества ответа, позволяя агенту быстро находить контекст даже во многом мультимодальных наборах.
-
Управление качеством и безопасности конвейера. Важна система правил, ограничений и аудита: какие источники допустимо использовать, какие признаки данных можно включать в ответы, какие данные запрещено выводить. Реализация таких ограничений ведет к более надежной эксплуатации в корпоративной среде.
Практическая реализация конвейера требует тесной интеграции между ClickHouse и внешними сервисами. Внутренние данные индексируются и обновляются в ClickHouse, эмбеддинги индексируются в векторном хранилище, а результаты кэшируются в слое управления. Взаимодействие между Retriever и Reader обеспечивает обновление контекста и минимизацию задержек. Роль аналитической архитектуры в этом процессе - обеспечить непрерывность и управляемость, чтобы агенты могли работать автономно, но под контролем и с прозрачной аудиторией.
Архитектура и потоки данных агентского ИИ: обработка текстового, визуального и мультимодального контента
Эффективная архитектура агентского ИИ требует унифицированного подхода к обработке мультимодальных данных: текст, изображения, документы, PDF файлы и мультимодальные источники. В рамках ClickHouse и сопутствующих конвейеров это означает разделение потоков ввода и их конвертацию в единый формат, пригодный для анализа и генерации.
-
Текстовый контент. Основной поток связан с запросами к данным и документами, реорганизованными в таблицах и полях. Включаются тексты документов, комментарии, логи операций и сообщения в чатах. Эффективное хранение требует нормализации форматов, удаления шума и индексации по ключевым тематикам. Для ускорения поиска применяются эмбеддинги и индексные структуры, что позволяет агенту достаточно быстро находить релевантные фрагменты контекста.
-
Визуальный контент. Изображения и графика часто требуют предварительной обработки: OCR для текста на изображениях, распознавание объектов и контекстуальная аннотированная информация. Результаты обработки затем переводятся в табличные представления или эмбеддинги, которые могут связываться с текстовыми данными. В интеграции с ClickHouse задача состоит в хранении информации об изображениях, их метаданных и ссылках на обработанные признаки.
-
Мультимодальные источники (PDF, видео, документы). Обработка таких источников начинается с извлечения текста и структурирования контента. Встроенные функции и внешние сервисы конвертации данных в машинно читаемые формы поддерживают эффективную индексацию. Эмбеддинги для мультимодальных данных позволяют проводить семантический поиск и сопоставление с текстовым контекстом.
-
Потоки данных и синхронная обработка. В реальном времени агенты требуют минимальной задержки между поступлением данных и предоставлением контекста. Это достигается через пайплайны обработки, которые распадаются на этапы: извлечение, нормализация, индексация и кэширование. В ClickHouse поддерживаются параллельные загрузки и батчи, что позволяет синхронизировать работу различных потоков.
-
Управление качеством данных и линейность. В мультимодальных конвейерах важно обеспечить управление качеством: валидность источников, полноту контекста, согласованность между различными каналами данных. Эти принципы необходимы для корректной интерпретации контекста агентами и для уменьшения риска ошибок в выводах.
Архитектурно мультимодальность требует единых контрактов между данными и моделями: форматы, схемы, версии и правила доступа. Это гарантирует, что агентский ИИ может бесперебойно работать в условиях разнообразных входных данных и изменяющихся источников, сохраняя качество отклика и корректность выведений.
Реализация автономной ML-системы агентского ИИ: многозадачность, онлайн-исследования и самообогащение данных
Автономная ML-система агентского ИИ предполагает, что агент выполняет задачи без прямого человеческого вмешательства, обучается на онлайн-данных и оперативно обогащает свои знания новыми источниками. В этом разделе освещаются принципы реализации, безопасность и управляемость таких систем.
-
Многозадачность. Агенты должны уметь параллельно работать над несколькими целями: мониторинг, ответ на запросы, проведение онлайн-исследований, подготовка отчетов и обновление контекста. Эффективное управление задачами достигается через планировщик задач, очереди и асинхронное выполнение. Важно избегать конфликтов за ресурсы и обеспечивать приоритеты в рамках бизнес-целей.
-
Онлайн-исследования. Агент может формулировать гипотезы, запрашивать данные, проверять гипотезы и возвращать результаты. Этот процесс сопряжен с вопросами верификации данных и ограничениям на доступ к внешним источникам. Сильной стороной является способность агентной системы быстро адаптироваться к новым условиям и выводить новые гипотезы на основе сформированного контекста.
-
Самообогащение данных. Агент может дополнять свой контекст новыми источниками информации, например, путем краулинга внешних сайтов, загрузки документов и анализа новых эмбеддингов. Необходимо обеспечить надежность и безопасность таких действий: проверку источников, ограничение на числа запросов, сохранение версий данных и аудит действий.
-
Безопасность и ограничение риска. Автономность не должна означать отсутствие контроля. В основе должны лежать политики ограничений: какие шаги агент может предпринимать без вмешательства человека, какие источники допустимы, какие данные можно публиковать и какие данные запретны. Принципы «доверяй, но проверяй» применяются для каждого агентского цикла, включая онлайн-исследование и самообогащение.
-
Оценка качества и регуляторика. Необходимо включать механизмы для оценки точности и полноты выводов, журнал изменений, аудит и ретроспективу. Метрики эффективности включают время до ответа, точность, полноту и устойчивость к отказам. В интеграционной архитектуре ClickHouse это часто реализуется через версионирование фич, журнал операций и метрики обработки.
Реализация автономной ML-системы требует согласования между архитектурой и бизнес-целями. Важна управляемость в условиях многозадачности, возможность масштабирования числа агентов и четкого контроля над источниками и данными. Такой подход обеспечивает устойчивое развитие агентских систем, которые могут адаптироваться к изменяющимся бизнес-требованиям и обновляющимся источникам знаний.
Интеграция внешних источников и синергия внешних и внутренних данных в ClickHouse
Интеграция внешних источников и внутренних данных формирует единственный контекст для агентских ИИ, который способен давать точные и обоснованные выводы. В этом разделе рассмотрены принципы синергии, архитектурные решения и практические подходы к интеграции.
-
Внешние источники. Это могут быть открытые веб-источники, корпоративные API, открытые документы (PDF, HTML), базы знаний, новостные ленты и специализированные источники. В контексте RAG внешние источники становятся значительной частью контекстного пространства. Вопросы качества источников, авторизации, скорости доступа и сроков истечения данных особенно критичны.
-
Внутренние данные. Внутренние данные - это данные, которые уже находятся в ClickHouse: фактические данные, логи, метрики, фичи и предикторы. Взаимодействие внешних и внутренних источников должно быть регламентировано и при этом обеспечивать целостность данных. Важно хранение версии данных и возможность отката изменений.
-
Интеграционные архитектурные принципы. В архитектуре следует применять слоистую модель: слой интеграции (API и коннекторы), слой индексации и поиска, слой конвейеров RAG и слой агентов. Важно обеспечить согласованность контекста между источниками, чтобы агент мог корректно интегрировать данные.
-
Управление качеством и безопасностью. Внешние источники потребуют механизмов верификации, фильтрации, ограничения доступа и аудита. Все соединения с внешними источниками должны быть защищены, аудируемы и соответствовать политике безопасности.
-
Управление данными и линейность. В ClickHouse необходимо поддерживать линейность этаких данных и их взаимосвязь с внешними источниками. Это включает хранение метаданных источников, версии и ограничение доступа на уровне токенов.
Синергия внешних и внутренних данных усиливает контекст и повышает точность выводов агентского ИИ. Важно обеспечить безопасную и управляемую интеграцию, чтобы бизнес-решения, основанные на агентской аналитике, были надежными и прозрачными.
Эффективное использование RAG в ClickHouse: хранение ML-фичей и ускорение доступа к источникам
RAG-подход позволяет агентскому ИИ использовать внешние источники и внутренние данные, получая точные и обоснованные ответы. В ClickHouse эффективность RAG достигается через хранение ML-фичей, интеграцию эмбеддингов и оптимизацию доступа к данным.
-
Хранение ML-фичей. ML-фичи представляют собой предикторы или признаки, используемые в моделях и стратегиях анализа. Размещение фичей в ClickHouse с эффективной компрессией и версионированием позволяет быстро извлекать контекст для агентов. Важно располагать фичи удобно для кеширования и скорого доступа.
-
Встраивания и поиск по ним. Эмбеддинги представляют собой векторные представления данных, которые позволяют быстро находить семантически близкие элементы. ClickHouse поддерживает архитектуру векторных данных и индексов для ускорения поиска соседей. Интеграция эмбеддингов с RAG позволяет агенту находить релевантные контексты в мультимодальных данных.
-
Кэширование и материализованные представления. Частые запросы к данным для генерации контекста повторяются. Кэширование результатов и создание MV (материализованных представлений) снижают задержку и балансируют нагрузку. Это особенно полезно в сценариях, когда агент выполняет серию схожих запросов к данным за короткие промежутки времени.
-
Иерархия источников. В RAG важна возможность приоритизации источников: какие источники более достоверны, какие обеспечивают больше контекста и какие доступны оперативно. Это позволяет агенту строить комплексные ответы на основе сочетания источников с разной скоростью доступа и качеством.
-
Безопасность и контроль доступа. При работе с внешними источниками необходимо обеспечить соответствие политикам безопасности и соответствия. Это включает аутентификацию, ограничение доступа к источникам, аудит и мониторинг.
Эффективное использование RAG в ClickHouse требует продуманной архитектуры: хранение эмбеддингов, быстрый доступ к данным, механизм кэширования и модульный подход к интеграции внешних источников. Такой набор позволяет агентскому ИИ работать быстро и уверенно, формируя точные и обоснованные выводы на основе разумной смеси внутренних и внешних данных.
OLAP-вклад в анализ: преимущества для обнаружения тенденций, аномалий и генерации результатов
OLAP-архитектура приносит уникальные преимущества в задачах агента ИИ: комплексная аналитика больших данных, поддержка временных рядов, агрегаций, сложных вычислений и гибких планов запросов. В контексте агентского ИИ это обеспечивает:
-
Обнаружение тенденций. Возможность строить скользящие окна, анализировать сезонность и выявлять долгосрочные тренды. Это критично для раннего обнаружения изменений в бизнес-показателях и корректировки моделей.
-
Обнаружение аномалий. Специализированные методы анализа, включая контрольные пределы, статистические тесты и модели распределений, позволяют обнаруживать отклонения. В ClickHouse такие вычисления можно реализовать через оконные функции и агрегации, обеспечивая быстрый отклик.
-
Генерация результатов. OLAP-базы предоставляют обширный контекст для генерации выводов агентами: сочетание фактов и предиктивных признаков, что делает формулировки более обоснованными и полезными.
-
Поддержка интерактивности. Высокая производительность чтения и параллелизм позволяют агенту поддерживать диалог с пользователем в реальном времени, отвечать на вопросы и быстро переходить к новым запросам.
-
Управление версионированием и откати. Важно иметь возможность версионирования контекста, чтобы можно было повторно воспроизвести анализ и проверить выводы, особенно при онлайн-обследовании и самообогащении.
OLAP в ClickHouse действует как двигатель аналитических вычислений, который способен поддерживать сложные сценарии агентов: от базовых запросов до сложных контекстов, объединяющих данные, эмбеддинги и внешние источники. В сочетании с RAG конвейерами это обеспечивает мощное средство для автономной аналитики и постоянного улучшения контура знаний агентов.
Производительность и интерактивность: латентность, параллелизм и поддержание качества отклика
Производительность и интерактивность являются критическими требованиями для агентских систем: задержки должны быть минимальными, а качество отклика - стабильным даже под высоким уровнем параллелизма. В рамках ClickHouse это достигается через несколько взаимосвязанных факторов:
-
Латентность и пропускная способность. Ключевые параметры включают скорость ingest, скорость обновления индексов и кэширования. В контексте RAG и мультимодальных данных важно минимизировать задержку между поступлением данных и их доступностью для агентов.
-
Параллелизм. ClickHouse реализует параллельное выполнение запросов и распределенную обработку, что позволяет масштабировать обработку при росте числа агентов и объема данных. Важную роль играет балансировка нагрузки между нодами кластера.
-
Кэширование. Механизмы кэширования снижают латентность повторных запросов, особенно для контекстов, которые часто используются агентами. Эффективное кэширование сокращает повторные обращения к источникам и ускоряет генерируемые ответы.
-
Материализованные представления. MV позволяют предварительно вычислять и хранить агрегаты и вычисления, которые часто запрашиваются агентами, ускоряя ответы и снижая вычислительную нагрузку на реальные данные.
-
Управление качеством отклика. В реальной эксплуатации важно поддерживать качество вывода, даже при высокой нагрузке. Это включает механизмы ограничения скорости, приоритеты задач и мониторинг задержек для каждого агента и каждого источника.
-
Мониторинг и автоматическое масштабирование. Динамическое масштабирование кластера и адаптивная настройка параметров запросов позволяют сохранять баланс между производительностью и затратами. Мониторинг времени отклика, пропускной способности и ошибок является основой для устойчивой эксплуатации.
Эти принципы обеспечивают, что агентский ИИ может отвечать на запросы оперативно, даже в условиях высокой конкуренции за ресурсы и больших данных. В реальной эксплуатации критичны баланс параметров между временем ожидания и точностью выводов, чтобы сохранить производительность и качество взаимодействия с пользователем.
Масштабируемость систем агентского ИИ: рост числа агентов и стратегий масштабирования
Масштабируемость - ключевой фактор для корпоративной архитектуры. Рост числа агентов и задач требует горизонтального масштабирования, эффективного управления ресурсами и когортной политики.
-
Горизонтальное масштабирование. Включает добавление узлов к кластерам ClickHouse и распределение нагрузки между нодами. Это обеспечивает устойчивость к перегрузкам и возможность обслуживания большего числа агентов. Реализация требует корректной настройки репликации, консистентности и согласованности.
-
Многопроцессорная работа и параллелизм. В каждом узле удается распараллеливать запросы и задачи агентов, используя внутренние механизмы планирования и ядра для параллельной обработки. Это позволяет сохранить низкую задержку даже при большом количестве активных агентов.
-
Мультитенантность и управляемость. При росте числа агентов необходимо обеспечить изоляцию контекста между агентами, соответственно, политикам RBAC и токенизации. Это требует более сложной архитектуры слоёв доступа и строгого управления контекстами.
-
Оркестрация агентов. Управляющий слой должен поддерживать создание, мониторинг, масштабирование и удаление агентов. Он должен обеспечивать согласование между целями бизнеса и техническими ограничениями.
-
Мониторинг и SLA. Важно устанавливать сервис-уровни доступности (SLA) и мониторить соответствие. В случае перегрузок система должна автоматически перераспределять ресурсы, отключать несущественные задачи или временно снижать качество контекста.
-
Масштабируемость данных. При росте объема данных возрастает потребность в эффективной архитектуре хранения и индексации, в том числе для эмбеддингов, версий и метаданных. Выбор подхода к шардированию, репликации и архивированию данных должен быть основан на бизнес-требованиях.
Стратегия масштабирования должна сочетать техническую оптимизацию и управляемость бизнес-правилами. В правильной архитектуре ClickHouse и сопутствующих компонентах масштабирование обеспечивает устойчивую производительность, гибкость и управляемость при растущем численном размере агентов и рабочих нагрузок.
Оптимизация SQL-запросов для агентов ИИ: правила качества, ограничение ресурсоёмких операций
LLM может генерировать SQL-запросы к различным источникам, но важно задать качество и ограничения, чтобы обеспечить безопасность, производительность и точность. Оптимизация SQL-запросов для агентов ИИ включает:
-
Ясные правила качества. Определение допустимых шаблонов и ограничений на запросы: запрет на полные сканирования, ограничение объема возвращаемых строк, предотвращение потенциальной деградации производительности.
-
Корректность ключевых бизнес-метрик. Необходимо определить, какие показатели являются критическими, например сезонные финансовые коэффициенты, и как они рассчитываются, чтобы не допустить некорректных выводов.
-
Определение параметров качества. Включение порогов точности, времени отклика, объема выборки и др. Это позволяет агенту оптимально балансировать точность и скорость.
-
Расширения SQL для LLM. Ввод специальных команд и правил, форматов и контекстов для управления качеством SQL-запросов, ограничений и источников. Это может включать новые операторы и формы синтаксиса, которые лучше подходят для пересборки контекста и интеграции с ML-обработкой.
-
Обнаружение данных. Запросы DESCRIBE и SHOW и их расширения. Они помогают агенту понять структуру и свойства данных и определить, какие образцы данных и агрегаты нужны для анализа.
Оптимизация требует сочетания технических и бизнес-правил, чтобы запросы LLM приводили к полезным и управляемым результатам, без перегрузки системы и риска ошибок.
Расширения SQL для LLM: новые операторы, форматирование правил и метаданных
Для эффективного взаимодействия LLM с базой данных необходим набор расширений SQL, включающий новые операторы, правила формата и метаданных. Такие расширения улучшают прозрачность и управляемость процессов.
-
Новые операторы. Применение операторов, которые позволяют запросам LLM не только формировать данные, но и управлять контекстом, версионностью и безопасностью. Например, специальные операторы для описания наборов данных, выборки образцов или управления контекстом, встроенные в SQL.
-
Форматы правил. Включение форматов правил, которые LLM может использовать для принятия решений: какие источники доступны, какие пользователи могут запрашивать данные, какие ограничения действуют в рамках конкретных задач. Форматы должны быть машиночитаемыми и легко парсируемыми.
-
Метаданные. Расширение SQL для описания и возврата метаданных: схемы, типы данных, ограничения, политики доступа и информация о версии. Машиночитаемая документация упрощает взаимодействие агентов и повышает качество ответов.
-
Стандартизированные контракты. Введение форматов контрактов между агентами и базой данных, включая наборы правил и требований к ответам, что обеспечивает предсказуемость поведения агентов и облегчает аудит.
Эти расширения позволяет построить более безопасную, управляемую и эффективную среду для агентского ИИ, минимизируя риск некорректных запросов и обеспечивая более качественные результаты.
Обнаружение данных и самоописание: DESCRIBE, SHOW и машиночитаемая документация
Обнаружение данных - важная часть взаимодействия агентов с данными. DESCRIBE и SHOW - базовые команды для описания таблиц, столбцов и объектов в базе данных. В контексте агентской аналитики они становятся основой для машиночитаемой документации и самоописания наборов данных.
-
DESCRIBE и SHOW. Эти команды позволяют агентову получить структурную информацию о наборах данных, их типах, ограничениях и примерах. Это первый шаг перед выполнением сложных вычислений, так как агент должен понять структуру и свойства данных.
-
Машиночитаемая документация. Важна единая схема описания данных в машиночитаемом формате (JSON, YAML, XML). Такая документация облегчает автоматическую генерацию подсказок для LLM, помогает агенту быстро изучать данные и формировать контекст для анализа.
-
Документационные стандарты. Введение стандартизированных форматов и полей, таких как название набора данных, источник, частота обновления, версии, ограничения доступа, соответствует требованиям к управляемости и аудиту.
-
Адаптация под LLM. Обеспечение адаптации документации под LLM: простая навигация, ясные поля, контекстные подсказки и взаимосвязь с конкретными запросами. Это улучшает точность и снижает риск ошибок.
Обнаружение данных и машиночитаемая документация создают прочную базу знаний для агентов, позволяя им быстро определить доступные источники, их свойства и способы использования. Это критически для ускорения онлайн-исследований и повышения доверия к выводам.
Специализированные операторы и адаптация документации под LLM
Для повышения эффективности взаимодействия LLM с данными требуются специализированные операторы и адаптация документации под модель. Включение таких операторов в SQL-слой позволяет агентам формулировать запросы и получать ответы с учетом специфики ML и аналитики.
-
Специализированные операторы. Это операторы, позволяющие агентам выполнять задачи по подготовке данных, нормализации, агрегации, фильтрации на уровне контекста и с учетом особенностей ML-аналитики. Они упрощают формирование сложных запросов в безопасном виде.
-
Адаптация документации под LLM. Машиночитаемая документация должна отражать специфичные форматы данных, ограничения и правила доступа. Включение структурированных форматов облегчает генерацию подсказок и контекстов для LLM.
-
Форматы вывода. Определение форматов вывода для LLM: структурированные ответы, отчеты, резюме, примеры выборок. Это обеспечивает единообразие и повышает качество интеграции LLM.
-
Метаданные оператора. Описательные метаданные для операторов помогают агентам и системам управления понимать поведение операторов, их влияние на производительность и безопасность.
Специализированные операторы и машиночитаемая документация создают прочную базу для безопасной, эффективной и понятной работы агентского ИИ с данными.
Документация для агентов ИИ: стандартизированные машиночитаемые формы
Документация - основа прозрачности и воспроизводимости. Для агентов ИИ крайне важно иметь стандартизированные, машиночитаемые формы документов, которые описывают данные, правила использования и технические особенности.
-
Стандартизация форматов. Введение единых форматов описания наборов данных, контрактов между агентом и источниками и спецификаций на уровне поля. Это позволяет автоматизированной системе быстро распознавать и использовать данные без ручной настройки.
-
Форматы представления. JSON-LD или YAML как стандартные форматы для описания схем, ограничений, версий и метаданных. Это облегчает интеграцию с машиночитаемыми спецификациями и позволяет агентам автоматически формировать подсказки и процедуры работы.
-
Машиночитаемая документация как часть контекста. Включение документации в контекст RAG, чтобы агент мог ссылаться на источники и проверять их через DESCRIBE/SHOW и связанные спецификации.
-
Управление версиями документации. Важно иметь версии документации и контроль изменений, чтобы агент мог точно отслеживать обновления и корректировать поведение в соответствии с новыми данными и правилами.
Документация в машиночитаемом виде - критически важна для прозрачности, воспроизводимости и доверия к агентским системам, особенно в условиях регулируемой корпоративной среды.
Ускорение выполнения за счёт кэширования и материализованных представлений
Эффективность агентов во многом зависит от скорости доступа к данным. Кэширование и материализованные представления (MV) обеспечивают ускорение выполнения запросов и снижают нагрузку на источник данных.
-
Кэширование. Включает кэш результатов запросов, контекстов и эмбеддингов. Кэширование позволяет агенту быстро повторно использовать ранее полученный контекст, особенно при повторяющихся запросах.
-
Материализованные представления. MV представляют собой заранее рассчитанные результаты, которые можно обновлять периодически или по событиям. Это снижает вычислительную нагрузку на основные таблицы и ускоряет длинные аналитические запросы, что особенно полезно в RAG и онлайн-исследованиях.
-
Управление временем жизни кэша. Важно задавать TTL для кэша и политикам обновления, чтобы контекст оставался актуальным. Неправильно настроенный кэш может привести к рассинхронизации контекста и неверным выводам.
-
Архитектура MV в ClickHouse. MV в ClickHouse могут обеспечивать быстрый доступ к часто используемым агрегатам, фичам и контекстам. Важно учитывать обновляемость MV и их влияние на консистентность данных.
-
Балансировка затрат. Решения по кэшированию должны учитывать trade-off между скоростью и затратами на хранение. Эффективная стратегия кэширования снижает задержки и обеспечивает предсказуемость поведения агентов.
Ускорение выполнения за счёт кэширования и MV обеспечивает необходимую интерактивность и поддержку многозадачных агентских процессов в реальном времени.
Управление доступом: RBAC, токены, веб-API и SSL/TLS
Безопасность и управление доступом являются краеугольными камнями корпоративной архитектуры агентского ИИ. В ClickHouse это достигается сочетанием RBAC (управления доступом на основе ролей), токенизации, веб-API и защищенных соединений.
-
RBAC. Роли и учетные записи позволяют ограничить набор операций, доступ к данным и среды исполнения. В контексте агентских задач роли могут быть связаны с контекстами, наборами данных и операциями, которые может выполнять каждый агент.
-
Токены и веб-API. Агенты, взаимодействуя через промежуточный слой приложения, получают временные токены, которые ограничивают продолжительность выполнения задач. Токены обеспечивают безопасную и управляемую аутентификацию, а также возможность быстрого отзыва.
-
SSL/TLS. Все коммуникации между агентами, промежуточным слоем и ClickHouse должны быть защищены протоколами SSL/TLS, обеспечивающими конфиденциальность и целостность данных.
-
Контроль доступа на уровне сети. Ограничение доступа к ClickHouse только через промежуточный слой обеспечивает защиту от прямого доступа агентов к базе. Это создает дополнительный уровень защиты и проще управляет маршрутами.
-
Мониторинг использования токенов. Включение журналирования использования токенов, контроля истечения и событий безопасности позволяет обнаруживать подозрительную активность и предотвращать злоупотребления.
Адаптация к современным требованиям безопасности и поддержка гибкого RBAC позволяют обеспечить безопасность и соответствие политик при автономной работе агентов.
Мониторинг, логирование и управление нагрузкой
Мониторинг и управление нагрузкой - критически важные аспекты устойчивого функционирования агентских систем. Необходимо видеть в реальном времени, как работают агенты, какой эффект получают от анализа и какие ресурсы при этом потребляются.
-
Мониторинг показателей. Отслеживаются латентность, Throughput, доля ошибок, время отклика и пропускная способность. В отслеживании важны показатели для каждого агента, набора данных и источника.
-
Логирование. Регистрация действий агентов и операций в ClickHouse, включая запросы, изменения контекста, доступ к данным и взаимодействия с внешними источниками. Это обеспечивает аудируемость и способствует расследованию инцидентов.
-
Управление нагрузкой. Оценка очередей, параллелизма и приоритетов задач. Важно управлять ограничениями скорости и качеством обслуживания, чтобы не перегружать систему и обеспечить предсказуемый отклик.
-
Трассировка. Трассировка запросов и операций позволяет идентифицировать узкие места и оптимизировать конвейеры. Это особенно важно в сложных сценариях с несколькими агентами, RAG и мультимодальными данными.
-
Дашборды и визуализация. Инструменты визуализации помогают аналитикам и администраторам быстро понимать состояние системы, ее производительность и безопасность. Важно, чтобы дашборды были понятны и информативны.
Эти механизмы обеспечивают прозрачность, контроль и устойчивую производительность агентского ИИ в реальном времени.
Управление жизненным циклом токенов и безопасность
Безопасность токенов и их жизненного цикла - важная часть стабильной эксплуатации. Необходимо управлять созданием, использованием и отзывом токенов, чтобы обеспечить безопасные взаимодействия между агентами, веб-API и ClickHouse.
-
Жизненный цикл токена. Включает эмиссию, срок действия и процесс отзыва. Токены должны быть выданы на ограниченный период, соответствующий длительности задач.
-
Ревокация и истечение. Необходимо поддерживать возможность принудительного отзыва токенов по запросу или по истечении срока. Это особенно важно при обнаружении подозрительной активности или изменений в политике доступа.
-
Безопасность хранения токенов. Токены должны храниться безопасно и защититься от утечки. Возможны решения по использованию секрет-менеджеров и шифрования.
-
Мониторинг и аудит. Ведение журналов использования токенов и контроль доступа помогают выявлять необычное поведение и проводить аудит на соответствие политикам.
-
Интеграции OAuth 2.0 и IAM. Альтернативы собственной разработке могут быть использованы эмпирически: OAuth 2.0 или решения IAM (Identity and Access Management) для упрощения управления доступом и безопасной аутентификации.
Управление жизненным циклом токенов и безопасность - неотъемлемые элементы устойчивой архитектуры агентского ИИ.
Альтернативы собственной разработке: OAuth 2.0, IAM и готовые решения
Разработка собственного решения по управлению доступом - трудоемкий процесс с высоким риском ошибок и задержек. Рассмотрение готовых подходов и стандартов может существенно сократить время внедрения и повысить безопасность.
-
OAuth 2.0. Стандарт авторизации, позволяющий делегировать ограниченный доступ аплику и агентам к ресурсам без передачи учётных данных. Это упрощает инфраструктуру и обеспечивает совместимость с различными сервисами.
-
IAM (Identity and Access Management). Роль-ориентированные подходы к управлению идентификации, доступом и политиками безопасности. IAM-системы дают централизованный контроль доступа и аудит, что особенно важно в корпоративной среде.
-
Готовые решения. Готовые решения по токенизации, аутентификации и управлению доступом позволяют снизить риск ошибок и ускорить внедрение. Они интегрируются с ClickHouse через промежуточный слой и обеспечивают согласованные политики.
-
Применение в агентской архитектуре. В интеграции с агентскими ИИ готовые решения позволяют сосредоточиться на конфигурации, политике и мониторинге, не отвлекаясь на создание базовой инфраструктуры.
Альтернативы собственной разработки предоставляют прочную основу для безопасной и эффективной интеграции агентских ИИ в корпоративную экосистему.
Построение DWH на ClickHouse: архитектурные решения и практические аспекты
Построение DWH (Data Warehouse) на ClickHouse требует учета архитектурной целостности, производительности и управляемости. В этом разделе обсуждаются практические аспекты:
-
Архитектура DWH. Включает источники данных, интеграцию, хранение и управление версиями. Важна грамотная стратегия инжекции, ETL/ELT-процессы и журнал изменений.
-
Хранение данных. ClickHouse подходит для колоночного хранения, с поддержкой компрессии и эффективного анализа. Важно структурировать данные таким образом, чтобы они поддерживали аналитические запросы и ML-агенты.
-
ML-фичи и эмбеддинги. Для агентской аналитики фичи и эмбеддинги должны храниться рядом с данными, чтобы обеспечить быстрый доступ. Важна версия и управление обновлениями, чтобы контекст был актуален.
-
Этапы конвейера. Интеграция источников, очистка и нормализация, агрегации, хранение и визуализация. Важно обеспечить согласование между различными этапами и контекстами.
-
Безопасность и управление. RBAC, токены, мониторинг и аудит. Это критично для корпоративной среды.
-
Масштабирование и устойчивость. Архитектура должна поддерживать рост объема данных и числа агентов, а также обеспечение отказоустойчивости.
Построение DWH на ClickHouse требует системного подхода, который охватывает архитектуру, данные, безопасность и эксплуатацию. Такой подход обеспечивает эффективную аналитику в реальном времени и поддержку агентских ИИ.
Кейсы применения в реальных сценариях: финансы, промышленность, научно-исследовательские задачи
Реальные кейсы демонстрируют, как архитектура агентского ИИ на ClickHouse может приносить бизнес-ценность.
-
Финансы. В банковской и страховой сферах агентский ИИ может анализировать финансовые потоки в реальном времени, выявлять риски и аномалии, формировать оперативные рекомендации и поддерживать комплаенс. OLAP-аналитика позволяет быстро выявлять тенденции и аномалии, а RAG обеспечивает доступ к внешним источникам и документообороту.
-
Промышленность. В производстве агентский ИИ осуществляет мониторинг оборудования, предиктивную аналитику и операционные решения на основе данных сенсоров, журналов и документов. Интеграция внешних источников, таких как регуляторные обновления и лабораторные отчеты, дополняет контекст.
-
Научно-исследовательские задачи. Агент может автоматизировать поиск и агрегацию знаний из множества источников, включая научные публикации и данные экспериментов. РAG позволяет формировать сводные отчеты и резюме исследований за относительно короткий период.
Кейсы показывают практическую эффективность, но при этом подчеркивают важность управляемости, безопасности и прозрачности контекста, чтобы обеспечить корректность выводов и соответствие требованиям.
Интеграция технологических стеков и синергия: архитектура стека, governance и data lineage
Интеграция стеков технологий требует продуманной архитектуры и согласованных методологий:
-
Архитектура стека. Применение модульного подхода, выделяющего слои источников данных, хранения и аналитики, конвейеры RAG, агентские слои и слой управления. Четкая граница между слоями упрощает масштабирование и обновление.
-
Governance и data lineage. В контексте корпоративной аналитики важно документировать происхождение данных, трансформации, правила доступа и политики безопасности. Data lineage обеспечивает прослеживаемость и аудируемость каждого шага анализа, что критично для регуляторных требований.
-
Взаимодействие с данными. Применение стандартов на формат документации, описание наборов данных, процедур и версий. Это помогает в онлайновых исследованиях и повторяемости.
-
Сотрудничество между командами. Интеграция архитектур и согласование между командами аналитики, разработки, информационной безопасности и руководством требуют общего языка и общих стандартов.
Синергия технологических стеков достигается через единый подход к governance, документации и совместному планированию архитектурных изменений.
Анализ рисков, уязвимостей, ограничений и метрик эффективности
Любая архитектура требует анализа рисков и метрик эффективности:
-
Риски и уязвимости. Возможные риски включают утечки данных, неверное использование агрегатов, нарушение политики безопасности и зависимость от внешних источников. Меры снижения включают строгие политики RBAC, аудит, контроль доступа, мониторинг и ограничение доступа к внешним источникам.
-
Ограничения. Стоит учитывать ограничения по скорости, объему данных, сложности моделей и мультимодальности. Важно иметь план по масштабированию, кэшированию и управлению контекстом.
-
Метрики эффективности. Основные метрики включают точность ответов, время отклика, latency и throughput, устойчивость к перегрузкам, количество ошибок, качество контекста и точность контекстной генерации. Для OLAP-аналитики полезны метрики задержки, пропускной способности и рост объема данных.
-
Подход к управлению рисками. Включает процессы ревью дизайна, тестирование изменений в изолированной среде, аудит и стратегии откатов. Важно обеспечить, чтобы аналитические выводы были проверяемы и повторяемы.
-
Соответствие требованиям. Включает соответствие нормативным актам, политики приватности и безопасности. Вагомый фактор - поддержка источников и контекстов, связанных с рисками и регуляторикой.
Анализ рисков и метрик обеспечивает управляемость и предсказуемость архитектуры агентского ИИ.
Конкурентный анализ конкурентных решений и их дифференциация
На рынке существуют различные подходы к агентскому ИИ и управлению данными в рамках OLAP-структур. Сравнение с конкурентами помогает выявить сильные стороны и направления для дифференциации:
-
Архитектура и интеграция. В некоторых решениях используется интеграция с другими базами данных и специфические конвейеры. В нашем подходе основной упор сделан на тесную интеграцию с ClickHouse, что обеспечивает высокую скорость чтения и эффективный OLAP-аналитический режим.
-
РAG и мультимодальность. Наличие устойчивых конвейеров RAG и поддержки мультимодальных данных является значительным преимуществом. Наша архитектура учитывает мультимодальные данные, контекст и кэширование для быстрого доступа к данным.
-
Управление доступом и безопасность. RBAC, токены и безопасные API-слои обеспечивают высокий уровень безопасности и соблюдения политика. Это важно в корпоративной среде.
-
Машиночитаемая документация. Наличие стандартизированных форм машиночитаемой документации упрощает интеграцию и взаимодействие с LLM, что является конкурентным преимуществом.
-
Производительность и масштабируемость. Наша архитектура ориентирована на горизонтальное масштабирование, кэширование и MV, что обеспечивает высокую производительность при росте агентов и объема данных.
-
Контроль контекста и прозрачность. Прозрачность контекста и машиночитаемая документация облегчают аудит и объяснение выводов, что является важным в регуляторной среде.
Дифференциация достигается через структурированную архитектуру, политику управления доступом, машиночитаемую документацию и эффективные конвейеры RAG на основе ClickHouse. Это позволяет использовать агентский ИИ в реальном времени с высокой эффективностью, прозрачностью и безопасностью в корпоративной среде.
Вопрос-Ответ:
-
Вопрос: Какова роль OLAP в агентском ИИ на ClickHouse?
Ответ: OLAP обеспечивает эффективный анализ больших данных, временных рядов и сложных агрегаций, необходимый для обнаружения тенденций, аномалий и генерации выводов агентами, при этом поддерживая интерактивность и масштабируемость. -
Вопрос: Что представляет собой RAG-пайплайн в контексте ClickHouse?
Ответ: RAG сочетает поиск по эмбеддингам и текстовым данным с генерацией ответов на основе найденной информации, обеспечивая контекст для LLM и ускоряя доступ к релевантным источникам. -
Вопрос: Какие меры безопасности критичны для агентских ИИ на ClickHouse?
Ответ: RBAC, токены с ограниченным временем жизни, TLS/SSL, управление доступом через промежуточный слой, мониторинг, аудит и возможность отзыва токенов. -
Вопрос: Как достигается масштабируемость системы?
Ответ: Через горизонтальное масштабирование нод ClickHouse, многопоточность, управление очередями, планирование задач и безопасное разделение контекста между агентами. -
Вопрос: Какие преимущества дает машиночитаемая документация для агентов ИИ?
Ответ: Она упрощает доступ к данным, улучшает точность вывода и ускоряет онлайн-исследования за счет единообразия форматов, описаний наборов данных и версий. -
Вопрос: Какие риски связаны с автономной ML-системой агентского ИИ?
Ответ: Риски включают неверные интерпретации данных, нарушение политики безопасности, злоупотребление внешними источниками и увеличение задержек. Меры включают управление контекстом, регуляторику и аудит. -
Вопрос: Как ClickHouse поддерживает мультимодальность?
Ответ: ClickHouse поддерживает работу с текстовой информацией и структурированными данными, а интеграции с мультимодальными конвейерами позволяют хранить и обрабатывать эмбеддинги и контекст мультимодальных данных. -
Вопрос: Как обеспечивается обновление и самообогащение данных агентами?
Ответ: Через онлайн-исследования, самообучение и обновление контекста, при этом применяются политики безопасности, контроля доступа и аудита, чтобы поддерживать соответствие требованиям. -
Вопрос: Какие преимущества дает интеграция внешних источников?
Ответ: Это расширяет контекст агентов, предоставляет новые источники знаний, поддерживает свежие данные и улучшает точность выводов, если управление источниками и качеством данных реализовано корректно. -
Вопрос: Какие стратегии кэширования применимы в агентских конвейерах?
Ответ: Кэширование результатов запросов, контекстов и эмбеддингов, использование MV для часто запрашиваемых агрегатов и контекстов, а также управление TTL и обновлением кэша. -
Вопрос: Какие требования к разработке расширений SQL для LLM?
Ответ: Необходимо определить новые операторы, форматы правил и машиночитаемую документацию, чтобы LLM мог формировать безопасные и качественные запросы, а система - корректно их обрабатывать. -
Вопрос: Каким образом обеспечивается прозрачность и управление данными в DWH на ClickHouse?
Ответ: Через governance, data lineage, машиночитаемую документацию и версии наборов данных, что позволяет отслеживать происхождение данных и повторно воспроизводить анализ. -
Вопрос: Каковы ключевые принципы перехода к автономной аналитике на основе ClickHouse?
Ответ: Модульность архитектуры, управление безопасностью, поддержка RAG и мультимодальности, машиночитаемая документация, мониторинг и способность масштабироваться под запросы бизнеса.


