

ClickHouse: архитектура и оптимизация запросов в современных аналитических системах - теория, кейсы, риски, конкуренция и регуляторные аспекты
В современных корпоративных аналитических средах выбор подходящей СУБД и эффективная реализация запросов являются критическими элементами цифровой трансформации. ClickHouse как столбцовая аналитическая система с массированными нагрузками предлагает уникальный набор архитектурных решений, компрессии данных, планирования выполнения запросов и стратегий репликации. В настоящей работе рассмотрены теоретические основы, архитектура и практические подходы к оптимизации запросов, разбор ключевых компонентов системы, а также кейсы применения в финансовых, телекоммуникационных и государственно-правовых контекстах. Особое внимание уделяется взаимодействию компонентов, регуляторным аспектам в обучении персонала и рискам эксплуатации в масштабе предприятия. Текст структурирован по принципу «от стратегий к реализациям», поддерживает требования профессионального уровня аудитории - аналитиков, архитекторов, руководителей data-направлений и ИТ-директоров.
Оптимизация запросов в ClickHouse: индексы, EXPLAIN и лучшие практики. Урок 6
Архитектура и роль индексов в ускорении запросов
ClickHouse реализует концепцию столбцового хранения и специальных механизмов ускорения без традиционных B-деревьев и многомерных индексов, знакомых из реляционных СУБД. Основной движок запросов строится вокруг хранения данных в настраиваемых таблицах на базе движков семейства MergeTree, где физическая организация данных определяет скорость сканирования, сжатие и выборку. Важнейшие концепты для архитекторов:
- Опциональные индексы в ClickHouse реализуются не как обычные B-деревья, а через синтаксис и параметры сортировки, первичного ключа и вспомогательных индексов с накоплением статистики:
- первичный ключ задаёт порядок хранения данных и влияет на исключение ненужных участков данных при чтении;
- сортировка по ключу (ORDER BY) позволяет эффективнее пользоваться пропусками и фильтрацией;
- ограничения на разведку диапазонами (granularity) и использование индексов на уровне блоков.
- Механизмы пропуска данных (data skipping), основанные на метаданых блоков, ускоряют чтение путем пропуска слишком молодых или нерелевантных участков.
- Сжатие и кодеки влияют на объём передаваемых по сети данных и интенсивность ввода-вывода; грамотный выбор кодеков (LZ4, ZSTD, Delta, Gorilla и пр.) и уровней компрессии позволяет снизить задержки без потери скорости вычислений.
- Важно учитывать компримирование не только для экономии пространства, но и для снижения сетевой нагрузки и ускорения сканирования больших массивов данных в столбцах.
Практическая рекомендация: проектируя схему хранения, определяйте порядок сортировки на уровне CREATE TABLE, учитывая характер запросов. Для часто используемых фильтров по диапазонам значений и временным меткам используйте партицирование по датам (PARTITION BY) и соответствующие сортировки в ORDER BY, чтобы максимизировать эффект data skipping.
EXPLAIN: планы выполнения и интерпретация
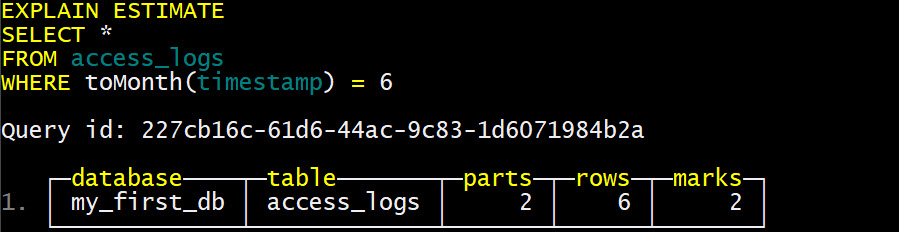
Понимание плана выполнения запросов в ClickHouse является критическим навыком для аналитиков и инженеров данных. Привычный вывод EXPLAIN в ClickHouse имеет свои особенности:
- EXPLAIN позволяет увидеть последовательность операций: чтение данных из таблицы, применение фильтров, агрегации, сортировки, переписывание итогов. Это позволяет выявлять узкие места на стадии чтения данных и на стадии агрегации.
- В плане можно увидеть влияние многоступенчатого чтения, когда данные считываются порциями благодаря партиционированию и грануляции; отражается эффект задержки, связанный с распределенными таблицами и репликациями.
- В контексте оптимизации индексов и сортировок EXPLAIN помогает проверить, насколько блоки пропускаются, какие участки данных затрагиваются фильтрами и какие данные попадают под агрегацию.
- Практическая ценность EXPLAIN состоит в том, чтобы определить, может ли изменение ORDER BY и PARTITION BY существенно изменить количество прочитанных блоков и количество узлов, задействованных в запросе.
Рекомендации по использованию EXPLAIN:
- Регулярно проводить аудит планов для часто выполняемых запросов в рабочих дельтах данных; фиксировать изменения планов после модификаций схем и параметров.
- Сопоставлять EXPLAIN с фактическими метриками: latency и throughput, чтобы полноценное понимание влияния архитектурных изменений.
- Использовать EXPLAIN в сочетании с мониторингом задержек на уровне узлов и сетевых компонентов, чтобы исключать проблемы инфраструктуры.
Лучшие практики и метрики производительности
Эффективная оптимизация в ClickHouse строится на сочетании архитектуры, конфигурации системы и методик контроля. Ключевые принципы:
-
Грамотная настройка и выбор движков: MergeTree-подобные движки, такие как ReplacingMergeTree, SummingMergeTree, CollapsingMergeTree, позволяют управлять специфическими сценариями обработки данных (устаревание записей, агрегации по ключу, детекция дубликатов).
-
Правильная конфигурация параметров чтения и кеширования: увеличение параллелизма чтения, настройка размеров кусков (mark distances) и границ кэширования.
-
Оптимизация последовательности операций: фильтры на уровне pre- и post-filter выводов должны использоваться в максимально селективной форме, чтобы минимизировать количество блоков, которые нужно прочитать.
-
Мониторинг и аналитика по пяти основным метрикам: latency, throughput (QPS), bandwidth, query contention и SLA-уровни. Включение ранжирования запросов по важности и приоритизация планирования вычислительных ресурсов в пиковые периоды.
-
Практическая методология performance-testing: использование синтетических рабочих нагрузок, realistic workloads и benchmarks, репликация результатов мониторинга в дашбордах.
-
Важнейшие показатели включают:
- latency (латентность) - время от подачи запроса до получения результата;
- QPS (queries per second) - пропускная способность;
- SLA (service level agreement) - целевые параметры времени отклика и доступности;
- throughput - объём обрабатываемых данных за единицу времени;
- resource utilization - загрузка CPU, IO и сети.

Во внедрении ClickHouse следует выстраивать процесс непрерывной оптимизации: от проектирования архитектуры и схемы хранения через отладку планов выполнения до мониторинга и коррекции конфигураций на рабочих стендах, предмете которых являются конкретные бизнес-задачи.
Декомпозиция технических компонентов и их взаимодействие
Архитектура: узлы, репликация и партиционирование
Архитектура ClickHouse характеризуется распределением данных по узлам кластера и мощной поддержкой параллельных вычислений. Основные элементы:
- Узлы кластера: каждый пакет данных хранится на определённом наборе узлов в рамках shard-ов и реплицируется для обеспечения доступности и отказоустойчивости.
- Репликация: обеспечивает консистентность и устойчивость к сбоям. Репликация реализуется через распределённые таблицы, которые синхронно копируют данные между репликами. Это критически важно для аналитических систем, где непрерывная доступность и консистентность данных- ключевые требования.
- Партиционирование: данные разделяются по временным или другим логическим признакам (например, по дням, регионам или источникам). Это обеспечивает эффективное чтение сегментированных данных и улучшение пропускной способности при больших нагрузках.
- Обеспечение консистентности: операции репликации, фоновые задачи MergeTree икомплектные фоновые процессы, включающие отложенное слияние и оптимизацию хранилища.

В проектировании кластера необходима чёткая стратегия балансировки нагрузки и отказоустойчивости, учитывающая требования бизнеса к задержкам и доступности.
Хранилище, движки и компрессия
- Хранилище: ориентировано на столбцовое хранение, что обеспечивает эффективную работу со спросовыми запросами, агрегациями и фильтрациями на больших объёмах. Для оптимальной эффективности выбираются комбинации движков и кодеков.
- Движки: семейство MergeTree и его вариации; кроме того, существуют вспомогательные движки для специальных задач:
- ReplacingMergeTree - справляется с заменой дубликатов по указанному ключу;
- SummingMergeTree - агрегирует значения по определённым ключам;
- AggregatingEngine - поддерживает специфичные паттерны агрегации;
- Distributed - обеспечивает доступ к данным из нескольких узлов как к единому логическому источнику.
- Компрессия и кодеки: выбор компрессии влияет на размер хранилища, сетевой трафик и скорость чтения; популярные кодеки включают LZ4, ZSTD, Delta и т. п. Грамотная настройка компрессии и кодеков повышает пропускную способность и снижает латентность, особенно в сценариях больших потоков данных и сложных агрегаций.
Каскадная схема: данные загружаются в локальные таблицы на узлах, затем агрегируются и реплицируются посредством фоновых задач, после чего внешнее представление через Distributed таблицы обеспечивает единый доступ к данным по всему кластеру.
Этапы обработки запросов
- Принятие запроса: клиент передаёт SQL-подобный запрос к одному из узлов.
- Разбор и планирование: синтаксический разбор, построение дерева выполнения; выбор оптимального плана на основе статистики данных и настроек.
- Чтение и фильтрация: выполнение фильтрации на уровне блоков, чтение только релевантных сегментов данных благодаря партиционированию и сортировке.
- Агрегация и сортировка: агрегационные функции, группировки и сортировка результатов по требуемым ключам.
- Финализация: сбор и формирование итоговых строк, форматирование по требованию клиента, применение любых функций окон (если применимо).
- Репликация и консолидация: в распределённых окружениях данные согласуются между репликами и узлами, обеспечивая целостность и устойчивость к сбоям.
Эти этапы требуют чёткой координации между узлами и оптимизации на уровне конфигурации, чтобы минимизировать накладные расходы и задержки.
Теоретическая база и объяснение основ
Структура столбцовых СУБД
Столбцовые СУБД, такие как ClickHouse, ориентированы на быстрый доступ к столбцам данных. Это позволяет эффективнее сканировать только те столбцы, которые необходимы для выполнения запроса, что критически важно при обработке больших наборов данных с многочисленными столбцами. Основные преимущества:
- Эффективная селективная фильтрация: чтение минимальных наборов столбцов снижает I/O.
- Улучшенная компрессия: повторяемые значения в столбцах легче кодируются.
- Параллелизм: независимое чтение столбцов возможно по разным потокам, что идеально подходит для многопроцессорной архитектуры.
- Гибкость схемы: добавление столбцов и изменений схемы может выполняться без значительных сбоев в доступности.
Эти принципы формируют основу проектирования схем и запросов в рамках аналитических систем.
Модели индексации, сортировки и сжатия
-
Индексация в ClickHouse реализуется через сортировку по ключу (ORDER BY) и структуру данных, позволяющую пропускать данные на уровне блоков.
-
Сортировка и организация данных по ключу позволяют эффективно использовать фильтры по диапазонам, временным меткам и другим условиям.
-
Сжатие данных ведёт к снижению затрат на хранение и сетевой трафик; выбор кодеков и уровней компрессии должен зависеть от характеристик рабочих нагрузок: частота обновления данных, объём и паттерны чтения.
-
Компрессия и сжатие: разные кодеки лучше подходят для различных типов данных. Выбор оптимального сочетания кодеков и параметров компрессии обеспечивает баланс между временем чтения и размером данных на диске.
Эти концепты служат теоретическим фундаментом, позволяющим архитекторам и инженерам строить эффективные решения на основе ClickHouse.
Кейсы применения в реальных сценариях
Финансы и аналитика в реальном времени
В финансовом секторе ClickHouse применяется для анализа потоковых данных в реальном времени: торговые логи, рыночные данные, риск-метрики и прогнозы. Ключевые задачи включают:
- обработку больших объёмов торговых транзакций за минимальные задержки;
- агрегирование по временным интервалам (минуты, часы, дни) для построения дашбордов;
- трекинг ключевых индикаторов риска и производности систем;
- интеграцию с BI-инструментами для оперативной отчетности.
Реализация таких кейсов требует балансирования между задержками и точностью, выбора подходящих движков, партиционирования и стратегиям кэширования.
Логи и телеком: обработка больших объемов
Лог-файлы телекоммуникационных сетей представляют собой огромные потоки событий с временными метками и различными полями. ClickHouse позволяет:
- хранить и анализировать телеком-логи на уровне миллисекунд;
- выполнять агрегации по различным признакам (типы событий, география, устройства);
- обнаружение аномалий и мониторинг качества сервиса в режиме реального времени;
- интеграцию с системами хранения в облаке и кэш-слоями для ускорения доступа и анализа.
Эти сценарии демонстрируют устойчивость ClickHouse к высокому уровню параллелизма и способности масштабироваться на уровне кластера.
Интеграция технологических стеков и их синергия
ETL/ELT и BI
- ETL (Extract-Transform-Load) и ELT (Extract-Load-Transform) - подходы к перемещению и обработке данных. В контексте ClickHouse часто предпочтительно применять ELT: данные загружаются в исходном виде, затем происходят трансформации внутри аналитической базы для минимизации задержек во внешних пайплайнах.
- BI-инструменты взаимодействуют с ClickHouse через драйверы и SQL-совместимый интерфейс, обеспечивая визуализацию и дашборды на основе агрегаций и тонкой настройки запросов.
- Архитекторы должны учитывать особенности задержек между источниками данных, ETL-очки и требования к обновлению дашбордов.
Кэширование и хранение: Redis, S3
- Redis может использоваться как кэш между источниками данных и ClickHouse для снижения задержек чтения часто запрашиваемых значений.
- Хранение долговечных данных в S3 или аналогичных хранилищах обеспечивает масштабируемость и устойчивость к отказам, а также позволяет осуществлять резервирование и архивирование данных.
- Синергия между кэшированием, локальными и облачными хранилищами позволяет строить гибкую архитектуру с учетом расходов и требований к доступности.
Возможности применения в различных экономических секторах
Финансы
Финансовые организации применяют ClickHouse для анализа больших массивов торговых данных, вычисления агрегатов в реальном времени и создания отчетности по регуляторным требованиям. В этом контексте критически важны:
- надёжность и отказоустойчивость;
- способность обрабатывать потоковые данные и согласовывать реплики;
- эффективная аналитика по временным рядам и кросс-табличным связям.
Телеком и онлайн-ритейл
В телеком и онлайн-ритейле ClickHouse используется для анализа логов, поведения пользователей, измерения SLA и мониторинга инфраструктуры. Важны:
- низкая задержка и высокая пропускная способность;
- возможность обработки больших массивов событий без потери точности;
- интеграции с системами видеодоступа, банкинга и транзакционных сервисов.
Государственный сектор
Государственные информационные системы требуют управления данными с учетом регуляторных требований, аудита и обеспечения доступа к данным. ClickHouse может служить аналитической платформой для госорганизаций, обеспечивая масштабируемость, отказоустойчивость и прозрачность вычислительных процессов.
Анализ рисков, уязвимостей и ограничений с метриками эффективности
Ограничения и риски ClickHouse
- сложность горизонтального масштабирования в сложных условиях и необходимость квалифицированного администрирования.
- зависимость от качественных метаданных и планирования схемы хранения: неправильный выбор ORDER BY и PARTITION BY может привести к деградации производительности.
- потенциальные проблемы с консистентностью в распределённых конфигурациях и задержками на уровне репликации в условиях сетевых сбоев.
- требовательность к объёму оперативной памяти и скорости дисков для поддержания высокой производительности.
Метрики эффективности: latency, QPS, SLA
- latency (латентность): критична для реального времени; контроль через мониторинг и профилирование запросов.
- QPS (queries per second): измерение пропускной способности кластера; требует балансировки вычислительных ресурсов.
- SLA (service level agreement): целевые параметры времени отклика, доступности и качества сервиса, согласованные с бизнес-подразделениями.
- Additional metrics: backlog, queue length на уровне диспетчера запросов; disk I/O wait; network throughput; cache-hit rate.
Эти метрики служат ориентиром для циклического цикла оптимизации: проектирование схем, настройка параметров, тестирование и релиз, мониторинг и корректировки.
Конкурентный анализ конкурирующих решений и их дифференциация
Druid и Apache Pinot: сравнение
- Druid и Apache Pinot - это аналитические системы, ориентированные на агрегации и быстрый отклик под OST (online analytical processing). Сравнение с ClickHouse может быть выполнено по нескольким направлениям:
- Архитектура: Druid и Pinot используют другие модели индексации и хранения, лучше подходят для некоторых конкретных сценариев по фильтрации и агрегации в реальном времени.
- Производительность: ClickHouse часто демонстрирует высокую производительность на больших объёмах столбцовых данных, с акцентом на компрессию и параллелизм.
- Гибкость и экосистема: ClickHouse предлагает более богатыe интеграционные возможности с разнообразными форматами и механизмами репликации.
- Выбор между этими решениями должен основываться на характере нагрузки, требуемой консистентности и уровне регуляторного контроля.
Другие решения и дифференциация
- Другие решения (например, традиционные колоночные СУБД и распределённые хранилища) могут иметь более узкую специализацию или меньшую стоимость владения в отдельных сценариях.
- Дифференциация основана на: архитектуре распределённого выполнения, поддержке языков запросов, возможностей для реального времени, масштабируемости, мониторинга и инструментов администрирования, а также на ценовой модели и гибкости инфраструктуры.
Налоговый вычет на обучение
Правовые основы
Для корпоративной среды образовательные программы выходят за рамки исключительно корпоративного обучения и затрагивают регуляторное поле, связанное с освещением затрат на образовательные услуги сотрудникам. В рамках Российской Федерации налоговый вычет на обучение относится к вычетам из доходов физических лиц (НДФЛ). В контексте обучения сотрудников в рамках корпоративной цифровой трансформации и подготовки специалистов по ClickHouse эта регуляторная концепция может использоваться для оптимизации затрат на обучение и повышения мотивации персонала.
- Нормативная база предусматривает возможность оформления социального вычета по расходам на обучение как для граждан, работающих официально, так и для их близких родственников в рамках установленных случаев.
- Важным элементом является корректное оформление документов и подтверждающих справок, которые подтверждают право на вычет и факт оплаты обучения.
Документы и порядок подачи
- Нередко требуется набор документов: декларация 3-НДФЛ за годы обучения, справки о доходах от работодателя, договоры обучения и дополнительные соглашения, копии лицензий учебного заведения, подтверждающие справки об обучении на очном отделении и прочие. В случае некоторых форм обучения документы формально оформляются по шаблонам, которые должны храниться в бухгалтерском учёте.
- Начиная с расходов на 01.01.2024 года, для подтверждения права на социальный вычет по обучению необходима справка об оплате образовательных услуг, выданная образовательной организацией или индивидуальным предпринимателем, осуществляющим образовательную деятельность; форма справки утверждена приказом ФНС России от 18.10.2023 № ЕД-7-11/755@.
- Если сведения о расходах уже были представлены налоговым органам напрямую образовательной организацией, то представление справки может не требоваться.
Нововведения 2024 года
- В 2024 году приняты изменения, направленные на упрощение процедуры подтверждения расходов и предоставления документов через онлайн-сервисы; формирование справки может происходить в электронном формате и отображаться в личном кабинете налогоплательщика. Это улучшает скорость обработки запросов на вычет и уменьшает административную нагрузку на сотрудников и бухгалтерию.
- В контексте корпоративной подготовки специалистов по ClickHouse, эти изменения создают стимул для компаний инвестировать в обучение, поскольку юридически вычеты могут значительно снизить затраты на квалификационную подготовку сотрудников.
Практическая интеграция налогового вычета в программы обучения
- Корпоративная политика и регуляторный контроль должны учитывать возможность вычета как часть бюджета на обучение. Включение соответствующих документов в учет образовательных программ, регулярная актуализация шаблонов договоров и квитанций помогут ускорить процедуру в будущем.
- В рамках архитектурного проекта по обучению персонала важно обеспечить прозрачность документооборота, автоматизацию формирования необходимой документации и взаимодействие с бухгалтерией.
- Включение налоговых вычетов в финансовые расчёты по проектам цифровой трансформации повышает экономическую эффективность программ обучения и делает их устойчивыми в долгосрочной перспективе.
Вопрос-Ответ
Вопрос: Какие принципы архитектуры ClickHouse обеспечивают скорость выполнения запросов при больших объемах данных?**
Основные принципы включают столбцовую организацию хранения, оптимизацию ORDER BY и PARTITION BY для эффективного data skipping, реализацию репликации и распределённых таблиц для масштабирования и отказоустойчивости, а также грамотный выбор кодеков и конфигураций компрессии для ускоренного доступа к данным.
Вопрос: Как EXPLAIN помогает в оптимизации запросов?**
EXPLAIN позволяет увидеть план выполнения запроса, показать, какие блоки данных будут считаны, какие индексы и фильтры активируются, и как распределяется вычисление по узлам. Это позволяет выявлять узкие места, корректировать сортировку и партиционирование, а также уменьшать латентность.
Вопрос: Какие регуляторные аспекты следует учитывать при обучении сотрудников для работы с ClickHouse?**
Важны правила оформления документов на оплату обучения, возможность использования налоговых вычетов по НДФЛ и требования к подтверждающим справкам о расходах. В 2024 году введены упрощения в оформлении справок об оплате образовательных услуг, что ускоряет процесс возмещения затрат.
Вопрос: Какие сценарии являются наиболее критичными для финансовых организаций при использовании ClickHouse?**
Обработки больших потоков данных в реальном времени, требовательность к точности и времени отклика, обеспечение отказоустойчивости и консистентности реплик, а также эффективная агрегация по временным рядам и вычисление рисков в реальном времени.
Каковы основные различия между ClickHouse и Druid/Apache Pinot в контексте аналитических задач?
ClickHouse традиционно обеспечивает высокую производительность на больших столбцовых данных с фокусом на компрессию и параллелизм, тогда как Druid и Pinot часто оптимизированы под специфические сценарии реального времени и фильтрации. Выбор зависит от рабочих нагрузок, требований к консистентности и интеграций с существующей инфраструктурой.
Вопрос: Какой подход к хранению данных наиболее эффективен для ClickHouse?**
Эффективная схема хранения строится вокруг MergeTree-подобных движков, оптимального ORDER BY и PARTITION BY, грамотного выбора временных партиций и подходящих кодеков. Это обеспечивает минимальный объем чтения и высокую скорость агрегации.
Вопрос: Какие метрики следует использовать для оценки производительности ClickHouse?**
Важно измерять latency, QPS, SLA, throughput, а также показатели использования CPU, disk I/O и сетевого трафика. Мониторинг должен соответствовать реальным требованиям бизнеса и регуляторным ограничениям.
Вопрос: Какие практики помогают снизить риск эксплуатации ClickHouse в больших кластерах?**
Регулярная проверка планов выполнения, мониторинг задержек и репликаций, настройка параметров параллелизма и кэширования, проведение стресс-тестов и резервного копирования. Планирование резервирования и тестирования сценарием отказа также критично.
Стратегически важной остается последовательность перехода от общего к частному: от концепций архитектуры и теоретических основ к практическим кейсам, внедрению в бизнес-процессы и регуляторным основаниям. В результате формируется целостная методология построения аналитических систем на базе ClickHouse, способная выдерживать современные требования к масштабируемости, точности и регуляторному комплаенсу.


