

Visiology ДанКо: новое поколение аналитического движка для корпоративной BI-аналитики
Почему BI-рынок перестал устраивать подход «дашборд поверх SQL»
Еще несколько лет назад корпоративная аналитика в большинстве компаний строилась по достаточно прямолинейной схеме. Существовало хранилище данных, команда BI-разработчиков, SQL-разработчики, ETL-процессы и витрины данных. BI-система в этой архитектуре зачастую выполняла роль визуального слоя: подключалась к готовым данным и отображала их в виде отчетов и дашбордов.
На практике такая модель работала далеко не идеально.
Каждое новое измерение, показатель или бизнес-правило превращалось в задачу для DWH-команды. Бизнес зависел от ИТ, ИТ — от сроков разработки, а аналитики часто оказывались в ситуации, когда даже небольшое изменение логики KPI требовало изменения SQL-кода, пересборки витрин и регрессионного тестирования.
Особенно болезненно это проявилось в крупных проектах импортозамещения Power BI, Tableau, Qlik и Cognos. Компании хотели не просто «нарисовать похожие графики», а сохранить привычную скорость аналитики, self-service-подход и возможность работать с данными без постоянного участия дата-инженеров.
Именно в этой точке российский рынок начал двигаться в сторону аналитических движков нового поколения — решений, которые находятся между BI и DWH и способны взять на себя существенную часть вычислительной и семантической нагрузки.
Одним из наиболее заметных шагов в этом направлении стал переход платформы Visiology от старого движка ViQube к новому аналитическому ядру ДанКо (Данные Компании).
Что такое ДанКо и почему это не просто замена ViQube
Если смотреть поверхностно, может показаться, что ДанКо — это просто новая версия встроенной базы данных Visiology. Однако архитектурно это существенно более глубокое изменение.
Ранее в платформе использовался движок ViQube — собственная многомерная аналитическая база, ориентированная на OLAP-подход и работу с бизнес-измерениями и показателями. В Visiology 3.x вендор фактически полностью переработал вычислительное ядро, заменив ViQube на новый аналитический движок ДанКо, который отличается как по внутренней архитектуре, так и по подходу к обработке данных.
Ключевая идея ДанКо состоит в том, чтобы убрать из аналитического процесса лишнюю зависимость от сложной инженерной подготовки данных и позволить аналитикам быстрее работать с бизнес-логикой.
Проще говоря, если раньше для многих задач требовалась предварительная подготовка витрин, то теперь часть вычислений, семантики и преобразований переносится ближе к BI-уровню.
Это особенно важно в среде, где скорость изменений становится критичным фактором: ассортимент обновляется ежедневно, бизнес-правила KPI меняются ежемесячно, а требования к отчетности могут пересматриваться буквально каждую неделю.
Архитектура ДанКо: как устроен новый аналитический слой
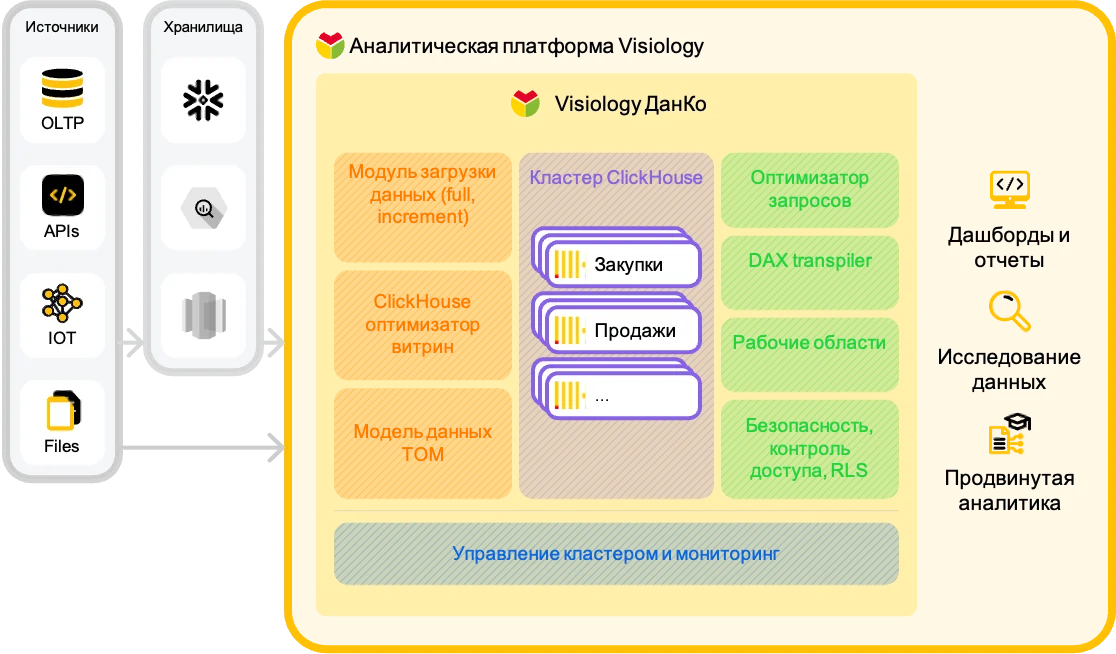
С технической точки зрения ДанКо нельзя корректно назвать просто in-memory-движком или просто встроенным DWH. Это скорее специализированный аналитический слой, который объединяет в себе несколько функций одновременно:
- вычислительное ядро;
- аналитическое хранилище;
- семантический слой;
- механизм self-service-моделирования;
- систему управления доступом и безопасностью.
В основе ДанКо лежит глубоко оптимизированная под аналитические сценарии архитектура, построенная на базе ClickHouse, но существенно адаптированная под задачи BI-нагрузок и вычислений внутри платформы Visiology. Вендор отдельно подчеркивает, что речь идет не о «голом ClickHouse», а о переработанном аналитическом стеке с собственной логикой оптимизации загрузки, хранения и обработки данных.
Внутри ДанКо присутствуют несколько важных компонентов.
Formula Engine — аналитическое сердце платформы
Ключевую роль играет Formula Engine — сервис, отвечающий за выполнение аналитических вычислений, обработку DAX-выражений, управление моделью данных и выполнение аналитических запросов. Именно здесь реализована логика вычисляемых показателей, кэширование запросов и управление бизнес-семантикой.
Для компаний, мигрирующих с Microsoft Power BI, наличие поддержки DAX является особенно важным фактором.
Фактически это означает, что привычная логика расчета KPI, временных сравнений, накопительных итогов, ABC/XYZ-анализа, сложных мер и контекстных вычислений может быть сохранена без полного переписывания аналитической логики.
Для бизнеса это снижает риски миграции.
Для ИТ — уменьшает объем ручной переработки расчетов.
Для аналитиков — снижает порог входа.
Визуальная семантическая модель
Еще одна важная особенность ДанКо — визуальная семантическая модель.
На практике это означает, что бизнес-сущности, показатели и связи между объектами можно описывать в понятной графической модели, а не исключительно через SQL-код.
Это особенно важно в enterprise-проектах, где аналитическая логика постепенно становится сложнее, а количество KPI исчисляется сотнями или тысячами.
При отсутствии семантического слоя организации обычно сталкиваются с так называемой «войной цифр», когда разные подразделения считают один и тот же показатель по-разному.
Например:
- EBITDA у финансов;
- EBITDA у коммерческого блока;
- EBITDA у генерального директора.
Формально показатель называется одинаково, но методика расчета отличается.
ДанКо позволяет централизовать подобную бизнес-логику внутри аналитической модели и сократить риск расхождения показателей.
Автоматический оптимизатор запросов
Отдельный интерес представляет встроенный оптимизатор запросов.
В классических BI-проектах производительность зачастую становится головной болью. При росте объемов данных появляются:
- долгие открытия дашбордов;
- проблемы с DirectQuery;
- неоптимальные join-операции;
- перегрузка DWH.
В ДанКо вендор делает акцент на автоматическую оптимизацию запросов и интеллектуальную работу с хранением данных. Это должно снижать зависимость от ручной SQL-оптимизации и помогать сохранять высокую производительность даже на больших объемах данных.
Конечно, как и в любой enterprise-архитектуре, магии здесь нет: при сложной модели данных и неудачной логике KPI все равно потребуется архитектурная проработка.
Однако сама идея переноса части оптимизации внутрь аналитического движка выглядит логичной и соответствует мировому тренду на semantic compute layer.
ДанКо и DWH: конкурент или союзник?
Один из наиболее частых вопросов заказчиков звучит так:
«Если есть ДанКо — нужен ли вообще DWH?»
Короткий ответ: зависит от зрелости компании.
В небольших и средних проектах ДанКо действительно способен закрывать значительную часть аналитических задач без полноценного корпоративного хранилища.
Это особенно актуально для:
- быстрого запуска BI;
- импортозамещения;
- пилотных проектов;
- компаний с ограниченной зрелостью data engineering;
- распределенных организаций, где данные находятся в десятках источников.
В таких сценариях ДанКо способен выступать как самостоятельный аналитический контур с собственной загрузкой данных, инкрементальным обновлением и CDC-механизмами.
Однако в крупных enterprise-ландшафтах — особенно с большим количеством источников, MDM, Data Governance и десятками доменов данных — корпоративное DWH остается фундаментом.
В подобных случаях ДанКо обычно становится не заменой DWH, а ускоряющим аналитическим слоем поверх него.
Мы в проектах системной интеграции чаще рассматриваем ДанКо именно в такой роли: как semantic-driven вычислительный слой, который позволяет ускорить time-to-dashboard и снизить нагрузку на команды DWH.
Когда ДанКо особенно интересен
На практике наиболее сильные сценарии использования ДанКо выглядят так.
Импортозамещение Power BI
Поддержка DAX, похожая логика моделирования и знакомая аналитическая парадигма делают Visiology одной из наиболее естественных платформ для перехода с Power BI. Многие вычисления можно переносить быстрее, чем при миграции на альтернативные BI-решения без DAX-подхода.
Быстрый запуск корпоративной BI
Компании часто сталкиваются с парадоксом: BI нужен уже сейчас, а полноценное DWH будет строиться 12–24 месяца.
ДанКо позволяет сократить этот разрыв и быстрее запускать аналитические сценарии.
Self-service-аналитика
Когда бизнес-подразделения хотят самостоятельно работать с данными, изменять показатели, собирать аналитику без постоянной очереди в ИТ — ДанКо может существенно повысить скорость изменений.
Высокие аналитические нагрузки
Благодаря архитектуре, ориентированной на большие объемы данных, ДанКо подходит для сценариев с десятками миллиардов строк и тысячами пользователей, особенно при корректно выстроенной модели данных.
Что важно учитывать до внедрения
При этом было бы неправильно рассматривать ДанКо как «волшебную кнопку BI».
Успех проекта все равно определяется рядом факторов:
Качеством модели данных. Плохая бизнес-логика не становится хорошей только потому, что появилась новая платформа.
Зрелостью процессов. Если показатели постоянно меняются хаотично, self-service быстро превращается в хаос.
Архитектурой интеграции. Нужно заранее определить роль ДанКо: временный слой, permanent semantic layer или часть корпоративного DWH-ландшафта.
Governance-подходом. Self-service без контроля обычно приводит к расхождению KPI.
Наш взгляд как системного интегратора
С нашей точки зрения, главный смысл появления ДанКо — это переход Visiology от модели «BI-витрина» к более зрелой концепции аналитической платформы.
Рынок постепенно уходит от ситуации, когда BI — это просто красивые графики поверх SQL.
Сегодня бизнес ожидает от платформы большего:
- ускорения time-to-insight;
- снижения зависимости от дата-инженеров;
- управляемой self-service-аналитики;
- работы с большими объемами данных;
- быстрой миграции с зарубежных решений;
- прозрачной бизнес-семантики KPI.
Именно в этом контексте ДанКо выглядит одним из наиболее интересных технологических шагов российского BI-рынка последних лет.
Но, как и любая enterprise-технология, максимальный эффект он показывает не сам по себе, а в правильно спроектированной архитектуре — когда заранее определены роль DWH, место semantic layer, правила Data Governance и стратегия развития корпоративной аналитики.


