
BI Consult Desktop Logo BI Consult Mobile Logo
  • Russian BI Исследование российских bi
  • Перейти на Fine BI
  • Контакты
  • +7 812 334-08-01
    +7 499 608-13-06
  • Отправить сообщение
  • Главная
  • Продукты Эксперт-BI
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Сельское хозяйство
    • Энергетика
    • FMCG
    • Девелоперы
    • Маркетплейсы
    • Пищевая промышленность
    • Фармацевтика
    • Построение Data Platform
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и FP&A
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • IBP
    • ИТ (CIO)
    • Закупки
  • Платформы
    • Системы бизнес-анализа (BI)
    • Интегрированное бизнес-планирование (IBP)
    • Хранилища данных (DWH / Lakehouse)
    • Каталоги данных (Data Catalog)
    • Системы ETL и ELT
    • AI / Исскуственный интеллект
    • Шина данных (ESB)
    • Система управления мастер-данными (MDM)
    • Семантический слой
  • Услуги
    • Переход на отечественные BI и DWH системы
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений и DWH
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Курсы
    • Учебный курс Информационная грамотность (Data Literacy)
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Greenplum
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt (Data Build Tool)
  • Компания
    • Руководство
    • Новости
    • Клиенты
    • Карьера
    • Скачать
    • Контакты

BI

  • FineBI
  • FineReport
  • FineDataLink
  • FineChatBI (FineAI)
  • Коннекторы данных из 1С в BI
  • Airflow / Nifi
  • Visiology
  • PIX BI
  • Modus BI
  • Yandex.DataLens
  • Open-source BI: Superset/Metabase
  • Luxms BI
  • AW BI + Alpha BI
  • FlyBI + Форсайт. Аналитическая Платформа
  • Loginom
  • Триафлай
  • AI / Исскуственный интеллект
  • Optimacros
  • Навигатор BI
  • Семантический слой

СУБД

  • Arenadata
  • ClickHouse
  • Greenplum
  • Postgres Professional
  • TData

Другое

  • Построение Data Platform
    • Аналитическое хранилище данных
    • Data Lake и Data Engineering
    • Подробнее про Data Lake
    • Внедрение Lakehouse
      • Apache Doris
      • StarRocks
      • Trino
    • Миграция витрин из пропиетарных DWH на новый стек
    • Учебный курс "Современная архитектура хранилища данных"
Главная » Курсы по системам бизнес-анализа и методологии » Учебный курс Современная архитектура хранилища данных » Введение в систему CDC — эффективный способ репликации транзакционных данных в озеро данных

Введение в систему CDC — эффективный способ репликации транзакционных данных в озеро данных

Спрос на новые эффективные механизмы репликации транзакционной базы данных в аналитическую базу данных в режиме реального времени постоянно растет. Происходит это по следующим причинам:

  • Традиционные реплики транзакционной базы данных не подходят для аналитических запросов (OLAP);
  • Они не могут быть масштабированы для долгосрочных аналитических запросов (OLAP);
  • Перекрестное соединение баз данных не всегда легко осуществить;
  • Запросы OLAP могут мешать процессам OLTP, что может повлиять на поток транзакций.
 

Компании постоянно пытаются решить все вышеперечисленные проблемы, перебирая самые разные способы. Один из общепринятых подходов заключается в планировании пакетных заданий для периодической загрузки данных в озеро/хранилище данных. Однако это не совсем подходит для  случаев, близких к работе в режиме реального времени, поскольку:

  • Свежесть: для работы в режиме реального времени потребителям данных необходимы только самые свежие данные. Обычно задержка обработки данных составляет 12/24 часа, что  неприемлемо для real-time ситуаций;
  • Производительность: хранение большого количества небольших файлов влияет на задержку чтения;
  • Стабильность: для систем загрузки, основанных на использовании моментальных снимков, необходимо решение, поддерживающее непрерывные операции обновления и удаления для существующих данных.


Чтобы решить данные задачи, в  Swiggy используется система CDC (захват изменений данных от англ. Change Data Capture), структура поэтапной обработки данных, обеспечивающая непрерывное функционирование важных для бизнеса конвейеров данных с низкой задержкой чтения и высокой эффективностью.


Мотивирующий прецедент: поздние обновления и удаления

Рассмотрим жизненный цикл заказа Swiggy. Как правило, заказ поступает из системы предварительных заказов (витрина магазина), систем выполнения и доставки, а также  из систем, связанных с процессами после осуществления доставки (поддержка клиентов). В то время, как большинство обновлений заказов выполняется в течение часа, каждую минуту мы получаем новые заказы и кучу обновлений для существующих заказов. Некоторые из них (например, обновления, связанные со службой поддержки клиентов, сверкой компенсаций и т. д.) могут появиться и для заказов, созданных за последние 15 дней.

Общая идея состоит в том, чтобы хранить эти данные об обновлениях в разных разделах (например, разделы данных по дате, часу или городу). Разделы значительно упрощают управление большими объемами информации. Основная проблема заключается в обновлении устаревших разделов, поскольку оно включает в себя:

  • Поиск правильного раздела и правильного файла, в котором находятся данные, требует сканирования большого объема данных;
  • Обеспечение согласованности данных при обновлении файла затруднено.


Что такое CDC?

CDC (Change Data Capture) - это паттерн проектирования, который фиксирует все изменения, происходящие с данными, вместо того, чтобы обрабатывать весь набор данных.

Вместо того, чтобы копировать всю базу данных, с помощью CDC фиксируются только те данные, которые изменились в базе данных, эти  же изменения применяются  и к аналитической базе данных (в том же порядке), чтобы обеспечить синхронизацию обеих баз данных.

Это более масштабируемое решение, поскольку имеет дело только с изменениями данных. Например, рассмотрим случай таблицы с 1 миллиардом записей и несколькими миллионами изменений в день. Данный подход позволяет нам применять только измененные записи (~ миллионы) вместо ежедневного копирования всего набора данных (~ миллиарды записей).


Подход, основанный на CDC

Основная идея подхода, основанного на CDC, заключается в применении изменений на аналитической стороне процесса по аналогии с тем, как это происходит в транзакционной базе данных. Чтение всего набора данных и перезапись в целевом хранилище заменяется непрерывным и поэтапным применением изменений в зависимости от типа операции (вставка/обновление/удаление).  Нагрузка на исходную систему при этом значительно снижается, поскольку размер журналов транзакций очень мал, а сам процесс осуществляется в несколько этапов.

Решение, основанное на CDC, позволяет легко, эффективно и экономично решить вариант использования запаздывающих обновлений, упомянутый выше. Всякий раз, когда система сталкивается с обновлениями, она выбирает только те файлы, которые необходимо обновить, и в итоге обновляет только определенные записи.

Подход к построению системы репликации в реальном времени включает в себя два основных этапа:

  • Создание копии текущей транзакционной базы данных;
  • Применение текущих изменений к этой копии в том же порядке, в котором они появляются в транзакционной базе данных.


Важной частью данного подхода является корректность — захват «всех» изменений из транзакционной базы данных. Этот процесс должен легко восстанавливаться после сбоя, при этом никакие данные не должны быть потеряны. Если хотя бы одно событие потеряно, данные будут несогласованными. Другим ключевым моментом является время начала данного процесса. Если мы начнем процесс сбора изменений после создания реплики транзакционной базы данных, мы потеряем события, которые происходят во время процесса начальной загрузки. Поэтому лучше сначала запустить процесс CDC, а затем - процесс начальной загрузки.

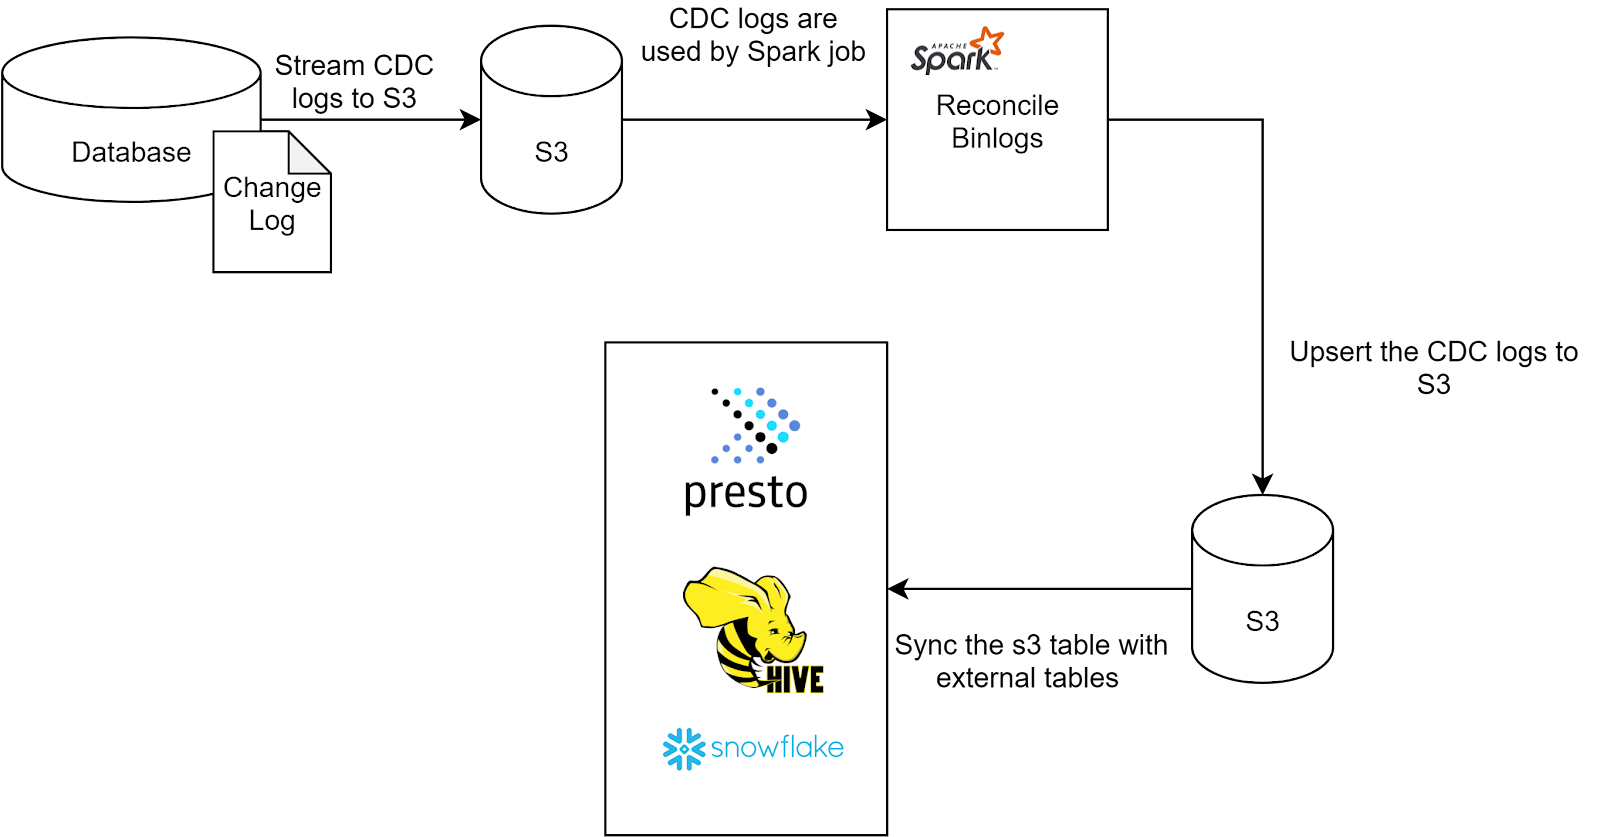
Когда у нас есть текущие записи базы данных, мы используем метод поэтапного обновления для чтения данных из источника и применения изменений (вставка/обновление/удаление) в соответствии с тегами в исходных данных на основе поля первичного ключа.

Наконец, чтобы выполнить запрос к этому набору данных, мы синхронизируем схему таблицы и разделы с метахранилищем Hive и метаданными Snowflake.

Компоненты высокого уровня и поток данных при этом выглядят так:
 

Аргументы за и против использования CDC вместо массового извлечения и загрузки данных

Хотя CDC имеет ряд преимуществ, он сопряжен с определенными затратами. В данной статье мы обсудим издержки с точки зрения минусов данного подхода.

Аргументы за:

  • Распределенная нагрузка — нагрузка распределена в течение суток. Извлечение и загрузка данных разбивается на небольшие наборы пошаговых изменений, что делает прием простым и эффективным;
  • Масштабируемость — система масштабируется для поддержки ряда источников, ее очень легко масштабировать в различных точках системы, таких как CDC replicator, S3, задания Spark и т. д.;
  • Быстрая и эффективная инструкция UPSERT — поскольку речь идет о пошаговых изменениях, время на upsert очень мало по сравнению с массовой вставкой/перезаписью. Это также эффективно, потому что операция происходит постепенно;
  • Доступность - настройка доступности важна для случаев использования, близких к реальному времени. Система CDC предоставляет пользователю свободу выбора требований к задержке. В зависимости от требований система определяет интервал опроса/частоту обновления;
  • Согласованность — одним из ключевых принципов этой системы является согласованность, для ее достижения мы использовали надежную, отказоустойчивую и легко восстанавливаемую систему, которая гарантирует 100% согласованность данных;
  • Стоимость — стоимость работы системы конкурентоспособна по сравнению с процессом массового извлечения и загрузки. Стоимость оптимизируется за счет использования простых инфраструктурных компонентов, таких как lambda, DynamoDB, AWS DMS, S3, общие кластеры Spark, облегченные сервисы с использованием Golang. Значительная экономия средств достигается за счет удаления реплики чтения MySQL из источников;
  • Легкое восстановление — процесс восстановления после сбоя очень прост и удобен. В случае сбоев система запускается с последней контрольной точки.


Аргументы против:

  • Сложность : CDC – более сложная система по сравнению с Извлечением и Загрузкой;
 

Ограничения:

  • Зависимость от ключа записи: Upsert последних обновлений поддерживается только для набора данных, который содержит ключ записи.


Узнать стоимость решенияЗапросить видео презентацию

← Предыдущая статья
Ценность виртуализации данных в Data Mesh
Следующая статья →
Data Mesh: что это такое и для чего он нужен инженерам
Запросить видео презентацию Запросить доступ к демо стенду online Узнать стоимость лицензий

Задать вопрос

loading...

Решения

Анализировать ФинансыУвеличивайте ПродажиОптимальный Склад и ЛогистикаМаркетинговые Метрики

Клиенты
  • ООО "Интернэшнл Ресторант Брэндс" – это крупнейший франчайзинговый партнер компании Yum! Brands Russia & CIS в России, отвечающий за рост и развитие бренда KFC на территории РФ. На сегодняшний день у компании более 350 ресторанов. Ежедневно в рестораны приходит 200 000+ гостей.

  • ЭГИС - международная фармацевтическая компания, основанная в 1907 году в Венгрии. Компания имеет представительства более чем в 60 странах мира, в том числе в России. Компания ЭГИС является одним из ведущих производителей дженерических лекарственных средств в Центральной и Восточной Европе. Её деятельность охватывает все звенья производственно-сбытовой фармацевтической цепочки.

  • Торгово-производственному холдингу ТБМ, специализирующемуся на поставке комплектующих и фурнитуры для производства окон, дверей, стеклопакетов и мебели, был необходим аналитический инструмент для выявления узким мест и поиска зон роста бизнеса и, как результат, оптимизации процессов. Добиться этого можно было, только внедрив data-driven подход.

  • ПАО «Транснефть» – крупнейшая российская нефтепроводная компания. «Транснефть» обеспечивает транспортировку более 85% добываемых в России нефти и нефтепродуктов.

  • Решения
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Энергетика
    • Фармацевтика
  • Услуги
    • Переход на отечественные BI и DWH
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Техническая поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Платформы
    • FineBI
    • FineReport
    • FineDataLink
    • Коннекторы данных из 1С в BI
    • Airflow + NiFi
    • Visiology
    • Luxms BI
    • Modus BI
    • PIX BI
    • Arenadata
    • ClickHouse
    • Greenplum
    • Postgres Professional
    • Open-source BI: Superset/Metabase
    • Loginom
    • Yandex.DataLens
    • AI / Исскуственный интеллект
    • Optimacros
    • Шины данных
  • Курсы
    • Учебный курс Информационная грамотность
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt
  • Функциональные решения
    • Создание Data Lake
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и прогнозная аналитика
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • Сквозная аналитика
  • Компания
    • О нас
    • Руководство
    • Новости
    • Клиенты
    • Скачать
    • Контакты
    • Политика конфиденциальности
RutubeVkontakteLinkedInYouTube
ООО "Би Ай Консалт",
ИНН: 7811437757,
ОГРН: 1097847154184
199178, Россия,
Санкт-Петербург,
6-ая линия В.О., Д. 63, 4 этаж
Тел: +7 (812) 334-08-01
Тел: +7 (499) 608-13-06
E-mail: info@biconsult.ru


×

Пользуясь сайтом, вы соглашаетесь с использованием cookies и политикой конфиденциальности.