

Data Mesh: что это такое и для чего он нужен инженерам
Это перевод статьи о новом подходе к построению архитектуры данных Data Mesh с помощью lakeFS — системы управления версиями данных с открытым исходным кодом, которая преобразует хранилище объектов в Git-подобные репозитории. Разбираем, что такое Data Mesh, суть этого подхода и как с его помощью повысить эффективность работы с данными.
История данных и их аналитики
Компании стали нуждаться в анализе данных, как только в обиход вошли первые компьютеры. В 1980-х компании создавали хранилища на основе реляционных баз данных, используя их в качестве систем принятия решений. Чем быстрее и больше разнообразной информации генерировали компании, тем очевиднее становились ограничения реляционных баз.
С приходом 2000-х мы вступили в эпоху больших данных. Появились новые решения, предназначенные для анализа больших объемов разнообразных данных, генерируемых с огромной скоростью. В современных паттернах архитектуры и аналитики хранилища объединились с новыми технологиями для работы с большими данными.
Однако при развертывании таких аналитических решений у компаний все еще возникали трудности. Архитектура оставалась монолитной, и одна команда всегда выступала в качестве поставщика платформы и занималась интеграцией данных. Такая система подходит для небольших организаций с высокой степенью централизации, а в крупных компаниях из-за такого подхода сразу же стали появляться длинные очереди за услугами интеграции и аналитических решений. В этом контексте централизация оказалась слабым местом крупного бизнеса.
В больших компаниях возлагать ответственность за подключение всех источников данных на одну команду чревато провалом. Часто эти источники децентрализованы и географически распределены, что затрудняет даже банальный поиск ответственных. Подобный подход просто не работает. И тут на помощь приходит новая архитектура, которая называется Data Mesh.
Что такое Data Mesh
Data Mesh, что дословно можно перевести как «сеть данных», — это децентрализованный гибкий подход к работе распределенных команд и распространению информации. Главное в нем — междисциплинарные команды, которые публикуют и потребляют Data-продукты, благодаря чему существенно повышают эффективность использования данных.
Понятие Data Mesh как архитектуры создания распределенных пайплайнов данных впервые ввела в обиход Жамак Дегани в статье How to Move Beyond a Monolithic Data Lake to a Distributed Data Mesh. Традиционно архитектура данных монолитна. Потребление, хранение, преобразование и вывод управляются через одно центральное хранилище (как правило, озеро данных). Data Mesh же позволяет упростить работу с распределенными пайплайнами, поддерживая отдельных потребителей, рассматривающих данные как продукт.

Но что связывает домены и соответствующие активы данных? Это уровень универсальной взаимной совместимости, на котором применяется одинаковая инфраструктура, синтаксис и стандарты данных.
Архитектура Data Mesh: суть концепции
Для понимания Data Mesh нужно знать четыре основных понятия:
Домены данных. Это понятие пришло из парадигмы разработки ПО Domain Driven Design (DDD). Его используют для моделирования сложных программных решений. В Data Mesh домен данных — это способ определить, где начинаются и заканчиваются корпоративные данные. Границы зависят от компании и ее потребностей. Иногда разумно моделировать домены, учитывая бизнес-процессы или исходные системы.
Data-продукты. Важный компонент Data Mesh, связанный с применением к данным продуктового мышления. Чтобы Data-продукт работал, он должен приносить пользователям пользу в долгосрочной перспективе и быть пригодным к использованию, ценным и ощутимым. Он может быть реализован как API, отчет, таблица или датасет в озере данных.
Платформа самообслуживания. Data Mesh строится экспертами широкого профиля, которые создают универсальные продукты и управляют ими. В рамках этого подхода вы будете опираться на децентрализацию и согласование с бизнес-пользователями, которые разбираются в предметной области, какое значение имеют те или иные данные. При этом у вас будут специализированные команды, которые разрабатывают автономные продукты, не зависящие от центральной платформы. Поэтому не получится использовать сложные и узкоспециализированные инструменты для эксплуатации фундамента платформы на основе Data Mesh.
Федеративное governance. Когда вы переходите на распределенную Data-платформу самообслуживания, нужно сосредоточиться на Governance. Если не уделять ему внимание, вы скоро окажетесь в ситуации, когда во всех доменах применяются разрозненные технологии, а данные дублируются. Поэтому и на уровне платформы, и на уровне данных нужно внедрить автоматизированные политики.
Архитектура Data Mesh: показания к применению
Data-Mesh-решения позволяют компенсировать недостатки монолитных озер данных. Владельцы данных получают большую автономность и гибкость, открываются новые возможности для экспериментов, инноваций и совместной работы. В то же время снижается нагрузка на команды по обработке данных, задачи каждого потребителя решаются на местах в рамках единого пайплайна.
В то же время благодаря платформе самообслуживания команды по обработке данных получают в свое распоряжение современные технологии для работы с данными с минимальными инвестициями (либо вообще без них). Кроме того, это универсальный и часто автоматизированный подход к стандартизации данных, Product Lineage и метрикам качества (их сбору и совместной работе с ними). В совокупности эти преимущества можно рассматривать как достойную конкуренцию традиционным архитектурам данных, которые страдают от отсутствия стандартизации на уровне источников и потребителей данных.
Эти преимущества всего лишь верхушка айсберга. Вот еще несколько аргументов в пользу Data Mesh.
Расходы ниже, а скорость выше. До сих пор организации пытались обрабатывать объемные данные разных типов и сценариев использования, опираясь на централизованные решения. Но централизация подразумевает импорт или доставку данных с периферии в центральное озеро для последующего анализа. Это долго и дорого. Работа централизованной команды может стать узким местом компании, ведь данные создают множество сотрудников, а централизованной команде нужно расставить приоритеты и решить, с каких задач начинать.
Data Mesh помогает ускорить анализ. В распределенной архитектуре мы рассматриваем данные как продукт, у которого есть владелец в лице отдельного бизнес-подразделения. Благодаря такой модели команды могут получить доступ и анализировать «периферийные» данные быстрее, чем когда-либо ранее.
Гибкость для бизнеса. Объемы данных продолжают расти, и модель централизованного управления не справляется с увеличением масштабов. Гибкость бизнеса снижается, так как на извлечение пользы из данных и формулировку выводов уходит слишком много времени.
Data Mesh решает эту проблему, возвращая крупному бизнесу гибкость и быстроту реакции на перемены. Из центра она делегирует владение датасетами доменам — отдельным командам или бизнес-пользователям. Это сокращает дистанцию между тем или иным фактом и его потреблением или процессом анализа.
Качественный комплаенс. В ряде случаев организациям трудно соблюдать требования к конфиденциальности и месту расположения данных, которые хранятся в странах ЕС, но используются, например, в Северной Америке. Соблюдение этих требований — длительный и трудоемкий процесс, из-за которого периодически возникают задержки критически важной бизнес-аналитики, необходимой для сохранения конкурентных преимуществ.
Data Mesh обеспечивает уровень связи, открывающий техническим и нетехническим пользователям непосредственный доступ к датасетам с возможностью выполнять запросы по месту нахождения информации. А также позволяет избежать их дорогостоящей передачи и требований к размещению данных в том или ином регионе.
Проблемы архитектуры Data Mesh
При внедрении Data Mesh нужно быть готовым к появлению некоторых проблем. Вот самые важные из них.
Ограничения бюджета
Финансовой жизнеспособности проекта по созданию новой платформы угрожает несколько факторов. В частности, это неспособность платить за инфраструктуру, разработку дорогостоящих приложений, создание Data-продуктов или техобслуживание таких систем.
Если команде по развитию платформы удастся создать инструмент, который закрывает техническую брешь, но объем данных и сложность Data-продуктов продолжат расти, цена решения может оказаться слишком высокой.
Совместная работа доменов и команды по развитию платформы
С внедрением Data Mesh у доменов появляется много дополнительной работы. Ведь они привыкли быть просто пользователями отчетности, а теперь их надо как-то убедить, что овчинка стоит выделки. И когда они согласятся, придется координировать с ними важные релизы.
Например, из-за доработки платформы иногда могут возникать радикальные изменения. Что, если такое произойдет у одного домена как раз в разгаре тестирования нового приложения? В этом случае они могут сорвать вам сроки на несколько месяцев.
Набор навыков по управлению данными
Отсутствие такого набора навыков — серьезное препятствие для компаний, стремящихся перейти на методологию Data Mesh. При децентрализации дата-менеджмента домены должны заняться этим самостоятельно. Действительно ли такое решение лучше центральной команды, которая обеспечивает интеграцию? Ответ на этот вопрос зависит от отраслевой специализации бизнес-доменов и происхождения данных.
Нехватка технических навыков
Делегирование доменам полного владения данными означает, что они должны заниматься проектом серьезно. Возможно, они наймут новых сотрудников или сами пройдут обучение, но не исключено, что вскоре требования окажутся для них непосильными. Когда производительность кардинально снизится, то там, то здесь будут постоянно появляться проблемы. Никакие инструменты здесь не помогут, потому что для решения проблем нужны знания в области дата-инжиниринга.
Мониторинг Data-продуктов
Команде нужны соответствующие инструменты для создания Data-продуктов и мониторинга того, что происходит в компании. Возможно, некоторым доменам не хватает глубокого понимания технических метрик и их влияния на рабочие нагрузки. Команде по развитию платформы нужны ресурсы, позволяющие выявлять и решать проблемы, например, чрезмерной нагрузки или неэффективности.
Виртуализация и дублирование данных
Сегодня сотрудники стремятся объединять данные из разных источников и не хотят подчиняться ограничениям «одного узла». Для этого существует два способа: виртуализация и дублирование данных. У каждого из них есть недостатки.
Виртуализация создает семантическую модель за пределами источников данных без их физического переноса в другую БД. Она разбивает запросы пользователей, передает части запроса к источнику и собирает результаты в единое целое.
Для дублирования нужно, чтобы команды обрабатывали данные, передаваемые от источников в приложения. Это может привести к резкому росту счетов на облачные сервисы. И мы говорим не только о стоимости хранения, но и о возможных расходах на исходящий трафик.
Реализация: как преобразовать озеро данных в сервисы Data Mesh
С помощью инструмента lakeFS команды по развитию инфраструктуры данных могут предоставлять отдельные сервисы Data Mesh с собственным озером данных с историей версий через обычное объектное хранилище. В операциях Git-Like, доступных в lakeFS, есть все необходимые функции: Data Governance, непрерывный деплоймент и другие.
Этапы реализации Data Mesh
Здесь перед нами стоит цель создать репозиторий lakeFS для каждого сервиса Data Mesh. Таким образом, каждый сервис будет работать изолированно, публикуя высококачественные данные для других сервисов или потребителей.
- Защитите имеющиеся данные в объектном хранилище, установив разрешения только на чтение.
- Создайте репозиторий в lakeFS для каждого сервиса данных.
- Загрузите уже имеющиеся исходные и выходные данные. Это операция на уровне метаданных — на самом деле транспортировка не происходит. Если некоторые датасеты используются для разных сервисов, они размещаются в нескольких репозиториях.
- Напишите для каждого сервиса скрипт онбординга для каждого сервиса из репозиториев, которые предоставляют исходные данные. При каждом запуске этого скрипта должен выполняться новый коммит в главной ветке, с изменениями и обновлениями исходных данных.
Теперь у вас все готово! У каждого сервиса в изолированном режиме есть необходимые данные в собственном репозитории. Он может перемещаться между разными версиями в коммите. Главная ветка репозитория выступает в качестве единого источника истины.
Чтобы проанализировать данные сервиса, нужно запустить процессы, потребляющие исходные данные и выдающие результат в репозитории lakeFS. Новый результат также передается в главную ветку, при этом создается новая версия, которую могут использовать остальные.
Теперь пора настроить среду разработки и CI/CD для каждого сервиса Data Mesh. Именно это обеспечит эффективность работы и высокое качество результатов.
Среда разработки для сервиса Data Mesh
Для грамотной разработки Data Mesh нам нужна среда разработки, которая позволяет вносить изменения в код сервиса, инфраструктуру или изолированные данные. Можно создать ветку из главной ветки репозитория и назвать ее dev-environment. Merges, направляемые в нее из главной ветки, позволяют экспериментировать с любой ее версией. Можно открыть ветку из dev-environment для тестирования на этапе разработки и закрыть ее сразу после окончания эксперимента. Можно последовательно проводить несколько экспериментов в одной ветке, используя Revert. Или экспериментировать одновременно в нескольких ветках, сравнивая результаты разных экспериментов.
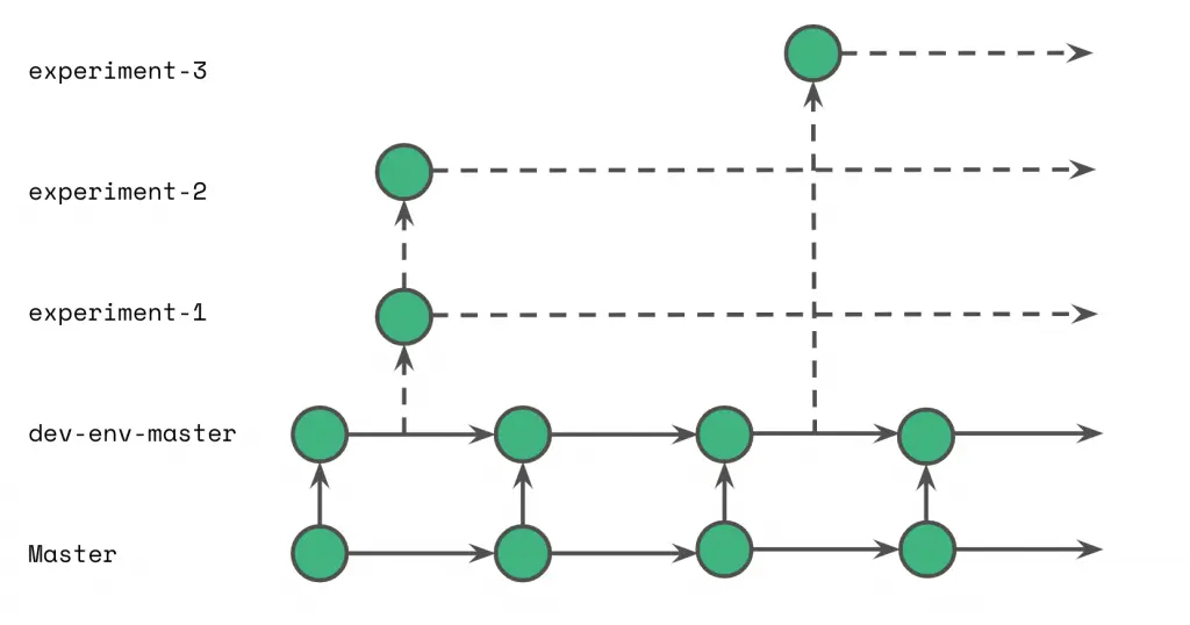
Есть также подробное руководство по созданию среды дата-разработки с помощью lakeFS.
Непрерывная интеграция данных в репозитории
Подключая новые источники данных или обновляя уже имеющиеся в репозитории, важно гарантировать соответствие спецификациям качества и техническим спецификациям. Когда мы описывали настройку репозитория для сервиса Data Mesh, мы предложили обновлять данные онбординга из исходных репозиториев прямо в главную ветку.
Это не очень хорошая практика, ведь данные могут каскадом попасть в Data-пайплайны сервиса еще до того, как вы успеете проверить их качество. Вам же не нужны проблемы с качеством, простои или долгое восстановление? Вот что мы предлагаем в качестве альтернативы:
- Лучше создать ветку для приема данных. В идеале у каждого датасета должна быть собственная ветка для приема данных.
- Дайте ей осмысленное название, например daily-sales-data.
- С помощью Pre-merge протестируйте данные и убедитесь, что они соответствуют стандартам качества и передовых методов работы.
- Если тест пройден, можно объединять данные с главной веткой. Если нет, система мониторинга высылает соответствующее уведомление. В случае неудачи у вас будет моментальный снимок репозитория на момент сбоя, и это поможет быстрее установить причину произошедшего. Данные не потеряны, ведь вы не передавали их в главную ветку.
Непрерывный деплоймент данных в репозитории
Назначение этой инфраструктуры — убедиться в высоком качестве данных, предоставляемых другим сервисам или потребителям. Сложный сервис данных может выполнять тысячи небольших заданий за несколько часов. Поэтому нам нужна непрерывно действующая среда развертывания, которая автоматически восстанавливает сервис в случае обнаружения ошибок. Для этого можно объединить контроль версий (lakeFS) с автоматизированным управлением рабочими процессами (Airflow, Dagster или аналоги) и тестовым фреймворком.
Принцип работы:
- Оркестрация запускает DAG в выделенной ветке. Каждое задание выполняется в ветке, созданной из DAG.
- После выполнения задачи инициируется вебхук, который проверяет качество данных.
- Если тест пройден, данные из этого задания автоматически поступают в ветку DAG и начинается следующее задание.
- Если тест не пройден, вебхук создает событие в системе оповещения со всеми релевантными данными. DAG перестает работать.
- Когда выполнение завершается успешно, данные поступают обратно в главную ветку. Теперь их можно использовать для других сервисов или экспортировать из объектного хранилища в интерфейс уровня обслуживания.
Главная ветвь каждого репозитория выступает в качестве единого источника проверенной информации. Перед сохранением в ней исходные, промежуточные или выходные данные проверяются. Кроме того, данные тестируются по обе стороны интерфейса.
Заключение
Концепция Data Mesh пришла к нам из передовых методов разработки программного обеспечения, таких как Agile и микроциклы разработки. Перенос этих концепций в область анализа данных сопряжен с рядом трудностей, но, если сделать все правильно, он приносит огромную пользу.
Термин «озеро данных» подразумевает монолитность, но на практике оно реализуется вместе с высокораспределенной технологией, такой как объектное хранилище. Потому команды по развитию платформы могут создавать Data Mesh, образуя изолированные Data-среды для Data-продуктов. Монолит можно разбить на маленькие озера — по одному на каждый продукт.
Чтобы избежать дублирования данных, поверх озера нужен уровень абстракции, который обеспечивается с помощью lakeFS. Таким образом, каждый Data-продукт может использовать собственный репозиторий, а также потреблять данные других репозиториев и передавать в них свои.


