

Архитектура системы CDC

В этой статье мы поговорим об архитектуре данной системы, а также о сложностях, с которыми мы столкнулись при ее построении, и о том, как нам удалось с ними справиться.
Еще раз о системе CDC
CDC (захват изменения данных, с англ. Change Data Capture) - шаблоны разработки ПО для определения измененных данных, позволяющий предпринять действия только с ними, а не со всем набором данных.
Вместо того, чтобы копировать всю базу данных, с помощью CDC фиксируются только те данные в базе данных, которые изменились, и эти же изменения применяются (в том же порядке) к аналитической базе данных, чтобы обеспечить синхронизацию обеих баз данных.
Принципы системы CDC
- Легкость использования
Система должна быть самообслуживаемой и полностью автоматизированной. Внедрение нового варианта использования осуществляется достаточно просто, нужно лишь указать все необходимые сведения в файле конфигурации. Вся сложность предоставления ресурсов и услуг скрыта от конечного пользователя.
- Гибкость системы
Систему можно масштабировать для различных таблиц, вариантов использования, а также для поддержки различных исходных ресурсов. Каждая фаза (CDC, хранение, согласование) процесса может быть масштабирована независимо от нагрузки, без какого-либо влияния на каждый последующий этап.
- Планирование затрат
Для определения вариантов использования обеспечивается полная прозрачность ценообразования и информирование потенциальных пользователей о стоимости использования системы. На основе входных данных система определят приблизительную стоимость каждого варианта использования, что помогает пользователям принять решение о целесообразности инвестирования средств.
- Надежность
Поскольку мы имеем дело с данными, важнейшую роль играет надежность работы системы. Каждый этап процесса гарантирует надежность данных, а также высокую отказоустойчивость, что в целом обеспечивает полноту и правильность использования данных.
Структура системы на высочайшем уровне


Источник
В мире ПО каждое приложение, будь то микросервис или монолит, требует базы данных для сохранения своего определенного состояния. В зависимости от варианта использования и требований для постоянного хранения данных выбирается либо RDBMS, либо база данных NoSQL. Популярными версиями РСУБД являются MySQL и DynamoDB для NoSQL. Эти две базы данных считаются исходными базами данных для обсуждения в данной статье, поскольку на сегодняшний день именно они являются основными транзакционными базами данных, используемыми в Swiggy.
Работа с MySQL
MySQL — это система управления базами данных, которая хранит структурированные наборы данных в отдельных таблицах. Это позволяет пользователям выполнять операции вставки/обновления/удаления данных, а также применять операции DDL (язык определения данных) для модификация структуры таблиц. Подробнее о Mysql читайте здесь.
Работа с двоичными журналами
Двоичный журнал - это коллекция последовательных файлов журнала, сгенерированных MySQL. Эти файлы содержат информацию об изменениях (создание, обновление, удаление), внесенных в данные, присутствующие на сервере MySQL.
Двоичные журналы содержат сведения об операторах/командах, которые обновили данные или потенциально могли бы их обновить (например, UPDATE). Они также фиксируют продолжительность выполнения операторов/команд SQL. Кроме того, эти журналы содержат метаданные, связанные с состоянием сервера, кодом ошибки и т. д.
Цель создания двоичных журналов
Двоичный журнал используется для репликации главного сервера на подчиненный сервер (MySQL) или любой другой целевой объект.
Некоторые процессы восстановления данных используют данные, хранящиеся в файле binlog, для повторного выполнения транзакций с целью восстановления исходного состояния.
Типы двоичных журналов:
- на основе операторов — содержит события, которые привели к модификации данных;
- на основе строк — содержит события, которые описывают изменения, сделанные в конкретных строках.
Пример двоичного журнала на основе строк:
# at 295
#150112 21:40:14 server id 1 end_log_pos 367 CRC32 0x19ab4f0f Query thread_id=108 exec_time=0 error_code=0
SET TIMESTAMP=1421079014/*!*/;
BEGIN
/*!*/;
# at 367
#150112 21:40:14 server id 1 end_log_pos 415 CRC32 0x6b1f2240 Table_map: `test`.`t` mapped to number 251
# at 415
#150112 21:40:14 server id 1 end_log_pos 461 CRC32 0x7725d174 Write_rows: table id 251 flags: STMT_END_F
### INSERT INTO `test`.`t`
### SET
### @1=1 /* INT meta=0 nullable=0 is_null=0 */
### @2=’apple’ /* VARSTRING(20) meta=20 nullable=0 is_null=0 */
### @3=’2022–06–01' /* VARSTRING(20) meta=0 nullable=1 is_null=1 */
# at 461
#150112 21:40:14 server id 1 end_log_pos 509 CRC32 0x7e44d741 Table_map: `test`.`t` mapped to number 251
# at 509
Инструменты CDC читают двоичные журналы и фиксируют операции с данными.
В приведенном выше примере данные на выходе после применения инструментов CDC следующие:
[
  {
    "Op": "Insert",
    "id": 1,
    "name": "apple",
    "date": "2022-06-01",
    "position": "mysql-bin-changelog.000001:461"
  }
]
позиция содержит имя файла binlog и местоположение транзакции в этом файле журнала.
Детали положения зависят от инструмента CDC. В приведенном выше примере фиксируются только имя и местоположение файла. Однако инструменты могут также фиксировать и начальное, и конечное местоположение транзакции, идентификатор транзакции и т. д.
Помимо этого, они также могут захватывать базу данных, таблицу, метку времени, старые и новые данные (в случае обновления), идентификатор сервера, первичный ключ, столбцы первичного ключа и т. д.
Есть несколько инструментов, способных использовать binlog в формате CDC. Например, Maxwell, AWS DMS, Debezium, SpinalTap, Mysql_streamer.
Работа с DynamoDB
DynamoDB – это система управления базами данных класса NoSQL в формате «ключ — значение». Она безсерверная и полностью управляется AWS.
Потоки DynamoDB
AWS предоставляет готовое решение (потоки DynamoDB ) для сбора данных об изменениях для Dynamodb. Поток DynamoDB фиксирует изменения на уровне элемента в любой таблице Dynamodb. Эти модификации фиксируются, как упорядоченная по времени последовательность.
Потребители могут получить доступ к этим изменениям и получить необходимую информацию. Каждое потоковое событие содержит имя события (INSERT/MODIFY/REMOVE), новое изображение (вставленное/обновленное значение), старое изображение (предыдущее значение из события Modify/Remove) и т. д. Подробнее о событиях Вы можете прочитать здесь.
Потоки DynamoDB обеспечивают следующее:
- Однократное появление события в потоке;
- События появляются в том же порядке, что и их фактические модификации;
- Доступность событий почти в реальном времени.
Журналы изменений
Пример журнала изменений:
{
  "Records": [
    {
      "eventID": "dd8bdd8843uh7e1b24b10814913b8f39",
      "eventName": "INSERT",
      "eventVersion": "1.1",
      "eventSource": "aws:dynamodb",
      "awsRegion": "us-east-1",
      "dynamodb": {
        "ApproximateCreationDateTime": 1592475692,
        "Keys": {
          "s_id": {
            "S": "xyz"
          },
          "p_id": {
            "S": "abcde"
          }
        },
        "NewImage": {
          "s_id": {
            "S": "xyz"
          },
          "p_id": {
            "S": "abcde"
          }
        },
        "SequenceNumber": "5027800000000001107762416",
        "SizeBytes": 32,
        "StreamViewType": "NEW_AND_OLD_IMAGES"
      },
      "eventSourceARN": "arn:aws:dynamodb:us-east-1:123456789876:table/test_table/stream/2020-06-18T10:17:37.027"
    }
  ]
}
Согласование данных
Ранее мы уже обсуждали, что для создания в аналитическом хранилище реплики транзакционной БД, близкой к реальному времени, журналы CDC должны быть правильно согласованы. Это очень сложный и важный этап процесса. Непротиворечивость и правильность данных зависят от логики и подхода, применяемых на этапе согласования. Неупорядоченные или поврежденные данные могут повлиять на правильность всей целевой таблицы.
Ключевые сложности данного этапа заключаются в следующем:
- Обеспечение правильной схемы целевой таблицы;
- Обеспечение правильности данных. Потери данных недопустимы. Количество записей должно четко соответствовать источнику, строки должны совпадать;
- Обработка повторяющихся событий в binlog. Повторяющиеся события могут возникать во время восстановления после сбоя инструмента CDC, а также после перезапуска приложения CDC с последней сохраненной контрольной точки. Кроме того, из-за ошибки инструмент CDC также может генерировать повторяющиеся события. Система должна быть в состоянии справиться с этими неблагоприятными сценариями;
- Обработка неупорядоченных событий. Если исходник разбит на разделы (по файлам/каталогам/разделам), очень сложно обеспечить порядок при чтении. События для записи могут быть распределены по многочисленным разделам. Для обеспечения согласованности данных в целевой таблице неупорядоченные события должны быть обработаны.
Upsert и Delete
Upsert - это операция в базе данных, которая обновляет уже существующие данные. Если данных пока нет, они будут вставлены.
Delete – операция, которая удаляет данные из базы данных.
Мы используем возможности Upsert и Delete для применения журналов CDC к целевой базе данных.
Оптимизированные Upsert и Delete
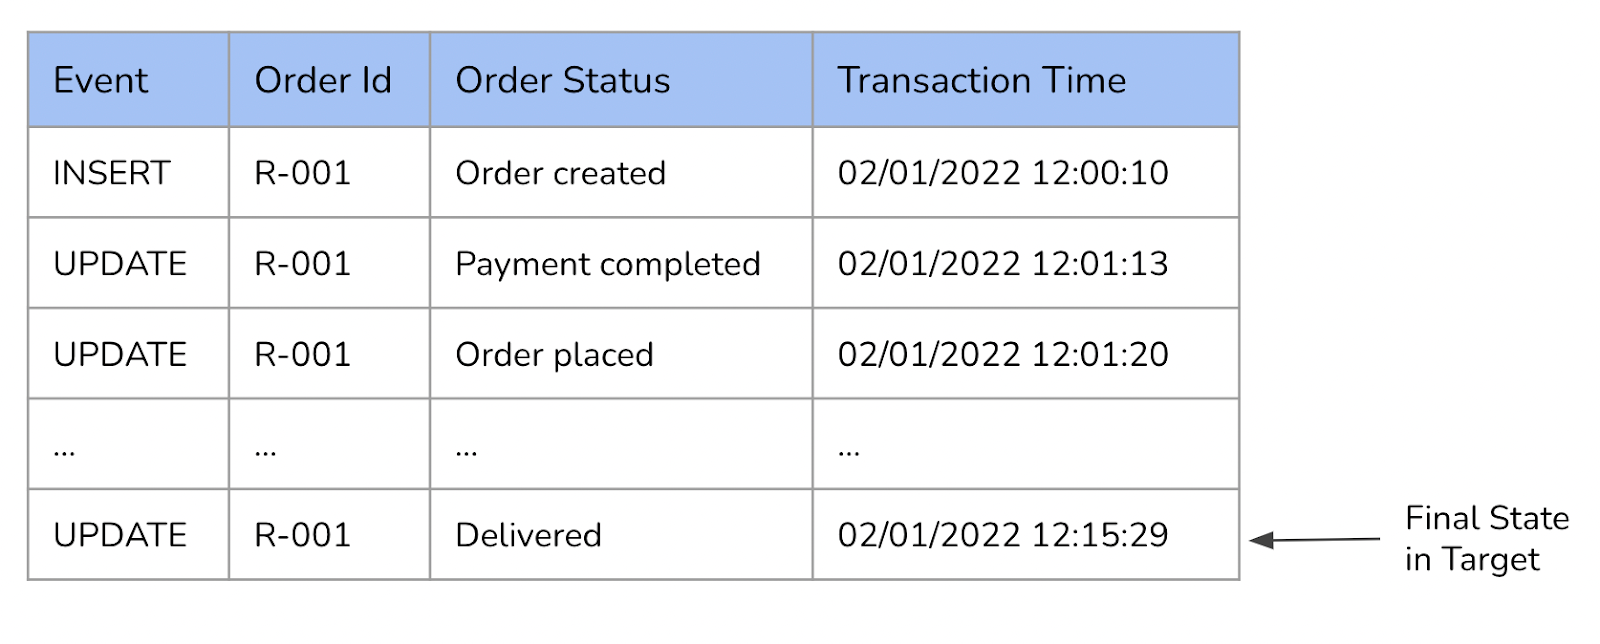
Как мы уже говорили ранее, CDC фиксирует события в базе данных, которые содержат все изменения данных. Предположим, что исходная база данных содержит запись с идентификатором R-001 и с этой записью произошло 15 операций обновления. CDC будет содержать 16 событий — 1 Insert и 15 Update. Если мы получаем все эти события в одном пакете, нам не нужно применять все события последовательно одно за другим. Мы можем оптимизировать процесс Upsert, отбрасывая старые события для R-001 и рассматривая только последнюю версию. Последняя обновленная запись представляет собой правильное состояние и поэтому будет использоваться для обновления последней версии в нашей целевой таблице. Если записи в целевой базе данных нет, Upsert вставит эту запись.
Другой пример: рассмотрим запись с идентификатором R-002. Над данной записью выполняется 15 операций обновления. Затем запись R-002 удаляется из исходной базы данных. В CDC мы получим 17 событий — 1 Insert, за которым следуют 15 Update и, наконец, 1 Delete. Если все эти события получены в одном пакете, и последней операцией является Delete, тогда запись R-002 не должна присутствовать в итоговой целевой таблице.
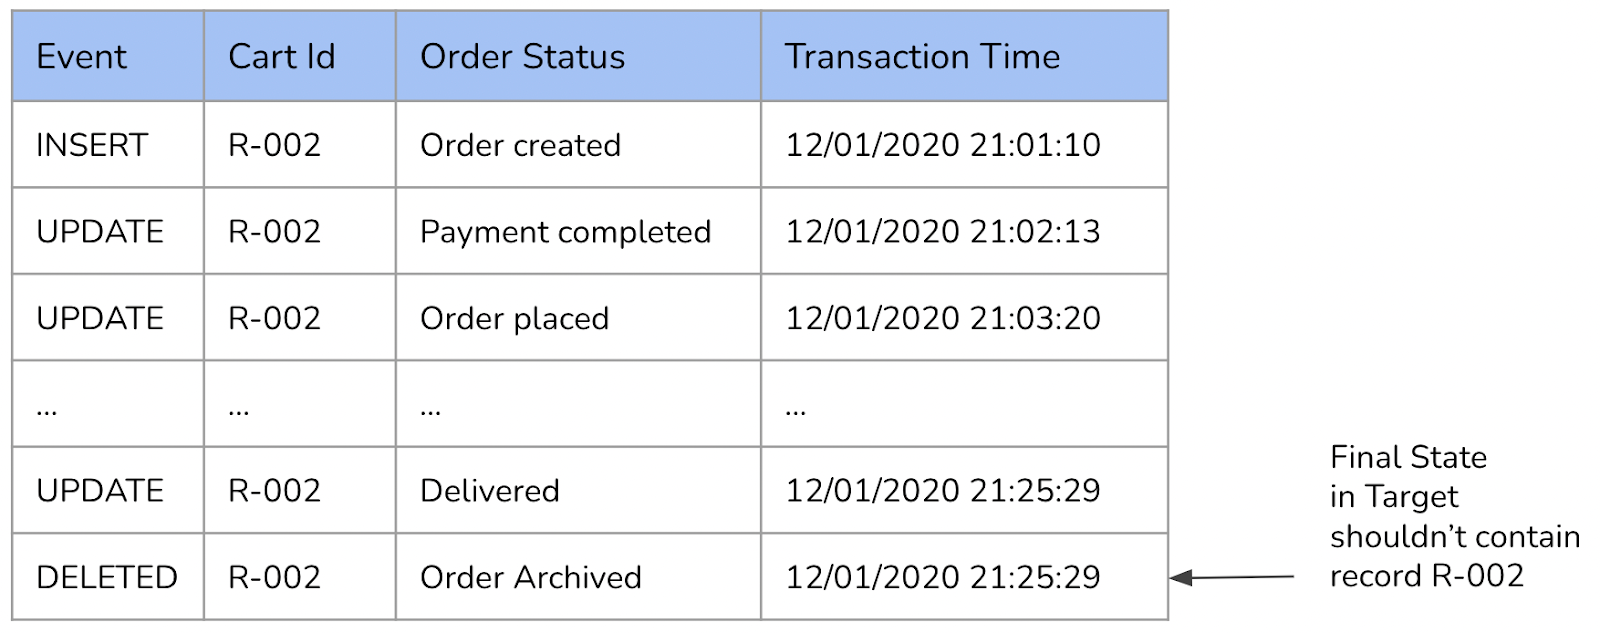 (не скачивается)
Создание схемы
Целевая таблица пригодна для использования, если она соответствует правильной схеме и структуре. Обеспечение правильной схемы — непростая задача. В реальном мире таблица начинается с базовой схемы, которая со временем эволюционирует.
Извлечение базовой схемы
В начале процесса схема таблицы обычно остается неизменной. Когда источником является таблица СУБД, извлечь схему очень просто, поскольку схема таблицы в СУБД предопределена и фиксирована до тех пор, пока не будет изменена явным образом. Схема, извлеченная из СУБД, может быть передана на этап согласования для записи данных в целевую таблицу.
Для баз данных NoSQL этот подход работает плохо. Чтобы использовать DynamoDB в качестве источника, мы создали собственное решение для вывода схемы таблицы. Оно считывает данные в формате записи потока DynamoDB и извлекает значимую информацию для определения окончательной схемы данных.
Изменение схемы
Развитие схемы (schema evolution)— это функция, которая позволяет пользователю изменять схему таблицы для размещения данных, меняющихся с течением времени.
Когда эволюция схемы происходит в исходной таблице, система CDC должна иметь возможность обрабатывать и применять ее к целевой таблице.
Совместимые изменения
Совместимые изменения схемы — это изменения, которые совместимы с существующей схемой и могут быть легко добавлены. Например, добавить/удалить столбцы, расширить тип данных столбцов (от int до long или от float до double). Большинство методов согласования могут легко справиться с данной задачей.
Несовместимые изменения
Есть изменения, которые не так-то просто добавить в существующую схему. Например, изменение типа данных столбцов (int в строку/с плавающей запятой в список/строку в карту и т. д.). Это нетривиальная задача для обработки данных на этапе согласования.
Упорядочивание событий
Непротиворечивость и правильность целевых данных зависят от порядка добавления событий. Одно добавление, осуществленное не по порядку, может испортить целый набор данных. Для сохранения порядка требуется возрастающий порядковый номер - мы полагаемся на метку времени. Всякий раз, когда в источнике происходит какая-либо транзакция, исходная БД фиксирует время транзакции, и это обеспечивает правильный порядок событий.
Это помогает нам:
- Выбрать самую последнюю транзакцию;
- Сбросить транзакции, выбившиеся из очереди
Механизм согласования
Есть несколько open-source решений, которые помогают построить фазу согласования. Примеры: Apache Iceberg, Delta lake и Apache Hudi.
Delta Lake
Для решения данной задачи мы в основном используем Delta lake.
Delta merge
Upsert и Delete применяются во время функции Delta merge. После очистки и обработки журналов CDC фрагмент данных передается в Delta merge для применения событий к целевому объекту. Delta предоставляет гарантию ACID поверх Spark, что помогает поддерживать согласованность данных.
Изменение схемы
Delta и Spark предоставляет готовое решение по изменению схемы без повреждения данных.
Оптимизация
Методы оптимизации Delta в основном преобразуют меньшие файлы в более крупные, что помогает улучшить производительность чтения. После применения оптимизации время чтения сократилось с 2 часов до 15 минут.
Z-порядок
Еще один тип оптимизации, повышающий производительность чтения запросов в зависимости от кластеров, таких как город, зона и т. д.
Vacuum
Помогает очистить старые коммиты и оптимизировать затраты на хранение.
Time travel
Одна из самых мощных возможностей таблиц Delta — путешествия во времени (time travel) - она помогает воспроизводить отчеты, изменения данных аудита и т. д.
Совместимость таблиц Delta
Таблицы Delta совместимы с хранилищем метаданных Hive. Метаданные таблицы регистрируются в хранилище Hive, а доступ к данным осуществляется с помощью Spark-SQL или HiveQL.
Мы также создали собственное решение для синхронизации таблиц Delta со Snowflake.
Заключение
Система CDC помогла Swiggy реализовать кейсы, близкие к реальному времени, такие как: мониторинг дашбордов в режиме, близком к реальному времени; выполнение функций практически в реальном времени; реализация сценариев использования Data Science. В целом, это помогло нам принять правильные бизнес-решения.
Эта система также помогла нам оптимизировать затраты на обработку измененных данных (в сравнении с обработкой всего набора данных). Мы сократили зависимость от инструментов обработки баз данных, используемых для массового импорта и экспорта данных, в результате чего добились значительной экономии в перерасчете на доллары (20% в месяц). Кроме того, значительно снизились и операционные накладные расходы, и затраты на техническое обслуживание, а также расходы на восстановление после сбоев. Повысилась гарантия «свежести» и непротиворечивости данных. Более того, мы создали отличный способ мониторинга работоспособности системы, состояния и согласованности данных, что помогает нам развивать наш сервис в лучшую сторону.


