

Введение в современный стек данных
Обзор того, как современный стек данных влияет на управление данными с помощью масштабируемых облачных решений, автоматизированных инструментов оркестрации данных, а также передовых аналитических технологий.
Современный стек данных отражает эволюцию управления данными, переход от традиционных монолитных систем к более гибким облачным архитектурам. Современный стек данных предназначен для работы с Big Data, обеспечивая масштабируемость, гибкость и возможность обработки данных в режиме реального времени. Он является модульным, что позволяет организациям использовать специализированные инструменты для каждого этапа обработки данных: сбор данных, хранение, преобразование и анализ данных. Поскольку компании уделяют большое внимание принятию решений, основанных исключительно на данных, современный стек данных является неотъемлемой частью процесса получения практических знаний, выработки лучших практик и внедрения передовых инноваций.
Этапы развития современного стека данных
- Самое начало: период до 2000 г.
Компании используют большие единые системы для хранения и управления данными, которые вполне справлялись с решением повседневных бизнес-задач, но не совсем подходили для работы с Big Data. Данные хранились в традиционных реляционных базах данных, таких как Oracle, IBM DB2 и Microsoft SQL Server.
- Эпоха Big Data: начало 2000 г. - 2010 г.
Этот период ознаменован началом перехода к системам, способным быстро обрабатывать Big Data, поступающим в различных форматах из самых разных источников. Новые технологии, такие как Hadoop, помогли распределить работу с данными по многим компьютерам.
- Появление облачных хранилищ данных: середина 2010 -х гг.
Облачные технологии коренным образом изменили хранение и обработку данных. Облачные хранилища данных, такие как Amazon Redshift и Google BigQuery, обеспечили невиданную до сей поры масштабируемость и гибкость, изменив скорость анализа данных. Кроме того, появился Snowflake, стартап в области облачных хранилищ данных, предложивший уникальную архитектуру, разделяющую вычисления и хранение данных.
- Современный стек данных: конец 2010 х. гг. – настоящее время
Современный стек данных сформировался с появлением процессов ELT, инструментов интеграции данных на базе SaaS, а также благодаря разделению систем хранения и вычислений. В это время появились инструменты, предназначенные для работы с определенными этапами жизненного цикла данных, что позволило применить более эффективный подход к управлению данными.

Ограничения традиционных систем управления данными
Будучи дата-инженером, работавшим в самых разных компаниях, я достаточно часто использовал Microsoft SQL Server. В этом разделе я расскажу Вам о проблемах, возникающих при работе с этой традиционной системой, с которыми мне довелось столкнуться. Позже мы рассмотрим, как современный стек данных (MDS) справляется с большинством этих трудностей; многие из них стали для меня настоящим открытием!
- Масштабирование
Традиционные развертывания SQL Server часто использовали локальные серверы, а это означало, что масштабирование с учетом растущих объемов данных требовало значительных инвестиций в оборудование и могло привести к длительным простоям во время обновлений. Более того, когда у нас стало меньше данных, у нас оставалось все это дополнительное оборудование, которое, по сути, нам было не нужно. Но мы все равно платили за него. Это все равно, что платить за целый автобус, хотя нужно всего лишь несколько мест…
- Сложные ETL- процессы
SSIS широко использовался для работы с ETL - процессами. Безусловно, это был достаточно мощный инструмент, но и он во многом имел ограниченный функционал, особенно по сравнению с более современными решениями по интеграции данных. Примечательно, что Microsoft SQL Server решил большинство этих ограничений с помощью Azure Data Factory и SQL Server Data Tools (SSDT):
- Звонки по API: с самого начала SSIS не работал со звонками по API. Для работы с веб-сервисами нужны были сложные скрипты, что значительно усложняло ETL – процессы;
- Распределение памяти: задания SSIS требуют внимательного управления памятью. Без достаточного количества серверной памяти сложные задания с данными становились просто невыполнимыми;
- Аудит: для мониторинга и устранения неполадок требовался серьезный аудит пакетовSSIS, что увеличивало объем работы с данными;
- Контроль версий: в ранних версиях SSIS возникали проблемы с интеграцией системы контроля версий, что затрудняло отслеживание изменений и негативно сказывалось на эффективности работы команды специалистов в обрасти данных;
- Работа с несколькими платформами: управление SSIS из систем, отличных от Windows, было достаточно сложной задачей, поскольку этот инструмент был ориентирован исключительно на Windows.
- Техническое обслуживание
Обслуживание локальных серверов требовало значительных ресурсов и рабочего времени. Я помню, как много усилий и времени требовалось для того, чтобы обеспечить бесперебойную работу систем, которая зачастую сопровождалось нежелательными простоями.
- Интеграция
Интеграция SQL Server с новыми инструментами и платформами не всегда проходила гладко. Для решения этой задачи приходилось в буквальном смысле ломать голову, что в значительной степени усложняло нашу архитектуру данных.
Как современный стек данных помог мне справиться со всеми этими трудностями
Современный стек данных (Modern Data Stack, MDS) позволил справиться со множеством трудностей, с которыми мне приходилось сталкиваться в процессе работы с SQL Server. Теперь для хранения данных мы смогли использовать облачные технологии, иными словами нам больше не нужно было тратиться на дорогостоящие серверы, которые не всегда были нам нужны. Получать данные из разных источников стало намного проще, поскольку появились инструменты, делающие все за нас. Сложное кодирование стало пережитком прошлого.
Когда нужно было отсортировать или очистить данные, мы могли делать это непосредственно в БД с помощью самых простых команд. Это позволило избежать головной боли, связанной с управлением большими серверами или «копанием» в Big Data в поиске крошечной ошибки.
Так что с помощью MDS мы смогли сэкономить уйму времени и смогли. Как будто у нас появились умные помощники, которые взяли на себя решение самых сложных задач, а мы смогли сосредоточиться на самом главном - изучении того, что говорят нам данные, и получении полезных инсайтов.
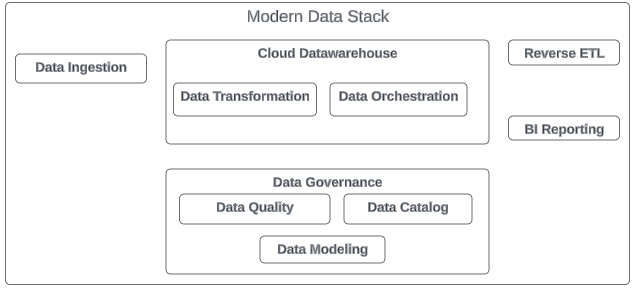
Компоненты MDS
MDS состоит из нескольких уровней, каждый из которых оперирует специализированными инструментами, которые в совокупности позволяют оптимизировать процессы обработки данных.
- Загрузка и интеграция данных - извлечение и загрузка данных из различных источников, включая API, базы данных и SaaS-приложения. Инструменты интеграции: Fivetran, Stitch, Airbyte, Segment и т.д.
- Хранение данных - современные облачные хранилища данных и озера данных предлагают масштабируемые, гибкие и экономически эффективные решения для хранения данных. Облачные хранилища данных: Google Bigquery, Snowflake, Redshift и т.д.
- Преобразование данных - такие инструменты, как dbt (data build tool), позволяют выполнять преобразования данных непосредственно в хранилищах данных с помощью простого SQL.
- Аналитика данных и BI - аналитические решения и BI инструменты позволяют исследовать данные гораздо быстрее и эффективнее, визуализировать их и обмениваться информацией в рамках всей организации. BI инструменты: Tableau, Looker, Power BI, Good Data
- Извлечение данных и обратный ETL - позволяет организациям оперативно использовать данные, загружая их в бизнес-приложения, что позволяет оперативно принимать решения на основе проверенных данных. Инструменты обратного ETL: Hightouch, Census
- Оркестрация данных - платформы, позволяющие автоматизировать рабочие процессы обработки данных. Инструменты оркестрации данных: Airflow, Astronomer, Dagster, AWS Step Functions
- Data Governance и безопасность данных - Data governance уделяет особое внимание управлению доступа к данным, а также обеспечению строгого соответстивия нормативным требованиям, а также требованиям в области защиты данных. С помощью Data Governance можно легко организовать активы данных. Инструменты организации данных: Alation, Collibra, Apache Atlas.
- Качество данных - обеспечивает надежность и точность данных благодаря их своевременной проверки и очистки, что позволяет быстрее принимать решения на основе данных. Инструменты обеспечения высокого качества данных: Talend, Monte Carlo, Soda, Anomolo, Great Expectations
- Моделирование данных - помогает в разработке схем баз данных, обеспечивает гибкость архитектуры данных. Инструменты моделирования данных: Erwin, SQLDBM
Заключение: MDS и более эффективное управление затратами
MDS – это фантастика! Он определенно ускоряет работу с данными и избавляет data – инженеров от изнуряющей головной боли. Несмотря на то, что он дает нам возможность применять в свой работе крутейшими инструментами, все - таки по прежнему важно следить за расходами. Облачные технологии с оплатой по факту использования - это здорово, поскольку что мы платим только за то, что используем. Но, как и в случае с оплатой услуг связи, необходимо рационально подходить к своим потребностям в области использования облачных технологий. Поэтому, наслаждаясь головокружительным функционалом MDS, очень важно должны следить за тем, как именно мы его используем. Если Вы не хотите, чтобы предъявленный счет за предоставленные услуги не стал для Вас неприятной неожиданностью, внимательно следите за используемыми инструментами и внимательно взвешиваете все за и против их использования в своей работе.


