

Архитектурные паттерны генерации: монолит vs микросервисы vs потоковые конвейеры
Современная автоматическая генерация XBRL-отчётов опирается на комплексную архитектуру, которая обеспечивает качество данных, соответствие налоговым требованиям и масштабируемость. Выбор паттерна воздействия на скорость доставки отчетов, надёжность и управляемость важных бизнес-процессов. В данной главе рассмотрены три базовых архитектурных подхода и их сочетания: монолитная реализация, микросервисная архитектура и потоковые конвейеры. Показаны принципы проектирования, типовые торговые точки, а также риски и критерии миграции между подходами в условиях регуляторной ликидности и требований к контролю качества данных.
В условиях широкого применения XBRL-отчетности важно помнить: архитектура должна не только поддерживать конвертацию данных и генерирование XBRL-инстансов, но и обеспечивать прозрачность процессов, валидируемость таксономий, прослеживаемость изменений и соответствие требованиям регулятора. Эффективная архитектура учитывает источники данных, их качество, частоту обновления и требования к аудиту. Именно поэтому в разделе ниже предлагается не единый рецепт, а набор паттернов и критериев выбора, адаптированных под конкретные бизнес-кейсы, объём регуляторной нагрузки и готовность к эволюции.
Концептуальные основы архитектурных паттернов
Архитектурная парадигма определяет, как данные конвертируются в XBRL-отчёт, как обеспечиваются качество данных, как управляется изменчивость таксономий и как организуется обработка больших объёмов информации. В контексте автоматической генерации XBRL-отчётов три паттерна приходят на первый план: монолитная система, набор автономных сервисов и потоковые конвейеры обработки. Каждый паттерн имеет свои преимущества и критические ограничения.
Монолитная архитектура упорно остаётся актуальной в рамках ограниченных по объёму проектов или при необходимости минимизации задержек в рамках единого контекста: единственная кодовая база, единая среда исполнения и централизованный контроль версий. Преимущества заключаются в простоте развертывания, отсутствии межсервисной задержки и упрощённой трассируемости. Но монолит страдает при росте сложности: трудности масштабирования отдельных этапов, риск коллизий при одновременном обновлении таксономий, ограниченные возможности гибкой адаптации под разные юрисдикции и регуляторные требования.
Микросервисы предлагают логическую декомпозицию по границам доменов: Extraction, Taxonomy Mapping, XBRL-Generation, Validation, Packaging и Delivery. Такой подход улучшает масштабируемость и устойчивость: можно независимо разворачивать и обновлять компоненты, внедрять автономные тестовые окружения и независимо управлять инфраструктурой. Важная характеристика - сервисы должны быть максимально автономными и идемпотентными, а коммуникации - через асинхронные механизмы и событийно-ориентированную интеграцию. Однако микросервисы добавляют сложность: координация между сервисами, распределённые транзакции, управляемость контрактов API и требования к мониторингу.
Потоковые конвейеры ориентированы на обработку изменений в данных в реальном времени или близком к нему режиме. Потоки позволяют снизить задержку между поступлением данных и выпуском XBRL-отчётов, поддерживают режимы CDC (change data capture) и пакетную обработку по расписанию. Это особенно ценно для регуляторной своевременности и для сценариев, где данные поступают из множества систем: ERP, CRM, финмодели и т. п. В контексте XBRL паттерн потоков требует продуманной стратегии валидации на каждом этапе, не только на финальной стадии, и надёжной оркестрации конвейеров через внешние средства очередей и управления потоками.
Монолитная архитектура: преимущества и ограничения
В монолитной реализации единая кодовая база аккумулирует все этапы: извлечение данных, преобразование под таксономии, формирование XBRL-документов и их валидацию. Такой подход эффективен на старте проекта, когда объём функциональности невелик, требования к задержке минимальны, а команда может быстро выпускать изменения и тестировать их в единой среде.
Преимущества монолита включают:
- упрощённое тестирование и развёртывание: единое артефактное окружение, единая цепочка CI/CD;
- возможность оптимизации общего пула ресурсов под конкретную нагрузку;
- упрощённая трассируемость и аудит на уровне всей цепочки обработки.
Ключевые риски и ограничения:
- ограниченная масштабируемость: тяжело независимо масштабировать этапы конвертации или валидации;
- тесная зависимость изменений в таксономии и бизнес-процессах: обновления требуют синхронной координации во всей монолитной кодовой базе;
- сложности поддержки в условиях растущего объёма данных и регуляторной динамики, что может затруднять быструю адаптацию под новые требования;
- риск узконаправленного узла отказа: сбой одного модуля может парализовать всю обработку.
Типовые шаблоны внутри монолита:
- модульная структуризация по функциональности: Extraction, Mapping, Generation, Validation, Packaging;
- внедрение слоёв абстракций для таксономий и правил бизнес-логики, чтобы минимизировать повторение кода;
- единая система конфигураций, которая позволяет переключать источники данных и целевые форматы без переконфигурации кода.
Риск миграции в другие паттерны обычно диктуется бизнес-целями: рост объёма данных, необходимость независимого обновления частей конвейера, требование к частой поставке регуляторных изменений. В этом случае план миграции должен предусматривать сохранение совместимости, фазовую декомпозицию и прозрачную миграцию контрактов API. Важная практика - документирование контрактов, поддерживаемый набором контрактных тестов и версии таксономий, чтобы в ходе перехода можно было откатиться к стабильной версии.
Микросервисы: дизайн, границы сервисов и интеграции
Микросервисная архитектура ориентирует на разделение ответственности и автономную жизненную траекторию каждого элемента процесса. Для генерации XBRL-отчётов это чаще всего включает такие сервисы как Data Extraction Service, Taxonomy Mapping Service, XBRL Generation Service, Validation Service и Packaging/Delivery Service. Границы сервисов выбираются по функциям бизнес-логики и по требованиям к частоте обновления: например, Mapping может обновляться чаще, чем Generation, если таксономии эволюционируют быстро.
Ключевые принципы микросервисной реализации:
- контрактная автономия: каждый сервис имеет явный API и контракт, который не зависит от внутренней реализации;
- асинхронная коммуникация: очереди сообщений или потоковые каналы для передачи данных между сервисами, что снижает жесткость связей;
- идентичность и идемпотентность: повторные запросы не приводят к неконсистентности;
- совместимый контракт версий: поддержка нескольких версий API и трансляторы между версиями для обеспечения плавной миграции;
- мониторинг и трассируемость: распределённый трассинг, сигналы об ошибках, централизованный лог.
Интеграции между сервисами обычно реализуются через очереди сообщений (Kafka, NATS) или через локальные REST/GRPC-интерфейсы с версионированием контрактов. В качестве паттернов интеграции важны:
- событийно-ориентированная архитектура: каждый шаг публикует события, позволяя downstream-сервисам реагировать на изменения;
- оркестрация vs реагирование: для сложных сценариев возможно применение оркестратора (workflow engine), но чаще предпочтительна реактивная модель с событийной связью;
- управление схемами данных: использование схем описания форматов (например, Avro/JSON Schema) и внешнего реестра схем, чтобы поддерживать совместимость между сервисами.
Примеры технологий и инструментов:
- для обмена сообщениями: Apache Kafka, NATS;
- для обработки потоков и трансформаций: Apache Flink, Spark Structured Streaming;
- для интеграции данных из ERP и финмоделей: Apache NiFi, гибридные конвейеры на базе NiFi + собственные сервисы;
- для конвертации и валидации XBRL: OpenXBRL/Arelle как движок валидации и трансформаций, возможно их интеграция через сервис-обёртку.
В микросервисном подходе критично управлять схемами и зависимостями таксономий. Обновления taxonomies требуют координации версий и снижения риска расхождений между источниками и целевым форматом. Рекомендуется внедрять централизованный реестр таксономий и контрактов, а также тестовые наборы регрессионных тестов на совместимость. Важна also безопасность и контроль доступа: сервисы должны обладать минимально необходимыми правами и централизованной политикой аудита.
Потоковые конвейеры: обработка данных в реальном времени и пакетной обработке
Путь потоковых конвейеров целесообразен, когда необходима низкая задержка между поступлением данных и выпуском готового XBRL-документа, а также когда данные поступают из множества источников и нуждаются в оперативной обработке. Конвейеры позволяют организовать CDC-источники из ERP/CRM-систем, трансформацию и конвертацию в XBRL инстанcы в рамках многоступенчатого pipeline.
Ключевые принципы потоковой архитектуры:
- децентрализованная обработка: каждый этап в конвейере отвечает за конкретную трансформацию;
- управление задержками и эвент-тайм обработкой: учёт временных зон, задержек доставки сообщений и порядка обработки;
- строгая валидность на каждом этапе: после каждого шага должны выполняться проверки целостности и соответствия таксономии;
- повторная обработка и ретрай: устойчивость к сбоям за счёт повторной попытки и хранение состояний;
- мониторинг и SLA: видимость времени обработки и задержек, способность быстро идентифицировать узкие места.
Технологически для потоковых конвейеров применяются:
- брокеры сообщений (Kafka) как основа передачи данных между этапами;
- движки обработки потоков (Flink, Spark Structured Streaming) для трансформаций и агрегаций;
- управление схемами и совместимостью через реестр схем и версионирование контрактов;
- инструменты для обеспечения качества данных: правила валидации, проверки консисентности между источниками.
Преимущества потоковых конвейеров:
- минимизация задержек в поставке XBRL-отчётов;
- гибкость в реактивном добавлении новых источников данных;
- возможность постоянной валидной проверки соответствия таксономиям.
Риски и мероприятия по сокращению:
- риск несогласованности между источниками данных и их поздней коррекции: применяются CDC и ретроспективная обработка;
- сложность мониторинга и отладки: требуются централизованные панели и трассировка событий;
- зависимость от инфраструктуры потоков: требуется устойчивый кластер и автоматическое масштабирование.
Интеграции с XBRL-инфраструктурой: таксономии, конвертация, валидация
Интеграция с XBRL-инфраструктурой является критическим звеном при автоматической генерации отчётов. Эффективная система должна поддерживать работу с таксономиями, схемами и стандартами XBRL, обеспечивая корректность конвертации входных данных в XBRL-инстансы, их валидность и соответствие требованиям регулятора. Важной логикой здесь является поддержка многосайтовых и многоязычных таксономий, версионирование форматов и обеспечение совместимости между источниками и выводами.
Ключевые категории интеграции:
- работа с таксономиями: загрузка и обновление таксономий, отображение элементов и контекстов; механизм сопоставления данных получаемых из корпоративных систем с элементами таксономии;
- конвертация данных: трансформация исходной информации в структуру XBRL и формирование инстансов, соответствующих конкретной юрисдикции;
- валидация и аудит: регламентированные проверки на синтаксис и семантику XBRL, проверка ссылок, контекстов и единиц измерения;
- проверка соответствия регуляторным требованиям: набор правил и тестов, которые охватывают конкретные требования по формату и содержанию отчётности;
- выбор инструментов: OpenXBRL и Arelle как открытые движки валидации и конвертации; интеграция через API-обёртку в архитектуру (не обязательно напрямую внутри сервиса).
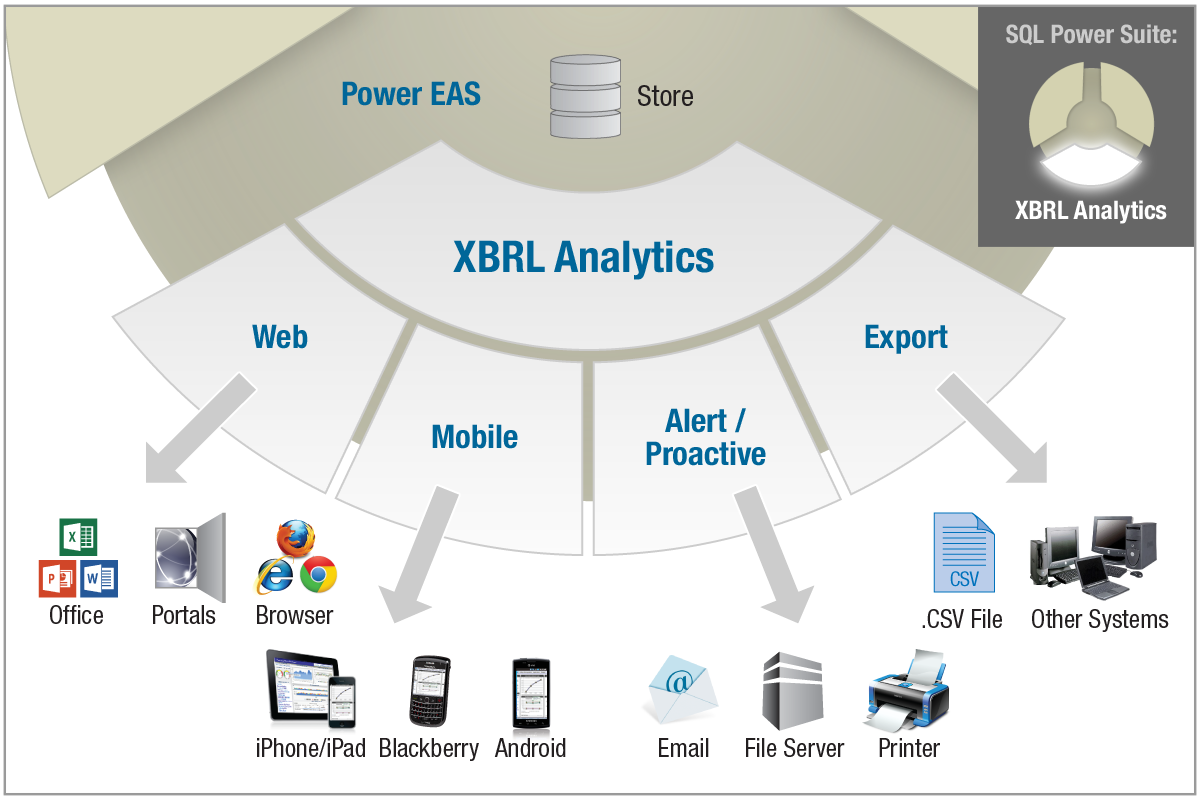
Практические принципы интеграции:
- поддержка единого реестра таксономий и их версий, чтобы любой сервис мог обращаться к актуальной версии;
- тестирование совместимости между источником данных и требованиями таксономии;
- обеспечение прозрачности процессов: журналирование, трассируемость операций и возможности аудита;
- минимизация дублирования логики в разных сервисах через общие библиотеки маппинга и конфигурации.
Безопасность, качество данных и соответствие требованиям
Архитектура должна быть рассчитана на соблюдение регуляторных требований и высокие стандарты качества данных. Это особенно важно в XBRL-отчётности, где любые проблемы с данными могут привести к штрафам или недостоверности отчётов.
Ключевые направления безопасности и качества данных:
- управление доступом и аудит: минимальные привилегии, многоуровневый аудит и журнал изменений по всем критичным этапам;
- контроль версий и целостности данных: отслеживание версий источников, изменений таксономий и выходных инстансов;
- качество данных: встраивание правил проверки входных данных, согласование значений и единиц измерения, обработка пропущенных значений;
- устойчивость к сбоям: резервное копирование, критично важные компоненты имеют дублирования и восстановление;
- безопасность передачи данных: шифрование при передаче и в хранении, мониторинг аномалий доступа к данным;
- соответствие требованиям: документирование процессов, контроль изменений и доказательства соответствия.
В этом контексте выбор архитектурного паттерна влияет на безопасность и управляемость. Микросервисная архитектура может облегчить внедрение отдельных политик безопасности для разных доменов, но потребует централизованных механизмов контроля доступа и мониторинга. Потоковые конвейеры усиливают требования к надёжной аутентификации и авторизации на уровне каждого этапа обработки и к аудит-следам для каждого события. В монолите безопасность часто реализуется централизованно, но при росте масштабирования может потребоваться переработка.
Реальные сценарии внедрения и пути миграции
В зависимости от текущего состояния инфраструктуры и регуляторной exigence организации могут выбрать разные траектории внедрения. Часто логика миграции выглядит как последовательная эволюция: начать с монолита, затем постепенно внедрять микросервисы для наиболее критичных функций, добавив потоковые конвейеры для части данных, где требуются минимальные задержки. Такой подход позволяет сохранить бизнес-цели и регуляторные требования в течение перехода.
Пошаговая стратегия миграции:
- аудит текущей архитектуры: определить узкие места, зоны риска и точки внедрения;
- выделение функций по доменам: определить сервисы-рынки и их границы;
- создание инфраструктуры для интеграции и совместимости: центральный реестр таксономий и контрактов;
- построение пилота: реализовать один или два критичных сценария в новой архитектуре и проверить устойчивость;
- постепенная миграция: развёртывание новых конвейеров и сервисов параллельно с существующей системой, с контролируемым переходом;
- мониторинг и аудит: постоянные проверки на соответствие, качество данных и регуляторные отчёты.
Обкатка архитектурно-справочной среды - это не только техническая задача, но и организационная. Внедрение новых паттернов требует изменений в процессах разработки, тестирования и эксплуатации, а также в управлении данными и документацией. Важна коммуникация между бизнес-единицами и ИТ, выстраивание совместных стандартов разработки и политики качества данных, а также обучение сотрудников новым подходам к работе с таксономиями и отчетностью.
Key takeaways
- Архитектурные паттерны монолит, микросервисы и потоковые конвейеры предлагают разные уровни масштабируемости, управляемости и задержки в процессе генерации XBRL-отчётов.
- Монолит подходит для ранних этапов и компактных проектов, но ограничивает самостоятельное масштабирование частей конвертации и валидации.
- Микросервисы обеспечивают гибкость, независимость развертываний и устойчивость к изменениям требовательных таксономий, но требуют продуманной оркестрации и управления контрактами.
- Потоковые конвейеры снижают задержку и поддерживают CDC-обработку, однако требуют зрелой архитектуры обработки событий, мониторинга и контроля качества на каждом этапе.
- Интеграция с XBRL-инфраструктурой должна опираться на единый реестр таксономий, управление версиями и строгую валидацию на каждом этапе конвейера.
- Безопасность, аудит и соответствие требованиям - неотъемлемые элементы архитектуры и должны быть встроены в каждый паттерн с учётом специфики регуляторной среды.
- Эволюционная миграция между паттернами возможна через фазовую декомпозицию, документирование контрактов и постепенное внедрение критически важных функций в новую архитектуру.
FAQ
- Какие факторы наиболее существенно влияют на выбор между монолитом, микросервисами и потоковыми конвейерами?
Архитектурное решение зависит от объёма данных, скорости обновления таксономий, требований к регуляторной задержке и готовности команды к управлению сложной инфраструктурой. Монолит эффективен на старте и при небольшом объёме, микросервисы - когда важно масштабировать отдельные этапы независимо, потоковые конвейеры - когда критична задержка и возможность обработки изменений в реальном времени.
- Как обеспечить совместимость таксономий при переходе от монолита к микросервисной архитектуре?
Необходимо ввести централизованный реестр таксономий и контрактов, версионирование API и строгие тесты регрессионной совместимости на каждом сервисе. Важно сохранять возможность работать с несколькими версиями таксономий параллельно и предоставлять миграционные механизмы.
- Какие сигналы сигнализируют о необходимости миграции к потоковым конвейерам?
Если требуется минимальная задержка между поступлением данных и выпуском отчётов, или если источники данных динамичны и требуют быстрого реагирования на изменения, это преимущество потоковой архитектуры. Также потоковые конвейеры полезны при большом количестве источников и необходимости CDC.
- Какие риски следует учитывать при внедрении микросервисной архитектуры?
Основные риски включают сложность координации между сервисами, управление контрактами API, сложность мониторинга и отладки, а также повышенные требования к инфраструктуре и операционному управлению.
- Как выбрать инструменты для обмена сообщениями и обработки потоков?
Выбор зависит от требований к задержке, устойчивости, экосистеме и совместимости с существующими технологиями. Kafka обеспечивает масштабируемые потоки и устойчивость; Flink и Spark структурированного потока - мощные движки обработки данных. NiFi может облегчить интеграцию и управление потоком данных из разных систем.
- Какие практики тестирования критичны для генерации XBRL-отчётов?
Необходимо обеспечить контрактное тестирование API между сервисами, регрессионное тестирование на совместимость таксономий, функциональные тесты конвертации и валидности, а также тесты на устойчивость к сбоям и проверку безопасности доступа и аудита.
- Насколько важна верификация соответствия требованиям в рамках архитектуры?
Очень важна: любые несоответствия могут привести к несоответствующим отчетам и регуляторным рискам. Верификация должна быть встроена в каждую стадию конвейера через механизмы валидации и аудита, а также через контроль версий таксономий.
- Как организация может начать внедрение паттернов, не нарушив текущий бизнес-процесс?
Начать с аудита текущей архитектуры и определения критичных сценариев. Затем выбрать пилотный сценарий, внедрить его в рамках монолита или микросервисной обвязки, обеспечить совместимость контрактов и постепенно расширять функциональность через миграционные шаги, сохраняя возможность отката.
- Какие российские или открытые решения полезны в рамках архитектуры?
В качестве открытых примеров можно упомянуть Arelle как движок XBRL и Apache Kafka для потоков. NiFi может служить мостом для интеграции источников данных. Важно ограничиться 1-2 примерами на раздел и следить за тем, чтобы они действительно усиливали смысл и не перегружали.
- Какие организационные изменения сопровождают переход к более современным паттернам?
Необходимо выстроить процессы управления изменениями, обновить руководство по архитектуре, внедрить общие принципы DevOps/DevSecOps, расширить обучение сотрудников по XBRL, таксономиям и контролю качества данных, а также развить культуру документирования и аудита на всех стадиях генерации отчетов.


