

People Analytics и HR-данные
Глобальная трансформация цифровых технологий оказала влияние на практику управления человеческими ресурсами во всех организациях. В условиях растущей конкуренции за таланты и необходимости оперативного принятия решений, аналитика персонала становится стратегическим ресурсом. Однако HR-данные - одни из самых чувствительных в корпоративных информационных системах: они содержат персональные данные, сведения о заработной плате, производительности, отношении к работе, здоровья и другие конфиденциальные аспекты сотрудников. В этом контексте ключевой задачей руководителей data-направлений, архитекторов и HR-директоров является выстраивание архитектуры данных, которая обеспечивает безопасность, качество и доступность информации для обоснованных решений.
Исходный обзор мировых практик подчеркивает несколько важных макроэтим: во-первых, рост роли аналитики персонала в улучшении процессов управления персоналом и формировании позитивного employee experience; во-вторых, существующий разрыв между наличием систем и реальным извлечением ценности из данных. Современные исследования показывают, что значительная доля HR-функций не достигает максимального эффекта от внедренной технологий, а внедрение и использование аналитических ресурсов требуют системного подхода к обучению сотрудников, качественному наполнению наборов данных и этическим рамкам. В этой связи создание безопасных синтетических наборов данных, выстроенные принципы конфиденциальности и управляемые методики анализа становятся неотъемлемой частью компетенций современных HR-аналитиков.
Настоящая статья представляет собой систематизированное руководство к практическому освоению People Analytics и HR-данных: от теоретических основ к архитектурным решениям, правовым и этическим рамкам, выбору и подготовке наборов данных, созданию синтетических данных, использованию инструментов и построению дашбордов, а также рассмотрению прикладных кейсов и отраслевых сценариев. В структуре учтены требования к профессиональной методологии: логика перехода от стратегического уровня к операционной практике, прозрачность методик, объяснимость моделей и контроль за рисками, связанными с конфиденциальностью и дискриминацией.
В данной работе принципы изыскания знаний опираются на формальные определения, общепринятые термины в области анализа данных персонала и практический опыт внедрения в рамках корпоративной среды. В центре внимания остаются вопросы достоверности, повторяемости и управляемости аналитических проектов: как формулировать вопросы, какие метрики выбирать, как валидировать выводы и как обеспечить соответствие требованиям регуляторов и корпоративной политики.
Ключевые цели раздела введения:
- обозначить контекст чувствительности HR-данных и значимости практики People Analytics;
- зафиксировать направление архитектурных и этических решений;
- очертить рамки методологии, инструментов и процессов, необходимых для устойчивого внедрения.
В следующих главах развертываются теоретические основы, архитектура данных, принципы этики и правовые рамки, а также прикладные кейсы и методики анализа, позволяющие переходить от абстрактной концепции к надёжной реализации в реальном бизнес-подконтексте.
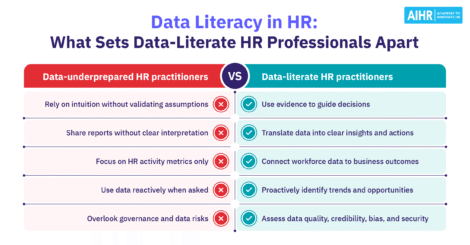
Теоретическая база: концепции аналитики персонала, цели, ценности и ограничения данных
Аналитика персонала (People Analytics) определяется как систематический сбор, структурирование, анализ и интерпретация данных о сотрудниках для поддержки управленческих решений в области найма, удержания, развития и эффективности. В экспертной литературе часто выделяют два взаимодополняющих ракурса: операционный анализ (для повседневной оптимизации HR-процессов) и стратегический анализ (для поддержки бизнес-целей и организационного дизайна). Важной характеристикой является тесная связь между данными из разных систем: информационных систем управления персоналом (HRIS), систем найма (ATS - Applicant Tracking System), систем управления вовлечённостью и удовлетворённостью, систем учета времени и производительности, а также внешних источников данных.
Цели People Analytics можно структурировать следующим образом:
- повышение эффективности найма и снижения затрат на набор персонала;
- улучшение удержания и снижение текучести через понимание факторов риска;
- оптимизация компенсаций и обеспечение внутренней справедливости;
- поддержка развития и обучения за счёт выявления узких мест в карьере и мотивационных факторов;
- формирование позитивного employee experience через анализ взаимодействий и благополучия.
Ценности аналитической практики отражают принципы прозрачности, объяснимости и ответственности. Важнейшие ценности включают:
- доверие к данным и методикам: аналитика должна базироваться на воспроизводимых методах и проверяемых источниках;
- этическое обращение с персональными данными: минимизация рисков, ограничение доступа, анонимизация и контроль за распространением;
- качество данных как основа доверия к выводам: полнота, точность, согласованность и своевременность;
- управляемая автономия команд: четкие ответственности за данные, модели и результаты;
- учет регуляторных требований и корпоративной политики.
Ограничения данных и аналитики в HR-среде требуют особого подхода к управлению качеством и рисками. Ключевые ограничения включают:
- ограниченность доступности полных наборов данных из-за конфиденциальности и правовых ограничений;
- наличие пропусков и несогласованности между системами;
- влияние социально-экономических факторов, сезонности и изменений в бизнес-модели на поведенческие паттерны;
- риск ошибок кобринга и смещения (bias) в моделях из-за неравномерной выборки, неполной информации по сотрудникам или неправильной калибровки переменных.
Методологический подход к аналитике персонала базируется на следующих принципах:
- формулировка вопросов на уровне бизнес-целей и операционных задач;
- выбор метрик, которые действительно отражают достижение целей и легко интерпретируются стейкхолдерами;
- обеспечение воспроизводимости анализа через документацию, версионность данных и кодовую базу;
- внедрение механизмов контроля за качеством данных и устойчивость к изменениям в источниках;
- активное участие заказчика и стейкхолдеров в процессе разработки и верификации выводов.
На уровне инструментов и методов выделяют три слоя: сбор и очистку данных, анализ и моделирование, визуализацию и дашборды. В каждом слое критически важны аспекты прозрачности методик, валидности моделей и возможности аудита процессов. В контексте этических норм и правовых требований особое значение приобретает концепция конфиденциальности, анонимности и роли синтетических данных как безопасной альтернативы для обучения и тестирования аналитических подходов без воздействия на реальных сотрудников.
Архитектура HR-данных: структура наборов, переменные и связь между системами
Архитектура HR-данных представляет собой многоуровневую систему взаимосвязанных компонентов, предназначенную для сбора, интеграции, хранения, обработки и распространения информации о кадрах организации. Основными слоями являются источники данных, интеграционные механизмы, хранилища данных, слой обработки и аналитики, а также консолидация доступа и управления безопасностью.
-
Источники данных формируют базовый набор информации: HRIS (Human Resources Information System) обеспечивает демографические данные, контекст должности, карьерный путь, расписания и кадровые события; ATS (Applicant Tracking System) предоставляет данные о найме и кандидатах; системы учета расходов на найм (recruiting_costs) позволяют оценивать экономическую эффективность найма; тренировочные и оценочные платформы дают данные о развитии сотрудников; payroll-системы содержат информацию о заработной плате и компенсациях; системы вовлеченности и удовлетворенности - опросники и результаты; системы производительности - результаты и KPI; а также данные о отпусках и отсутствии.
-
Интеграционные механизмы обеспечивают связность между системами и создают единый контекст для анализа. Обычно применяются подходы ELT (Extract, Load, Transform) или ETL (Extract, Transform, Load), коннекторы к базам данных, REST API и файлы в формате CSV/Parquet. Ключевыми задачами интеграции являются сопоставление полей (mapping), консолидация идентификаторов сотрудников (Master Data Management, MDM), поддержка активности изменений (data lineage) и обеспечение согласованности временных меток.
-
Хранилища данных представляют собой организованную архитектуру хранения: data lake для незапрещенного сырого формата и data warehouse (или data marts) для структурированных и готовых к аналитике наборов. В рамках этой архитектуры данные проходят этапы очистки, нормализации и обеспечения качества, а также управляются через каталоги и метаданные.
-
Слой обработки и аналитики включает в себя набор инструментов для анализа: SQL-запросы, Python-скрипты, R-скрипты, банку инструментов машинного обучения, а также платформы бизнес-аналитики (BI) и визуализации. Важной практикой является возможность повторного использования кода, документирование алгоритмов и аудит изменений, чтобы обеспечить прозрачность методик.
-
Управление безопасностью и доступом - центральная часть архитектуры. Принципы на уровне ролей, принцип минимальных привилегий, шифрование данных в состоянии покоя и передачи, аудит доступа, управление идентификацией и аутентификацией, а также политикой анонимизации и псевдонимизации, являются базовыми для обеспечения конфиденциальности.
-
Взаимосвязь и процессный контекст: архитектура должна поддерживать не только ретроспективный анализ, но и мониторинг в реальном времени, дашборды оперативной аналитики и прогностические модели. В контексте этических норм и правовых требований архитектура должна обеспечивать согласование с регуляторными актами, включая требования по защите персональных данных и управление рисками.
Ключевые понятия, которые следует запомнить на этом уровне:
- связка HRIS-ATS-платформы для опросов, payroll и производительности образует «ядро» HR-данных;
- MDM обеспечивает одну единицу истины для сотрудников, ролей и идентификаторов;
- data lineage позволяет проследить происхождение данных и влияние изменений;
- data governance устанавливает правила доступа, качества и ответственности;
- безопасность и конфиденциальность - неотъемлемые требования к архитектуре и процессам.
Ниже приведено наглядное представление типовой конфигурации переменных и их источников, что облегчает проектирование интеграционных потоков. Таблица не является исчерпывающим каталогом, но демонстрирует типовую схему распределения ключевых переменных между источниками.
| Источник данных | Типовые переменные | Примечания |
|---|---|---|
| HRIS (адрес, пол, дата рождения, пол, база должности, подразделение) | Демографика, должность, департамент, локация | Базовый контекст персонала |
| ATS | Источник отбора, дата интервью, статус кандидата, должность | Поддержка анализа найма и конверсии |
| Payroll | Заработная плата, диапазон оплаты, надбавки | Взаимосвязь оплаты и позиции |
| Опросы вовлеченности | Уровень вовлеченности, удовлетворенность, индексы стресса | Связь с увольнениями и производительностью |
| Системы учета времени | Отработанные часы, сверхурочная работа | Влияние на производительность и благосостояние |
| Оценка эффективности | Рейтинг, план развития | Связь с карьерным развитием и удержанием |
| Производственные показатели | KPI по подразделению/роли | Аналитика операционной эффективности |
| Системы обучения | Пройденные курсы, времени до повышения | Развитие компетенсий и текучесть |
Декомпозиция технических компонентов и их взаимодействие
Декомпозиция технических компонентов HR-архитектуры позволяет выстроить понятную карту сборки аналитических решений и выявить узкие места. В контексте людей и ИТ-архитектуры важны три аспекта: данные, процессы и люди. Уровень данных включает источники, качество и форматы; процессы - конвейер обработки, качество данных, мониторинг и автоматизацию; люди - роли, ответственность и культура анализа.
-
Ингестиониг-слой (data ingestion) обеспечивает непрерывное или периодическое извлечение данных из разных систем, с учетом требований к частоте обновления. Важно поддерживать согласование временных меток и минимальную задержку между источниками и хранилищем.
-
Преобразование и качество данных (data cleaning and transformation) включает нормализацию форматов, приведение единиц измерения к единому стандарту, обработку пропусков и ошибок. В HR-данных значимо обеспечить согласование терминологий (например, единая шкала уровней должностей, единый формат дат).
-
Метаданные и каталогизация (metadata and data catalog) позволяют отслеживать источник, назначение и дефиниции переменных, а также обеспечивать понятность для пользователей и аудиторов. В этом слое часто применяется частое обновление словарей данных и код-библиотеки.
-
Безопасность и конфиденциальность (security and privacy) включают управление доступом, анонимизацию, псевдонимизацию, шифрование и аудит. В HR контексте важна стратегия минимизации опасности повторной идентификации и утечки данных.
-
Оркестрация и автоматизация (orchestration and automation) обеспечивает согласованность рабочих процессов, повторяемость аналитических пайплайнов, обновления в графике и контроль версий. Обычно используются orchestrator-инструменты (Airflow, Prefect и др.) и инструменты репликации данных.
-
Аналитика и визуализация (analytics and visualization) включают инструменты бизнес-аналитики, Python/R‑пакеты, SQL-доступ и механизмы интерактивной визуализации. Важна возможность совместного использования выводов, а также прозрачность моделей и интерпретация результатов.
-
Интеграция технологических стеков и сред (integration of stacks and environments) предусматривает взаимную совместимость HRIS, ATS, BI-платформ и аналитической среды. Архитектура должна поддерживать порталы самообслуживания, доступ к данным по ролям и централизованный доступ к дашбордам.
Этапы взаимодействия можно описать как последовательность циклов: планирование данных, сбор, качество, сохранение, анализ и интерпретация. В этом процессе критично соблюдать требования к этике и правовым регуляциям, чтобы обеспечить доверие к аналитическим выводам и снизить риск нарушения прав сотрудников.
Правовые и этические рамки: конфиденциальность, анонимизация и роль синтетических данных
Правовые и этические рамки формирования HR-аналитики являются фундаментом доверия к данным и устойчивости аналитических процессов. Современное правовое поле охватывает принципы защиты персональных данных, включая общие положения, регулирующие обработку и хранение персональных данных сотрудников. В большинстве юрисдикций действуют следующие базовые принципы:
- законность и справедливость: сбор и обработка данных должны соответствовать законным основаниям и быть прозрачными для сотрудников;
- ограничение целей: данные должны собираться и использоваться исключительно для указанных целей;
- минимизация данных: сбор только тех данных, которые необходимы для достижения целей анализа;
- точность и актуальность: поддержание данных в актуальном и корректном состоянии;
- сохранение и архивирование: ограничение срока хранения и надлежащие меры по уничтожению данных;
- безопасность и конфиденциальность: меры защиты от несанкционированного доступа, утечки и киберугроз.
Особое место занимают вопросы обезличивания и анонимизации. В контексте HR-данных применяется псевдонимизация (замена идентификаторов на псевдонимы) и анонимизация (удаление идентификаторов и уникальных комбинаций, которые могут привести к идентификации лица). В реальных условиях полная анонимизация может снижать ценность данных, поэтому баланс между конфиденциальностью и аналитической ценностью достигается через подходы к обезличиванию и агрегированию, а также через фиксацию ограничений на размер выборки и уровень детализации.
Синтетические данные играют важную роль как безопасная альтернатива реальным данным для обучения сотрудников, тестирования методик и разработки дашбордов. При создании синтетических наборов важно сохранять структурную схожесть с реальными данными, сохранять корреляционные паттерны и разумные распределения, но исключать возможность идентификации. Проверка качества синтетических данных должна включать:
- сравнение распределений по ключевым переменным с оригиналами;
- проверку отсутствия прямых идентификаторов;
- проверку на сохранение зависимостей между переменными;
- внешнюю экспертизу и валидацию.
Этическое использование аналитики требует внедрения процессов аудита и прозрачных политики доступа к данным, а также обучения сотрудников принципам ответственного использования данных и принципам fairness (справедливости) в моделях и выводах. В частности, практики мониторинга и аудита-including bias testing and model validation-необходимо внедрять на ранних этапах проектов.
Выбор и подготовка наборов данных для анализа: критерии качества, очистка и нормализация
Выбор набора данных для анализа зависит от вопроса, который вы ставите перед командой, и от того, какие переменные необходимы для ответа. Важными этапами являются формулировка вопроса, определение необходимых переменных, анализ доступности данных и обеспечение этических рамок. Важно помнить: «лучший набор данных не обязательно самый большой, но тот, который структурирован под ваш вопрос, структуру и цели анализа».
Критически важные аспекты подготовки данных включают:
- полнота и качество данных: минимизация пропусков, исправление ошибок и устранение дубликатов;
- единообразие форматов: единый формат дат, единицы измерения, единая шкала уровней и категориальных переменных;
- нормализация и приведение к единым стандартам: согласование часовых поясов, валют, районов;
- обработка пропусков и аномалий: решать вопросы, как обрабатывать отсутствующие значения (imputation) и как трактовать выбросы;
- согласование временных рамок: адаптация к частоте обновления источников и временной согласованности относительно заданной задачи;
- документация и словари данных: четкое определение переменных, их значений и ограничений.
После подготовки данных следует обеспечить проверку качества: выполнение базовых тестов на целостность, тесты на зависимость между переменными и на соответствие бизнес-логике, а также проведение тестов на устойчивость к изменениям в источниках данных. В контексте HR-аналитики важно помнить о значимости фиксации нарративов и ограничений по данным, чтобы выводы не противоречили реальным условиям бизнеса и регуляторным требованиям.
Наборы данных для практики аналитики людей
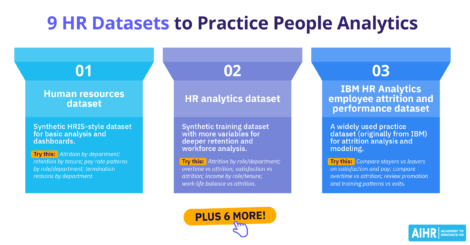
Наборы данных для практики аналитики людей создаются с целью безопасной отработки навыков анализа, построения дашбордов и тестирования гипотез без доступа к реальным данным сотрудников. В качестве ориентиров можно использовать синтетические и обезличенные наборы, а также открытые примеры, предоставляющие структуру и переменные, пригодные для моделирования и визуализации.
Ключевые принципы при выборе практических наборов:
- наличие реалистичных переменных: демография, роль, отдел, уровень, стаж, заработная плата, показатели вовлеченности, удовлетворенности, производительности, отсутствие и др.;
- сочетание разных источников данных: HRIS, ATS, опросы, финансовые показатели найма;
- возможность анализа на уровне групп и сегментов: отделы, должности, регионы, уровни;
- обеспечение анонимности и синтетичности, чтобы не нарушать требования конфиденциальности;
- наличие кодексов и справочников (codebooks) для понимания структуры переменных.
В числе примеров описанных в исходной текстовой базе упоминаются наборы, содержащие core data, engagement и satisfaction, salary grid, recruiting costs, production staff и другие. В практических рамках фокус делается на способность сочетать данные с целями анализа, например, исследование attrition (устойчивость к уходу), взаимоотношения вовлеченности и удержания, анализ соответствия оплаты заданным позициям и регионам, а также влияние источников найма на показатели эффективности.
Практические рекомендации:
- начинайте с вопроса, который вы хотите решить (turnover, engagement, equity и т. п.) и от него выстраивайте структуру набора;
- держите набор данных компактным и целенаправленным: избегайте «перегрузки» лишними переменными;
- используйте сетевые источники данных и синтетические варианты для тренировок и обучения;
- документируйте каждую переменную и определение, чтобы обеспечить единое понимание для команды.
Core HR dataset: структура, переменные и аналитические возможности
Core HR dataset - это базовый набор для анализа, который чаще всего охватывает основные характеристики сотрудника и его карьерный контекст. В типовой Core HR набор включает демографические данные, информацию о департаменте и должности, параметры оплаты, менеджера, даты найма и увольнения, а также оценку эффективности. Такой набор позволяет выполнять широкий спектр анализов: от описательной статистики по демографическим группам до корреляционного и регрессионного анализа факторов, влияющих на текучесть и производительность.
Основные переменные Core HR набора обычно включают:
- Employee ID - уникальный идентификатор сотрудника;
- Demographics - возраст, пол, образование и гражданство (при необходимости);
- Department и Job Title - подразделение и должность;
- Salary Band и Pay Rate - диапазон заработной платы и фактическая оплата;
- Hire Date и Termination Date - даты приема на работу и увольнения;
- Manager ID - идентификатор руководителя;
- Tenure - продолжительность пребывания в организации;
- Performance Rating - рейтинг эффективности;
- Attrition - индикатор ухода (Yes/No);
- Location - место работы (город/регион);
- Overtime - переработки, если применимо;
- Other Context - дополнительные поля, такие как статус трудового договора, командировки и т. п.
Аналитические возможности Core HR набора включают:
- анализ текучести и её детерминантов по отделам, должностям, регионам и уровням;
- исследование связи между стажем, рейтингами производительности и вероятностью ухода;
- оценку внутренней справедливости оплаты и соответствия зарплатного диапазона;
- построение прогнозов и моделирование сценариев для планирования кадровых потребностей;
- создание дашбордов, объединяющих демографику, карьерный путь и бизнес-ключевые показатели.
Дальнейшая работа с Core HR набором требует учета правовых и этических аспектов: обеспечение анонимизации и минимизации идентификаторов, а также документирование источников данных и определений переменных.
| Переменная | Описание | Тип | Пример значений |
|---|---|---|---|
| Employee ID | Уникальный идентификатор сотрудника | Ключевая переменная | E12345 |
| Department | Подразделение | Категориальная | HR, IT, Производство |
| Job Title | Должность | Категориальная | Аналитик, Инженер, Менеджер |
| Location | Место работы | Категориальная | Москва, Санкт-Петербург |
| Hire Date | Дата найма | Дата | 2018-03-15 |
| Termination Date | Дата увольнения | Дата | 2021-11-30 |
| Salary Band | Диапазон оплаты | Категориальная | Junior, Mid, Senior |
| Pay Rate | Месячная оплата | Числовая | 5200 |
| Tenure | Стаж в организации | Числовая | 4.5 |
| Performance Rating | Рейтинг эффективности | Категориальная/Числовая | 1-5 |
| Attrition | Уходит ли сотрудник | Булевый | Yes/No |
| Manager ID | Идентификатор руководителя | Строка | MGR001 |
Engagement и удовлетворенность сотрудников: переменные, взаимосвязи и примеры анализов
Уровень вовлеченности сотрудников является одним из ключевых индикаторов здоровья организации. Вовлеченность отражает мотивацию сотрудников, готовность вкладывать усилия в достижение целей, а также связь с производительностью и уровнем текучести. Вовлеченность формируется рядом факторов, включая стиль руководства, возможности профессионального роста, качество коммуникаций, баланс работы и личной жизни, а также восприятие справедливости и поддержки.
Переменные, описывающие engagement, обычно включают:
- Engagement Score - композитный показатель вовлеченности;
- Absenteeism и дисциплина в отношении сроков и посещаемости;
- Personal Initiative и Mobility Behavior - показатели инициативы и вероятности смены условий;
- Оценки менеджера и отдела - контекст для сравнения между группами;
- Work-life Balance - баланс работы и личной жизнью.
Связи вовлеченности с другими переменными часто устанавливаются в рамках корреляционного анализа и регрессионной модели:
- связь вовлеченности и удовлетворенности с удержанием и вероятностью увольнения;
- влияние вовлеченности на показатели производительности и качество работы;
- отличие вовлеченности сотрудников в зависимости от департамента, уровня должности, региона.
Примеры анализа:
- сравнение вовлеченности между группами сотрудников с различными уровнями должности или стажем;
- анализ влияния вовлеченности на риск ухода после контроля за демографическими и карьерными факторами;
- изучение влияния руководителя и стиля управления на вовлеченность и благополучие.
Данные об engagement часто поступают из опросников и анкет, что требует особого внимания к методам сбора данных, минимизации ошибок и интерпретации результатов. Этические принципы подсказывают не проводить анализ на уровне индивидуальных сотрудников без соответствующего согласия и обеспечивать агрегированные результаты для управленческих выводов.
Salary grid: диапазоны оплаты по должностям и их использование в сравнительном анализе
Salary grid (диапазоны оплаты) представляет собой структурированную схему оплаты, которая устанавливает минимальные, средние и максимальные значения оплаты по каждой должности или группе должностей. Такой подход обеспечивает внутреннюю справедливость, управляемость затрат на оплату и сопоставимость между различными подразделениями и регионами. Диапазоны оплаты обычно учитывают уровень должности, региональные различия, критические компетенции и рыночные условия.
Ключевые аспекты использования salary grid:
- сопоставление фактической оплаты сотрудника с диапазоном по его должности и региону;
- анализ отклонений, доли сотрудников на границе диапазона и выше/ниже границы;
- поддержка решений по повышению квалификации, карьерного продвижения и планированию бюджета оплаты труда;
- сравнение оплаты внутри структурных единиц и между ними для выявления несоответствий и возможной дискриминации;
- обеспечение прозрачности и понятности для сотрудников и руководителей.
Важно помнить, что salary grid не является статическим. Он должен периодически пересматриваться в контексте изменений рынка труда, инфляции, изменений бизнес-стратегии и экономических условий. Внедрение salary grid должно сопровождаться процессами коммуникации, обучения руководителей и сотрудников, чтобы обеспечить прозрачность и справедливость.
Практические советы по применению salary grid:
- проводить регулярные сравнения оплаты сотрудников внутри похожих позиций по отделам и регионам;
- анализировать долю сотрудников, чьи оплаты находятся внутри, ниже или выше диапазона;
- использовать salary grid как ориентир для планирования роста и продвижения;
- сочетать данные по Salary grid с данными по производительности (performance) и обучению для оценки эффективности инвестиций в развитие.
Recruiting costs: расходы на найм по источникам и связь с источниками набора персонала
Расходы на найм являются критическим компонентом эффективности человеческих ресурсов и управленческой дисциплины. Аналитика затрат на найм помогает выявлять наилучшие источники найма, оптимизировать бюджет и ускорять цикл привлечения таланта. В рамках анализа часто применяют показатели, такие как cost per hire (стоимость найма на одного сотрудника), time to hire (время на закрытие вакансии), качество найма и конверсионные ставки по источникам.
Ключевые элементы анализа Recruiting costs:
- источники найма: соцсети, сайты вакансий, агентов по подбору, внутренние кандидаты и рефералы, платформа обучения и др.;
- расходы по источникам: затраты на рекламу, сервисные сборы, фирмы по найму, платформа ATS и прочие;
- связь источников с качеством найма: метрики удержания, производительность, рейтинг кандидатов по итогам испытательного срока;
- временные динамики: сезонность и циклы найма, влияние экономических изменений.
Связь Recruiting costs с данными HRIS и Core HR позволяет анализировать, как затраты на различные источники коррелируют с количеством приглашений, качеством кандидатов и будущими результатами, включая удержание и производительность. В этом контексте следует учитывать логику учета времени и этапов найма, а также корректировку на время, когда сотрудник начал работу.
Практическая ценность анализа затрат на найм проявляется в возможности:
- оптимизировать бюджет на найм и перераспределение ресурсов;
- внедрять более эффективные источники и каналы;
- просчитывать экономическую эффективность найма через сравнение затрат и результатов.
Production staff: производственные показатели и факторы, влияющие на эффективность
В производственных сегментах анализ данных о персонале сталкивается с специфическими требованиями к данным и моделям. Производственный персонал требует учета операционных KPI, которые тесно связаны с безопасностью, качеством продукции и эффективностью процессов. В этом контексте аналитика персонала должна дополняться операционной аналитикой, чтобы связывать человеческий фактор с результатами производства.
Типичные показатели для производственного персонала включают:
- абу́тамы в час (output per hour) и производственные темпы;
- коэффициент ошибок (defect rate, quality metrics);
- количество жалоб и запросов по качеству;
- пропускная способность и скорость выполнения задач;
- показатель отклонений по времени и задержек.
Факторы, влияющие на эффективность производственного персонала, могут включать:
- мотивацию и вовлеченность, рабочий климат на линии;
- удовлетворенность и баланс работы/жизни;
- организационную поддержку, обучение и доступ к необходимым ресурсам;
- распределение задач, руководительский стиль и коммуникацию;
- физическую нагрузку и условия труда.
Аналитический подход к данным производственного персонала часто требует слияния HR-данных с операционными данными систем учета производственных операций. Это позволяет встретить взаимосвязи, такие как влияние вовлеченности на частоту ошибок или влияние уровня оплаты на мотивацию и производительность. Внедрение таких подходов требует тесной координации между HR и производственным подразделением, а также внимательного соблюдения этических и правовых требований, связанных с обработкой персональных данных в условиях производственной среды.
IBM HR Analytics: набор аттриции сотрудников и его профиль для дашбордов
Набор IBM HR Analytics (аттри́ция сотрудников) является одним из наиболее часто используемых в учебных и практических целях для анализа workforce pattern и отраслевых примеров. В этом наборе обычно содержится около 1 470 записей сотрудников и примерно 35 переменных. Он предназначен для поддержки анализа текучести и производительности, создания дашбордов и проведения вводного моделирования.
Ключевые поля в данном наборе чаще всего включают:
- Attrition - показатель ухода (Yes/No);
- Department и Job Role - отдел и роль;
- Monthly Income - месячный доход и показатели роста оплаты;
- Overtime - сверхурочная работа;
- Satisfaction и Work-life Balance - удовлетворенность и баланс между работой и личной жизнью;
- Tenure и Progression - стаж и развитие, включая годы в компании и в текущей роли;
- другие переменные, такие как переменные влияния, например Business Travel, Distance from Home, Education и т. п., которые помогают анализировать паттерны ухода по разным контекстам.
Дашборды в рамках такого набора часто строятся вокруг анализа различий по отделам, ролям, уровням и факторам, влияющим на уход. Аналитики используют такие данные для демонстрации паттернов по удержанию, уровню удовлетворенности и зависимости между оплатой и вероятностью ухода. Важно отметить, что наборами IBM часто сопровождает учебная документация, кодовые примеры и инструкции по валидации моделей.
IBM HR analytics: аттриция и производительность (attrition and performance)
В рамках расширенного набора IBM HR Analytics фокус может быть смещен на взаимосвязь attrition (уход сотрудников) и производительности. В таком контексте анализируются:
- различия в attrition между отделами и ролями;
- влияние внештатной занятости или сверхурочной работы на уход;
- отличие по уровню удовлетворенности и рабочей среды между оставшимися и ушедшими;
- сравнение зарплаты и роста по дисциплине и роль.
Кроме того, рассматриваются аналитические задачи, связывающие «years at company» и «years in current role» с вероятностью ухода и с изменениями в производительности. Набор IBM HR Analytics позволяет исследовать, как переменные лояльности и стабильности управления соотносятся с длительностью пребывания сотрудников и их вкладом в производственные KPI.
Практический вывод: данные IBM HR Analytics используют для построения обучающих дашбордов, анализа сценариев retention и тестирования гипотез о том, какие группы сотрудников требуют особого внимания в рамках программы развития и удержания.
Absenteeism: отсутствие сотрудников, сегментация по отделам и ролям
Данные по Absenteeism (отсутствие сотрудников) являются важной частью анализа рабочей среды и благополучия. Залогом эффективного анализа является наличие детализированных полей, позволяющих сегментировать отсутствие по отделам, ролям, локациям и другим характеристикам, чтобы выявлять закономерности и закономерности.
Основные переменные absenteeism включают:
- Annual absent hours - общее количество часов отсутствия за год;
- Department, Division, и Business Unit - контекст организации;
- Job Title - роль;
- City/Store Location - географический контекст;
- Length of Service - стаж;
- возможно, причины отсутствия и типы отсутствия (болезнь, отпуск и т. п.).
Анализ может включать сравнение по департаментам и ролям, выявление локальных различий между городами и розничными точками (если применимо), исследование взаимосвязи между отсутствием и уровнем удовлетворенности или вовлеченности, а также анализ влияния отсутствия на производственные показатели и качество работы. В целом, Absenteeism анализ требует деликатного обращения с данными, поскольку он может поддаваться стигматизации и требованиям к конфиденциальности.
Engagement survey (AIHR): данные вовлеченности и их применение в анализе и обучении
AIHR (Academy for Industry HR Research) предоставляет примеры и курсы, связанные с engagement-аналитикой. Engagement survey - это специфический набор данных, включающий результаты опросов сотрудников об их вовлеченности, а также контекстные переменные, например функция группы, отдел и менеджер. Этот набор служит для демонстрации того, как анализировать вовлеченность и как она коррелирует с различными результатами, такими как инновационное поведение, инициативность и намерение уйти.
Включаемые переменные могут включать:
- Engagement Score - общий балл вовлеченности;
- Innovation Behavior, Personal Initiative, Mobility Behavior - поведенческие индикаторы;
- Organizational and Professional Commitment - организационная и профессиональная приверженность;
- Task and role-context - контекстная информация о должности и руководителе.
Применение данных вовлеченности:
- анализ различий по отделам, уровням и регионам;
- тестирование гипотез о влиянии вовлеченности на удержание, производительность и развитие;
- использование для обучения руководителей и аналитиков методикам измерения и интерпретации вовлеченности.
Важно отметить, что данные engagement часто собираются через опросники, поэтому минимизация ошибок измерений и обеспечение этической части работы с участниками опроса являются критическими требованиями в академической и практической работе.
Pay equity: анализ оплаты равной ценности труда и контроль за дискриминационными паттернами
Pay equity относится к анализу оплаты с учетом ценности выполняемой работы и факторов, которые действительно объясняют различия в заработке. В рамках анализа equity рассматриваются регуляторные требования и принципы справедливости. В типичном случае анализ включает сравнение оплаты между сотрудниками, занимающими схожие должности в рамках одной организации, с контрольными переменными, такими как:
- Job Title и Department - для определения «одной и той же должности»;
- Gender - половая идентичность (для анализа различий);
- Tenure - стаж и возраст;
- Performance Rating - параметры производительности;
- Education и Contract Percentage - контракты и фон образования.
Цель Pay Equity - выявлять дискриминационные паттерны и предупреждать о скрытых дискриминационных практиках. Подходы к анализу включают сравнение среднего и медианного заработка между группами, а также регрессионный анализ с контролем за независимыми переменными. В контексте практики это требует соблюдения этических норм и надлежащего безопасного обращения с персональными данными, а также строгого аудита и документации методов.
Как вывод: анализ оплаты должен сопровождаться мониторингом и корректировкой практик оплаты, обеспечением прозрачности и доверием сотрудников к системе вознаграждений.
Campus recruitment: факторы трудоустройства выпускников и прогнозы зарплат и размещения
Campus recruitment фокусируется на факторах, влияющих на трудоустройство выпускников и их размещение на рынках труда. Наборы данных для campus recruitment часто включают:
- Placement status - размещение (Placed/Not Placed);
- Salary - предлагаемая заработная плата;
- Academic performance scores (ssc_p, hsc_p, degree_p, mba_p) - показатели академической успеваемости;
- Education background (ssc_b, hsc_b, hsc_s, degree_t, specialisation) - образование и специализация;
- Work experience - прошлый опыт работы;
- Employability test score (etest_p) - показатель пригодности к работе.
Аналитическая задача здесь - моделировать вероятность размещения и прогнозировать зарплаты выпускников в зависимости от их академической подготовки, опыта и характеристик. Применение таких данных позволяет образовательным учреждениям и работодателям лучше координировать процессы найма выпускников, а также формировать стратегии по развитию талантов и размещению.
Remote/On-site/Hybrid wellbeing: режим работы, нагрузка и показатели благополучия
Современные рабочие режимы включают удаленную работу (remote), работу в офисе (on-site) и гибридную схему (hybrid). Аналитика благополучия в контексте разных режимов помогает понять, как режим работы влияет на стресс, баланс между работой и личной жизнью, а также на продуктивность.
Типичные переменные включают:
- Work Location - режим работы;
- Hours Worked per Week - часы рабочих в неделю;
- Work-life Balance rating - рейтинг баланса жизни и работы;
- Stress Level - уровень стресса;
- Mental Health Condition - состояние психического здоровья;
- Productivity Change - изменение продуктивности.
Задачи анализа включают сравнение стресса, баланса и благополучия между режимами, анализ влияния нагрузки на стрессы и изучение того, как гибкий график влияет на продуктивность и удовлетворенность. Этот анализ требует осторожности в обработке чувствительных данных, а синтетические наборы данных или обезличенные данные часто используются для обучения и моделирования без риска идентифицирования сотрудников.
Практические задачи и методика анализа: постановка вопросов, выбор метрик и построение дашбордов
Практическая аналитика начинается с постановки чётко сформулированного вопроса. Четко обозначенная задача позволяет определить необходимые переменные, корректные методы анализа и ожидаемые результаты. В рамках HR-аналитики распространены следующие типы вопросов:
- какие факторы наиболее сильно предсказывают уход сотрудника и как снизить текучесть?
- как вовлеченность сотрудников коррелирует с производительностью и удовлетворенностью?
- какие элементы оплаты и карьерного пути обеспечивают справедливость вознаграждений и минимизируют дискриминацию?
- как распределение по регионам и департаментам влияет на риски и возможности?
Выбор метрик должен быть привязан к бизнес-целям и может включать:
- показатели текучести, удержания, времени до найма и качества найма;
- показатели вовлеченности, удовлетворенности и благополучия;
- показатели оплаты в рамках salary grid и equity;
- бизнес-метрики производственных подразделений и производственные KPI.
Построение дашбордов требует учёта аудитории: руководители заинтересованы в агрегированном навыке принятия решений и стратегических выводах, в то время как аналитики - в детализированной информации и воспроизводимости. Рекомендована практика создания модульных дашбордов, ясной визуализации и пояснений к выводам, а также наличие «слоёв» детальности: высокий уровень для руководителей и детальная страница для аналитиков.
Создание синтетических HR-наборов данных: принципы, алгоритмы и проверки качества
Синтетические данные приобретают всё большую роль как безопасная альтернатива реальным данным для практики обучения и тестирования методик анализа. При создании синтетических наборов необходимо соблюсти ряд принципов:
- соответствие структуры: синтетические данные должны сохранять корреляции и распределения, характерные для реальной выборки, но не повторять конкретные лица;
- обезличенность: прямые идентификаторы исключаются, переменные на уровне индивидуума не позволяют восстановить реальных сотрудников;
- валидированность: синтетический набор должен быть валиден с точки зрения статистики и бизнес-логики, чтобы аналитические выводы не были искаженными;
- проверка на непреднамеренную идентификацию: устраняются потенциальные сочетания переменных, которые могут привести к распознаванию отдельных сотрудников.
Алгоритмические подходы к синтетическим данным в HR включают:
- генеративные модели (например, вариационные автоэнкодеры, генеративные состязательные сети) для сохранения внутренней структуры переменных;
- методы переименования и перестановки, сохранение корреляций между переменными;
- правила с учетом реальных бизнес-логик и временных зависимостей;
- контроль над качеством через статистические тесты, сравнение с оригинальными наборами и проверку на отсутствие идентифицируемой информации.
Проверки качества включают:
- проверку распределений по ключевым переменным;
- сравнение корреляций и зависимостей;
- аудит и верификацию со стороны экспертов по данным;
- тестирование на идентификацию, чтобы исключать возможность восстановления реальных лиц.
Синтетические наборы полезны для обучения сотрудников, построения дашбордов и тестирования гипотез без риска утечки персональных данных или нарушения конфиденциальности.
Инструменты и рабочие процессы: Excel, Power BI, SQL, Python; совместная работа команд
Для эффективной реализации People Analytics необходим комплекс инструментов и процедур, обеспечивающих продуктивность, повторяемость и сотрудничество между командами. Основные инструменты включают:
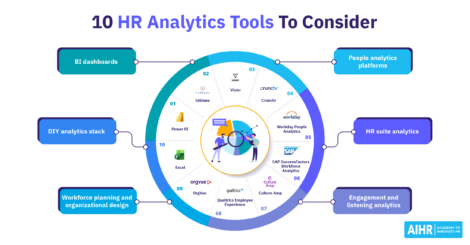
- Excel и Power BI - для быстрой загрузки, очистки и визуализации данных. Excel удобен для начального анализа и манипуляции данными, в то время как Power BI предоставляет мощные возможности визуализации, взаимодействия и совместной работы через общие отчеты и дашборды.
- SQL - язык структурированных запросов, который обеспечивает доступ к данным в реляционных базах данных, позволяет выполнять выборки, агрегации и сложные фильтры.
- Python - универсальный язык для анализа данных, статистики, машинного обучения, подготовки и автоматизации. Используется для обработки больших наборов, построения моделей и автоматизации пайплайнов.
- R - также применяется для статистического анализа, особенно в академической среде и при выполнении специфических тестов.
- Системы управления проектами и репозитории кода (например, Git) - для обеспечения версионности и совместной работы над кодом анализа и дашбордов.
- Инструменты управления данными и каталогами (Data Catalog) - для описания и классификации переменных, источников и процессов обработки.
Рабочие процессы включают:
- дизайн-спринты аналитических проектов: формулирование вопросов, выбор наборов данных, методологии и критериев успеха;
- контроль версий данных и кода анализа;
- процесс ревью и утверждения: участие стейкхолдеров;
- документирование и создание кодексов: комментарии, код-библиотеки и руководства по воспроизводимости;
- процедуры аудита безопасности и соответствия требованиям по конфиденциальности.
Интеграция инструментов должна обеспечивать бесперебойный поток данных от источников к дашбордам, с учетом правил доступа и конфиденциальности.
Интеграция технологических стеков: HRIS, ATS, BI-платформы и аналитическая среда
Интеграция технологических стеков - критически важный элемент архитектуры HR-данных. Уровни интеграции включают:
- HRIS (Human Resources Information System) как источник базовой кадровой информации;
- ATS (Applicant Tracking System) для данных о найме и кандидатах;
- BI-платформы (Business Intelligence) для визуализации и дашбордов;
- аналитические среды (Python/R, Jupyter, notebooks) для исследований и моделирования;
- Payroll и Time & Attendance для данных о заработной плате и учёте времени;
- Системы обучения и развития для данных о росте и обучении;
- Data Governance и Data Privacy слои для политик и контроля.
Интеграция требует:
- единого идентификатора сотрудников (Master Data Management) и согласованных схем идентификации;
- текущей и точной метаданные и словарей;
- согласованных форматов и структур данных;
- механизмов мониторинга качества данных и аудита доступа;
- политики обновления и синхронизации между системами.
Ключ к успешной интеграции - не только собрать данные, но и привести их к единому контексту для анализа, обеспечить правовую и этическую соответствие, а также поддерживать согласование бизнес-целей и IT-стратегии.
Применение в экономических секторах: отраслевые сценарии использования People Analytics
Применение People Analytics варьирует в зависимости от отрасли и бизнес-модели. В производстве и промышленности аналитика может фокусироваться на текучести, квалификации и обучении, оптимизации графиков смен и поддержке безопасности труда, где данные сотрудников напрямую воздействуют на производственные KPI. В секторе услуг и финансовых услуг особенно важна аналитика широкого спектра факторов вовлеченности, качества обслуживания и удержания ключевых профессионалов. В здравоохранении - безопасность пациентов и управление персоналом в условиях высокого стресса и сменности. В IT-секторе - управление талантами, удержание специалистов и эффективность распределения проектов.
Отраслевые сценарии требуют адаптации источников данных, появления специфических переменных и учета регуляторных ограничений. В каждой отрасли важна адаптация процессов обработки данных, обеспечение прозрачности, этических вопросов и соответствия требованиям к конфиденциальности.
Анализ рисков, уязвимостей и ограничений: метрики эффективности, валидация и управление рисками
Любая аналитическая инициатива требует системного подхода к управлению рисками, включая:
- риск утечки данных и нарушение конфиденциальности: обеспечение защиты и ограничение доступа;
- риск ошибок в данных и моделях: контроль качества, аудит и верификация;
- риск дискриминации и предвзятых выводов: тестирование fairness, мониторинг и регулярный аудит моделей;
- риск несоответствия регуляторным требованиям: соответствие GDPR, локальным законам по защите данных и корпоративной политики;
- риск внедрения и эксплуатации: оценка ресурсов, компетенций и поддержания инфраструктуры;
- риск неправильной интерпретации: обеспечение объяснимости и прозрачности методов и выводов.
Метрики эффективности в рамках анализа рисков включают точность моделей, полноту и качество данных, устойчивость к изменению источников, а также способность поддерживать управленческие решения без риска для сотрудников. Валидация проводится через перекрестную проверку, тестовые данные и внешнюю экспертизу.
Конкурентный анализ решений и их дифференциация: сравнение подходов и преимуществ
На рынке решений для People Analytics существует широкий спектр инструментов и подходов. При выборе подхода к аналитике в корпоративной среде следует учитывать:
- гибкость и управляемость платформ;
- возможность интеграции с существующими HRIS, ATS и BI-платформами;
- качество поддержки данных и возможность соблюдения требований к безопасности;
- функциональные возможности по моделированию, прогнозированию и визуализации;
- стоимость владения и требования к инфраструктуре;
- уровень поддержки синтетических данных и обучающих материалов;
- поддержка аудита и возможности соблюдения этических норм.
Ключ к дифференциации - установление четких критериев в контексте целей организации и организационной культуры, чтобы выбрать инструменты и подходы, которые обеспечат максимальную ценность без компромиссов по конфиденциальности и законности.
Кейсы применения в реальных сценариях: демонстрационные примеры на основе наборов данных
Кейсы в реальном мире иллюстрируют, как концепции, архитектуру и методологии применяются в практике. Примеры кейсов могут включать:
- анализ текучести и выявление её драйверов по отделам и регионам с последующим внедрением программ удержания;
- оценку эффективности программ обучения и их влияние на производительность;
- проверку справедливости оплаты и корректировку зарплат в рамках salary grid;
- анализ эффективности источников найма и оптимизация бюджета найма;
- исследование влияния удаленного, гибридного и офлайн-режима на благополучие и продуктивность;
- построение пилотных моделей attrition и производительности и их внедрение в управленческий процесс.
Кейсы в рамках синтетических наборов данных позволяют отрабатывать методики без риска для реальных сотрудников и предоставить репродуктивные примеры для обучения и сертификации.
Выводы и направления дальнейших исследований
В заключение следует отметить, что People Analytics - это не только набор технических инструментов, но и управляемый процесс, требующий междисциплинарного подхода. Архитектура HR-данных должна строиться не только для обработки данных, но и для поддержки этически оправданных решений, соблюдения прав сотрудников и устойчивой бизнес-модели. Этические принципы, правовые требования и принципы конфиденциальности - неотъемлемая часть любой аналитической инициативы, и их внедрение должно сопровождаться обучением сотрудников и усилением контроля над процессами.
Далее представляются направления для будущих исследований и практик:
- развитие методик синтетических данных и их валидации для разных отраслей;
- углубление практик fairness и устойчивости моделей в HR-контексте;
- создание унифицированных стандартов по метрикам и словарям данных для HR-аналитики;
- развитие интеграционных архитектур, позволяющих безопасно масштабировать аналитическую инфраструктуру;
- дальнейшее исследование отраслевых кейсов и сценариев применения в условиях глобальной экономики.
В целом, комплексное внедрение People Analytics требует системного подхода к архитектуре данных, этике, правовым рамкам и практическим методикам анализа, чтобы организация могла превращать данные сотрудников в ценность и устойчивый конкурентный фактор.
Вопрос-Ответ:
- Вопрос: Что является основой успешной реализации People Analytics? Ответ: Эффективная архитектура HR-данных, соблюдение правовых и этических рамок, качественные данные, понятные методики анализа и активное вовлечение стейкхолдеров.
- Вопрос: Какие ключевые переменные включать в Core HR dataset? Ответ: Идентификатор сотрудника, демография, департамент, должность, регион, дата найма, дата увольнения, зарплата/диапазон оплаты, рейтинг эффективности, аттриция, менеджер, локация и стаж.
- Вопрос: Как минимизировать риск утечки конфиденциальности в анализе? Ответ: Применять псевдонимизацию и анонимизацию, использовать синтетические данные для обучения и разработки, ограничивать доступ по ролям и контролировать использование данных.
- Вопрос: Какие преимущества предоставляет salary grid? Ответ: Обеспечивает внутреннюю справедливость, управляемость затрат и возможность анализа соответствия оплаты должности региональным условиям, что поддерживает прозрачность и справедливость выплат.
- Вопрос: Каковы ключевые ограничения HR-данных и как их преодолевать? Ответ: Пропуски, разнородность форматов и регуляторные ограничения; преодолеваются через стандартизацию форматов, управление качеством, создание синтетических данных и применение этических стандартов.
- Вопрос: Какие этапы включает практическая методика анализа? Ответ: Формулировка вопроса, выбор метрик, подготовка данных, анализ и моделирование, визуализация и дашборды, интерпретация и этическая валидность выводов.


