

Архитектура диспетчерской системы: пайплайны, оркестрация, микросервисы
Данная глава рассматривает архитектуру диспетчерской системы как основную опору для реализации, мониторинга и интерпретации метрик качества прогноза спроса: MAPE, Bias и Forecast Accuracy. В современном контуре цифровой трансформации расчёты прогноза не существуют в изоляции от операций: прогноз влияет на цепочки поставок, планирование запасов, ценообразование и сервисное обслуживание клиентов. Эффективная архитектура обеспечивает не только точность метрик, но и воспроизводимость вычислений, управляемость изменений моделей и прозрачность данных.
Ключевые принципы, которые здесь раскладываются: четкие контракты данных, управляемая инфраструктура микросервисов, надёжная оркестрация задач, обработка потоков событий и достаточный уровень мониторинга. Рассматриваемые паттерны применимы как к данным из ERP и POS, так и к внешним источникам и данным IoT. В фокусе - способность быстро развернуть новые версии моделей, сохранять историю результатов и интерпретировать отклонения в метриках в контексте бизнес-целей.
- Определение архитектуры как инструмента обеспечения повторяемости и надёжности расчётов метрик прогноза.
- Проектирование пайплайнов от источников до расчётов метрик и их визуализации.
- Оркестрация зависимостей, обработка ошибок и управление изменениями в моделях и данных.
- Интеграция микросервисной архитектуры, контрактов данных и событийно-ориентированных коммуникаций.
- Мониторинг, алерты и управление качеством данных и прогноза.
Общая архитектура диспетчерской системы
Архитектура диспетчерской системы объединяет источники данных, вычислительные сервисы и механизмы контроля исполнения, которые превращают поток информации в управляемые прогнозы и метрики. В этой структуре ключевые слои включают: слой данных, слой моделей и слой оркестрации. Между ними выстроены чёткие контракты данных и протоколы взаимодействия.
Системная карта обычно включает следующие компоненты:
- Источники данных: POS-системы, ERP, CRM, транспортные сенсоры, веб-аналитика и сторонние поставщики спроса. Источники должны поддерживать согласованные формы идентификаторов, временные метки и единицы измерения.
- Ингестор данных: сбор и нормализация данных через батч и потоковую обработку. Важна поддержка гарантий доставки (at-least-once, exactly-once в критичных случаях) и минимизация задержек.
- Хранилище и контракты данных: data lake или lakehouse, а также хранилища временных рядов. Контракты данных фиксируют схему, допустимые значения и сигнатуры качества.
- Feature Store: проведение и хранение признаков, используемых моделями, с версиями и зависимостями. Это обеспечивает согласованность между обучением и inference.
- Модуль моделей и реестр моделей: хранение версий моделей, метаданных, параметров и сценариев валидации.
- Сервис прогнозирования: единый API для получения прогноза, с учётом временного контекста и ограничений latency.
- Сервис оценки: вычисление метрик качества (MAPE, Bias, Forecast Accuracy) на заданных горизонтах и для выбранных сегментов.
- Система оркестрации: управление потоками данных и задач, зависимостями, retries и мониторингом x-complete.
- Платформа мониторинга и визуализации: дашборды по метрикам модели, качеству данных, инцидентам и SLA.
Чтобы обеспечить масштабируемость и устойчивость, архитектура опирается на протоколы обмена сообщениями (например, Kafka или RabbitMQ), REST/gRPC для синхронного взаимодействия, а также на стандарты сериализации (Avro, Protobuf). Важной составляющей является совместная работа между командами: данные, ML-инженеры, эксплуатация и бизнес-аналитики. Договоренности по данным и протоколам должны быть отражены в документации контрактов и в согласованных схемах обмена.
{
  "schemaVersion": "1.0",
  "payload": {
    "timestamp": "2025-12-01T10:00:00Z",
    "store_id": "ST01",
    "sku": "ABC123",
    "actual_demand": 124,
    "forecast_demand": 118
  }
}
Вопросы архитектурной целесообразности и выбора технологий следует рассматривать через призму операционных ограничений: требуемое время отклика, размер данных, частота обновления прогнозов и уровень риска ошибок в бизнес-процессах. Архитектура должна быть гибкой и допускающей замену компонентов без риска «протечек» в цепочке данных и в логике вычислений метрик.
Пайплайны данных: от источников к метрикам
Пайплайны данных являются костяком расчётов качества прогноза. Они должны обеспечивать прозрачность, воспроизводимость и контроль качества на каждом шаге: от извлечения данных до вычисления метрик.
Ключевые принципы:
- ELT-подход с явной стадией преобразования и загрузки в целевые хранилища, где признаки подготавливаются для моделей и валидаций.
- Встроенные проверки качества на каждом этапе: валидность форматов, диапазонов, отсутствия пропусков и согласованности идентификаторов.
- Линии данных и код контракты: регистрация происхождения данных, версия данных, трассируемость изменений и возможности отката.
- Управление временными окнами: для метрик важно объявлять горизонты и правила агрегации (rolling, tumbling окна) и учитывать задержку данных.
- Совместимость обучающих и инференс-данных: хранение и версия признаков в feature store, чтобы вычисления метрик на референсных тестах и в проде были сопоставимы.
Пайплайны включают следующие этапы:
- Ингестиция и нормализация: привязка к временным меткам, привязка к контекстам (магазин, зона, сезон).
- Очистка и обогащение: обработка пропусков, коррекция ошибок, агрегации на стороне источников.
- Расчёт признаков и подготовка фич: стандартные преобразования, нормализация, создание оконных признаков.
- Верификация данных: автоматические проверки валидности, мониторинг качества данных и сигнализация отклонений.
- Расчёт метрик: вычисление MAPE, Bias и других интервалов точности на заданных горизонтах и под сегментами.
- Архивирование и публикация: сохранение метрик, метаданных и артефактов модели в реестры.
Контракты данных здесь особенно критичны. Форматы файлов и потоков должны быть согласованы между поставщиками данных и сервисами прогноза. Валидация схемы на входе в систему предотвращает «расползание» неконтролируемых изменений и снижает риск ошибок в расчётах.
import numpy as np

def compute_metrics(actual, forecast):
    actual = np.asarray(actual, dtype=float)
    forecast = np.asarray(forecast, dtype=float)
    mask = actual != 0
    if not np.any(mask):
        return {"MAPE": None, "Bias": None}
    mape = np.mean(np.abs((actual[mask] - forecast[mask]) / actual[mask])) * 100
    bias = np.mean(forecast[mask] - actual[mask])
    return {"MAPE": float(mape), "Bias": float(bias)}
Управление качеством данных требует встроенных механизмов контроля: автоматическая проверка на пропуски, аномалии, консистентность идентификаторов, и сигналы тревог при нарушении контрактов данных. Эффективная архитектура предусматривает задержку между обновлением данных и публикуемыми метриками, чтобы исключить «ложные» сигналы из-за неполной информации.
Оркестрация процессов: потоковая обработка и зависимые задачи
Оркестрация формирует управляемый, воспроизводимый и устойчивый процесс расчётов. В диспетчерской системе существует множество зависимостей: обновление данных, расчёт признаков, ранжирование гипотез, обновление моделей и вычисление метрик. Эффективная оркестрация обеспечивает следующие возможности:
- Декларирование зависимостей между задачами: задача подготовки данных должна завершиться до начала вычисления метрик.
- Idempotency и повторное выполнение: повторные попытки без побочных эффектов, корректное перерасчёт метрик при повторном запуске.
- Гибкое расписание: периодическая переобучение и расчёт метрик на основе актуальных данных или триггеры на входных данных.
- Управление состоянием и аудит: хранение журналов выполнения, версий артефактов и изменений в конфигурациях.
- Обнаружение и обработка ошибок: механизм предупреждений, автоматическое переключение на резервные потоки и безопасный rollout.
На практике выбирают инструменты оркестрации, подходящие под организационные требования: Airflow, Prefect, Dagster или Kubeflow. В архитектурном проекте целесообразно определить следующие паттерны:
- DAG-структуры с четкими зависимостями: сбор данных** - обработка - вычисление признаков - модель - метрики - публикация.
- Обособленные рабочие потоки для обучения и инференса, чтобы минимизировать воздействие изменений в одной цепочке на другую.
- Контейнеризация задач и минимизация состояния в задачах: хранение состояния в внешних системах (базы данных, object storage).
- Оповещения и эскалация: автоматическое уведомление команд в случае задержек или ошибок, и наличие резервных конфигураций для критичных сценариев.
Пример простой концептуальной DAG-логики может быть представлен так:
- Ежечасная загрузка данных из источников.
- Обогащение данных и построение фич.
- Обновление признаков в feature store.
- Вызов модели и получение прогноза.
- Вычисление и публикация метрик.
- Обновление дашбордов и алертов.
## Псевдодекларирование в Airflow (для иллюстративности)
from airflow import DAG
from airflow.operators.python_operator import PythonOperator
from datetime import datetime

def extract():
    pass  # ingestion

def transform():
    pass  # cleaning & feature engineering

def forecast():
    pass  # call model service

def evaluate():
    pass  # compute MAPE, Bias

with DAG('forecast_pipeline', start_date=datetime(2025,1,1), schedule_interval='@hourly') as dag:
    t1 = PythonOperator(task_id='extract', python_callable=extract)
    t2 = PythonOperator(task_id='transform', python_callable=transform)
    t3 = PythonOperator(task_id='forecast', python_callable=forecast)
    t4 = PythonOperator(task_id='evaluate', python_callable=evaluate)

    t1 >> t2 >> t3 >> t4
Управление оркестрацией в условиях реального времени требует поддержки потокового исполнения и гибкости в распределении задач. В некоторых случаях целесообразна гибридная конфигурация: батч-обновление ночью и потоковые обновления в реальном времени для критичных сегментов. В любом случае архитектура должна поддерживать трассировку выполнения и детальную диагностику на уровне каждого шага.
Микросервисы и интеграции
Микросервисная архитектура позволяет разделить функциональность на независимые, заменяемые и масштабируемые компоненты. В контексте прогноза спроса ключевые сервисы обычно включают:
- Data Ingress Service: обобщение получаемых данных, нормализация форматов, защитa от неконсистентности.
- Feature Store Service: управление признаками, версиями признаков и зависимостями между признаками и моделями.
- Model Registry and Inference Service: хранение версий моделей, выбор модели для конкретного горизонта или сегмента, сервис инференса с минимальной задержкой.
- Evaluation Service: расчёт метрик качества и генерация отчетов.
- API Gateway и Authentication: управление доступом, маршрутизацией и безопасностью.
- Event Bus/Message Broker: обмен событиями о прогрессе пайплайнов и их результатами (напр., Kafka).
Контракты данных и интерфейсы являются центральной частью интеграций. В документации контрактов должны быть определены:
- Форматы и схемы входных и выходных данных (примеры: actual, forecast, timestamps, SKU, store_id).
- Требования к порядку и консистентности событий, обработка задержек и повторных отправок.
- Нормализация единиц измерения и временных зон.
- Обоснование версии контрактов и миграций.
Типовые протоколы взаимодействия включают:
- REST/gRPC для упрощённых вызовов между сервисами инференса и метрик.
- Kafka/RabbitMQ для асинхронных событий: обновления данных, результаты вычислений, алерты.
- Прямые подключения к хранилищам для больших объектов (например, признаков) через безопасные каналы и доступы.
Пример контрактной схемы может выглядеть так (кратко):
- Входной контракт: timestamp, store_id, sku, actual_demand, external_factors.
- Выходной контракт: forecast_demand, confidence_interval, horizon, model_version.
Безопасность и доступ: микросервисы должны работать в изолированной среде, использовать маппинг ролей и политик доступа, шифрование данных в покое и в транзите, аудит операций и журналирование событий.
## Пример простой конфигурации микросервиса на Kubernetes
apiVersion: apps/v1
kind: Deployment
metadata:
  name: forecast-service
spec:
  replicas: 3
  selector:
    matchLabels:
      app: forecast-service
  template:
    metadata:
      labels:
        app: forecast-service
    spec:
      containers:
      - **name**: forecast-service
        image: registry.example.com/forecast-service:1.2.0
        ports:
        - **containerPort**: 8080
        env:
        - **name**: MODEL_VERSION
          value: "v1.2.0"
Дальнейшее развитие инфраструктуры предполагает внедрение сервис-мейд-архитектур: распределённое журналирование, трассировка запросов, централизованный сбор логов, мониторинг задержек и ресурсов. Поуправляемая оркестрацией, микросервисы позволяют гибко внедрять обновления моделей и изменений в пайплайнах без нарушения работы системы в целом. Важной задачей является обеспечение совместимости между версиями моделей и признаков, чтобы выводимые метрики всегда соответствовали истинному режиму вычислений.
Контроль качества прогноза: метрики, мониторы и алерты
Расчёт MAPE, Bias и других метрик требует ясной стратегии, чтобы интерпретации были корректными и полезными для бизнеса. В контексте диспетчерской системы это означает не только вычисление метрик, но и грамотную интерпретацию их значений в рамках горизонтов прогноза, сегментов клиентов и товарных категорий.
Основные концепты:
- Прозрачная методология расчётов: определение горизонтов (например, дневной, недельный), окон расчетов и использования пропусков.
- Контекстная интерпретация: сравнение метрик между сегментами по магазинам, SKU, регионам, и сезонности.
- Валидация на практических сценариях: backtesting по историческим данным, оценка устойчивости к шуму и выбросам.
- Управление порогами: установление пороговых значений для MAPE и Bias, которые вызывают алерты и процессное реагирование.
- Drift и концептуальные изменения: мониторинг дрейфа калибровки и логика переработки моделей, когда метрики выходят за пределы допустимых диапазонов.
MAPE и Bias - не независимые показатели: для корректной интерпретации полезно анализировать их совместно. Например, систематический положительный Bias может означать устойчивое недооценивание спроса в ключевых сегментах, что приводит к избыточному запасу на складе. С другой стороны, высокий MAPE может быть следствием редких экстремальных событий или неправильной агрегации. Здесь важны:
- Разделение метрик по сегментам и по горизонту прогноза.
- Мониторинг склонности ошибок в зависимости от значений фактического спроса.
- Валидация, что метрики считают именно те случаи, которые критичны для операций (например, ближайшее время до планируемого пополнения запасов).
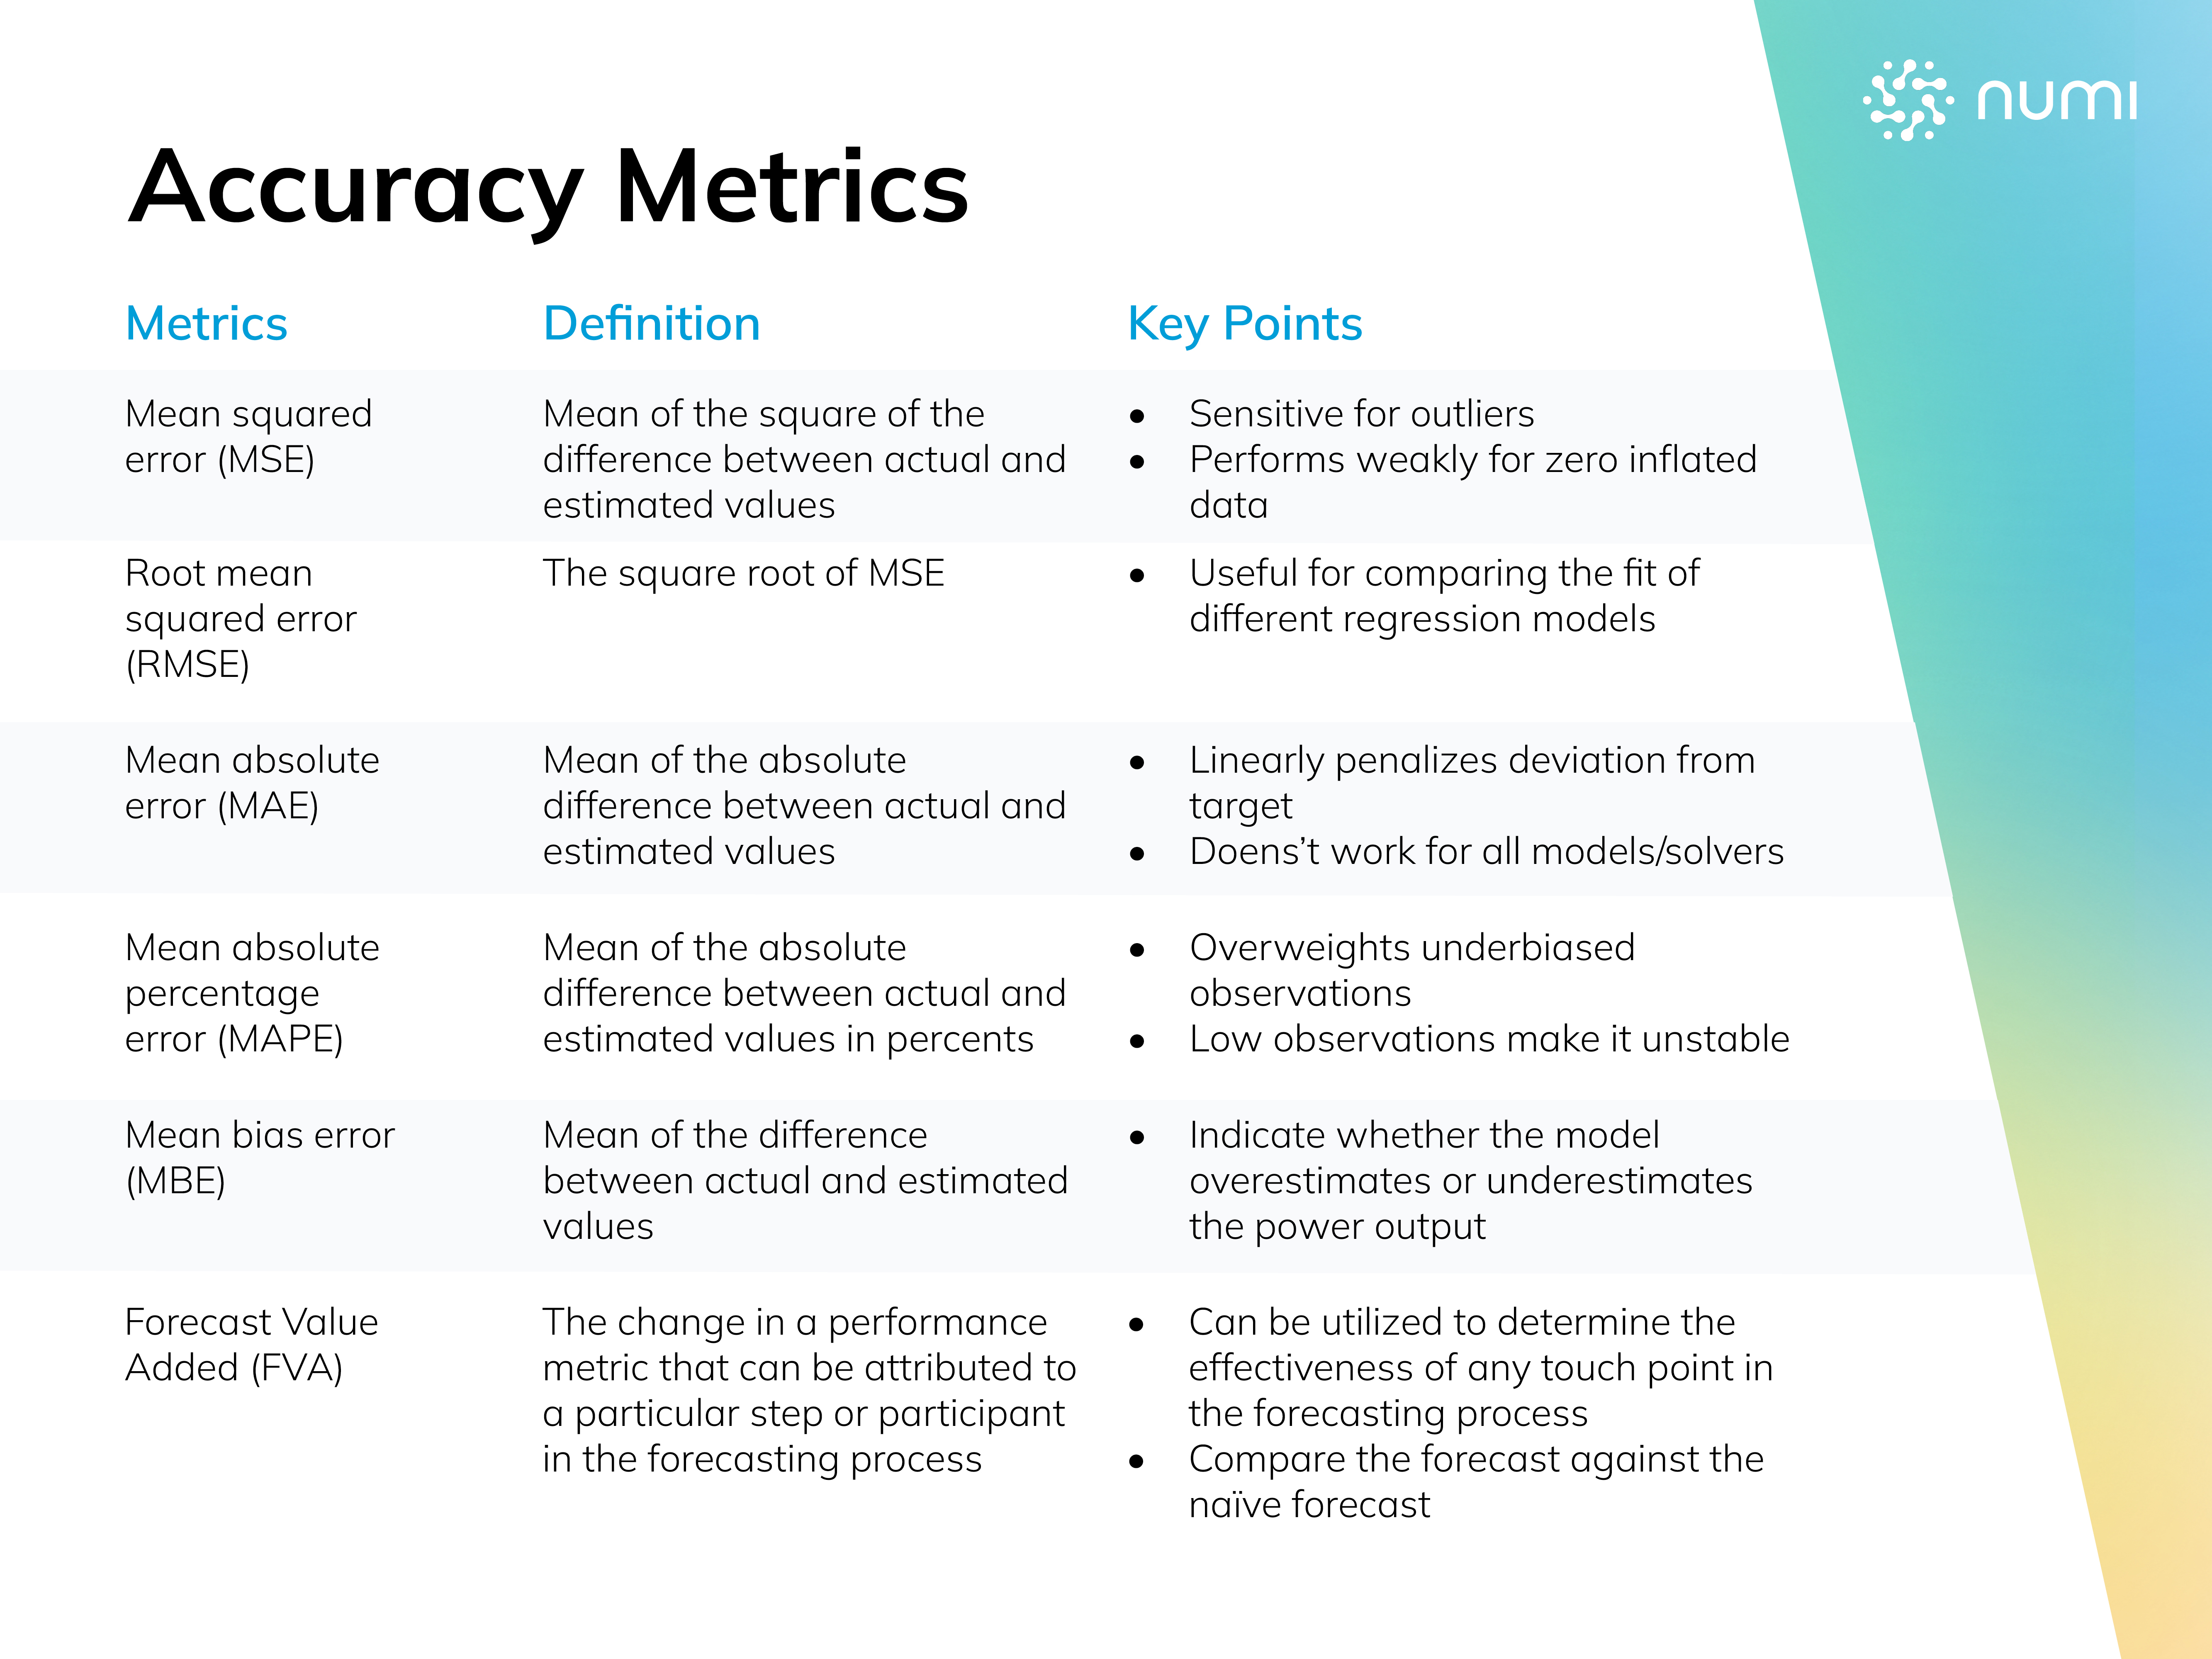
Реализация мониторов включает:
- Дашборды в BI/дашбордах мониторинга модели.
- Алерты по порогам и автоматизированные ответы (перезапуск пайплайна, переключение на резервную модель).
- Регистрация и сохранение истории метрик для последующего анализа и аудита.
def interpret_metrics(mape, bias, horizon, segment): messages = [] if mape is None: messages.append("Метрики недоступны: данные отсутствуют или невалидны.") return "\n".join(messages) if mape > 20: messages.append(f"Высокий MAPE на горизонте {horizon} для сегмента {segment}. Требуется ревизия модели и данных.") if abs(bias) > 5: messages.append(f"Заметный Bias ({bias}) - систематическая пере- или недооценка спроса.") if horizonИнструменты монитора должны обеспечивать прозрачность вычислений и возможность воспроизведения. В идеале к каждому вычислению метрик привязываются версии данных, версии признаков, версии моделей и параметры конфигурации, чтобы можно было реконструировать источник ошибок.
Интеграции, безопасность и масштабируемость
Безопасность данных и доступ к сервисам - важнейшие аспекты архитектуры диспетчерской системы. Управление доступами, аудит и контроль версий остаются критически важными при работе с коммерчески чувствительной информацией и данными клиентов. Реалистичное решение включает:
- Управление идентификацией и доступом (IAM): минимальные привилегии, аутентификация сервисов через service accounts и манифесты.
- Шифрование: данные в покое и в транзите, защита секретов и конфигураций.
- Логирование и аудит: полная трассируемость изменений, включая данные об обновлениях моделей и конфигураций.
- Приватные сети и сегментация: ограничение доступа между сервисами, применение политики сетевой безопасности.
- Масштабируемость: горизонтальное масштабирование сервисов, управление ресурсами через Kubernetes или аналогичные оркестрационные платформы.
- Обеспечение согласованности: версия контракта данных и миграции между версиями признаков и моделей.
Упомянутые примеры инструментов следует использовать там, где они действительно повышают надёжность и скорость развертывания. В рамках технической практики чаще применяют такие решения, как Apache Airflow или Dagster для оркестрации, Apache Kafka как платформа потоковых данных и Kubernetes как платформа оркестрации контейнеров. Важно ограничиться 1-2 известных инструментов на раздел и сосредоточиться на том, как они работают в контексте конкретной задачи.
Реальные паттерны реализации и сценарии внедрения
Эффективная архитектура основывается на повторяемых паттернах. Ниже приведены два примера, которые часто применяются в диспетчерских системах, работающих с прогнозами спроса и их метриками.
- Паттерн «Model as a Service» с Feature Store как источником признаков: сервис инференса вызывает предикторы, которые берут признаки из центрального хранилища признаков, а расчёт метрик осуществляется отдельной службой. Такой подход обеспечивает консистентность между обучением и инференсом и минимальные задержки при ретренинге модели.
- Паттерн «Event-driven evaluation»: каждое обновление данных порождает событие, которое инициирует расчёт метрик и публикацию отчётов. Это обеспечивает своевременную реакцию на изменения спроса и позволяет оперативно обнаруживать отклонения.
Применимо сочетание: архитектура должна быть рассчитана на гибкую интеграцию новых типов данных, новых моделей и новых источников данных. Важна обратная совместимость и возможность постепенного перехода на новые версии без остановки существующих операций.
## Пример простой гипотетической архитектурной схемы
## Инструкция по сцене взаимодействия между сервисами
## Ингестор -> Предобработка -> Feature Store -> Модель -> Метрики -> Публикация

## В иллюстративном виде текстуальная диаграмма
## Ингестор данных публикует события в Topic "raw-data".
## Предобработка читает "raw-data", пишет в "cleaned-data".
## Feature Store хранит признаки (feature vectors).
## Модель читает признаки и публикует прогноз в "forecasts".
## Метриках сервис читает прогноз и реальные данные, вычисляет MAPE/Bias, публикует в "metrics".
Важно подчеркнуть, что внедрение требует управляемого перехода от текущей архитектуры к целевой. Стратегия может включать постепенную миграцию частей пайплайнов, модульное тестирование взаимодействий и эволюцию контрактов данных. Этот подход позволяет минимизировать риски и сохранить бизнес-пользовательский опыт.
Безопасность, качество данных и масштабируемость (практические принципы)
- Документация контрактов и регламентов: заранее описанные форматы, единицы измерения, временные зоны и поля схем. Это снижает риск несоответствий между учётом и инфраструктурой.
- Контроль качества: автоматизация тестов на входящих данных, тесты на регрессии метрик и системные проверки в пайплайнах.
- Версионирование инфраструктуры: хранение версий конфигурации и литератов моделей для регрессионного анализа и аудита.
- Мониторинг и алерты: интеграция в единый центр мониторинга, чтобы обнаруживать задержки в пайплайнах, падения сервисов и аномалии в метриках.
- Масштабируемость: горизонтальное масштабирование критических сервисов и устойчивые задержки в потоках данных. При этом важно избегать «цепочек» в которых задержка одного элемента вызывает лавинообразные задержки в других частях пайплайна.
После внедрения архитектуры важно поддерживать культуру обмена знаниями между командами, документировать ключевые решения и проводить периодические аудитории на соответствие бизнес-целям, качеству данных и требованиям к безопасности.
Key takeaways
- Архитектура диспетчерской системы должна обеспечивать воспроизводимость расчётов метрик, устойчивость к ошибкам и возможность масштабирования.
- Пайплайны данных связывают источники, признаки, инференс и метрики в единый цикл, где контракт данных и качество на каждом этапе критичны.
- Оркестрация задач требует надёжности, идемпотентности и гибкости расписания, чтобы поддерживать как батчевые, так и стриминговые режимы.
- Микросервисная архитектура с чёткими контрактами и асинхронной коммуникацией упрощает обновления и мониторинг, но требует тщательной архитектурной проработки по безопасности и совместимости версий.
- Метрики качества прогноза (MAPE, Bias, Forecast Accuracy) должны расчётно сопровождаться контекстом (горизонтом, сегментами, сезонностью) и быть интегрированы в алерты и бизнес-аналитику.
- Контроль качества данных и данных о моделях должен быть встроен в каждый уровень пайплайна, включая версионирование, трассировку и аудит.
- Реализация паттернов Model as a Service и Event-driven evaluation обеспечивает гибкость и быструю адаптацию к изменениям бизнес-требований.
FAQ
- Какие преимущества дадут пайплайны данных, ориентированные на метрики качества прогноза?
- Они обеспечивают воспроизводимость вычислений, прозрачность источников ошибок и возможность оперативного реагирования на отклонения в метриках. Это позволяет бизнесу быстро принимать решения по замене модели, переработке признаков или обновлению данных.
- Как выбрать между батчевой и потоковой обработкой в пайплайнах прогноза спроса?
- Батчевая обработка лучше подходит для периодических обновлений с полной переработкой за день/ночь и меньшей задержкой в инфраструктуре. Потоковая обработка необходима, когда бизнес требует минимальной задержки и оперативной реакции на изменения спроса. В реальности часто применяют гибрид: ночной батч для обучения и потоковые обновления для критических сегментов.
- Какие данные считается критически важными для точности MAPE и Bias?
- Важны данные по фактическому спросу, времени и контекстам (магазин, SKU, регион), а также временные метки и связанная информация об операциях (акции, промо-события). Неполнота или несоответствие таких данных напрямую влияют на качество метрик.
- Как обеспечить совместимость версий признаков и моделей в проде?
- Вводят строгий реестр версий (Model Registry и Feature Store версии). Любая новая модель должна иметь согласованные версии признаков и контрактов данных. При релизах версий выполняются регрессионные тесты и backtesting на исторических данных.
- Что считать «порогами» для алертов по MAPE и Bias?
- Пороги зависят от бизнес-контекста и горизонтов. Обычно MAPE выше 10-20% для коротких горизонтов считается тревожным и требует анализа. Bias более чем на 2-5% в абсолютной величине у сегмента может сигнализировать систематическую проблему в моделях или данных.
- Какие технологии предпочтительнее для оркестрации и почему?
- Для оркестрации часто выбирают Airflow, Dagster или Prefect в зависимости от требований к UX, тестированию и масштабированию. Airflow хорошо подходит для сложных DAG, Dagster - для типовой разработки и тестирования, Prefect - для гибкой динамической конфигурации. Важно обеспечить согласованность между инструментами и вашими контейнеризированными сервисами.
- Как обеспечить безопасность при обмене данными между сервисами?
- Использовать аутентифицированные каналы (OAuth2, mTLS), шифрование данных, ограничение доступа на уровне сервисов и ролей, хранение секретов в безопасных секциях, аудит действий и журналирование изменений. Регулярные пентесты и контроль соответствия требованиям также необходимы.
- Можно ли обойтись без feature store в архитектуре?
- В некоторых случаях возможно, но это увеличивает риск рассинхронности между обучением и инференсом. Feature store обеспечивает версионирование признаков, согласованность между обучением и предсказаниями, а также упрощает повторное использование признаков в разных моделях и цепочках.
- Как интегрировать мониторинг метрик с бизнес-целями?
- Связать значения метрик с бизнес-метриками (например, издержки запасов, складские резервы, удовлетворенность клиентов). Это позволяет формулировать алерты по бизнес-рискам и повышать ценность прогноза в операциях.
- Какие практические шаги для начала внедрения архитектуры диспетчерской системы?
- Определить набор источников данных и требования к времени обновления, зафиксировать контракты данных, выбрать инструменты оркестрации и инфраструктуры, спроектировать минимально жизнеспособный пайплайн с базовыми метриками, запустить пилот на ограниченном сегменте и затем масштабировать по мере готовности.


