

Управление данными и качество: профилирование, очистка, валидация
Качество данных выступает основой достоверности прогнозов спроса и планирования запасов. В контексте Demand Planning профилирование, очистка и валидация данных преобразуют разрозненные источники в управляемый набор фактов, на основании которых формируются сценарии спроса, бюджеты и сервисный уровень. Низкое качество данных ведет к неточным прогнозам, неверной оценке запасов и повышенным расходам на хранение, а также к разобщению между бизнес-подразделениями - продажами, логистикой и финансовым контролем. Поэтому управление данными должно рассматриваться как системная функция: не отдельный шаг, а непрерывный цикл улучшений, встроенный в процесс планирования.
В рамках этой главы представлены методологические принципы профилирования, очистки и валидации данных, а также организационные и технологические условия их устойчивой реализации. Основное внимание уделяется темпорам, ролям, процессам и архитектурным решениям, которые позволяют обеспечить единообразие данных на всех источниках и этапах планирования спроса.
- Цели и принципы обеспечения качества данных в Demand Planning.
- Процедуры профилирования, очистки и валидации: от концепций к практическим артефактам.
- Организационная модель управления качеством данных: роли, политики, правовые аспекты.
- Архитектура поддержки качества данных и интеграция с бизнес-процессами.
Понимание роли качества данных в Demand Planning
Качество данных прямо влияет на точность прогнозирования спроса и на качество принятых на его основе управленческих решений. В рамках класса данных, связанных с продажами, запасами, промо-акциями и календарными событиями, выделяются классические измерения качества: полнота (coverage), точность (accuracy), непротиворечивость (consistency), своевременность (timeliness), валидность (validity) и уникальность записей. Эти измерения применяются к каждому источнику данных: ERP-системам, CRM, платформам промо-аналитики, данным из дистрибуции и цепочек поставок.
Понимание контекста Demand Planning требует осознания того, что данные проходят через несколько стадий преобразований: сбор, интеграцию, агрегацию, расчеты и искажения. Промах на одном уровне может приводить к компоновке неверной картины на другом. Например, неполноценная история продаж за предыдущий период может исказить сезонные тенденции, а несогласованные правила единиц измерения - привести к неверной оценке спроса в разрезе SKU. Поэтому подход к качеству данных должен быть многомерным: учитываться как качество отдельных источников, так и согласованность между ними.
Ключевыми результатами этой части являются: определение критических источников данных для прогнозирования, формализация минимальных уровней качества, которые необходимы для начала расчета прогноза, и создание базовой карты рисков качества данных по каждому источнику. Важно обеспечить прозрачность: какие данные доступны, какие проходят валидацию, какие обходы допускаются и какие исключения требуют ручной проверки.
Процесс профилирования данных: методология и артефакты
Профилирование данных - это систематический сбор информации о свойствах данных, их распределении и связях между наборами. В Demand Planning профилирование помогает выявлять дефекты еще на ранних этапах, устанавливать пороги качества и документировать поведенческие паттерны источников.
Этапы профилирования можно условно разбить на следующие блоки:
- подготовка и определение области охвата: выбор наборов источников, временных окон, уровня детализации;
- сбор метаданных и базовых статистик: уникальность, пропуски, частотности, диапазоны значений, корреляции между полями;
- анализ качества по измерениям: полнота, точность, консистентность между источниками, консистентность по версиям и календарям;
- формализация правил профилирования: пороги, допустимые значения, скрытые зависимости;
- артефакты профилирования: отчеты профилирования, карта данных (data lineage), словари данных и справочники (data dictionaries), регламентированные конвенции именования и единиц измерения.
Артефакты профилирования служат основой для дальнейшей очистки и валидации. Они должны быть доступными для соответствующих ролей: бизнес-аналитиков по планированию, архітекторов данных, владельцев источников и стейкхолдеров Demand Planning. В идеале формируется дашборд профилирования, где оперативно видны отклонения от норм, динамика пропусков и изменение полноты по источникам.
Применение профилирования в рамках процессов Demand Planning обеспечивает ранние сигналы возможных искажений: например, резкое увеличение пропусков по данным продаж по конкретному каналу или SKU может указывать на проблему в системе продаж или задержку в загрузке данных. Такой сигнал позволяет инициировать ускоренную коррекцию и минимизировать задержки в прогнозах.
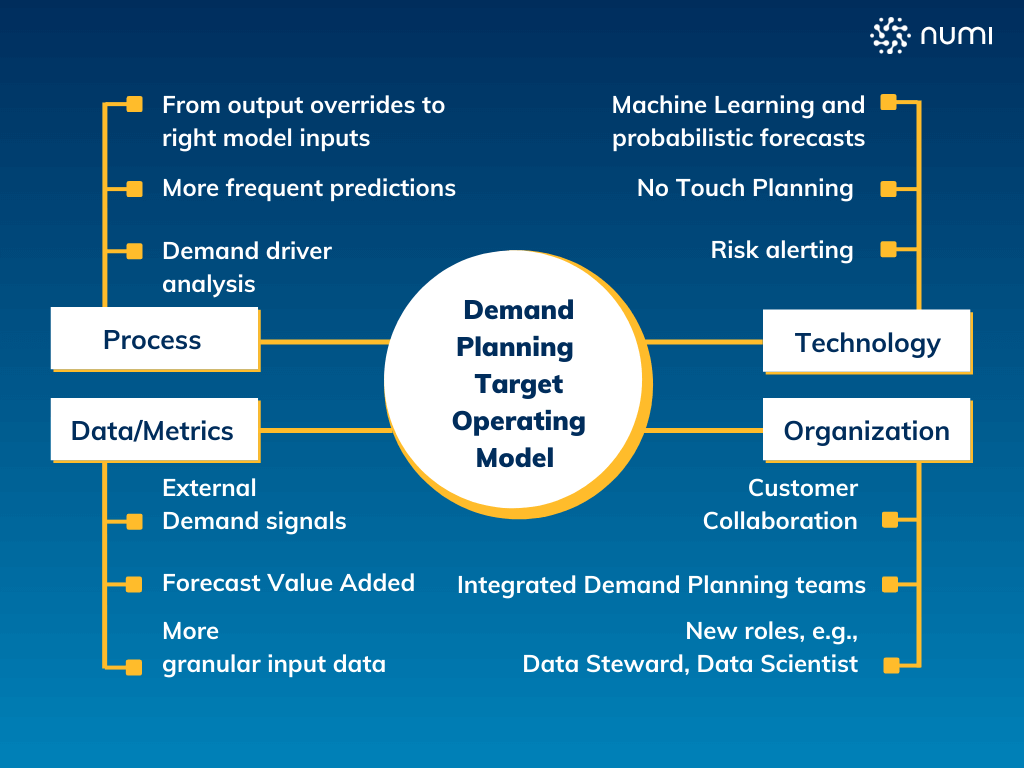
Очистка и стандартизация данных: подходы и практики
Очистка данных - активный процесс устранения ошибок, дубликатов и несогласованностей, который сопровождает переход данных от исходной формы к удобной для анализа. В контексте Demand Planning это особенно важно, поскольку различия в форматах дат, единицах измерения или кодах товаров приводят к расхождениям в агрегированных показателях и, как следствие, к неверной интерпретации спроса.
Ключевые направления очистки:
- дедупликация и сопоставление записей: устранение повторов и корректное объединение данных по SKU, клиентам и географии;
- стандартизация форматов: унификация единиц измерения, форматов дат и кодировок;
- нормализация и приведение к единой схеме данных: выравнивание атрибутов (например, категории товара, гео-разбиения, единиц измерения);
- обогащение данных: добавление недостающих атрибутов из справочников или внешних источников, чтобы повысить полноту и контекст;
- обработка пропусков: применение правил заполнения пропусков с учетом бизнес-логики (например, заполнение нулем там, где продажи невозможны, или использование средней сезонной величины).
Практический результат очистки - единый набор качественных данных, который можно использовать для расчета прогнозов без необходимости ручной коррекции. Важно внедрять автоматические процедуры очистки, которые выполняются в рамках ETL/ELT-пайплайнов или через orchestration-инструменты, чтобы минимизировать задержки и человеческий фактор. При этом следует документировать каждое изменение: какие правила применялись, какие значения преобразованы и какие случаи требуют ручной проверки.
Стандартизация данных играет здесь ключевую роль. Без единой схемы названий и единиц измерения риски ошибок будут повторяться. Внедрение справочников данных, общих правил кодирования и форматов дат существенно снижает операционные риски и ускоряет внедрение новых источников данных.
Валидация данных и контроль качества: правила и мониторинг
Валидация данных - это формализация проверок соответствия значения бизнес-правилам, критериям качества и ожиданиям модели прогноза. В Demand Planning валидация должна охватывать не только входные данные, но и результаты расчета прогноза, сценариев и связанных метрик.
Основные элементы валидации:
- правила приемлемости и валидности: например, диапазоны продаж по SKU, сезонные коэффициенты, согласованность дат и календарей;
- тест-кейсы на прогнозируемых сценариях: проверка на соответствие бизнес-ограничениям, отклонениям между источниками и историческим поведением;
- мониторинг и алерты: регулярные проверки, дашборды по качеству данных, уведомления при выходе за пороги;
- управление несоответствиями: регламенты по классификации инцидентов, эскалации, исправлениям и отслеживанию времени цикла.
Эффективная валидация требует интеграции с данными об управлении качеством и сервис-уровнями (SLA). В рамках этих процессов появляется понятие data quality gates - контрольные «ворота» на разных стадиях пайплайна: загрузка данных, подготовка, обогащение и расчёт прогноза. Пройдя ворота, данные считаются готовыми к использованию; не прошедшие ворота проходят автоматическое отклонение и требуют вмешательства ответственных лиц.
Мониторинг качества должен быть непрерывным. Данные о качестве дают возможность вовремя обнаруживать деградацию в исходных источниках, возникающие проблемы в загрузке и изменения в бизнес-процессах. В рамках Demand Planning особенно важна временная агрегированность и устойчивость к сезонным пикам: метрики должны отражать сезонность и тренды, чтобы отклик на отклонения был пропорционален риску для запасов и сервиса.
Организационные аспекты управления качеством данных
Технологии без управленческого обеспечения не достигают требуемых уровней качества. Эффективная практика требует формализации ролей, ответственности и процедур, связанных с данными.
Ключевые роли:
- Data Owner - владелец данных по источнику, отвечает за целостность и доступность, согласование форматов и политики использования;
- Data Steward - хранит ежедневную ответственность за качество: мониторинг, обработку инцидентов, координацию изменений в справочниках и метаданных;
- Data Architect / Data Engineer - реализуют архитектурные решения по профилированию, очистке и валидности, поддержке пайплайнов и качественных правил;
- Demand Planning Lead - обеспечивает согласование бизнес-требований к данным, участвует в формулировании правил валидности и критериев качества для прогноза.
Политики и процессы включают:
- политика качества данных: цели, критерии и требования к источникам;
- регламент управления инцидентами качества: критерии классификации, цикл обработки и сроки устранения;
- управление метаданными и каталог данных: единая карта источников, зависимостей и контекстов использования данных;
- KPI и вознаграждения за качество: связь улучшений качества с экономическими и операционными эффектами.
Важно обеспечить устойчивую культурную смену: высокая прозрачность процессов, участие бизнес-подразделений и регулярные обзоры качества данных на управленческих встречах. Роли должны быть энд-ту-энд закреплены в RACI-матрице: кто отвечает за профилирование, очистку, валидацию, мониторинг и эскалацию.
Организационные изменения часто требуют внедрения новых процедур или изменений в существующих процессах планирования. В качестве примера может быть введение обязательного прохождения data quality gates перед каждым запуском прогноза, формирование отдельного канала коммуникаций для инцидентов качества и создание координационного комитета по данным, который собирает представителей продаж, логистики, финансов и ИТ.
Технологическая архитектура поддержки качества данных
Архитектура управления качеством данных должна обеспечивать последовательную работу профилирования, очистки и валидации на протяжении всего цикла Demand Planning. Центральные элементы архитектуры включают источники данных, процессы загрузки и интеграции, пайплайны очистки и нормализации, метаданные и инструменты контроля качества.
Ключевые принципы архитектуры:
- единая модель данных и словари: общие конвенции именования, единицы измерения и справочники;
- целостность данных: прослеживаемость данных (data lineage) от источника до прогноза;
- модульность пайплайнов: профилирование, очистка, обогащение и расчёт прогноза - разделены по слоям, чтобы облегчить масштабирование и контроль;
- встроенный контроль качества: правила валидности и автоматизированные проверки в каждом критическом узле пайплайна;
- качественные инструменты: использование специальных инструментов для профилирования и тестирования данных (примерно на выбор, см. ниже).
Для реализации качественных процессов применяются современные подходы и инструменты. В рамках open-source экосистемы широко применяются решения, которые позволяют ускорить внедрение и снизить зависимости от поставщиков. В частности, для профилирования и валидации данных эффективны инструменты вроде Great Expectations - фреймворк для настройки тестов качества данных, а для трансформаций и управления моделями данных - dbt. Единый слой мониторинга и визуализации качества данных может быть реализован на основе ваших существующих BI и аналитических инструментов; при этом ключевую роль играет интеграция с каталогом метаданных и системой управления изменениями.
Доказательная ценность такого подхода проявляется в снижении числа инцидентов связанных с данными, ускорении цикла прогноза и улучшении согласованности между планами продаж, запасов и финансовой отчетности. Стратегически важным является построение дорожной карты внедрения, учитывающей готовность команды, наличие данных и необходимость регуляторных или корпоративных требований к качеству.
Комплексная интеграция и примеры практик
- Сформируйте план профилирования, охватывающий наиболее критичные источники данных: продажи по каналам, запасы на складах, календарь промо-мероприятий и внешние индикаторы спроса.
- Определите минимальный набор метрик качества для каждого источника: пропуски, точность значений, единицы измерения, консистентность между полями, уникальность записей.
- Встроите процессы очистки в ETL/ELT пайплайны: автоматическая нормализация форматов, устранение дубликатов, верификация с справочниками.
- Введите регулярную валидацию и контроль качества на каждом этапе: заранее согласованные пороги, тест-кейсы на прогнозные сценарии, алертинг при нарушениях.
- Реализуйте управление данными через каталог и метаданные: документируйте источники, правила, связи между данными и влияние на прогноз.
- Обеспечьте организационную поддержку: закрепите роли Data Owner и Data Steward, определите SLA по исправлению инцидентов качества данных и интеграцию с процессами Demand Planning.
Продавать такие практики можно через последовательные пилоты, начиная с одного набора источников и одного типа данных, затем расширяя охват. Важнейшими условиями успеха являются четко сформулированные правила, доступность артефактов профилирования и возможность контроля изменений в данных и процессах.
Key takeaways
- Качество данных является критическим фактором точности прогнозов спроса и эффективности планирования запасов.
- Профилирование данных выявляет дефекты на ранних стадиях, формирует метрики и артефакты, необходимые для контроля качества.
- Очистка и стандартизация данных уменьшает риски несогласованности и улучшает управляемость моделей прогноза.
- Валидация данных обеспечивает соответствие бизнес-правилам, контролируемый расчет прогноза и систематический мониторинг качества.
- Организационная модель управления качеством данных требует четких ролей, политик и процессов, поддерживаемых изменениями в культуре работы с данными.
- Технологическая архитектура должна обеспечивать прослеживаемость данных, модульность пайплайнов и встроенный контроль качества с применением современных инструментов и подходов.
FAQ
- Что такое профилирование данных и зачем оно нужно в Demand Planning?
- Профилирование данных - систематический сбор характеристик наборов данных: распределения, пропуски, уникальность, корреляции. В Demand Planning оно позволяет выявлять источники риска качества данных еще до расчета прогноза, устанавливать пороги и правила обработки, а также документировать зависимости между данными. Это снижает вероятность ошибок в прогнозах и уменьшает задержки на этапе подготовки данных.
- Какие метрики качества данных особенно важны для прогнозирования спроса?
- Критически важны: полнота (выражает, насколько данные охватывают требуемые элементы), точность (соответствие значения реальности), непротиворечивость между источниками, своевременность, валидность (соответствие формату и бизнес-правилам) и уникальность записей. Для каждого набора данных можно добавлять специфические метрики в зависимости от роли источника (например, регулярность обновления данных по SKU, согласование по календарю).
- Как начать внедрение процессов очистки данных в организации?
- Начните с карты источников данных и определения критических для прогнозирования областей. Установите минимальные правила очистки: единицы измерения, форматы дат, базовые правила дедупликации. Внедрите автоматическую очистку в ETL/ELT-пайплайны и закрепите артефакты (словарь данных, правила преобразования). Постепенно расширяйте охват на новые источники и усложняйте правила по мере роста зрелости процессов.
- Какие роли должны быть вовлечены в управление качеством данных?
- Владелец данных (Data Owner) отвечает за целостность источника, Steward - за повседневное управление качеством и инцидентами, инженеры данных - за архитектуру пайплайнов и реализацию правил, бизнес-руководители планирования - за требования к данным для прогноза. В контексте Demand Planning эти роли тесно взаимодействуют с командами продаж, логистики и финансов через совместные комитеты и регламенты.
- Какие инструменты наиболее эффективны для профилирования и тестирования данных?
- В рамках методологии можно опираться на подходы и инструменты, которые позволяют быстро внедряться в существующую инфраструктуру. Хорошие практические примеры включают Great Expectations для настройки тестов качества данных и dbt для управления трансформациями и качеством данных в контексте моделирования. Оба инструмента поддерживают документирование, тесты и интеграцию с пайплайнами. Выбор конкретного набора инструментов должен соответствовать вашим архитектурным требованиям и возможностям команды.
- Как измерять эффект внедрения управления качеством данных в Demand Planning?
- Эффект можно оценивать через показатели прогнозной точности (MAPE, RMSE) до и после внедрения, снижение числа инцидентов качества данных, сокращение времени цикла подготовки прогноза, уменьшение уровня запасов и более точные сервисные уровни. Важно устанавливать базу измерения до изменений и соблюдать регулярную отчетность, чтобы продемонстрировать ценность для бизнеса.
- Какие являются частые риски и анти-паттерны в управлении качеством данных?
- Частые риски включают: отсутствие единой политики качества, разрозненные источники и справочники, слабая прослеживаемость данных, чрезмерная зависимость от ручной обработки, недостаточная вовлеченность бизнес-подразделений. Анти-паттерны - попытки «быстро обойти» проверки, игнорирование инцидентов качества, отсутствие документирования изменений в данных или правил обработки.
- Как внедрять культурные изменения в организации для улучшения качества данных?
- Внедрять культуру качества следует через прозрачные процессы, быстрый отклик на инциденты, регулярные обсуждения на управленческих встречах и создание общих правил. Важно вовлекать бизнес-подразделения в формулирование требований к данным и держать в курсе прогресса: какие источники охвачены, какие правила применены, какие инциденты решены. Наглядные показатели качества и их связь с бизнес-результатами помогают закреплять новые практики.
- Какие шаги следует предпринять перед выбором инструментов профилирования и тестирования?
- Определите требования по охвату источников, скорости обработки, совместимости с текущей инфраструктурой и необходимостью соответствия регуляторным требованиям. Определите бюджет, оцените риск внедрения и возможности масштабирования. Протестируйте пилот на одном критическом источнике данных, оцените улучшения по времени подготовки прогноза и качеству данных, затем расширяйте пилот.
- Какие артефакты должны быть доступны всем участникам процесса?
- Карта источников данных и их зависимостей (data lineage), словари и справочники данных, правила преобразований и единицы измерения, отчеты профилирования, регламенты очистки и валидаты, дашборды качества и регламентированные протоколы для инцидентов. Это обеспечивает прозрачность и упрощает совместную работу между командами данных и бизнес-подразделениями.


