

Интеграция систем и паттерны обмена данными: API, ERP, BI
В рамках методологии внедрения Demand Planning с нуля интеграция между API, ERP и BI выступает фундаментальным драйвером скорости доступа к данным, согласованности семантики и устойчивости управленческих решений. Правильная организация обмена данными позволяет превратить разрозненные источники в единый источник правды, сокращает задержки обработки, уменьшает риск ошибок и поддерживает новые сценарии планирования, рассчитанные на гибкую адаптацию бизнес-потребностей. В этой главе рассматриваются концепции интеграции на уровне процессов, архитектурных паттернов и организационных изменений, которые необходимы для эффективного внедрения Demand Planning.
Краткое введение
-
Современная ERP-экосистема и BI-инструменты не существуют автономно: они должны бесшовно взаимодействовать через хорошо спроектированные API и управляемый канал обмена данными. Эффективная интеграция требует не только технической реализации, но и четкого согласования семантики, политики качества данных и управляемости изменениями.
-
В рамках методического подхода к внедрению Demand Planning акцент делается на этапности: проектирование архитектуры обмена, выбор паттернов интеграции, формирование ролей и процедур управления данными, а затем реализация через управляемые пилоты и постепенное масштабирование.
-
Контекст и архитектурные паттерны обмена данными
-
API-слой и управление контрактами данных
-
ERP-интеграция: данные, процессы, мастер-данные
-
BI и аналитика как потребители данных
-
Управление качеством, безопасностью и соответствием
-
Организационные изменения и операционная практика
Контекст и архитектурные паттерны обмена данными
Эффективная Demand Planning требует единообразной семантики и своевременного доступа к данным из разных систем: ERP обеспечивает операционные данные продаж, запасов и производства; BI-инструменты - аналитику и отчетность; API-слой связывает эти элементы в единое плато данных. Основная задача - выбрать паттерны обмена, которые обеспечивают масштабируемость, управляемость и устойчивость к изменениям бизнес-потребностей.
Ключевые концепции:
- Каноническая модель данных. Создание общей семантики и наборов атрибутов, которые используются всеми системами. Это уменьшает количество трансформаций “переделай под каждую систему” и снижает риск расхождений в ключевых метриках спроса, запасов и заказов.
- Архитектурные паттерны.
- Hub-and-spoke (шина данных) обеспечивает централизованный обмен через API-менеджмент и конвенции по маппингу, уменьшая количество точечных интеграций между системами.
- API-led connectivity ставит API как первый класс интеграции: за счёт хорошо управляемого набора контрактов достигается повторное использование, безопасность и прозрачность.
- Событийно-ориентированная архитектура (EDA) через брокеры сообщений обеспечивает асинхронность и высокую пропускную способность для обновлений спроса, цен и запасов в режиме near real-time.
- Управление качеством и трансформациями. Включение конвейера данных с валидацией на каждом шаге, согласование стандартов именования, типизации и единиц измерения. Это критично для точного планирования на основе данных, поступающих из ERP и BI.
- Безопасность и соответствие. Ограничение доступа, управление идентификацией и аутентификацией, аудит изменений и журналирование операций обмена данными. В рамках GDPR и локализации данных особенно важно обеспечить надлежащую гео- и контекстную защиту.
На уровне практики применяются сочетания паттернов в зависимости от зрелости инфраструктуры и бизнес-нужд. В реальных условиях целесообразно начать с hub-and-spoke и перехода к событийно-ориентированной архитектуре для критических потоков данных, которые требуют минимальной задержки. В качестве технического примера можно отметить интеграцию через брокер сообщений на основе открытых стандартов (например, Apache Kafka) для событийных уведомлений о изменениях запасов и спроса, что позволяет BI-инструментам обновлять прогнозы без задержек, связанных с пакетной загрузкой.
Почему это важно для методологии внедрения? Потому что выбор паттерна определяет не только архитектуру, но и организационные роли, требования к тестированию, планы миграции и контроль качества. Неформализованные обмены приводят к несовпадениям в данных, что подрывает доверие к прогнозам и снижает эффективность Demand Planning.
Каноническая модель данных и семантика
Ключ к успешной интеграции - единая семантика. Определение канонических сущностей и атрибутов (товар, локация, клиент, склад, дата, единица измерения, валюта) позволяет унифицировать правила агрегации, трансформацию и согласование метрик между ERP и BI. В рамках реализации методологии рекомендуется:
- сформировать Data Dictionary и согласовать имена полей, форматы и допустимые значения;
- задокументировать бизнес-правила конвертации и перевода единиц измерения (например, SKU в базовой единице против единицы планирования);
- обеспечить обратную совместимость контрактов API через версионирование и регламентные процедуры изменения схем.
Семантика, зафиксированная на раннем этапе, обуславливает качество прогнозов спроса и устойчивость процессов планирования.
Паттерны интеграции: API-led, ESB, iPaaS
- API-led connectivity фокусируется на разделении слоёв: Experience API (для UI и бизнес-поддержки), Process API (для бизнес-процессов Demand Planning) и System API (для доступа к ERP и другим системам). Такой подход облегчает повторное использование и упрощает тестирование изменений.
- ESB (Enterprise Service Bus) может быть уместен на стадиях перехода, когда требуется координация трансформаций и маршрутизации между старыми локальными интеграциями и новым API-сервисом, однако в современных условиях часто заменяется iPaaS и lightweight API-платформами для гибкости.
- iPaaS (Integration Platform as a Service) обеспечивает готовые коннекторы к ERP и BI и может ускорить внедрение через преднастроенные паттерны, но требует внимательного мониторинга затрат и зависимости от поставщика услуг.
Расширение паттернов в рамках методологии предполагает использование гибридного подхода: дефектная или критичная функциональность - через собственные API и через HR- или финансовые интерфейсы ERP - в то время как менее критичные потоки переводятся на iPaaS для быстрой доработки и тестирования. Важной частью является планирование мониторинга и управления пропускной способностью: какие события требуют мгновенной реакции, а какие могут функционировать в режиме near real-time или пакетной загрузки.
API-слой и управление контрактами данных
API-слой - это лицо интеграционной архитектуры Demand Planning. Он обеспечивает согласованные контракты, безопасность и управляемость обмена и позволяет BI-инструментам получать данные в предсказуемом формате для анализа и прогнозирования. В этом контексте важны следующие аспекты.
- Контракты данных и версионирование. Каждый API контракт должен иметь понятную версию и способ миграции потребителей. Документация по контрактам должна быть доступна для всех участников проекта, чтобы избежать несоответствий между ERP, ETL-процессами и аналитикой.
- Стандарты дизайна. Использование общих паттернов: единый набор HTTP-операций, понятные коды статусов, ясная политика обработки ошибок и ретрая. Применение OpenAPI/Swagger упрощает обмен контрактами и автоматизирует тестирование.
- Безопасность и доступ. Реализация OAuth2, mTLS для сервисов, разграничение ролей и принцип минимальных привилегий. Журналирование доступа и изменений контракта, аудит потребителей API.
- Контроль качества API. Включение автоматических тестов регрессии для контрактов, мониторинг производительности и SLA, фиксация задержек и ошибок на уровне каждого API. Внедрение уровней retry и backoff уменьшает риск нарушений из-за временных сбоев.
Эта часть методологии определяет, как обезопасить и структурировать обмен, чтобы Seamless доступ к данным для Demand Planning обеспечивался без потерь и с высокой воспроизводимостью.
Управление жизненным циклом API
Жизненный цикл включает дизайн, тестирование, публикацию, мониторинг и эволюцию контрактов. В рамках методологии рекомендуется внедрить:
- регламенты ревизий контрактов и архивацию устаревших версий;
- сценарии миграции потребителей и минимизацию прерываний;
- политики тестирования производительности и устойчивости к сбоям;
- процесс уведомления команд потребителей о изменениях.
ERP-интеграция: данные, процессы, мастер-данные
ERP-системы служат операционной сердцевиной бизнеса - от обработки продаж до планирования материалов. Интеграция с ERP должна поддерживать как потоковые, так и пакетные режимы обмена, учитывая требования Demand Planning к точности, полноте и актуальности данных.
Ключевые аспекты:
- Архитектура интеграции. Часто рекомендуется разделить потоки на: (1) данные о запасах, продажах и заказах для планирования на уровне E2E; (2) мастер-данные и классификации; (3) события изменений, которые должны распространяться через API и BI.
- Дельтовые загрузки и CDC. Для минимизации нагрузки на ERP целесообразно использовать delta-обновления и CDC, что позволяет BI-подсистемам обновляться без полного копирования базы.
- Мастер-данные и консолидация. В Demand Planning важна консолидация мастер-данных по продуктам, складам, категориям и поставщикам. Наличие единого репозитория мастер-данных уменьшает риск несогласованности в прогнозах и планах.
- Реализация через российские и международные ERP-платформы. В российских условиях часто встречается 1C: Enterprise как источник мастер-данных и точек интеграции; в зарубежной практике - SAP S/4HANA, Oracle ERP Cloud. В рамках методологии целесообразно выбрать гибкую стратегию миграции и совместной работы с ERP-партнёрами.
Практическая рекомендация: начать с пилотного окна данных (например, запас и продажи по нескольким важным SKU) и ограничить количество интеграций на этапе старта. Затем расширять каналы обмена и добавлять новые источники и потребителей по мере выработки надежной архитектуры и согласованных бизнес-правил.
Мастер-данные и синхронизация
Ключевые принципы:
- Определение минимального набора атрибутов, без которых прогнозы теряют точность (SKU, локации, единицы измерения, валюты, статус поставки).
- Унификация кодов и атрибутов между ERP и BI. Любые различия в иерархиях или классификациях должны документироваться и отражаться в конвейере преобразований.
- Какие данные и как обновляются. В контексте Demand Planning особенно важны обновления спроса, поставок и запасов. Вводятся политики частоты обновления и способа обработки задержек.
BI и аналитика как потребители данных
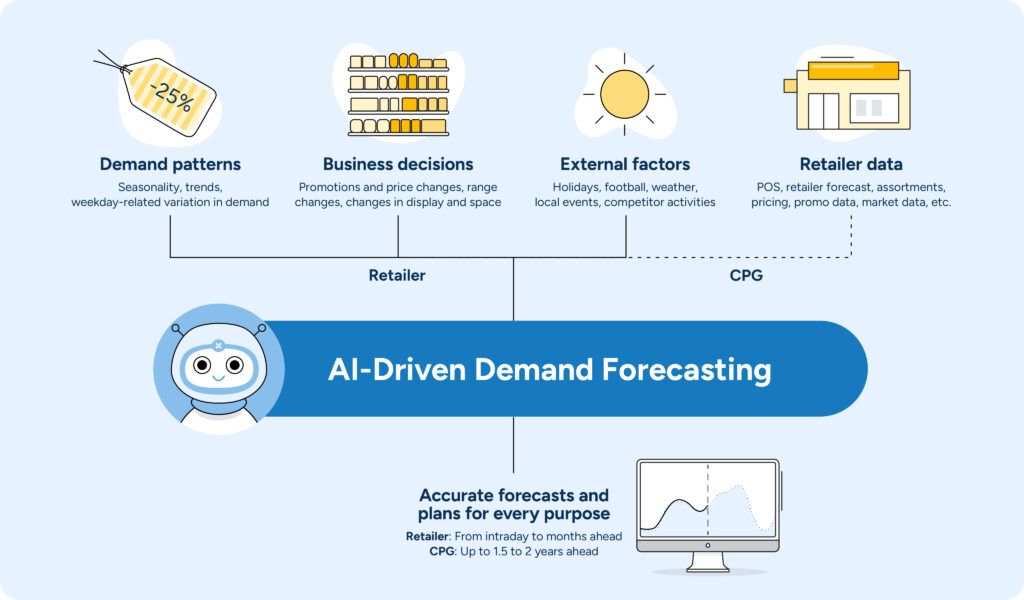
BI-инструменты стоят на вершине данной архитектуры и обеспечивают анализ, прогнозирование и визуализацию. Эффективная интеграция требует не только доступа к данным, но и правильно выстроенного слоя семантики и моделей данных.
- Архитектура аналитики. Разделение на слоя: источник данных (ERP/поставщики), интеграционный слой (API, конвейеры трансформаций) и аналитический слой (data warehouse, data marts, semantic layer). Это позволяет отделять операционные потоки от аналитических и снижает влияние изменений в операционных системах на аналитику.
- Модели данных. В выборе между самодельной денормализацией и согласованными data marts важно соблюдать баланс между скоростью анализа и гибкостью. В рамках Demand Planning эффективна модульная архитектура, где каждый домен (продажи, запасы, поставки) имеет свою подсистему и согласованный слой мер.
- Семантика и правила трансформации. Поддержка общих показателей-предиктов (например, спрос по SKU и по гео, уровень запасов, задействованность запасов по цепи поставок) и согласование единиц измерения. Взаимодействие с BI-аналитиками требует доступности документированного словаря измерителей и бизнес-правил суммирования.
- Контроль качества данных для аналитики. BI-слой четко отслеживает точность, полноту и консистентность. Включаются процессы проверки на каждом этапе конвейера, автоматическая обработка исключений и уведомления в случае отклонений.
На практике это означает создание хорошо задокументированного слоя данных, который позволяет аналитикам и планировщикам работать с единообразными основами. В качестве примечания можно указать, что использование открытых стандартов и инструментов, таких как OpenAPI для контрактов и Apache Kafka для событий, поддерживает устойчивость и масштабируемость аналитических сценариев.
Управление качеством данных, безопасностью и соответствием
Качество данных - краеугольный камень точности Demand Planning. Без надлежащих процедур даже самая продвинутая архитектура обмена данными не сможет обеспечить адекватный прогноз.
Ключевые элементы:
- Грамотное управление качеством. Включение правил валидации на каждом этапе конвейера: валидность значений, корректность дат, отсутствие нулевых полей в критических измерителях, согласование единиц измерения.
- Легитимность данных и аудит. Ведение журнала изменений, трассировка источника данных и возможность отката последствий ошибок. Это особенно важно для аудита и регуляторной отчетности.
- Безопасность и конфиденциальность. Ограничение доступа к данным через роли, шифрование чувствительных атрибутов, мониторинг аномалий и защита от угроз. В условиях локализации данных и передачи персональных данных требуется соответствие требованиям, таким как GDPR и локальные требования по хранению информации.
- Линеидж данных и прозрачность. Отслеживание происхождения данных, их изменений и влияния на бизнес-процессы. Это помогает выявлять источник ошибок и быстро восстанавливать прогнозы.
Эти элементы становятся частью операционной практики проекта: наличие роли Data Steward, регламентов управления данными, четкой ответственности за качество и мониторинг производительности интеграции.
Организационные изменения и операционная практика
Технические решения невозможно реализовать без соответствующей организации процессов и ролей. В Demand Planning критически важно внедрить управляемую структуру взаимодействия между бизнес-областьми и ИТ.
Роли и обязанности:
- Data Product Owner. Определяет приоритеты данных, инвестиции в качество и семантику, принимает решения об изменении модели данных и контрактов API.
- Integration Architect. Проектирует и контролирует конвейеры обмена данными, архитектурные выборы и соответствие паттернам.
- Data Steward. Ответственен за качество и непрерывность мастер-данных, их актуализацию и согласованность по бизнес-областям.
- Platform Owner. Обеспечивает устойчивость инфраструктуры интеграции, уровень доступности и мониторинга.
Методологически следует применять agile-подход с выделением спринтов на интеграцию, тестирование контрактов и внедрение новых источников данных. В ходе проекта важна регулярная коммуникация по прогрессу между бизнес-подразделениями, ИТ и поставщиками решений, а также проведение периодических демо- и обучающих сессий для пользователей.
Этапы внедрения можно структурировать как последовательность: постановка цели и рамок интеграции; проектирование канона данных и контрактов; пилоты по ключевым потокам; масштабирование и совершенствование; мониторинг и оптимизация. В каждом этапе применяются критерии готовности, контроль качества и планы управления рисками.
Key takeaways
- Грамотная интеграционная архитектура с единым каноническим набором данных и согласованной семантикой критична для точности Demand Planning.
- API-led connectivity, паттерны hub-and-spoke и события (EDA) обеспечивают масштабируемость и управляемость обмена между API, ERP и BI.
- ERP-интеграция должна сочетать delta-обновления и CDC для минимизации нагрузки на системы и своевременного поступления изменений.
- BI-слой требует четко продуманной архитектуры данных, модульных data marts и прозрачной семантики для качественных прогнозов.
- Управление качеством данных, безопасность и соответствие становятся частью операционной практики и должны поддерживаться регламентами и ролями.
- Организационные изменения и четко определенные роли (Data Product Owner, Integration Architect, Data Steward) критичны для устойчивого внедрения.
- Пилоты и постепенное масштабирование позволяют управлять рисками и обеспечивают быструю окупаемость инвестиций.
FAQ
Вопрос 1. Какие паттерны интеграции наиболее подходят для Demand Planning в первые шаги проекта?
Ответ: На старте разумно использовать паттерн hub-and-spoke с централизованным API-слоем, который обеспечивает единый контракт данных между ERP и BI. Это упрощает консолидацию семантики и контроль над качеством данных. По мере роста зрелости архитектуры можно добавлять события через EDA для критичных потоков, например уведомления о изменениях запасов и спроса, что ускоряет обновления прогнозов. Поддержка через iPaaS может помочь быстро расширить коннекторы и ускорить пилоты, однако необходимо оценить стоимость и долгосрочную устойчивость.
Вопрос 2. Что такое API-led connectivity и зачем он нужен в интеграции ERP и BI?
Ответ: API-led connectivity - подход, при котором интеграционные сценарии строятся через три слоя контрактов: System API (доступ к системам), Process API (бизнес-логика и конвергенция данных) и Experience API (потребители: BI, UI). Такой подход обеспечивает повторное использование, упрощает тестирование и снижает риск конфликтов между системами. В Demand Planning он позволяет BI-пользователям работать с консистентной семантикой, а ERP - безопасно публиковать данные через стабильные контракты.
Вопрос 3. Как обеспечить согласование семантики между ERP и BI?
Ответ: Необходимо создать каноническую модель данных и Data Dictionary, где жестко зафиксированы правила трансформации, единицы измерения и разрешённые значения. Важна версия контракта API и регламент миграций. Регулярные ревизии и совместные сессии бизнес-аналитиков и разработчиков помогают поддерживать согласованность на протяжении всего цикла внедрения.
Вопрос 4. Какие данные в ERP чаще всего становятся источниками для Demand Planning?
Ответ: Основные источники - данные о продажах, запасы, заказы, поставки и производственные планы. В некоторых случаях полезно включать данные о поставщиках, ценах и условиях поставки для точной оценки себестоимости и времени выполнения заказов. Delta-загрузки и CDC позволяют оперативно отражать изменения в прогнозах без полной переработки всей базы.
Вопрос 5. Какие требования к безопасности и соответствию особенно важны для интеграции?
Ответ: Важны аутентификация и авторизация (роли, минимальные привилегии), шифрование данных в покое и в транзите, аудит и журналирование операций обмена, а также соблюдение региональных норм хранения данных и локализаций. В условиях GDPR и локальных регуляций требуется прозрачная политика обработки персональных данных и возможность быстро удалять или анонимизировать данные по запросу.
Вопрос 6. Как организовать тестирование интеграции и мониторинг в проектах интеграции?
Ответ: Следует внедрить автоматизированное тестирование контрактов API (OpenAPI), регрессионное тестирование конвейеров данных и мониторинг SLA по каждому API и каналу передачи. Мониторинг должен охватывать задержки, редкие ошибки и пропускные способности, а также иметь процессы уведомления ответственных лиц и автоматическое эскалирование при выходе за пороги.
Вопрос 7. Какие организационные роли критичны для успешного внедрения интеграции?
Ответ: Data Product Owner отвечает за ценность данных и приоритеты интеграций, Integration Architect - за архитектуру и техническое соответствие паттернам, Data Steward - за качество мастер-данных, Platform Owner - за инфраструктуру и устойчивость решений. В рамках проекта рекомендуется создать сквозную команду END-TO-END, включающую представителей бизнес-областей и ИТ, чтобы обеспечить вовлеченность и прозрачность процесса.
Вопрос 8. Как оценивать успех проекта интеграции в контексте Demand Planning?
Ответ: Успех оценивается по параметрам качества данных (полнота, точность, консистентность), скорости доступа к данным (время обновления прогнозов), уровню удовлетворенности бизнес-пользователей и влиянию на точность планирования спроса. Дополнительно полезно отслеживать бизнес-метрики, такие как снижение задержек в цепочке поставок, уменьшение запасов без потери обслуживания и улучшение отклика на изменения рыночной конъюнктуры.
Вопрос 9. Какие шаги реализации стоит предпринять в пилотной фазе?
Ответ: Выберите ограниченный набор SKU и географий, реализуйте каноническую модель, настройте API-порты и контракты, организуйте delta-обновления и первую версию BI-отчетности. Важно зафиксировать набор ошибок иожить корректировки в план проекта, а затем масштабировать на дополнительные домены и источники данных.
Вопрос 10. Какие примеры технологий и инструментов можно рассмотреть в рамках открытых решений?
Ответ: В рамках открытых решений можно рассмотреть Kafka как механизм обмена событиями и реального времени, OpenAPI для описания контрактов API, а также архитектурные подходы на базе современных облачных платформ. В рамках российского контекста можно учитывать 1C: Enterprise как ERP-источник данных, обеспечивающий стабильные каналы и возможности интеграции. Выбор должен основываться на критериях масштабируемости, стоимости владения и совместимости с существующей инфраструктурой.
Завершение главы призывает к тому, чтобы методический подход к интеграции систем и паттернам обмена данными стал неотъемлемой частью устойчивого, прозрачного и эффективного внедрения Demand Planning.


