

Локализация корпоративного хранилища данных в сети ресторанов быстрого питания
Конкуренция в ресторанном бизнесе усиливается, а глобальные вызовы вносят свои коррективы в текущие бизнес-процессы. В отрасли возрастает скорость принятия решений на основе данных, а самих данных и источников становится больше. Ресторанам приходится пересматривать свою стратегию принятия бизнес-решений.
Сеть ресторанов быстрого питания использовала систему хранилища данных на базе зарубежного программного обеспечения. Компанией было принято решение перейти на локальные системы после оценки рисков в части дальнейшего развития и поддержки системы в России. Целью данного проекта являлось создание нового аналитического ландшафта и консолидация данных из многочисленных источников в едином пространстве. Сети ресторанов требовалась унификация данных и использование корпоративного хранилища данных (DWH) в качестве единственного источника для систем-потребителей.
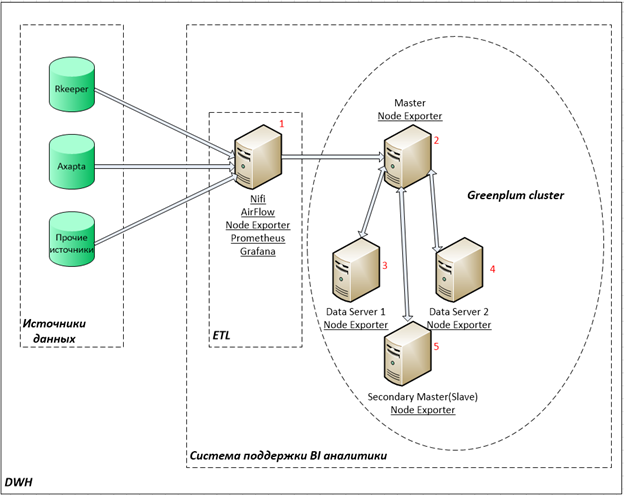
Данная сеть ресторанов представлена в 12 регионах и имеет более 100 филиалов, поэтому необходимо учитывать возможности масштабирования при создании локального хранилища данных. В рамках разработки КХД было реализовано подключение к источникам данных и реализованы два слоя данных: слой «сырых» данных dt1 и предрассчитанные данные dt2.
Требования к хранилищу данных
У заказчика было несколько требований, которые необходимо было предусмотреть при проектировании хранилища данных:
- Консолидация источников
- Унификация данных
- Масштабируемость
- Отказоустойчивость
- Хранение исторических данных
- Производительность
Источники данных DWH
Было разработано хранилище данных, которое позволит реализовать подключение к различным источникам данных. Источниками данных выступали следующие системы:
- RKeeper;
- Axapta;
-
Прочие источники:
- BOSS
- IRB Reports
- Digital
- OFD
- ВТБ
- Реестры Сбербанка XML и XLS
- Реестры Сбербанк Спасибо
- Реестры Tinkoff
- Реестры YUM
- XLS-файлы (справочные данные)
- Omnitracker
Было реализовано автоматическое обновление данных по индивидуальному для каждого источника регламенту.
Функциональность хранилища
В качестве СУБД был выбран GreenPlum. Greenplum позволяет сократить разрозненность данных, предоставляя единую масштабируемую среду для конвергенции аналитических и операционных рабочих нагрузок. С помощью Greenplum был реализован отказоустойчивый кластер с настроенной автоматической репликацией.
В качестве ETL инструмента были использованы Apach NiFi и Apach Airflow. Эти два open source инструмента позволяют привести данные из разных учетных систем к единым справочникам для последующей загрузки данных в КХД. ETL состоит из трех этапов:
1. Extract – извлечение данных из внешних систем-источников.
2. Transform – данный этап позволяет трансформировать данные. На этом этапе происходит приведение данных к унифицированному виду. Целью этого этапа является подготовка данных к загрузке в хранилище и приведение их к более удобному для последующего анализа формату.
3. Load – перенос данных из промежуточных таблиц в структуру DWH.
Для мониторинга за данными использовали Grafana, для сбора метрик внутри сервера – Node Exporter и Prometeus для сбора метрик с Node Exporter каждого сервера.
Архитектура DWH
Итогом проекта разработки КХД стала реализация отказоустойчивого кластера, содержащего данные со всех перечисленных источников, «разложенных» по двум слоям:
Data Layer (DL) - dt1
Слой хранения «сырых» данных. Он используется для хранения данных из систем-источников, которые загружаются в рамках автоматизированных ETL-процессов.
Предрассчитанные данные - dt2
Данный слой содержит преобразованные данные, которые приобретают удобный для пользователей вид.
Сформированная логическая модель детального уровня содержит данные, необходимые для дальнейшей разработки витрин данных (слой dt3), которые обеспечат возможность как создания отчетности, так и использование почти любого BI-инструмента по выбору Заказчика.
Этапы проекта
- Аудит источников данных
Источники данных имеют разный формат. Необходимо было изучить и реализовать подключение к различным системам: платформы для ресторанов, банковские реестры, оператор фискальных данных.
- Определение потребителей данных
На этом этапе была выбрана система, которая будет обрабатывать данные. Сейчас в компании используется BI-система Qlik Sense.
- Работа со слоями данных
Все данные из перечисленных источников были «разложены» по двум слоям – dt1 и dt2. Была проведена подготовка системы к разработке третьего слоя, который позволит использовать почти любого BI-инструмента по выбору Заказчика.
- Оптимизация хранилища данных
Дополнительно проведены работы по оптимизации хранилища данных, а именно:
- Балансировка таблиц;
- Партиционирование (помесячное и построчное);
- Распределение таблиц по сегментам;
- Изменение типа сжатия;
- Вакуумирование;
- Анализ и оптимизация скриптов.
Полученные результаты
Итогом проекта разработки КХД стала реализация отказоустойчивого решения. Разработанное КХД предусматривает возможность расширения атрибутивного состава без существенного увеличения стоимости решения, т.е. не приводит к неконтролируемому росту затрат при добавлении новых бизнес-сущностей. Данные разных форматов унифицированы и обновляются по индивидуальному для каждого источника регламенту. Работа с данными через КХД позволяет регулировать нагрузку на источники, которая создается пользователями бизнес-систем. По итогам проекта у пользователей появилась возможность быстрее и проще получать доступ к необходимым данным, что позволяет увеличить скорость работы с данными для принятия аналитических решений.
Продукт Эксперт-BI

Продукт Эксперт-BI, запросить доступ к демо-стенду on-line


