

Потоковая обработка: реальное время и near real-time
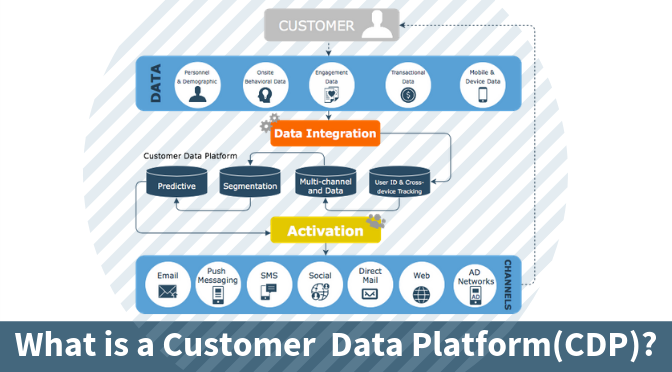
Потоковая обработка — это способ обработки данных по мере их появления, в режиме, близком к реальному времени. В контексте курса «Курс Использование BI и DWH при внедрении Customer Data Platform CDP» это один из важнейших инструментов для построения единого представления о клиенте: когда события пользователей поступают в систему почти мгновенно, мы можем обновлять профили, сегменты и правила активации в реальном времени. Реальное время и near real-time (близко к реальному времени) позволяют снизить задержки между сбором данных и их использованием для персонализации, метрик и анализа. В этой главе мы подробно разберём теорию, практику и технические детали потоковой обработки, приведём примеры реальных архитектур как на открытом ПО, так и на российских решениях, обсудим риски и ограничения внедрения, а в конце — FAQ на основании изученного материала.
Основные понятия и контекст
- Поточная обработка (stream processing) обрабатывает данные по мере их поступления как непрерывный поток событий, в отличие от пакетной обработки (batch), где данные собираются за период и затем обрабатываются целиком.
- Реальное время (real time) обычно означает задержку обработки в рамках секунды или доли секунды после появления события. Near real-time (near RT) — задержка может быть измерена десятками секунд или несколькими минутах, но всё равно остаётся быстрой и управляемой.
- Источники данных в CDP часто представляют собой веб- и мобильные события, логи приложений, изменения в OLTP-базах (CDC), данные из CRM/ERP и внешние потоки. Эффективная потоковая архитектура позволяет эти источники соединить в единый потоковой конвейер.
-
Архитектура Lamba vs Kappa:
- Lambda: разделение на «слой пакетов» и «слой потоков» с двойной обработкой (одни и те же данные обрабатываются двумя путями). Это сложнее в поддержке и требует синхронизации между слоями.
- Kappa: единая потоковая дорожка, где пакетная обработка получается как результат оффлайн-обработки из потока. Упрощает архитектуру и чаще применяется в CDP для более быстрой и устойчивой обработки.
-
Временные концепции:
- Processing time — время обработки события системой.
- Event time — фактическое время, когда событие произошло, как указано в источнике.
- Watermarks — механизм для оценки того, какие события до какого момента можно считать «зафиксированными» в окнах.
- Окна: tumbling (непересекающиеся интервалы), sliding (пересекающиеся интервалы), session (окна по времени бездействия).
-
Семантика обработки:
- Exactly-once semantics: гарантирует, что каждое событие будет учтено ровно один раз, даже при сбоях и повторных отправках.
- At-least-once/at-most-once: возможны дубликаты или пропуски в случае сбоев; некоторые бизнес-кейсы допускают такую семантику для упрощения.
- Stateful vs stateless обработчики: stateful-операторы сохраняют состояние между запусками (например, счетчики, агрегации, кэш идентичности), что требует управления состоянием и устойчивыми механизмами сохранения.
- Надёжность и мониторинг: checkpointing, восстановление после сбоев, ретрансляция данных, контроль качества данных (data quality), наблюдаемость (критически важно для CDP).
- Взаимосвязь поточной обработки и BI/DWH: потоковые данные могут быть источником для «живой» аналитики в DWH, для обновления профилей CDP, сегментации в реальном времени и активации кампаний.
Методологии и принципы проектирования потоковых систем
- Выбор архитектуры: для CDP чаще применяется чистая потоковая архитектура (Kappa) с единым конвейером обработки и интеграцией в хранилище данных и в слой активаций.
- Управление качеством данных: схема данных, унификация идентификаторов, обработка дубликатов, управление схемами и эволюцией схем через Schema Registry.
- Идентификация и консолидация профилей: потоковое обновление профилей пользователей, сопоставление устройств и пользователей, построение единого «glue»-профиля.
- Латентность vs полнота данных: баланс между скоростью обновления и полнотой данных; в некоторых случаях допустима чуть более длительная задержка ради повышения точности.
- Обеспечение согласованности: Exactly-once обработка на уровне стриминга, idempotent sinks, повторные попытки записи без дублирования.
- Управление временными окнами: выбор типа окна и настройка водных меток (watermarks) для корректного аггрегационного анализа по времени события.
- Безопасность и соответствие требованиям: шифрование в пути и в покое, управление доступом, локализация данных, соответствие ГО и GDPR.
Практические примеры
Пример 1. Архитектура потоковой обработки веб-событий и реального времени в CDP (open-source стек)
- Источники данных: веб- и мобильные события отправляются в потоковую систему через продюсеров в Apache Kafka.
- CDC и OLTP: для синхронизации изменений из OLTP-систем (например, MySQL/PostgreSQL) применяем Debezium как источник CDC, который публикует события изменений в Kafka.
-
Обработка: Apache Flink — на входе поток из Kafka, выполняются преобразования, обогащения и вычисления сегментов. Функции включают:
- Преобразование событий в унифицированную схему.
- Обогащение профилями из мастер-данных (MDM/identity store).
- Вычисление реальных сегментов аудитории в окнах (например, за последние 5 минут) и обновление атрибутивной информации профиля.
- Вычисление ключевых KPI в реальном времени (например, частота покупки, латентная конверсия).
- Хранилище и экспорт: результаты отправляются в ClickHouse для оперативной аналитики и в data lake (S3/ HDFS) для долгосрочного хранения; также публикуются обновления профилей в CDP-индекс (Identity Graph) для активного использования в сегментации и персонализации.
- Мониторинг и безопасность: Prometheus/Grafana собирают метрики производительности и задержек, применяются TLS и SASL для Kafka, роли доступа определены на уровне тем и сервисов.
- Преимущества: минимальная задержка между событием и обновлением профиля; возможность немедленной активации кампаний по пользовательскому поведению.
Пример 2. Российские решения и локальная экосистема
- Инструменты: Яндекс Data Streams как управляемый источник потоков, совместимый по API с Kafka и интегрируемый с экосистемой Яндекс Облако.
- Обработка: Apache Flink на кластере в Яндекс Облаке, соединённый с ClickHouse для хранения и DataLens для визуализации BI-слоя.
- Ингест: события с веб-ресурсов и мобильных приложений публикуются в Kafka-совместимый канал, который может держаться в Data Streams; Debezium может применяться для CDC из локальных систем и синхронной репликации в облако.
- Хранилище: ClickHouse обеспечивает быстрый ответ в реальном времени и поддерживает инференцию через столбцатую структуру; Data Lake — S3-совместимый хранилище в облаке.
- Преимущества и контекст: сильная локализация данных внутри российского облака, снижение задержек для регионального рынка, соответствие требованиям локализации и регуляторики.
Пример 3. Архитектура реального времени для активации сегментов
- Архитектура: потоковая подсистема формирует сегменты в реальном времени (например, «пользователь сегодня посетил сайт и добавил товар в корзину»), и результаты публикуются в систему активации (например, рекламные платформы или в мобильное приложение).
- Включаемые компоненты: Flink для агрегаций по окнам, Kafka как транспортное средство, ClickHouse как аналитическая витрина, Redis или VoltDB для быстрых кэш-слоев профилей, S3 как хранилище архивных данных.
- Результат: пользовательский профиль обновляется практически мгновенно, системаSegmentUpdate публикуется в интерфейс персонализации и в рекламные кампании.
Примечание о выборке технологий
- Open-source решения: Apache Kafka (платформа для потоков), Apache Flink (поточная обработка и exactly-once обработка, управление состоянием), Apache Spark Structured Streaming (потоки и микро-батчи), Apache NiFi (потоковая интеграция данных и маршрутизация), Apache Pinot/ClickHouse (реальное аналитическое представление), Debezium (CDC), Schema Registry (для эволюции схем).
- Российские решения и локальные практики: Яндекс Data Streams как управляемая платформа для потоков, ClickHouse как российский по происхождению высокопроизводительный аналитический столбцовый хранилище, DataLens и другие инструменты BI, поддерживающие интеграцию с потоками и SQL-подобными интерфейсами. Эти решения позволяют держать данные внутри российского юридического пространства, снижать задержки и соответствовать требованиям локализации данных.
Архитектура и конфигурации
-
Архитектура конвейера:
- Источник данных: веб/мобильные события, CDC из OLTP, внешние источники.
- Платформа потоков: брокер сообщений (Kafka или Яндекс Data Streams) для транспортировки событий.
- Обработчик потока: Apache Flink (stateful и windowed вычисления) или Apache Spark Structured Streaming.
- Хранилище результатов: ClickHouse для реального времени, data lake для архива, возможно MDM/identity-store для профилей.
- BI/активация: DataLens, dashboards, персонализация в приложении, рекламные платформы.
-
Конфигурация CDC через Debezium:
- Источник: MySQL или PostgreSQL.
- Коннектор Debezium публикует изменения в Kafka с ключами, значениями и временем события.
- Управление схемой: использование Schema Registry для совместимости и эволюции.
-
Конфигурация Flink-процесса:
- Источники: Kafka consumer с темами событий.
- Преобразование: map/flatMap, фильтрация, обогащение данными из мастер-данных.
- Аггрегации: оконные вычисления (tumbling/sliding windows) по event-time, с watermarking.
- Водительское время и задержка: выбор watermark-а в зависимости от источника и latency budget.
- Сливка и стейт: использование RocksDB как state backend для больших состояний, менеджмент checkpoint-interval (например, 5-15 минут) и частоты сохранения прогресса.
- Sink: в ClickHouse через коннектор (Kafka -> ClickHouse sink) с поддержкой Exactly-Once semantics.
-
Эволюция схем:
- Использование Avro или Protobuf в сочетании с Schema Registry для совместимого обновления схем без потери данных.
- Политика совместимости: backward/forward/compatibility modes; поддержка схемной миграции без остановки конвейера.
-
Мониторинг и управление качеством:
- Метрики Latency, Throughput, Processing Time, Watermarks, num of_failed_checks, количество недоступных sink-ов.
- Трекинг ошибок и алертинг: Prometheus + Grafana; централизованный лог-менеджмент (ELK/EFK) и трассировка (OpenTelemetry).
-
Безопасность и соответствие:
- Трафик TLS, аутентификация SASL/ Kerberos в Kafka и Secure HTTP в REST-интерфейсах.
- Управление доступом на уровне тем, проектов и источников; аудит операций.
- Гео-локализация данных и соответствие требованиям регуляторов.
-
Производительность и эксплуатация:
- Тюнинг пропускной способности: настройка параллелизма, увеличение числа партиций Kafka, масштабирование Flink-операторов.
- Управление задержкой и дубликатами: обеспечение Exactly-Once на уровне конвейера и sink-слоя.
- Планирование ресурсов: вычислительная мощность кластера Flink, размер памяти для state, периодичность checkpoint’ов.
-
Примеры конфигураций (описательно):
- Kafka: несколько топиков для событий, с ключами user_id и timestamp, поддержка компоновки схем и безопасного доступа.
- Debezium: коннектор для конкретной базы, параметры для захвата изменений таблиц с нужными полями и временными метками.
- Flink: источники для Kafka, трансформации и маппинг в единый формат, окна по event-time с watermark-ами, sinks в ClickHouse и Kafka Topic-управление результатами.
- ClickHouse: таблицы для реального времени (плотные) и денормализованные формы для быстрого анализа; возможна интеграция с Pinot/Druid для OLAP-аналитики.
-
Практический сценарий моделирования идентичности:
- Потоковые данные объединяют события и профиль пользователя через уникальные идентификаторы (user_id, device_id).
- В реальном времени выполняется сопоставление и консолидация профиля, обработка конфликтов идентификаторов и создание единого 360-градусного профиля.
- Обновления профиля проходят через Kafka и отражаются в целевой системе.
Риски и ограничения
- Задержки и латентность: непредсказуемая задержка в зависимости от загрузки кластера, сетевых задержек и качества источников; критично для персонализации и активаций в реальном времени.
- Управление временем: несогласованные event-time и processing-time могут приводить к неверным окнам и агрегатам; водные метки должны корректно отражать поступление событий.
- Дубликаты и потери данных: особенно при сбоях, повторной отправке сообщений и неполной обработке; требует exactly-once и idempotent sinks.
- Сложность развития схем: изменения структуры данных требуют совместимости и планирования миграций; некорректное управление схемами может привести к ошибкам в обработке.
- Стоимость и операционная нагрузка: поддержка потоков требует аппаратного обеспечения, лицензий и квалифицированных специалистов; рост объёмов может существенно увеличить эксплуатационные затраты.
- Совместимость и интеграция: различные компоненты (CDC, Kafka/Data Streams, Flink, ClickHouse, BI-системы) должны надёжно взаимодействовать; несовместимость версий может прервать конвейер.
- Риск потери данных при локализации: локальные решения могут ограничивать геораспределённость, согласование политик доступа и репликацию между регионами.
- Юридические и регуляторные ограничения: локализация данных, требования к хранению персональных данных, санкции и требования к аудитам.
- Безопасность: потоковые решения уязвимы к атакам через источники данных; необходимы постоянный мониторинг, обновления и строгие политики доступа.
- Непредвиденные блокировки рынка: зависимость от облачных поставщиков или определённых экосистем может создавать риски поставок и обновления технологий.
Потоковая обработка в контексте KPI CDP даёт возможность обеспечить практически мгновенное обновление профилей клиентов, динамическую сегментацию и оперативную активацию кампаний. Правильное разделение обязанностей между источниками, конвейером обработки и слоями хранилища, а также грамотная настройка event-time, watermark’ов и окон позволяют минимизировать задержки и повысить точность сегментации. Важно помнить, что реализация должна опираться на архитектуру Kappa, в которой единая потоковая дорожка обеспечивает единообразие обработки, устойчивость к сбоям и простоту поддержки. Российские и открытые решения дают возможность строить локальные, масштабируемые и управляемые потоки, адаптированные под требования локального рынка и регуляторов, сохраняя при этом гибкость и высокую производительность. В реальных проектах стоит начинать с минимального жизненного контура, затем плавно расширять конвейеры и добавлять новые источники и применения — всегда с учётом latency-budget, качества данных и обеспечения безопасности.
Вопрос–Ответ (FAQ)
Что такое near real-time и чем он отличается от реального времени?
Near real-time представляет собой задержку обработки в диапазоне tens of seconds до нескольких минут, тогда как реальное время обычно предполагает задержку на уровне секунд или долей секунды. В CDP near RT часто достаточен для обновления сегментов и профилей в рамках оперативной аналитики, тогда как требования к мгновенной персонализации могут потребовать более низкой задержки и полного потока в реальном времени.
Какие основные концепции важны в потоковой обработке для CDP?
Ключевые концепции: event time vs processing time, watermarks, оконные вычисления (tumbling, sliding, session), stateful vs stateless обработчики, exactly-once semantics, архитектура Kappa против Lambda, управление схемами через Schema Registry, мониторинг и контроль качества данных. Всё это критично для корректной консолидации профилей и качественных сегментов.
Какие технологии обычно применяют в открытом ПО для потоковой обработки?
Часто используют Apache Kafka как брокер сообщений, Apache Flink как движок потоковой обработки с поддержкой exactly-once, Apache Spark Structured Streaming как альтернатива, Debezium для CDC, Apache NiFi для потоковой интеграции, а для аналитики — ClickHouse и Pinot/Druid в качестве аналитических витрин. В качестве схем и контрактов — Avro или Protobuf с Schema Registry.
Какие российские решения можно использовать в рамках CDP-потоков?
Российские варианты включают Яндекс Data Streams как управляемый источник потоков и Яндекс Облако, интегрируемые с экосистемой Яндекса (кластеры Flink, ClickHouse, DataLens для BI). ClickHouse — российское происхождение и широко применяется для реального времени аналитики; DataLens — BI-слой поверх столбцовых хранилищ. Это позволяет держать данные в российском облаке и соответствовать локальным регуляторным требованиям.
Как обеспечить Exactly-Once в потоковой конвейере?
Обеспечение Exactly-Once достигается через комбинацию:
- источники и sinks поддерживают гарантию сохранения сообщений (Kafka/SASL-TLS и транзакционные продюсеры).
- обработчик потоков (например, Flink) с включённой чекпойнтингом и состоянием, которое восстанавливается без потери данных.
- консистентные sinks, где возможна атомарная запись в целевые хранилища (например, ClickHouse через Kafka sink с транзакциями или обновления в виде апдейтов на вероятностной основе).
- idempotent operations на уровне sinks, чтобы повторные записи не портили данные.
- мониторинг и ретрай-стратегии.
Какие риски характерны для внедрения потоковой обработки в CDP?
Риски включают задержки и непредсказуемость латентности, сложности с управлением временем (event-time vs processing-time), дубликаты и утраты данных при сбоях, рост сложности архитектуры и затрат, регуляторные требования к локализации и соответствие. Кроме того, риск vendor lock-in, если выбираются специфические облачные сервисы, и необходимость постоянной поддержки схем и интеграций.
Какие данные и сценарии являются типичными для потоковой обработки в CDP?
Типичные сценарии:
- реальное обновление профиля клиента на основе потоков событий и изменений в OLTP;
- живые сегменты, основанные на последних действиях пользователя (посещение сайта, просмотр товара, добавление в корзину);
- CDC-синхронизация изменений в мастер-данных и их интеграция в единый identity graph;
- активации кампаний в реальном времени на основе поведения и сегментирования;
- мониторинг и предупреждения (реальные сигналы) по поведению клиентов.
Какую роль играет схема и управление данными в потоках?
Схема определяет формат сообщений и влияние на совместимость приложений. Schema Registry обеспечивает совместимость эволюций схем и упрощает стратегию изменений. Без надёжного управления схемой можно столкнуться с несовместимостью, потерями данных и падениями конвейера.
Как выбирать между открытым ПО и российскими решениями?
Выбор зависит от требований к локализации, регуляторики, контрактов на обслуживании и доступности специалистов. Открытое ПО даёт гибкость, прозрачность и широкое сообщество, но требует больше управляемых ресурсов. Российские решения позволяют локализацию и соответствие требованиям, часто хорошо интегрируются с локальными BI-слоями и инфраструктурой, но требуют клиентов к конкретному стеку и контрактной поддержки. В идеале можно сочетать: локальные сервисы для ingestion и хранения (Яндекс Data Streams, ClickHouse) вкупе с открытым ПО для обработки (Flink, Kafka) и BI-слой DataLens.
Какие метрики и KPI важны для мониторинга потоковой конвейера в CDP?
Критически важны: задержка (latency) от события до обновления профиля/сегмента, пропускная способность (throughput), доля ошибок, число повторных обработок, размер состояния, частота checkpoint-ов, время выполнения окон, точность профилей и сегментов, коэффициент деградации при сбоях. Наблюдаемость должна быть сквозной: источники, конвейер обработки, хранилища и BI-слой.
Потоковая обработка в рамках CDP обеспечивает быстрый доступ к обновленным данным, позволяет поддерживать актуальные профили клиентов и оперативно активировать персонализированные кампании. Важно выбрать правильную архитектуру (часто предпочтение отдают единообразной потоковой дорожке в духе Kappa), грамотно спроектировать обработку событий с учетом event-time, watermark и окон, обеспечить надёжность и безопасность, а также учесть юридические требования по локализации и хранению персональных данных. Реальные примеры на открытом ПО и российских решениях показывают, что можно построить устойчивую, масштабируемую и соответствующую регуляторике инфраструктуру потоковой обработки, которая дополняет DWH и BI слои, давая ценные преимущества в скорости и точности клиентской аналитики и активаций.


