

Концептуальная, логическая и физическая модель данных
В рамках обучающего курса «Курс Использование BI и DWH при внедрении Customer Value Management Maximization CVM» одной из ключевых тем является построение концептуальной, логической и физической моделей данных. Правильно спроектированная модель данных — фундамент для качественной аналитики, позволяющей управлять ценностью клиента, прогнозировать доходность кампаний и быстро адаптироваться к изменению рынка. В этой главе вы познакомитесь с основными уровнями моделирования данных (концептуальным, логическим и физическим), рассмотрите методологии (звездная схема, Data Vault 2.0 и другие подходы), приведёте пример реальных структур данных для CVM, а также узнаете, как это применяется на практике в BI и DWH-проектах. Также мы рассмотрим технологические решения (open-source и российские инструменты), примеры реализации и риски внедрения.
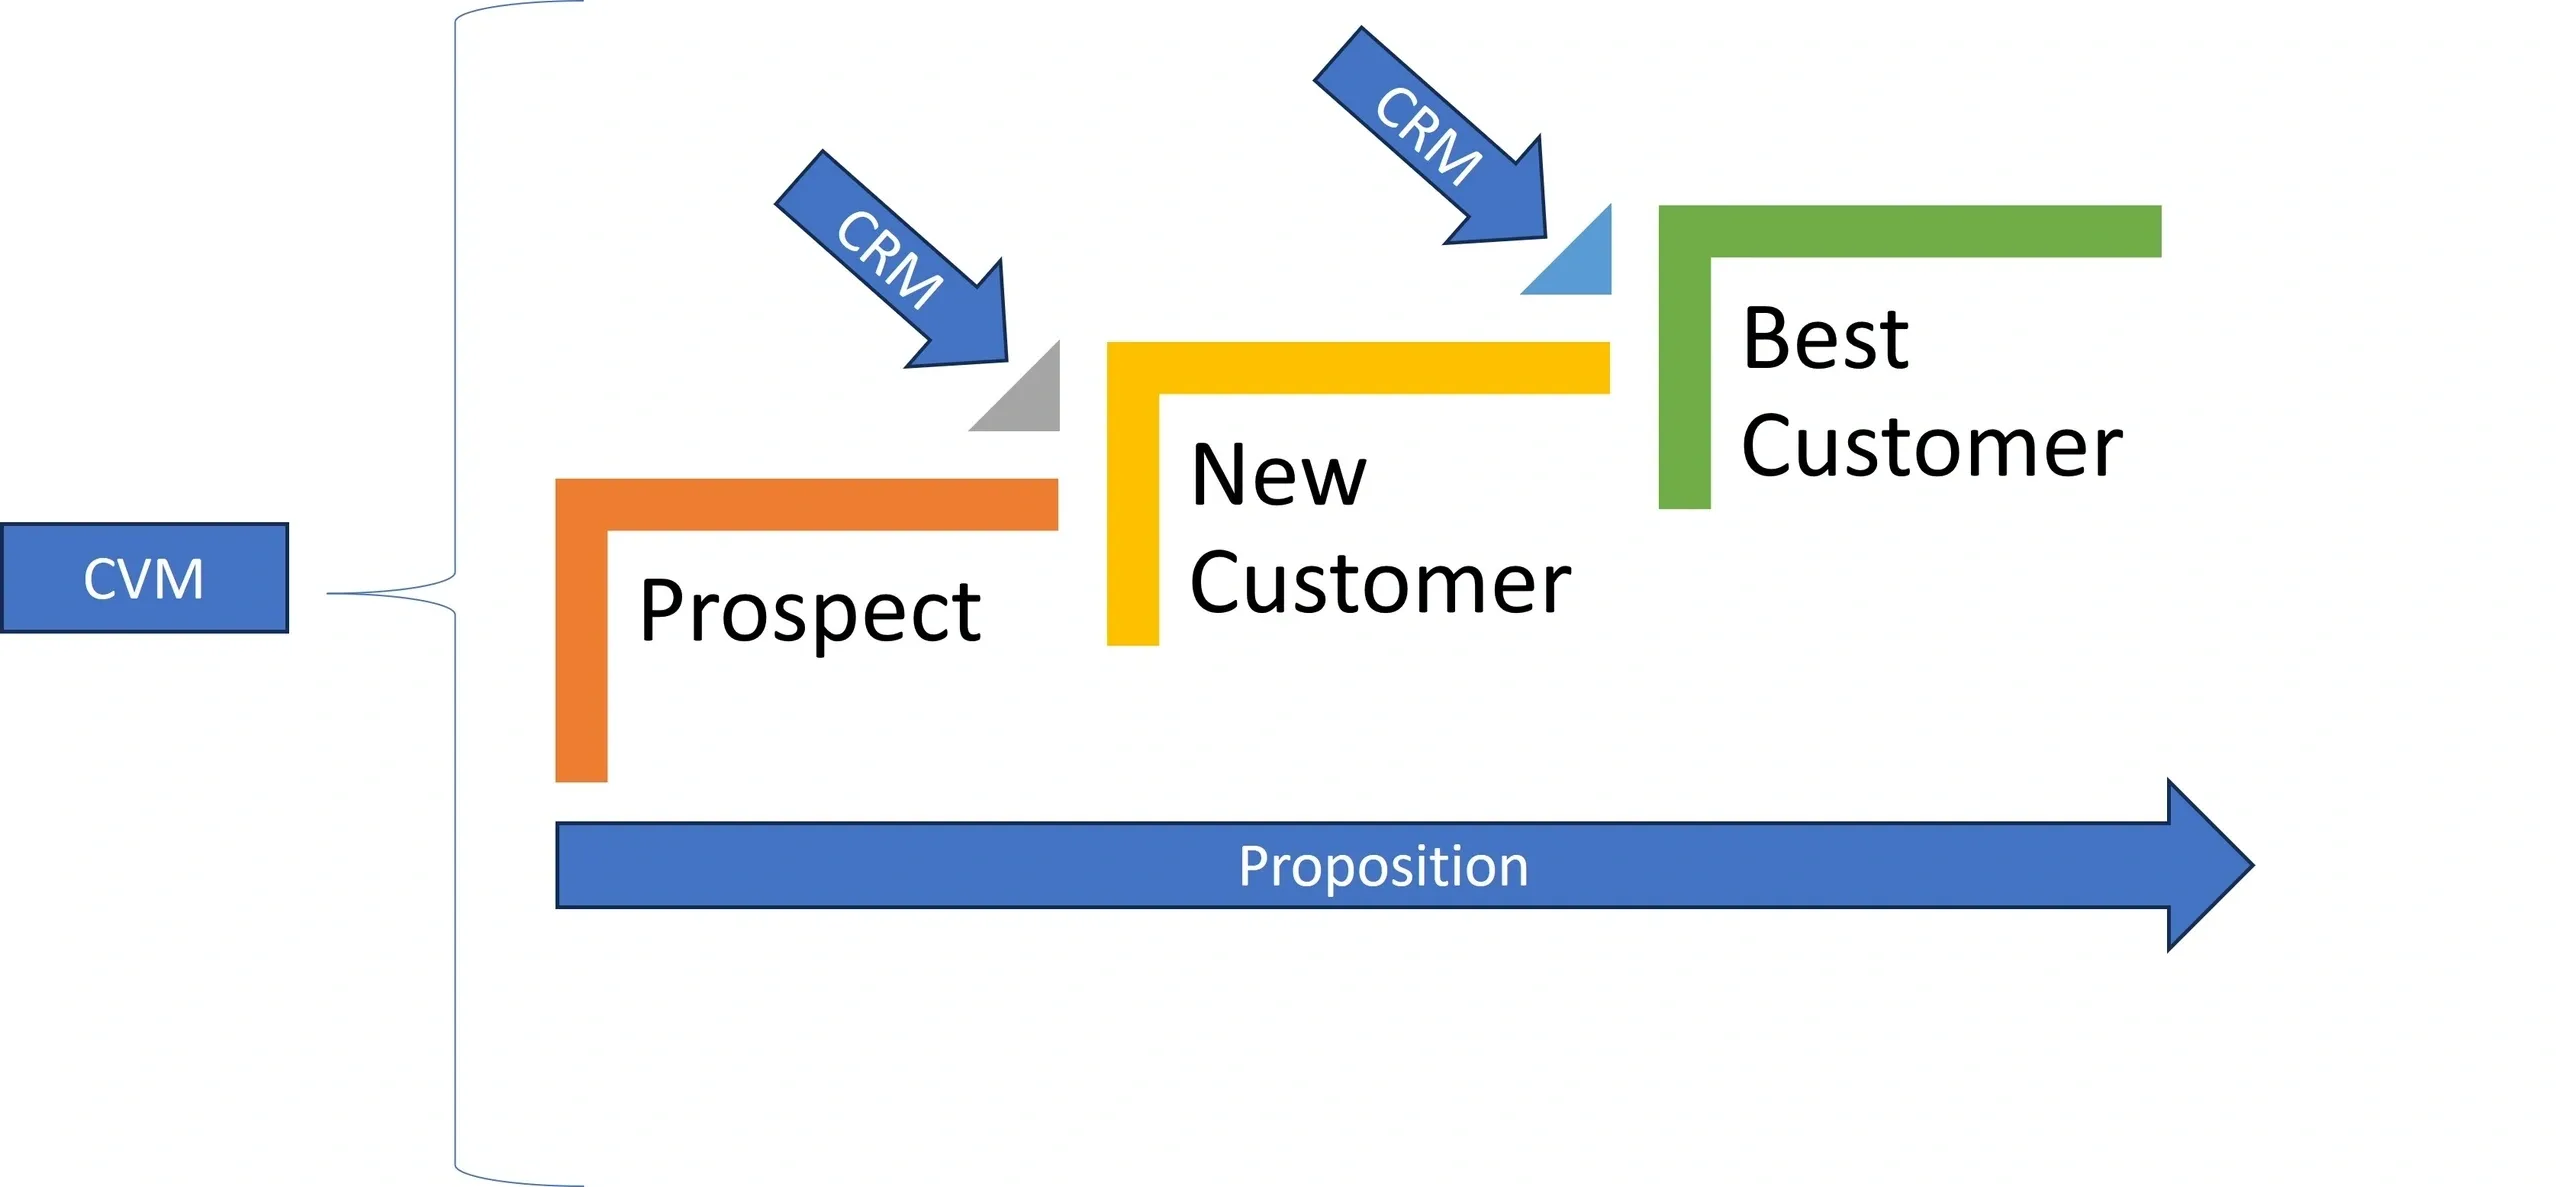
Что такое концептуальная, логическая и физическая модель данных
- Концептуальная модель данных описывает бизнес-сущности и их взаимосвязи на высоком уровне без привязки к конкретной технологии хранения. В CVM она включает такие понятия, как Клиент, product, канал взаимодействия, кампания, интеракция, транзакция, сегмент, показатель ценности клиента (CLV), коэффициенты поведения (RFM, вероятности оттока и т. п.).
- Логическая модель данных превращает концепты в более детализированную схему: определение атрибутов сущностей, их типов и отношений между сущностями. Здесь мы начинаем учитывать требования аналитики: атрибуты клиента (идентификатор, возраст, сегмент), атрибуты продукта, метаданные по времени, каналы маркетинга, факты взаимодействий и т. п.
- Физическая модель данных адаптирует логическую модель под конкретную СУБД и технические требования проекта: выбор СУБД, структура таблиц, индексы, партиционирование, настройки хранения и скорость выполнения запросов. В CVM физическая модель должна обеспечивать быстрый доступ к фактам ценности клиента, эффективную агрегацию по времени и по каналам, а также масштабируемость при росте объёмов данных.
Методологии моделирования данных
- ER-модель и нормализация: полезна на начальном этапе концептуального и логического моделирования, особенно для сложных предметных областей. Однако для аналитических систем часто предпочтительнее денормализация ради быстрого чтения и упрощения запросов.
- dimensional modeling (Kimball) и star/snowflake схемы: широко применяются в DWH для аналитических задач CVM. Главный элемент — факт-таблица с величинами измерения и набором измерений (размерности). Преимущество — простые и быстрые запросы для бизнес-аналитики, понятные метрики.
- Data Vault 2.0: альтернативный подход к DWH, ориентированный на устойчивость к изменениям требований, сильную историю и гибкость адаптации к новыми источникам. В DV используют три типа объектов: Хабы (Hubs) — уникальные бизнес-ключи, Линки (Links) — связи между ключами, Сателлиты (Satellites) — атрибуты и исторические изменения. DV хорошо подходит для сред данных CVM, когда источники разнообразны, а требования к истории и линейности изменяются.
- Управление метаданными и качество данных: в CVM критично отслеживать источник данных, преобразования, линейность изменений и соответствие требованиям бизнеса. Встроенные процессы lineage и качество помогают уверенно использовать данные в моделях риска и ценности клиента.
Основные домены и концепции CVM в модели данных
- Клиент (Customer): идентификатор клиента, демография, сегментация, история взаимодействий.
- Продукт (Product) и Категории: информация о товарах, услугах, которые могут быть объектами кампаний и анализа LTV.
- Взаимодействия/Интеракции (Interaction): записи о касаниях с клиентом через каналы маркетинга (email, push-уведомления, звонки, визиты на сайт).
- Кампания (Campaign): маркетинговая кампания, её цели, период, бюджет, таргетинг.
- Канал (Channel): оффлайн/онлайн каналы (email, сайт, мобильное приложение, звонок).
- Время (Time/Date): DimDate, позволяющая агрегировать показатели по дням, неделям, месяцам, кварталам.
- Факты ценности клиента (Fact_CVM или Fact_CustomerValue): ключевые измерители — доход клиента, CLV/LCV, совокупная выручка, средний чек, частота покупок, RFM-показатели, вероятность оттока.
- Метрики и сегменты: RFM, CLV/LTV, конверсия, ретенш, коэффициенты отклика на кампанию, сегменты целевой аудитории.
Важные принципы и требования
- Линейность и временная история: CVM требует сохранения исторических изменений поведения клиентов и кампаний. Исторические данные позволяют оценивать тенденции, тестировать гипотезы и строить прогнозы.
- Логическая непротиворечивость: единый «слой» бизнес-логики, чтобы расчёты CLV, LTV и других показателей были согласованы между инструментами BI и моделями ML.
- Качественные данные и консистентность: проверка полноты, точности, единообразия данных между источниками (CRM, ERP, CMS, веб-аналитика и пр.).
- Масштабируемость и производительность: выбор архитектуры (Star/DV), подход к храненияю и индексации для поддержки возрастающих объёмов и скорости выполнения запросов.
- Безопасность и приватность: управление PII, соответствие требованиям GDPR/локальных законов, примеры маскирования и ограничение доступа по ролям.
Архитектура данных для CVM: уровни и потоки
- Стадия (staging): копии исходных данных из источников, минимальная переработка, сохранение исходного состояния.
- ODS (Operational Data Store) или интеграционный слой: сохранение очищенных и нормализованных данных для поддержки ежедневной обновляемости и консолидации.
- Data Warehouse / Data Mart: аналитический слой с моделью на уровне фактов и измерений. В CVM чаще применяются звездная схема или DV-модель для хранилища данных.
- Источники и обработка: ETL и ELT. В современных решениях часто применяют ELT-подход: данные сначала загружаются, затем трансформируются внутри целевой СУБД или обработчика (Spark, SQL-движки).
- Метаданные, качество и управляемость: каталог метаданных, lineage, политики качества данных, управление версиями схем.
Практические примеры
1. Реальная предметная область CVM: сценарий кампании
Предположим, банк розничного сегмента запускает кампанию по повторной покупке товаров в интернет-магазине. Источники данных:
- CRM: данные о клиентах, сегменты, предпочтения.
- E-commerce платформа: транзакции, посещения, корзины.
- Loyalty-система: баллы, участие в программах лояльности.
- Веб-аналитика: поведение на сайте, источники трафика, события.
2. Концептуальная модель для CVM
- Сущности: Клиент, Продукт/Категория, Кампания, Канал, Взаимодействие, Транзакция, Сегмент, Показатели (CLV, RFM, вероятность оттока).
- Связи: Клиент — Взаимодействие (один ко многим), Кампания — Взаимодействие (одна ко многим), Транзакция — Клиент (многие к одному), Кампания — Транзакция (многие к одному через взаимодействие), Продукт — Транзакция (многие к одному).
3. Логическая модель данных
Таблицы и атрибуты:
  DimCustomer: customer_id, first_name, last_name, email, segment, birth_date, gender, geography, signup_date, lifecycle_status.
  DimProduct: product_id, category, subcategory, price, brand, is_active.
  DimCampaign: campaign_id, name, start_date, end_date, objective, budget, channel_id.
  DimChannel: channel_id, name, type (online/offline), platform.
  DimDate: date_id, full_date, year, quarter, month, day, day_of_week.
  DimCustomerLoyalty: loyalty_id, tier, enrollment_date.
  FactTransaction: transaction_id, customer_id, product_id, campaign_id, channel_id, date_id, quantity, revenue, discount.
  FactCVM: cvm_id, customer_id, date_id, revenue, total_cost, gross_margin, rfm_score, clv, churn_probability, segment_assignment.
Пример связи:
  DimDate.date_id -> FactTransaction.date_id -> FactCVM.date_id
  DimCustomer.customer_id -> FactTransaction.customer_id -> FactCVM.customer_id
  DimCampaign.campaign_id -> FactTransaction.campaign_id -> FactCVM.campaign_id
4. Физическая модель: звездная схема (пример на SQL-подобном синтаксисе)
Примеры таблиц для PostgreSQL/ClickHouse:
  CREATE TABLE DimDate (
      date_id UInt32 PRIMARY KEY,
      full_date Date,
      year UInt16,
      quarter UInt8,
      month UInt8,
      day UInt8,
      day_of_week UInt8
    );
  CREATE TABLE DimCustomer (
      customer_id UInt64 PRIMARY KEY,
      first_name String,
      last_name String,
      email String,
      segment String,
      birth_date Date,
      gender String,
      geography String,
      signup_date Date
    );
  CREATE TABLE DimProduct (
      product_id UInt64 PRIMARY KEY,
      category String,
      subcategory String,
      brand String,
      price Decimal(10,2),
      is_active UInt8
    );
  CREATE TABLE DimCampaign (
      campaign_id UInt64 PRIMARY KEY,
      name String,
      start_date Date,
      end_date Date,
      objective String,
      budget Decimal(18,2),
      channel_id UInt64
    );
  CREATE TABLE DimChannel (
      channel_id UInt64 PRIMARY KEY,
      name String,
      type String
    );
  CREATE TABLE FactTransaction (
      transaction_id UInt64 PRIMARY KEY,
      customer_id UInt64 REFERENCES DimCustomer(customer_id),
      product_id UInt64 REFERENCES DimProduct(product_id),
      campaign_id UInt64 REFERENCES DimCampaign(campaign_id),
      channel_id UInt64 REFERENCES DimChannel(channel_id),
      date_id UInt32 REFERENCES DimDate(date_id),
      quantity UInt32,
      revenue Decimal(18,2),
      discount Decimal(18,2)
    );
  CREATE TABLE FactCVM (
      cvm_id UInt64 PRIMARY KEY,
      customer_id UInt64 REFERENCES DimCustomer(customer_id),
      date_id UInt32 REFERENCES DimDate(date_id),
      revenue Decimal(18,2),
      total_cost Decimal(18,2),
      gross_margin Decimal(18,2),
      rfm_score Float64,
      clv Float64,
      churn_probability Float64,
      segment_assignment String
    );
5. Вариант Data Vault 2.0 (для устойчивости к изменениям источников)
- Хабы: HubCustomer (customer_id, load_date), HubCampaign (campaign_id, load_date), HubProduct (product_id, load_date)
- Линки: LinkCustomerCampaign (customer_id, campaign_id, load_date), LinkCustomerProduct (customer_id, product_id, load_date)
- Сателлиты: SatCustomer (customer_id, first_name, last_name, email, demographics, load_date, end_date), SatCampaign (campaign_id, objective, budget, load_date), SatProduct (product_id, category, brand, price, load_date)
- Пример DDL для DV очень упрощённо:
  CREATE TABLE HUB_CUSTOMER (BUSINESS_KEY UInt64 PRIMARY KEY, LOAD_DATE Date);
  CREATE TABLE LINK_CUSTOMER_CAMPAIGN (CUSTOMER_KEY UInt64, CAMPAIGN_KEY UInt64, LOAD_DATE Date, PRIMARY KEY (CUSTOMER_KEY, CAMPAIGN_KEY));
  CREATE TABLE SAT_CUSTOMER (CUSTOMER_KEY UInt64, FIRST_NAME String, LAST_NAME String, EMAIL String, BIRTH_DATE Date, GENDER String, GEO String, LOAD_DATE Date, END_DATE Date);
6. Практические примеры использования данных CVM
- Расчёт CLV: сумма дисконтированных прибылей по клиенту за весь период с учётом маржи и стоимости услуг, коррелированная с датой последней покупки.
- RFM-анализ: Recency, Frequency, Monetary — групповая сегментация клиентов по поведению.
- Прогнозирование оттока: использование исторических данных по взаимодействиям и покупкам для моделирования вероятности оттока и повышения удержания.
- Пример запросов (упрощённый SQL-подход):
Получение CLV по клиенту:
    select c.customer_id, sum(f.revenue) as clv
    from FactTransaction f
    join DimCustomer c on f.customer_id = c.customer_id
    group by c.customer_id;
Релевантная сегментация по RFM (упрощённый пример):
    select customer_id,
           max(case when r.rank = 'R1' then 1 else 0 end) as recency_flag,
           max(case when f.rank = 'F3' then 1 else 0 end) as frequency_flag,
           max(case when m.rank = 'M2' then 1 else 0 end) as monetary_flag
    from (
      select customer_id,
             recency_rank(date_diff('day', MAX(date_id), current_date)) as rank
      from FactTransaction
      group by customer_id
    ) r
    join (
      select customer_id,
             sum(quantity) as freq
      from FactTransaction
      group by customer_id
    ) f on r.customer_id = f.customer_id
    join (
      select customer_id,
             sum(revenue) as mon
      from FactTransaction
      group by customer_id
    ) m on r.customer_id = m.customer_id
    group by customer_id;
7. Инструменты и решения: open-source и российские
Open-source решения:
- ClickHouse: высокопроизводительная колонковая OLAP-база данных, особенно хорошо подходит для CVM-аналитики в реальном времени, поддержки больших объемов и быстрого агрегационного анализа по времени.
- Apache Spark: обработка больших данных, машинное обучение, интеграция данных из разных источников.
- Apache Airflow: оркестрация ETL/ELT-процессов, управление зависимостями задач, мониторинг.
- Apache Kafka: потоковая обработка и интеграция данных из разных систем в реальном времени.
- PostgreSQL или Greenplum: для OLAP/OLTP регионов, структура и индексация под запросы.
- Apache Hive/Presto/Trino: SQL на больших данных, объединение источников.
- DataHub/OpenLineage/Great Expectations: управление качеством данных и линейностью.
- BI-инструменты: Apache Superset, Metabase, Redash — открытые средства визуализации и анализа.
Российские и локальные решения:
- ClickHouse (разработан в России, открытый код): эффективное хранилище для OLAP-аналитики и CVM-показателей; активно применяется в российском и глобальном рынках.
- DataLens (Яндекс): российская BI-платформа для визуализации и анализа данных; хорошо интегрируется с ClickHouse и другими источниками; поддерживает просмотр дашбордов и создание отчетности без написания сложных SQL-запросов.
- Яндекс.Метрика и Яндекс.Аналитика: веб-аналитика, источники данных для CVM в онлайн-каналах. Их данные можно интегрировать через конвейеры в DWH.
- 1С-биноиды и интеграционные шлюзы: в рамках предприятий, где основными системами являются 1С, используется интеграция данных в DWH через конверторы и мосты.
- Возможны решения от российских систем интеграции и консалтинговых компаний, специализирующихся на интеграции CVM в отечественных организациях, которые предлагают готовые конвейеры и шаблоны под отраслевые требования.
Методы реализации и проектный подход
- Выбор подхода к моделированию: звездная схема для быстрой аналитики и простоты использования бизнес-аналитиками; Data Vault 2.0 — если источники разнообразны, часто меняются и важна история изменений. В CVM можно сочетать: основная звездная схема для ежедневной аналитики и DV как слой истории и интеграции источников.
-
Этапы проекта:
- Сбор требований бизнеса: какие показатели ценности клиента нужны, какие метрики должны поддерживаться, какие сегменты используются.
- Анализ источников данных: какие источники есть, частота обновления, качество и совместимость.
- Проектирование концептуальной, логической и физической моделей данных.
- Выбор технологий: база данных (например, ClickHouse для хранилища фактов), инструмент для оркестрации (Airflow), инструмент BI (DataLens).
- Реализация ETL/ELT процессов: извлечение, очистка, нормализация, загрузка; создание фактов и измерений; контроль качества.
- Внедрение метаданных и lineage: документирование источников, версий схем, процедур обновления.
- Тестирование и валидация: сравнение результатов между источниками, регрессионное тестирование для новых обновлений.
- Развертывание и эксплуатация: мониторинг производительности, обновления схем, управление доступами и безопасностью.
Риски и ограничения внедрения
- Неполнота источников данных: если часть каналов отсутствуют или данные неполные, ценность анализа CLV и RFM может быть искажена.
- Качество данных и консистентность: различия в форматах, дубликаты, пропуски; без качественных пайплайнов риск ошибок в расчетах.
- Задержки обновления и латентность: оперативная аналитика требует своевременности. В CVM задержка может приводить к пропускам в таргетинге и пропускам в результатах.
- Сложность интеграции источников: CRM, ERP, веб-аналитика, платформы электронной торговли — у каждого источника свои модели данных и смысловые различия. Требуется согласование семантики.
- Проблемы миграции и версионирования схем: изменения в источниках данных могут повлиять на существующие ETL/ELT конвейеры и отчеты.
- Масштабируемость и производительность: при росте объема数据 и числа пользователей, запросы к фактам и измерениям должны оставаться быстрыми. Необходимо правильно выбрать партиционирование, индексы и архитектуру.
- Безопасность и приватность: хранение PII требует строгого контроля доступа, маскирования и соответствия требованиям GDPR/законодательства. Важно настроить ролевой доступ и шифрование.
- Риск доменной зависимости: если бизнес-логика перемещена на одну концепцию (например, конкретную платформу BI), любая смена платформы может стать дорогостоящей.
- Модели машинного обучения и drift: CLV, прогнозы оттока и другие меры требуют периодического реботинга моделей; без поддержки мониторинга качество ухудшается со временем.
- Ограничения регулятора и комплаенса: необходимо следить за соответствием хранению данных в определённых юрисдикциях.
Выводы
- Концептуальная, логическая и физическая модели данных — это не просто схемы. Это управляемый инструмент, который поддерживает ценностную аналитику CVM: от определения того, какие данные сохранить, до оперативной и плановой аналитики по CLV, сегментациям и коэффициентам отклика.
- Выбор методологии моделирования зависит от источников данных, требований к истории и скорости аналитики. В CVM часто разумно сочетать подходы: Star/Snowflake для повседневной аналитики и Data Vault 2.0 для устойчивости к изменениям источников и сохранения истории.
- Важность технических решений: выбор инструментов open-source (ClickHouse, Spark, Airflow, Kafka) и российских продуктов (DataLens, ClickHouse) позволяет построить эффективную архитектуру DWH и удобную бизнес-аналитику. Важно не забывать про безопасность, качество данных и метаданные.
- Реализация требует дисциплины: чёткая архитектура конвейеров данных, документирование моделей, регулярный контроль качества и мониторинг производительности являются ключами к длительной успешности проекта CVM.
Вопрос–Ответ (FAQ)
1) Что такое концептуальная, логическая и физическая модель данных и зачем они нужны в CVM?
Концептуальная модель описывает бизнес-сущности и их взаимосвязи на высоком уровне (например, Клиент, Кампания, Взаимодействие). Логическая превращает эти концепты в детализированную схему с атрибутами и связями. Физическая адаптирует схему под конкретную СУБД и требования к хранению, скорости и масштабируемости. В CVM это позволяет последовательно строить аналитическую архитектуру: от истории клиента до ценности и поведения, обеспечивая единое понимание данных и эффективную аналитику.
2) Как выбрать между звездной схемой и Data Vault 2.0 для CVM?
Звездная схема хороша для повседневной аналитики и быстрой генерации отчетов: понятная структура, быстрые запросы, простота обучения бизнес-пользователей. Data Vault 2.0 лучше, когда источники данных многочисленны, меняются со временем, и важна детальная история загрузок и изменений. В CVM часто эффективно использовать звездную схему как основной слой аналитики и Data Vault как промежуточный слой истории и интеграции источников.
3) Какие ключевые домены должны быть в модели для CVM?
Клиент, Продукт/Категория, Кампания, Канал, Взаимодействие, Транзакции, Время (DimDate), Показатели ценности (CLV, RFM, churn_probability), Сегменты. Дополнительно можно включать DimPage/DimChannel для онлайн-платформ, DimGeography, DimLoyalty и т. п.
4) Какие данные обычно нужны для расчета CLV и RFM в CVM?
CLV требует исторических данных о транзакциях, марже и времени покупки, а также стоимости обслуживания и скидок. RFM требует Recency (как давно клиент делал покупку), Frequency (частота покупок) и Monetary (сумма покупок). Эти данные обычно берутся из FactTransaction и DimCustomer вместе с DimDate и DimProduct.
5) Какие инструменты стоит использовать в open-source стеке для CVM?
ClickHouse для хранилища фактов и быстрых аналитических запросов; Apache Spark для обработки больших данных и подготовки признаков; Apache Airflow для оркестрации конвейеров; Apache Kafka для потоковой передачи данных; Superset или Metabase для BI-визуализации; DataHub/OpenLineage для метаданных и линейности; Great Expectations для качества данных.
6) Какие российские решения можно применить в CVM-проектах?
ClickHouse как российское решение для OLAP и хранилища фактов; DataLens как российский BI-инструмент для визуализации и дашбордов; использование Яндекс.Метрики и Яндекс.Аналитики как источников веб-аналитики. В рамках инфраструктуры можно использовать интеграционные мосты и конверторы к 1С и другим системам.
7) Какие риски и ограничения следует учитывать на старте проекта?
Неполнота источников, качество данных, задержки обновления, сложности интеграции, необходимость обеспечения приватности и соответствия требованиям регуляторов, риск миграций схем, масштабируемость и производительность, а также необходимость поддержки и обновления моделей машинного обучения.
8) Как реализовать контроль качества данных в CVM?
Внедрить набор правил и тестов с использованием Great Expectations или аналогичных инструментов: проверки полноты, уникальности ключей, консистентности между источниками, корректности числовых показателей. Включить мониторинг качества данных в CI/CD и в ежедневные конвейеры.
9) Какую архитектуру выбрать для скорости и масштабируемости?
Часто выбирают звездную схему с быстрыми агрегациями на ClickHouse, где фактовая таблица FactCVM и размерности позволяют быстро резать данные по времени, сегментам и каналам. Для истории и изменения источников можно внедрить Data Vault 2.0 как дополнительный слой слежения и адаптации к изменениям.
10) Какие действия стоит предпринять, чтобы минимизировать задержки в аналитике CVM?
Разграничить слои (staging, ODS, DW); применить ELT-подход и вычисления признаков внутри хранилища; оптимизировать партиционирование по DimDate и по клиентам; использовать инкрементальные загрузки; кэширование часто запрашиваемых агрегаций; настройку индексов и материализованных представлений там, где это поддержано СУБД.
Заключение
Развитие CMS CVM требует дисциплины в проектировании данных на всех уровнях: концептуальном, логическом и физическом. В сочетании звездной схемы, Data Vault 2.0 и современных инструментов open-source и российских решений можно создать устойчивую архитектуру DWH и мощный инструмент BI для максимизации ценности клиентов. Важно помнить о требованиях к качеству данных, безопасности и управлению метаданными, чтобы аналитика была достоверной и устойчивой к изменениям источников и бизнес-логики. Практический подход к проектированию и внедрению моделей данных в CVM — шаг за шагом: от бизнес-целей к технической реализации и непрерывной поддержке.
В завершение материала — вопросы и ответы
1) Какой именно уровень моделирования данных мы начинаем с CVM и почему?
Начинаем с концептуального уровня, чтобы зафиксировать бизнес-термины и взаимосвязи. Затем переходим к логической, где детализируем атрибуты и связи, и заканчиваем физическим уровнем, где проектируем таблицы, индексы и параметры хранения под выбранные технологии. Такой подход обеспечивает согласованность бизнес-я и технологических решений и позволяет избежать дорогих переработок на поздних стадиях проекта.
2) В чем преимущество Data Vault 2.0 для CVM-проектов?
DV2.0 лучше справляется с большим количеством источников и изменяющимися требованиями. Он хранит историю загрузок, поддерживает гибкую миграцию источников и упрощает интеграцию новых систем. Для CVM это особенно важно, когда добавляются новые каналы, новые источники данных или меняются бизнес-логики расчётов ценности клиента.
3) Какой стек инструментов лучше использовать для открытой экосистемы CVM?
Хорошая база: ClickHouse как OLAP-Хранилище; Spark для обработки данных и свертывания признаков; Airflow для оркестрации; Kafka для потоковых данных; SQL-платформа (Presto/Trino) для единообразного доступа; BI-инструменты (DataLens, Superset). В рамках российского рынка можно активно использовать DataLens и ClickHouse для аналитики CVM.
4) Какие основные компоненты физической модели необходимы для поддержки CVM?
DimDate, DimCustomer, DimProduct, DimCampaign, DimChannel, FactTransaction и FactCVM. В зависимости от подхода можно добавить DimGeography, DimLoyalty и другие вспомогательные размерности. Также стоит рассмотреть альтернативу DV с Hub-Links-Satellites для истории изменений.
5) Как повысить качество данных в CVM-проекте?
Внедрить процесс качества данных на каждом этапе конвейера: от источника до DW; использовать Great Expectations или аналог; создать линейку регламентов проверки и мониторинга; вести каталог метаданных и lineage; обеспечить контроль доступа и безопасность данных.
6) Какие риски при внедрении CVM-архитектуры следует минимизировать на старте?
Риски: неполнота данных, несогласованные бизнес-термины, задержки в обновлении, сложности миграций схем, нарушения приватности. Меры снижения: единая бизнес-терминология, четко прописанные источники и правила обновления, пилоты и поэтапное масштабирование, внедрение безопасности и регуляторной совместимости.
7) Как измерять успех внедрения CVM через модель данных?
Успех можно оценивать по качеству и полноте данных (напр., процент ошибок в данных), скорости доступа к ключевым KPI (CLV, RFM, churn_probability) в BI-инструментах, числу успешных рекламных кампий с высокой конверсией, и устойчивости аналитики к новым источникам данных.
8) Какие практические шаги можно начать уже сегодня?
Определите набор бизнес-метрик CVM (CLV, RFM, удержание, конверсия), соберите минимальный набор источников данных (CRM, веб-аналитика, транзакции), спроектируйте компактную концептуальную модель и затем перейти к логической. Выберите технологический стек (например, ClickHouse + Spark + Airflow + DataLens), создайте первые Dim-таблицы и Fact-таблицу для тестовой выборки, проведите пилотный расчет CLV и RFM.
9) Какова роль этики и приватности в модели данных CVM?
Этические и правовые аспекты крайне важны: хранение PII требует ограничений доступа и маскирования, соответствия GDPR/локальным законам, определения политики хранения данных и механизма согласия пользователей. Кроме того, следует внедрить приватность по принципу минимизации данных и анонимизацию где возможно.
10) Какие проблемы часто встречаются при переходе на новую модель данных CVM и как их решать?
Проблемы: сопротивление пользователей к новым терминам, отсутствие единого словаря, конфликт семантик. Решение: вовлечение бизнес-пользователей в ранний этап проектирования, создание единого словаря терминов, тесная связь между бизнес-аналитиками и инженерами данных, документирование процессов и обучение пользователей.
Эта глава даёт вам прочную базу для понимания концептуальных, логических и физических аспектов моделирования данных в контексте CVM и BI/DWH-проектов. В дальнейшем мы будем углубляться в конкретные кейсы, примеры реализованных конвейеров и методики оценки эффективности CVM-инициатив на основе собранной архитектуры данных.


