
BI Consult Desktop Logo BI Consult Mobile Logo
  • Russian BI Исследование российских bi
  • Перейти на Fine BI
  • Контакты
  • +7 812 334-08-01
    +7 499 608-13-06
  • Отправить сообщение
  • Главная
  • Продукты Эксперт-BI
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Сельское хозяйство
    • Энергетика
    • FMCG
    • Девелоперы
    • Маркетплейсы
    • Пищевая промышленность
    • Фармацевтика
    • Построение Data Platform
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и FP&A
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • IBP
    • ИТ (CIO)
    • Закупки
  • Платформы
    • Системы бизнес-анализа (BI)
    • Интегрированное бизнес-планирование (IBP)
    • Хранилища данных (DWH / Lakehouse)
    • Каталоги данных (Data Catalog)
    • Системы ETL и ELT
    • AI / Исскуственный интеллект
    • Шина данных (ESB)
    • Система управления мастер-данными (MDM)
    • Семантический слой
  • Услуги
    • Переход на отечественные BI и DWH системы
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений и DWH
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Курсы
    • Учебный курс Информационная грамотность (Data Literacy)
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Greenplum
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt (Data Build Tool)
  • Компания
    • Руководство
    • Новости
    • Клиенты
    • Карьера
    • Скачать
    • Контакты

BI

  • FineBI
  • FineReport
  • FineDataLink
  • FineChatBI (FineAI)
  • Коннекторы данных из 1С в BI
  • Airflow / Nifi
  • Visiology
  • PIX BI
  • Modus BI
  • Yandex.DataLens
  • Open-source BI: Superset/Metabase
  • Luxms BI
  • AW BI + Alpha BI
  • FlyBI + Форсайт. Аналитическая Платформа
  • Loginom
  • Триафлай
  • AI / Исскуственный интеллект
  • Optimacros
  • Навигатор BI
  • Семантический слой

СУБД

  • Arenadata
  • ClickHouse
  • Greenplum
  • Postgres Professional
  • TData

Другое

  • Построение Data Platform
    • Аналитическое хранилище данных
    • Data Lake и Data Engineering
    • Подробнее про Data Lake
    • Внедрение Lakehouse
      • Apache Doris
      • StarRocks
      • Trino
    • Миграция витрин из пропиетарных DWH на новый стек
    • Учебный курс "Современная архитектура хранилища данных"
Главная » Курсы по системам бизнес-анализа и методологии » Учебный курс по MLOps и Data Science (ML, AI) » Руководство по SVM (Support-Vector Machine или Опорно-векторная машина) с использованием Python

Руководство по SVM (Support-Vector Machine или Опорно-векторная машина) с использованием Python

SVM – это очень мощный и гибкий класс контролируемых алгоритмов машинного обучения для задач классификации и регрессии. В этой статье я познакомлю вас с руководством по машинному обучению на SVM с использованием Python.


SVM

В машинном обучении SVM представляют собой набор контролируемых алгоритмов машинного обучения, которые можно использовать как для классификации, так и для регрессии. Они относятся к категории обобщенных линейных классификаторов. Проще говоря, SVM – это алгоритм классификации и регрессии, который обеспечивает большую точность, автоматически избегая переобучения данных.

Большая сила SVM заключается в том, что их обучение очень простое. Не требуется оптимального значения, в отличие от нейронных сетей. Он также очень хорошо подходит для данных с очень большим размером. Теперь, в разделе ниже, я расскажу вам, как реализовать SVM на очень популярном наборе данных «Ирис».


Руководство по SVM с использованием Python

SVM – один из лучших подходов к моделированию данных. Он использует проверку обобщения как метод проверки размерности. Теперь давайте начнем с задачи реализации алгоритма SVM в наборе данных. Я начну с импорта набора данных и библиотек, необходимых для визуализации данных:


 import seaborn as sns
 iris = sns.load_dataset('iris')
 import pandas as pd
 import matplotlib.pyplot as plt
 %matplotlib inline
 set(iris['species'])


Результат:

{'setosa', 'versicolor', 'virginica'}


 iris.head()


Результат:


sepal_length

sepal_width

petal_length

petal_width

species

0

5.1

3.5

1.4

0.2

setosa

1

4.9

3.0

1.4

0.2

setosa

2

4.7

3.2

1.3

0.2

setosa

3

4.6

3.1

1.5

0.2

setosa

4

5.0

3.6

1.4

0.2

setosa


Визуализация данных:

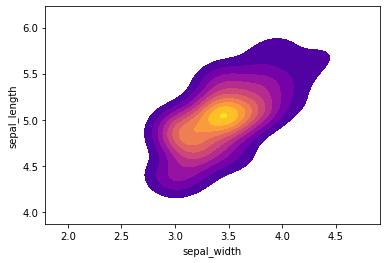
Теперь давайте визуализируем некоторые важные особенности данных, чтобы понять, с чем мы работаем:


sns.pairplot(iris,hue='species',palette='Dark2')


 setosa = iris[iris['species']=='setosa']
 sns.kdeplot( setosa['sepal_width'], setosa['sepal_length'],
 cmap="plasma", shade=True, shade_lowest=False)


Для обучения классификатора SVM я разделю данные на обучающий и тестовый наборы:


 from sklearn.model_selection import train_test_split
 X = iris.drop('species',axis=1)
 y = iris['species']
 X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.30)


Теперь чтобы обучимть модель, я импортирую модель SVC из scikit-learn и просто подгоню данные в модель:


 from sklearn.svm import SVC
 svc_model = SVC()
 svc_model.fit(X_train,y_train)
 predictions = svc_model.predict(X_test)
 from sklearn.metrics import classification_report,confusion_matrix
 print(confusion_matrix(y_test,predictions))


Результат:

 [[16  0  0]

 [ 0 14  0]

 [ 0  2 13]]


 print(classification_report(y_test,predictions))


 Результат:

 precision    recall  f1-score   support
      setosa       1.00      1.00      1.00        16
  versicolor       0.88      1.00      0.93        14
   virginica       1.00      0.87      0.93        15
   accuracy                           0.96        45
   macro avg       0.96      0.96      0.95        45
weighted avg       0.96      0.96      0.96        45


Давайте посмотрим, сможем ли мы настроить гиперметры, чтобы попытаться стать еще лучше, что маловероятно, поскольку вы, вероятно, будете довольны этими результатами, поскольку набор данных довольно мал, но я просто хочу, чтобы вы попрактиковались в использовании GridSearch:


from sklearn.model_selection import GridSearchCV
param_grid = {'C': [0.1,1, 10, 100], 'gamma': [1,0.1,0.01,0.001]}
grid = GridSearchCV(SVC(),param_grid,refit=True,verbose=2)
grid.fit(X_train,y_train)
grid_predictions = grid.predict(X_test)
print(confusion_matrix(y_test,grid_predictions))
print(classification_report(y_test,grid_predictions))


Результат:

 [[16  0  0]

 [ 0 14  0]

 [ 0  0 15]]


 precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        16
  versicolor       1.00      1.00      1.00        14
   virginica       1.00      1.00      1.00        15
    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45


Надеюсь, вам понравилась эта статья с руководством по машинному обучению на опорных векторных машинах


Узнать стоимость решенияЗапросить видео презентацию

← Предыдущая статья
Деревья решений в машинном обучении
Следующая статья →
Понимание нейронной сети


Внедряем AI в бизнес-процессы крупных компаний
От стратегии и инфраструктуры до AI-агентов, интеграций и промышленной эксплуатации.

Подробнее об AI-решениях


Решения

Анализировать ФинансыУвеличивайте ПродажиОптимальный Склад и ЛогистикаМаркетинговые Метрики

Клиенты
  • Розничный и интернет-магазин 12 Storeez один из лидеров на рынке женской одежды. С географией рынка не только на территории России, своя продукция представлена еще и в таких странах как Казахстан и Дубай.

  • ИНВИТРО
    ИНВИТРО – крупнейшая частная медицинская компания в России, специализирующаяся на лабораторной диагностике и оказании других медицинских услуг.
     
    ИНВИТРО располагает 9 самыми современными лабораторными комплексами и крупнейшей в Восточной Европе сетью более чем из 900 медицинских офисов. Страны присутствия — Россия, Украина, Казахстан, Беларусь.
     
  • ПАО «Транснефть» – крупнейшая российская нефтепроводная компания. «Транснефть» обеспечивает транспортировку более 85% добываемых в России нефти и нефтепродуктов.

  • ООО "Интернэшнл Ресторант Брэндс" – это крупнейший франчайзинговый партнер компании Yum! Brands Russia & CIS в России, отвечающий за рост и развитие бренда KFC на территории РФ. На сегодняшний день у компании более 350 ресторанов. Ежедневно в рестораны приходит 200 000+ гостей.

  • Решения
    • Дистрибуция
    • Розничная торговля
    • Производство
    • Операторы связи
    • Страхование
    • Банки
    • Лизинг
    • Логистика
    • Нефтегазовый сектор
    • Медицина
    • Сеть ресторанов
    • E-Commerce
    • Энергетика
    • Фармацевтика
  • Услуги
    • Переход на отечественные BI и DWH
    • Консалтинг
    • Пилотный проект
    • Обучение и сертификация
    • Бесплатное обучение
    • Техническая поддержка
    • Технические задания
    • Сбор требований для проекта внедрения BI-системы
    • CI/CD для DWH
    • Аудит BI приложений
    • Выделенная команда
    • Настойка и поддержка баз данных
    • Разработка BI Стратегии
    • Styleguide для BI-системы
    • Как выбрать BI-систему
  • Платформы
    • FineBI
    • FineReport
    • FineDataLink
    • Коннекторы данных из 1С в BI
    • Airflow + NiFi
    • Visiology
    • Luxms BI
    • Modus BI
    • PIX BI
    • Arenadata
    • ClickHouse
    • Greenplum
    • Postgres Professional
    • Open-source BI: Superset/Metabase
    • Loginom
    • Yandex.DataLens
    • AI / Исскуственный интеллект
    • Optimacros
    • Шины данных
  • Курсы
    • Учебный курс Информационная грамотность
    • Учебный курс для бизнес-аналитиков
    • Учебный курс для системных аналитиков
    • Учебный курс по Data Governance
    • Учебный курс Как стать CDO
    • Учебный курс Современная архитектура хранилища данных
    • Учебный курс по Fine BI
    • Учебный курс по FineReport
    • Учебный курс по DWH
    • Учебный курс по Data Science (ML, AI)
    • Учебный курс по PostgreSQL
    • Учебный курс по Apache Airflow и NiFi
    • Учебный курс по Open-source BI
    • Учебный курс по ClickHouse
    • Учебный курс по DataLens
    • Учебный курс по Loginom
    • Учебный курс по Modus BI и ETL
    • Учебный курс по Visiology
    • Учебный курс по dbt
  • Функциональные решения
    • Создание Data Lake
    • Цифровая трансформация
    • Управление по KPI
    • Финансы
    • Продажи
    • Склад
    • HR
    • Маркетинг
    • Внутренний аудит
    • Категорийный менеджмент
    • S&OP и прогнозная аналитика
    • Геоаналитика
    • Цепочки поставок (SCM)
    • AutoML
    • Process Mining
    • Сквозная аналитика
  • Компания
    • О нас
    • Руководство
    • Новости
    • Клиенты
    • Скачать
    • Контакты
    • Политика конфиденциальности
RutubeVkontakteLinkedInYouTube
ООО "Би Ай Консалт",
ИНН: 7811437757,
ОГРН: 1097847154184
199178, Россия,
Санкт-Петербург,
6-ая линия В.О., Д. 63, 4 этаж
Тел: +7 (812) 334-08-01
Тел: +7 (499) 608-13-06
E-mail: info@biconsult.ru


×

Пользуясь сайтом, вы соглашаетесь с использованием cookies и политикой конфиденциальности.