

Деревья решений в машинном обучении
Деревья решений – это универсальные алгоритмы машинного обучения, которые могут выполнять как задачи классификации и регрессии, так и задачи с несколькими выходами. Это мощные алгоритмы, способные обрабатывать сложные наборы данных.
Деревья решений также являются фундаментальными компонентами случайных лесов, одних из самых мощных алгоритмов машинного обучения, доступных сегодня.
В этой статье я начну с обсуждения того, как тренировать, визуализировать и делать прогнозы с помощью деревьев решений. Затем я рассмотрю алгоритм обучения CART, используемый Scikit-Learn, и расскажу, как упорядочить деревья и использовать их для задач регрессии.
Обучение и визуализация деревьев решений
Чтобы разобраться в деревьях решений, давайте построим их и посмотрим, как они делают прогнозы. Следующий код обучает DecisionTreeClassifier на наборе данных радужной оболочки:
from sklearn.datasets import load_iris
from sklearn.tree import DecisionTreeClassifier
iris = load_iris()
X = iris.data[:, 2:] # petal length and width
y = iris.target

tree_clf = DecisionTreeClassifier(max_depth=2, random_state=42)
tree_clf.fit(X, y)
Результат:
DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=2,
max_features=None, max_leaf_nodes=None,
min_impurity_decrease=0.0, min_impurity_split=None,
min_samples_leaf=1, min_samples_split=2,
min_weight_fraction_leaf=0.0, presort=False, random_state=42,
splitter='best')
Вы можете визуализировать обученное дерево решений, сначала используя метод export_graphviz () для вывода файла определения графа с именем iris_tree.dot:
from graphviz import Source
from sklearn.tree import export_graphviz

export_graphviz(
        tree_clf,
        out_file=os.path.join(IMAGES_PATH, "iris_tree.dot"),
        feature_names=iris.feature_names[2:],
        class_names=iris.target_names,
        rounded=True,
        filled=True
    )

Source.from_file(os.path.join(IMAGES_PATH, "iris_tree.dot"))

Дерево решений Iris
Делаем прогнозы
Давайте посмотрим, как дерево, представленное на рисунке выше, делает прогнозы. Предположим, вы нашли цветок ириса и хотите его классифицировать. Вы начинаете с корневого узла, этот узел спрашивает, меньше ли длина лепестка цветка 2,45 см. Если это так, вы переходите к левому дочернему узлу корня. В данном случае это листовой узел, поэтому он не задает никаких вопросов, а дерево решений предсказывает, что ваш цветок является Ирис сетоса.
Теперь предположим, что вы нашли другой цветок, и на этот раз длина лепестка больше 2,45 см. Вы должны перейти вниз к правому дочернему узлу корня, который не является листовым узлом, поэтому узел задаст другой вопрос: ширина лепестка меньше 1,75 см? Если это так, то ваш цветок – Ирис разноцветный. Если нет, то, скорее всего, это Ирис виргинский. Это действительно просто.
Одним из многих качеств деревьев решений является то, что они не требуют подготовки данных. Фактически, они вообще не требуют масштабирования или центрирования элементов.
from matplotlib.colors import ListedColormap

def plot_decision_boundary(clf, X, y, axes=[0, 7.5, 0, 3], iris=True, legend=False, plot_training=True):
    x1s = np.linspace(axes[0], axes[1], 100)
    x2s = np.linspace(axes[2], axes[3], 100)
    x1, x2 = np.meshgrid(x1s, x2s)
    X_new = np.c_[x1.ravel(), x2.ravel()]
    y_pred = clf.predict(X_new).reshape(x1.shape)
    custom_cmap = ListedColormap(['#fafab0','#9898ff','#a0faa0'])
    plt.contourf(x1, x2, y_pred, alpha=0.3, cmap=custom_cmap)
    if not iris:
        custom_cmap2 = ListedColormap(['#7d7d58','#4c4c7f','#507d50'])
        plt.contour(x1, x2, y_pred, cmap=custom_cmap2, alpha=0.8)
    if plot_training:
        plt.plot(X[:, 0][y==0], X[:, 1][y==0], "yo", label="Iris setosa")
        plt.plot(X[:, 0][y==1], X[:, 1][y==1], "bs", label="Iris versicolor")
        plt.plot(X[:, 0][y==2], X[:, 1][y==2], "g^", label="Iris virginica")
        plt.axis(axes)
    if iris:
        plt.xlabel("Petal length", fontsize=14)
        plt.ylabel("Petal width", fontsize=14)
    else:
        plt.xlabel(r"$x_1$", fontsize=18)
        plt.ylabel(r"$x_2$", fontsize=18, rotation=0)
    if legend:
        plt.legend(loc="lower right", fontsize=14)
plt.figure(figsize=(8, 4))
plot_decision_boundary(tree_clf, X, y)
plt.plot([2.45, 2.45], [0, 3], "k-", linewidth=2)
plt.plot([2.45, 7.5], [1.75, 1.75], "k--", linewidth=2)
plt.plot([4.95, 4.95], [0, 1.75], "k:", linewidth=2)
plt.plot([4.85, 4.85], [1.75, 3], "k:", linewidth=2)
plt.text(1.40, 1.0, "Depth=0", fontsize=15)
plt.text(3.2, 1.80, "Depth=1", fontsize=13)
plt.text(4.05, 0.5, "(Depth=2)", fontsize=11)

save_fig("decision_tree_decision_boundaries_plot")

plt.show()

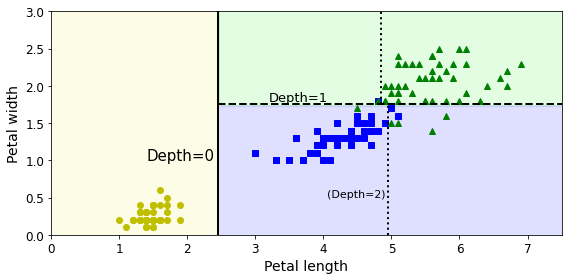
На приведенном выше рисунке показаны границы решений Дерева решений. Толстая вертикальная линия представляет границу решения корневого узла: длина лепестка = 2,45 см. Поскольку левая область чистая, ее нельзя разбивать дальше.
Однако правая область загрязнена, поэтому правый узел глубины 1 разделяет ее на ширину лепестка = 1,75 см. Поскольку max_depth был установлен в 2, дерево решений останавливается прямо здесь. Если вы установите max_depth в = 3, то каждый из двух узлов глубины 2 добавит еще одну границу решения.
Оценка вероятностей классов
Деревья решений также могут оценивать вероятность того, что экземпляр принадлежит определенному классу k. Сначала он просматривает дерево, чтобы найти листовой узел для этого экземпляра, а затем возвращает соотношение обучающих экземпляров класса k в этом узле.
Например, предположим, что вы нашли цветок, лепестки которого имеют длину 5 см и ширину 1,5 см. Соответствующий листовой узел – это левый узел с глубиной 2, поэтому деревья решений должны вывести следующие вероятности: 0% для Ириса сетоса, 90,7% для Ириса разноцветного и 9,3% для Ириса виргинского.
И если вы попросите его предсказать класс, он должен вывести Ирис разноцветный (класс 1), потому что тот имеет самую высокую вероятность. Давайте проверим это:
tree_clf.predict_proba([[5, 1.5]])
Результат:
array([[0. , 0.90740741, 0.09259259]])
tree_clf.predict([[5, 1.5]])
Результат:
array([1])
Идеально! Обратите внимание, что предполагаемые вероятности были бы идентичны где-нибудь еще в правом нижнем прямоугольнике рисунка ниже, например, если бы лепестки были 6 см в длину и 1,5 см в ширину.
Нестабильность
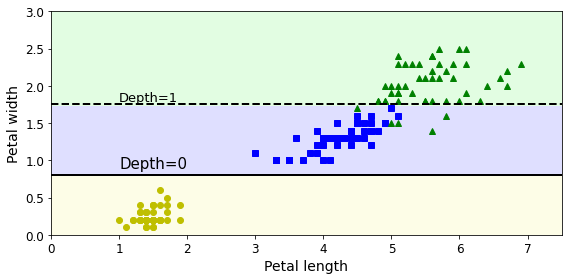
Надеюсь, к настоящему времени вы убедились, что деревья решений имеют много преимуществ: они просты для понимания и интерпретации, просты в использовании, универсальны и мощны. Однако у них есть несколько ограничений. Во-первых, как вы могли заметить, деревьям решений нравятся ортогональные границы решений, которые делают их чувствительными к ротации обучающих наборов. Давайте посмотрим на эту ситуацию:
X[(X[:, 1]==X[:, 1][y==1].max()) & (y==1)] # widest Iris versicolor flower
Результат:
array([[4.8, 1.8]])
not_widest_versicolor = (X[:, 1]!=1.8) | (y==2)
X_tweaked = X[not_widest_versicolor]
y_tweaked = y[not_widest_versicolor]

tree_clf_tweaked = DecisionTreeClassifier(max_depth=2, random_state=40)
tree_clf_tweaked.fit(X_tweaked, y_tweaked)
Результат:
DecisionTreeClassifier(ccp_alpha=0.0, class_weight=None, criterion='gini', max_depth=2, max_features=None, max_leaf_nodes=None, min_impurity_decrease=0.0, min_impurity_split=None, min_samples_leaf=1, min_samples_split=2, min_weight_fraction_leaf=0.0, presort='deprecated', random_state=40, splitter='best')
plt.figure(figsize=(8, 4))
plot_decision_boundary(tree_clf_tweaked, X_tweaked, y_tweaked, legend=False)
plt.plot([0, 7.5], [0.8, 0.8], "k-", linewidth=2)
plt.plot([0, 7.5], [1.75, 1.75], "k--", linewidth=2)
plt.text(1.0, 0.9, "Depth=0", fontsize=15)
plt.text(1.0, 1.80, "Depth=1", fontsize=13)

save_fig("decision_tree_instability_plot")
plt.show()
Чувствительность к деталям тренировочного набора
from sklearn.datasets import make_moons
Xm, ym = make_moons(n_samples=100, noise=0.25, random_state=53)

deep_tree_clf1 = DecisionTreeClassifier(random_state=42)
deep_tree_clf2 = DecisionTreeClassifier(min_samples_leaf=4, random_state=42)
deep_tree_clf1.fit(Xm, ym)
deep_tree_clf2.fit(Xm, ym)

fig, axes = plt.subplots(ncols=2, figsize=(10, 4), sharey=True)
plt.sca(axes[0])
plot_decision_boundary(deep_tree_clf1, Xm, ym, axes=[-1.5, 2.4, -1, 1.5], iris=False)
plt.title("No restrictions", fontsize=16)
plt.sca(axes[1])
plot_decision_boundary(deep_tree_clf2, Xm, ym, axes=[-1.5, 2.4, -1, 1.5], iris=False)
plt.title("min_samples_leaf = {}".format(deep_tree_clf2.min_samples_leaf), fontsize=14)
plt.ylabel("")

save_fig("min_samples_leaf_plot")
plt.show()
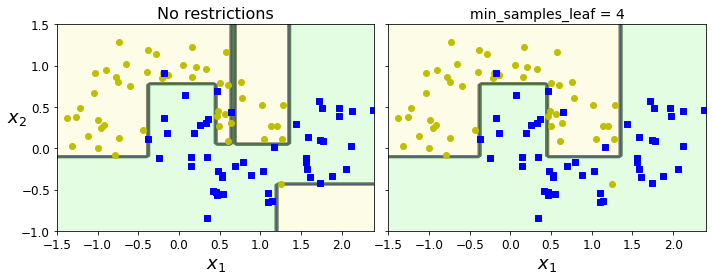
На приведенном выше рисунке показаны два дерева принятия решений, обученные на наборе данных о лунах. Слева дерево решений обучается с гиперпараметрами по умолчанию, а справа оно обучается с min_samples_leaf = 4. Совершенно очевидно, что модель слева обучается чрезмерно, а модель справа, вероятно, будет лучше обобщать.
np.random.seed(6)
Xs = np.random.rand(100, 2) - 0.5
ys = (Xs[:, 0] > 0).astype(np.float32) * 2

angle = np.pi / 4
rotation_matrix = np.array([[np.cos(angle), -np.sin(angle)], [np.sin(angle), np.cos(angle)]])
Xsr = Xs.dot(rotation_matrix)

tree_clf_s = DecisionTreeClassifier(random_state=42)
tree_clf_s.fit(Xs, ys)
tree_clf_sr = DecisionTreeClassifier(random_state=42)
tree_clf_sr.fit(Xsr, ys)

fig, axes = plt.subplots(ncols=2, figsize=(10, 4), sharey=True)
plt.sca(axes[0])
plot_decision_boundary(tree_clf_s, Xs, ys, axes=[-0.7, 0.7, -0.7, 0.7], iris=False)
plt.sca(axes[1])
plot_decision_boundary(tree_clf_sr, Xsr, ys, axes=[-0.7, 0.7, -0.7, 0.7], iris=False)
plt.ylabel("")

save_fig("sensitivity_to_rotation_plot")
plt.show()
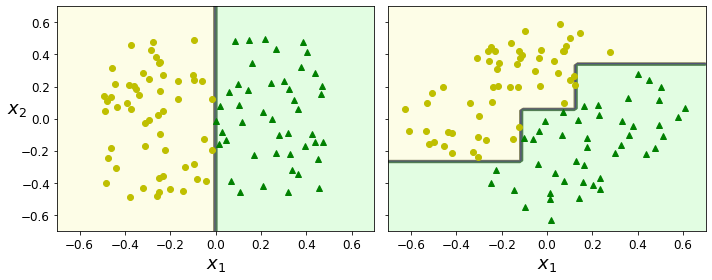
На приведенном выше рисунке показан простой линейно разделяемый набор данных: слева дерево решений легко разделяет его, а справа – после поворота набора данных на 45 градусов граница решения выглядит излишне запутанной. Хотя оба дерева решений идеально подходят для обучающей выборки. Очень вероятно, что правая модель не будет хорошо обобщать.
Регрессия: деревья решений
Деревья решений также могут выполнять задачи регрессии. Давайте построим дерево регрессии, используя класс DecisionTreeRegressor из Scikit-Learn, обучая его на зашумленном квадратическом наборе данных с max_depth = 2:
# Quadratic training set + noise
np.random.seed(42)
m = 200
X = np.random.rand(m, 1)
y = 4 * (X - 0.5) ** 2
y = y + np.random.randn(m, 1) / 10
from sklearn.tree import DecisionTreeRegressor

tree_reg = DecisionTreeRegressor(max_depth=2, random_state=42)
tree_reg.fit(X, y)
Результат:
DecisionTreeRegressor(ccp_alpha=0.0, criterion='mse', max_depth=2, max_features=None, max_leaf_nodes=None, min_impurity_decrease=0.0, min_impurity_split=None, min_samples_leaf=1, min_samples_split=2, min_weight_fraction_leaf=0.0, presort='deprecated', random_state=42, splitter='best')
from sklearn.tree import DecisionTreeRegressor

tree_reg1 = DecisionTreeRegressor(random_state=42, max_depth=2)
tree_reg2 = DecisionTreeRegressor(random_state=42, max_depth=3)
tree_reg1.fit(X, y)
tree_reg2.fit(X, y)

def plot_regression_predictions(tree_reg, X, y, axes=[0, 1, -0.2, 1], ylabel="$y$"):
    x1 = np.linspace(axes[0], axes[1], 500).reshape(-1, 1)
    y_pred = tree_reg.predict(x1)
    plt.axis(axes)
    plt.xlabel("$x_1$", fontsize=18)
    if ylabel:
        plt.ylabel(ylabel, fontsize=18, rotation=0)
    plt.plot(X, y, "b.")
    plt.plot(x1, y_pred, "r.-", linewidth=2, label=r"$\hat{y}$")

fig, axes = plt.subplots(ncols=2, figsize=(10, 4), sharey=True)
plt.sca(axes[0])
plot_regression_predictions(tree_reg1, X, y)
for split, style in ((0.1973, "k-"), (0.0917, "k--"), (0.7718, "k--")):
    plt.plot([split, split], [-0.2, 1], style, linewidth=2)
plt.text(0.21, 0.65, "Depth=0", fontsize=15)
plt.text(0.01, 0.2, "Depth=1", fontsize=13)
plt.text(0.65, 0.8, "Depth=1", fontsize=13)
plt.legend(loc="upper center", fontsize=18)
plt.title("max_depth=2", fontsize=14)

plt.sca(axes[1])
plot_regression_predictions(tree_reg2, X, y, ylabel=None)
for split, style in ((0.1973, "k-"), (0.0917, "k--"), (0.7718, "k--")):
    plt.plot([split, split], [-0.2, 1], style, linewidth=2)
for split in (0.0458, 0.1298, 0.2873, 0.9040):
    plt.plot([split, split], [-0.2, 1], "k:", linewidth=1)
plt.text(0.3, 0.5, "Depth=2", fontsize=13)
plt.title("max_depth=3", fontsize=14)

save_fig("tree_regression_plot")
plt.show()
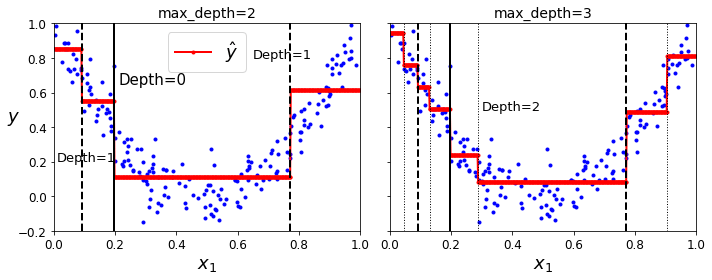
Прогнозирование регрессионной модели двух деревьев решений. Теперь давайте посмотрим на получившееся дерево, используя дерево решений для регрессии:
export_graphviz(
        tree_reg1,
        out_file=os.path.join(IMAGES_PATH, "regression_tree.dot"),
        feature_names=["x1"],
        rounded=True,
        filled=True
    )
Source.from_file(os.path.join(IMAGES_PATH, "regression_tree.dot"))

Дерево решений для регрессии
Это дерево очень похоже на модель классификации, которую мы построили ранее. Основное отличие состоит в том, что вместо предсказания класса в каждом узле он предсказывает значение.
Регуляризация регрессора дерева решений
Как и задачи классификации, деревья решений склонны к переобучению при работе с задачами регрессии. Давайте взглянем на это:
tree_reg1 = DecisionTreeRegressor(random_state=42)
tree_reg2 = DecisionTreeRegressor(random_state=42, min_samples_leaf=10)
tree_reg1.fit(X, y)
tree_reg2.fit(X, y)

x1 = np.linspace(0, 1, 500).reshape(-1, 1)
y_pred1 = tree_reg1.predict(x1)
y_pred2 = tree_reg2.predict(x1)

fig, axes = plt.subplots(ncols=2, figsize=(10, 4), sharey=True)

plt.sca(axes[0])
plt.plot(X, y, "b.")
plt.plot(x1, y_pred1, "r.-", linewidth=2, label=r"$\hat{y}$")
plt.axis([0, 1, -0.2, 1.1])
plt.xlabel("$x_1$", fontsize=18)
plt.ylabel("$y$", fontsize=18, rotation=0)
plt.legend(loc="upper center", fontsize=18)
plt.title("No restrictions", fontsize=14)

plt.sca(axes[1])
plt.plot(X, y, "b.")
plt.plot(x1, y_pred2, "r.-", linewidth=2, label=r"$\hat{y}$")
plt.axis([0, 1, -0.2, 1.1])
plt.xlabel("$x_1$", fontsize=18)
plt.title("min_samples_leaf={}".format(tree_reg2.min_samples_leaf), fontsize=14)

save_fig("tree_regression_regularization_plot")
plt.show()

Регуляризация регрессора дерева решений
Очевидно, что эти прогнозы плохо соответствуют обучающей выборке. Надеюсь, вам понравилась эта статья о деревьях решений в машинном обучении. Я рассмотрел задачи классификации и регрессии в деревьях решений со всеми их недостатками.


