

Многообразное обучение
Поворот, переориентация или растяжение листа в трехмерном пространстве не меняют плоскую геометрию статьи: такие операции сродни линейным вложениям. Если вы согнете, скрутите или скомкаете бумагу, она останется двумерным многообразием, но вложение в трехмерное пространство больше не будет линейным. Алгоритмы обучения многообразию будут стремиться узнать о фундаментальной двумерной природе бумаги, даже если она будет искажена, чтобы заполнить трехмерное пространство.
Здесь я продемонстрирую несколько различных методов, глубоко погрузившись в парочку техник: многомерное масштабирование (MDS), локально линейное вложение (LLE) и изометрическое отображение (IsoMap).
Начну со стандартного импорта:
import matplotlib.pyplot as plt
import seaborn as sns; sns.set()
import numpy as np
Многостороннее обучение: «HELLO»
Чтобы прояснить эти концепции, давайте начнем с создания некоторых двумерных данных, которые мы можем использовать для определения многообразия. Вот функция, которая будет создавать данные в форме слова «HELLO»:
def make_hello(N=1000, rseed=42):
    # Make a plot with "HELLO" text; save as PNG
    fig, ax = plt.subplots(figsize=(4, 1))
    fig.subplots_adjust(left=0, right=1, bottom=0, top=1)
    ax.axis('off')
    ax.text(0.5, 0.4, 'HELLO', va='center', ha='center', weight='bold', size=85)
    fig.savefig('hello.png')
    plt.close(fig)

    # Open this PNG and draw random points from it
    from matplotlib.image import imread
    data = imread('hello.png')[::-1, :, 0].T
    rng = np.random.RandomState(rseed)
    X = rng.rand(4 * N, 2)
    i, j = (X * data.shape).astype(int).T
    mask = (data[i, j] < 1)
    X = X[mask]
    X[:, 0] *= (data.shape[0] / data.shape[1])
    X = X[:N]
    return X[np.argsort(X[:, 0])]
Вызовем функцию и визуализируем полученные данные:
X = make_hello(1000)
colorize = dict(c=X[:, 0], cmap=plt.cm.get_cmap('rainbow', 5))
plt.scatter(X[:, 0], X[:, 1], **colorize)
plt.axis('equal')
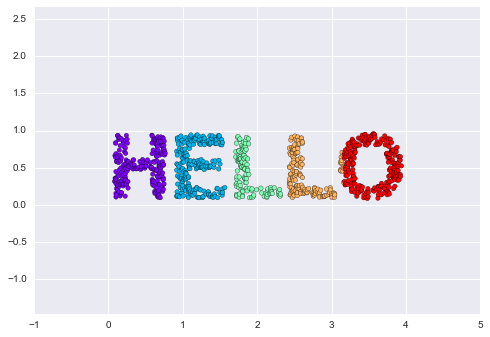
Результат является двухмерным и состоит из точек, нарисованных в форме слова «HELLO». Эта форма данных поможет нам визуально увидеть, что делают эти алгоритмы.
Также прочтите – PCA в машинном обучении
Многомерное масштабирование (MDS)
Взглянув на такие данные, мы увидим, что конкретный выбор значений x и y для набора данных не является самым фундаментальным описанием данных: мы можем масштабировать, сжимать или вращать данные, и «HELLO» все равно будет очевидным.
Например, если мы используем матрицу вращения для переключения данных, значения x и y изменятся, но данные остаются в основном теми же:
def rotate(X, angle):
    theta = np.deg2rad(angle)
    R = [[np.cos(theta), np.sin(theta)],
         [-np.sin(theta), np.cos(theta)]]
    return np.dot(X, R)

X2 = rotate(X, 20) + 5
plt.scatter(X2[:, 0], X2[:, 1], **colorize)
plt.axis('equal')
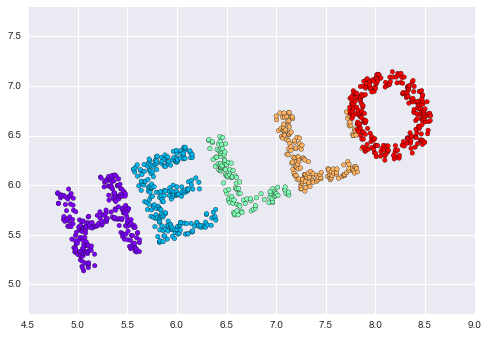
Это говорит нам о том, что значения x и y не обязательно являются основными для отношений данных. В данном случае принципиальным является расстояние между каждой точкой и другими точками в наборе данных. Распространенный способ представить эту картину – использовать матрицу расстояний: для $N$ точек мы создаем массив N \times N, такой, что запись (i, j) содержит расстояние между точкой i и точкой j.
Давайте воспользуемся эффективной функцией pairwise_distances из Scikit-Learn, чтобы сделать это для наших исходных данных:
from sklearn.metrics import pairwise_distances
D = pairwise_distances(X)
D.shape
Результат:
(1000, 1000)
Как и было обещано, для наших N=1000 точек мы получаем матрицу 1000×1000, которую можно визуализировать, как показано здесь:
plt.imshow(D, zorder=2, cmap='Blues', interpolation='nearest')
plt.colorbar()
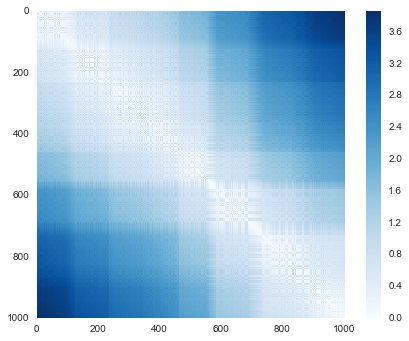
Эта матрица расстояний дает нам представление наших данных, инвариантное для поворотов и перемещений, но визуализация приведенной выше матрицы не совсем интуитивно понятна. На изображении, показанном на этом рисунке, мы потеряли все видимые признаки впечатляющей структуры данных «HELLO», который мы видели раньше.
Кроме того, хотя вычисление этой матрицы расстояний из координат (x, y) будет несложным, преобразование расстояний обратно в координаты x и y уже заметно сложнее. Именно на это и направлен алгоритм многомерного масштабирования: по заданной матрице расстояний между точками он восстанавливает $D$-мерное координатное представление данных.
Давайте посмотрим, как это работает для нашей матрицы расстояний, используя предварительно вычисленное несходство, чтобы указать, что мы передаем матрицу расстояний:
from sklearn.manifold import MDS
model = MDS(n_components=2, dissimilarity='precomputed', random_state=1)
out = model.fit_transform(D)
plt.scatter(out[:, 0], out[:, 1], **colorize)
plt.axis('equal')
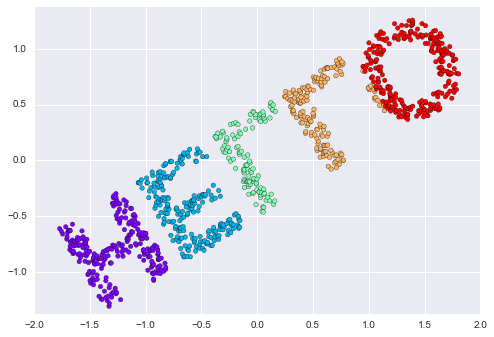
Алгоритм MDS восстанавливает одно из возможных двумерных координатных представлений наших данных, используя только матрицу расстояний N\times N, описывающую взаимосвязь между точками данных.
MDS как многообразное обучение
Полезность этой функции становится более очевидной, если мы рассмотрим тот факт, что матрицы расстояний могут вычисляться из данных в любом измерении. Так, например, вместо того, чтобы просто вращать данные в двухмерной плоскости, мы можем спроецировать их в трех измерениях, используя следующую функцию:
def random_projection(X, dimension=3, rseed=42):
    assert dimension >= X.shape[1]
    rng = np.random.RandomState(rseed)
    C = rng.randn(dimension, dimension)
    e, V = np.linalg.eigh(np.dot(C, C.T))
    return np.dot(X, V[:X.shape[1]])

X3 = random_projection(X, 3)
X3.shape
Результат:
(1000, 3)
Давайте визуализируем эти моменты, чтобы увидеть, с чем мы имеем дело:
from mpl_toolkits import mplot3d
ax = plt.axes(projection='3d')
ax.scatter3D(X3[:, 0], X3[:, 1], X3[:, 2],
             **colorize)
ax.view_init(azim=70, elev=50)
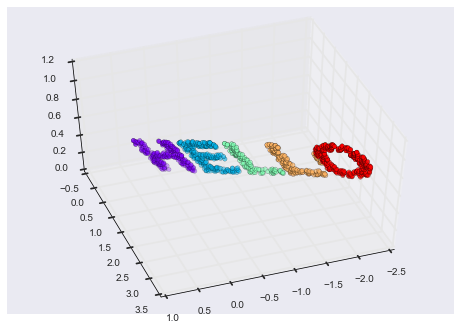
Теперь мы можем попросить оценщик MDS ввести эти трехмерные данные, вычислить матрицу расстояний и затем определить оптимальное двумерное вложение для этой матрицы расстояний. Результат восстанавливает представление исходных данных:
model = MDS(n_components=2, random_state=1)
out3 = model.fit_transform(X3)
plt.scatter(out3[:, 0], out3[:, 1], **colorize)
plt.axis('equal')
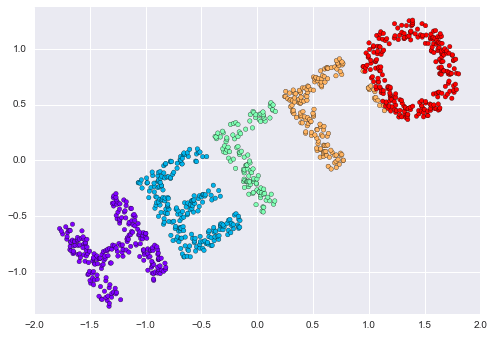
По сути, это – цель многостороннего обучающего оценщика: учитывая многомерные встроенные данные, он ищет низкоразмерное представление данных, которое сохраняет индивидуальные отношения в данных. В случае MDS защищаемое количество – это расстояние между каждой парой точек.
Пример изучения многообразия: изокарта на гранях
Многообразное обучение часто используется для одной задачи – для понимания взаимосвязи между многомерными точками данных. Типичным случаем данных большой размерности являются изображения: например, набор изображений по 1000 пикселей каждое можно рассматривать как набор точек в 1000 измерений – яркость каждого пикселя в каждом изображении определяет координату в этом измерении.
Давайте применим Isomap к некоторым данным лиц. Я буду использовать набор данных Labeled Faces in the Wild, предоставленный scikit-learn.
from sklearn.datasets import fetch_lfw_people
faces = fetch_lfw_people(min_faces_per_person=30)
faces.data.shape
Результат:
(2370, 2914)
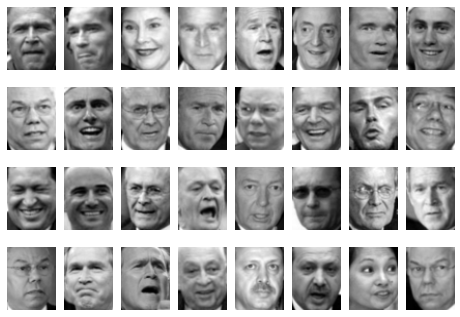
У нас есть 2370 изображений, по 2914 пикселей каждое. Другими словами, изображения можно рассматривать как точки данных в 2914-мерном пространстве.
Давайте быстро визуализируем несколько из этих изображений, чтобы увидеть, с чем мы работаем:
fig, ax = plt.subplots(4, 8, subplot_kw=dict(xticks=[], yticks=[]))
for i, axi in enumerate(ax.flat):
    axi.imshow(faces.images[i], cmap='gray')
Я хотел бы построить низкоразмерное вложение 2914-мерных данных, чтобы выявить фундаментальные отношения между изображениями. Один из полезных способов начать эту работу – вычислить PCA и изучить объясненный коэффициент дисперсии, который даст нам представление о том, сколько линейных функций требуется для описания данных:
from sklearn.decomposition import RandomizedPCA
model = RandomizedPCA(100).fit(faces.data)
plt.plot(np.cumsum(model.explained_variance_ratio_))
plt.xlabel('n components')
plt.ylabel('cumulative variance')
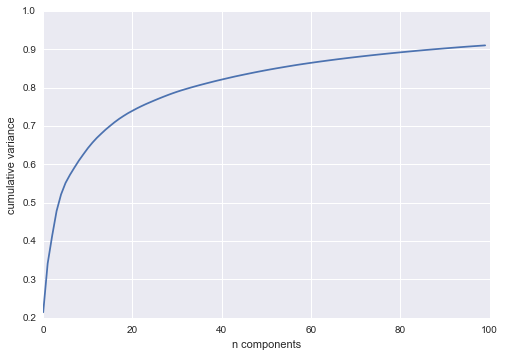
Мы видим, что для того чтобы сохранить 90% дисперсии в этих данных требуется около 100 компонентов, это говорит нам о том, что данные по своей природе очень многомерны – их нельзя описать линейно с помощью всего лишь несколькими компонентами.
В этом случае могут быть полезны вложения нелинейных многообразий, такие как LLE и Isomap. Мы можем вычислить вложение Isomap на этих гранях, используя тот же шаблон, который был показан ранее:
from sklearn.manifold import Isomap
model = Isomap(n_components=2)
proj = model.fit_transform(faces.data)
proj.shape
Результат:
(2370, 2)
Результатом является двухмерная проекция всех входных изображений. Чтобы лучше понять, что говорит нам прогноз, давайте определим функцию, которая будет выводить эскизы изображений в местах расположения проекций:
from matplotlib import offsetbox

def plot_components(data, model, images=None, ax=None,
                    thumb_frac=0.05, cmap='gray'):
    ax = ax or plt.gca()

    proj = model.fit_transform(data)
    ax.plot(proj[:, 0], proj[:, 1], '.k')

    if images is not None:
        min_dist_2 = (thumb_frac * max(proj.max(0) - proj.min(0))) ** 2
        shown_images = np.array([2 * proj.max(0)])
        for i in range(data.shape[0]):
            dist = np.sum((proj[i] - shown_images) ** 2, 1)
            if np.min(dist) < min_dist_2:
                # don't show points that are too close
                continue
            shown_images = np.vstack([shown_images, proj[i]])
            imagebox = offsetbox.AnnotationBbox(
                offsetbox.OffsetImage(images[i], cmap=cmap),
                                      proj[i])
            ax.add_artist(imagebox)
Вызывая эту функцию сейчас, мы увидим результат:
fig, ax = plt.subplots(figsize=(10, 10))
plot_components(faces.data,
                model=Isomap(n_components=2),
                images=faces.images[:, ::2, ::2])
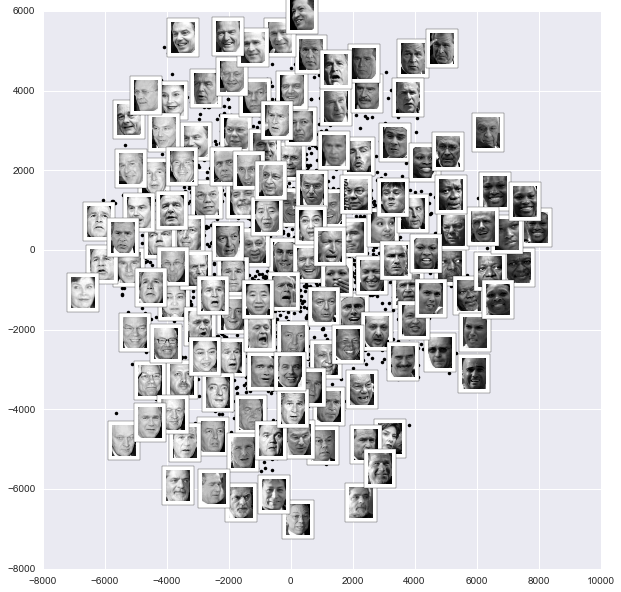
Результат впечатляет: первые два измерения Isomap, кажется, описывают общие характеристики изображения: общую темноту или яркость изображения слева направо и общую ориентацию лица снизу вверх. Это дает нам отличное визуальное представление о некоторых фундаментальных характеристиках наших данных.
Надеюсь, вам понравилась эта статья о многообразном обучении в машинном обучении.


