

Надёжность и Disaster Recovery: копии, аварийные сценарии, резервное копирование
Аннотация к главе: в рамках курса «StarRocks для аналитического машинного обучения: от витрин к ML-фичам» рассмотрены принципы построения устойчивой архитектуры на базе StarRocks, методы резервного копирования и восстановления, а также сценарии аварий и тестирования готовности к ним. Особое внимание уделено сохранению целостности витрин данных и воспроизводимости ML-фич в условиях отказов инфраструктуры и региональных сбоев.
В современном аналитическом контексте многокластерные и многорегиональные развёртывания StarRocks становятся критически важными для обеспечения непрерывности бизнес-аналитики и воспроизводимости экспериментов в ML. Эффективный Disaster Recovery (DR) требует согласованной стратегии: с одной стороны - защиты данных и метаданных, с другой - своевременного восстановления сервисов и минимизации простоя. В этой главе приводятся архитектурные принципы, процедуры резервного копирования, сценарии аварий, а также практики верификации резервов и организационные аспекты внедрения DR-практик в реальных продуктивных средах.
- В центре внимания находится не только копирование больших таблиц и витрин, но и сохранение детерминированности и воспроизводимости ML‑фич, включая связанные метаданные и lineage.
- Рассматриваются практические рекомендации по интеграции DR-процессов с пайплайнами данных и инструментами оркестрации, с учётом требований к RPO и RTO для аналитических нагрузок.
Краткое содержание главы
- Архитектура и принципы копирования в StarRocks: данные, метаданные и их консистентность.
- Дизайн резервного копирования: типы бэкапов, хранение, безопасность и верификация.
- Аварийные сценарии и процедуры восстановления: план-граббы, автоматизация и тестирование.
- Интеграции, операционные практики и выход на продакшен: оркестрация, контроль версий и аудит.
Архитектура копирования и устойчивости StarRocks
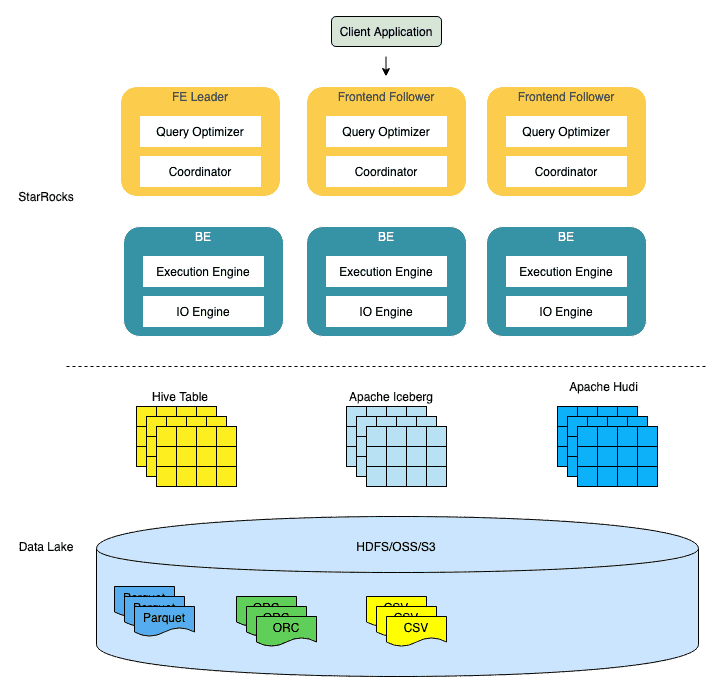
В основе надёжности лежит четкая граница между слоями архитектуры StarRocks: управляющий слой Fe (Frontend) и вычислительный слой Be (Backend). Для устойчивости в DR контексте критично сохранить и синхронность метаданных, и физические данные, а также обеспечить возможность быстрого восстановления до согласованного состояния. Ключевые концепции включают:
- Консистентный снимок состояния: для восстановления требуется единая точка времени, в которой и данные, и метаданные соответствуют друг другу. Это особенно важно для ML‑фич: повторное построение признаков должно давать идентичные результаты при повторных запусках и тестах.
- Разграничение сохранности данных и метаданных: данные чаще копируются в хранилища объектов, а метаданные - в управляемые резервные копии и журналы изменений. Такой подход снижает риск рассинхронов между структурой витрин и самим набором данных.
- Многоуровневая устойчивость: поддержка как локальных резервных копий внутри кластера, так и удалённых копий в географически распределённых хранилищах, обеспечивая защиту от локальных сбоев и стихийных бедствий.
- Гарантии целостности и аутентичности: проверка контрольных сумм, хешей и цепочек изменений (lineage) для предотвращения несанкционированного или неполного восстановления.
Что это значит на практике? Архитектура DR должна обеспечивать: возможность быстрой фиксации глобального состояния кластера в заданный момент времени, экспорт копий в надёжное хранилище, а затем безопасное восстановление на идентичном уровне функциональности иPerf‑потребления. Для ML‑практик критично не просто вернуть данные, но и сохранить совместимость витрин, версионирование и воспроизводимость экспериментов.
Типы копий и консистентность
- Полные и: создаются для базового набора витрин и всех связанных таблиц, включая метаданные, схемы и показатели распределения, чтобы обеспечить восстановление в исходном виде без предпосылок.
- Инкрементальные копии: фиксируют только изменения после последнего полного или инкрементального бэкапа, снижая объём переносимых данных иTIME-накладные расходы.
- Снимки витрин и зависимостей: отдельные копии, которые отражают состояние конкретной витрины данных и связанного набора ML‑фич, включая схемы и схемы lineage, что упрощает точечное восстановление для отдельных проектов или экспериментов.
- Метаданные и журналы изменений: хранение цепочек транзакций и изменений схем дает возможность вернуть систему к определённой точке времени, что особенно важно для воспроизводимости и audit trail.
Хранение копий: выбор хранилища и требования к безопасности
- Объектные хранилища: S3‑совместимые сервисы, MinIO, локальные кластеры HDFS - выбор зависит от доступности, стоимости и политики соответствия. В любом случае критично обеспечить версионирование объектов, шифрование на покое и в передаче, а также контроль доступа через IAM‑профили.
- Логически разделённые копии: отделение копий витрин и ML‑фич от рабочих данных снижает риск влияния резервного копирования на производственный режим и упрощает восстановление конкретных элементов пайплайна.
- Эндпойнты и протоколы: для передачи копий применяются безопасные протоколы, поддерживается параллельная загрузка, а также параллельное чтение для ускорения процесса восстановления в больших кластерах.
Верификация резервов
- Регулярные проверки: тестовые восстановления на тестовом кластере подтверждают целостность бэкапов и пригодность их для продакшна.
- Контрольные тесты: сценарии PITR, rollback до конкретной точки времени, верификация консистентности витрин и связей с ML‑фичами.
- Аудит и соответствие: хранение журнала операций по backup/restore, чтобы обеспечить traceability и соответствие регуляторным требованиям.
Аварийные сценарии и планы восстановления
DR‑практика строится на детализированном списке сценариев и заранее подготовленных runbooks. Ниже представлены ключевые случаи и подходы к их разрешению.
Отказ узла Be и перегрузка кластера
При выходе из строя отдельного BE‑узла система должна продолжать работу за счёт перераспределения задач и восстановления из копий. Восстановление включает:
- Диагностику причин отказа и изоляцию узла, чтобы предотвратить распространение проблемы.
- Перераспределение данных и переразбиение нагрузки между оставшимися Be‑узлами, с сохранением целостности транзакций и витрин.
- Восстановление недостающих локальных данных из резервной копии, а затем синхронизацию с остальной частью кластера.
Важно обеспечить минимальные простои для аналитических запросов и непрерывность экспорта ML‑фич в витрины, даже во время аварии. В продуманной архитектуре DR эти процессы автоматизируются и сопровождаются мониторингом.
Отказ Frontend (Fe) и управление метаданными
Fe‑узлы отвечают за планирование, маршрутизацию и обслуживание метаданных. Их выход из строя может парализовать управление кластером. Решения включают:
- Репликацию управляющих данных и журналов изменений на отдельном наборе Fe‑узлов в режиме hot‑standby.
- Быстрое переключение на резервный Fe без потери согласованности, при этом данные продолжают обслуживаться через существующие Be‑узла.
- Восстановление метаданных из резервной копии и повторную синхронизацию с Be‑слоем без нарушения консистентности витрин и зависимостей ML‑фич.
Региональные сбои и DR между кластерами
Для критически важных сценариев применяются географически распределённые DR. Основные принципы:
- Асинхронная репликация критических объектов: витрины с данными и связанные метаданные реплицируются в ближайший доступный регион.
- Тиражирование ML‑фич и конфигураций окружения: сохранение конфигураций пайплайнов, версий моделей и зависимостей в DR‑кластере для повторной сборки окружения.
- План восстановления: последовательность развёртывания DR‑кластера, восстановление метаданных, загрузка резервов и запуск ключевых сервисов поэтапно, с тестированием консистентности.
Коррупция данных и PITR
В случае внеплановой мутации данных или ошибок загрузки критично иметь точку восстановления. Стратегия должна охватывать:
- Очистку и валидность исходных данных перед применением резервных копий.
- Использование PITR-подхода: возврат к конкретной временной отметке и повторная генерация ML‑фич на основе консистентного набора витрин.
- Верификацию на тестовом стенде: развёртывание на стенде с восстановлением данных и повторной сборкой признаков.
Безопасность и устойчивость резервов
- Шифрование: резервные копии должны быть зашифрованы как в покое, так и в передаче.
- Управление доступом: минимальные привилегии для операций backup/restore и чёткая сегрегация ролей.
- Защита от отказов поставщиков: многократные копии в разных хранилищах, тесты на целостность и доступность.
Резервное копирование: стратегии, расписания и верификация
Стратегия копирования
- Гибридный подход: сочетание полных бэкапов и инкрементальных копий, чтобы минимизировать задержки и суммарные объёмы переносимых данных.
- Время и частота: регулярные полные бэкапы раз в заданное окно (например, еженедельно) и инкрементальные копии - чаще (ежедневно или по завершении важных операций загрузки данных).
- Вызовы для ML‑витрин: копии должны охватывать не только данные, но и схемы, метаданные, lineage и зависимости фиче‑pipeline.
Хранение и доступ
- Хранилища: выбор зависит от доступности, стоимости и политики управления данными. В реальном производстве часто применяют S3‑совместимые решения и объектные хранилища в регионе доступности.
- Версионирование и retention: включение версионирования объектов и дефинированные политики хранения для обеспечения возможности возврата к конкретной версии бэкапа.
- Безопасность: шифрование, аудит доступа и хранение ключей в управляемых сервисах.
Верификация и тестирование восстановления
- Регулярные тесты восстановления в staging или QA‑кластере: подтверждают, что резервные копии можно использовать для восстановления до конкретной точки времени.
- Валидирование целостности: сверка контрольных сумм, сравнение схем и количества строк, проверка воспроизводимости ML‑фич.
- Документация и учения: обновляемые runbooks, регламент тестирования DR и периодические учения команд.
Внедрение процессов DR в продакшен
- Автоматизация: оркестрация резервного копирования и восстановлений через CI/CD или оркестрационные системы (например, Airflow, Kubernetes Jobs) с учётом зависимости между витринами и ML‑фичами.
- Мониторинг и алерты: видимость статуса бэкапов, время последнего удачного восстановления и состояние целостности данных.
- Контроль версий и конфигураций: фиксация версий схем, зависимостей и параметров вычислительного слоя, чтобы повторно создать идентичное окружение при восстановлении.
Практическая реализация: план внедрения DR в StarRocks
Этап
- Оценка текущей устойчивости: определить критичные витрины, наборы ML‑фич и требования к RPO/RTO для каждого компонента пайплайна. Этап
- Проектирование DR‑архитектуры: выбрать схемы полных и инкрементальных копий, определить регионы, хранилища и политики безопасности. Этап
- Реализация резервного копирования: внедрить автоматизацию подчас загрузок, обеспечить хранение метаданных и lineage. Этап
- Верификация и тестирования: регулярно проводить восстановление в тестовой среде, обновлять runbooks. Этап
- Операционная практика: связь DR‑процессов с пайплайнами ML и витринами, контроль версий, аудит и обучение команд.
Key takeaways
- Надёжность StarRocks достигается через согласованные стратегии копирования данных и метаданных, а также через организацию географически распределённых резервных копий.
- Восстановление должно быть детерминированным: точка времени, целостность витрин и воспроизводимость ML‑фич обеспечиваются за счёт PITR, версионирования и контроля lineage.
- Архитектура DR требует балансировки между скоростью восстановления и стоимостью хранения бэкапов, особенно в глобальных окружениях и при больших объёмах данных.
- Интеграция DR с пайплайнами данных и ML‑фичей должна быть автоматизированной: оркестрация, мониторинг, алерты и регулярные учения.
- Безопасность резервных копий - ключевой элемент: шифрование, управление доступом и аудит операций резервного копирования и восстановления.
- Проверка готовности к авариям должна быть частью жизненного цикла эксплуатации: тестовые восстановления подтверждают пригодность резервов к продакшен‑восстановлению.
- В контексте аналитического ML критично сохранять целостность не только данных, но и связанных метаданных, схем и lineage, чтобы результаты экспериментов оставались воспроизводимыми.
FAQ
- Что такое RPO и RTO в контексте DR StarRocks, и как их выбрать для ML‑нагрузок?
RPO (Recovery Point Objective) определяется как максимально допустимая потеря данных по времени, а RTO (Recovery Time Objective) - максимально допустимое время простоя при восстановлении. Для аналитической инфраструктуры с ML‑фичами часто выбирают низкий RPO, чтобы минимизировать потерю новых данных и обновлённых фич. RTO зависит от требований бизнеса к доступности витрин и способности проводить эксперименты без длительной паузы. В практике это достигается через частые инкрементальные копии, быстрый извлекаемый доступ к копиям и автоматизированное восстановление в отдельном DR‑кластере.
- Какие хранилища подходят для бэкапов StarRocks и чем они различаются?
Поддерживаются S3‑совместимые сервисы, локальные MinIO и HDFS‑кластеры. Выбор зависит от доступности, затрат и политики соответствия. Важно обеспечить версионирование, шифрование и возможность географически разнесённых копий, чтобы снизить риск потери данных при локальных сбоях.
- Как обеспечить консистентность между данными и метаданными при резервном копировании?
Необходимо фиксировать точку времени, где состояние данных и их метаданных согласованы. Реализация может включать снимки витрин совместно с метаданными, фиксацию lineage и последовательность операций загрузки, а затем резервирование всего этого объёма в совместных копиях. Верификация после восстановления должна подтверждать соответствие между данными, схемами и зависимостями.
- Какие сценарии аварий требуют отдельных действий по восстановлению?
Сценарии включают отказ одного BE‑узла, сбой FE‑узлов, региональные отключения кластера, и случаи с порчей данных. Для каждого сценария существует набор действий: изоляция проблемы, перераспределение нагрузки, восстановление данных из резерва, повторная синхронизация и проверка целостности. Важна автоматизация retornов и чёткие runbooks.
- Как проверить, что резервные копии действительно работоспособны?
Через регулярные тестовые восстановления в тестовом окружении, проверку целостности копий, сверку схем и количества записей, а также оценку воспроизводимости ML‑фич. Эти тесты должны быть автоматизированы и включать проверки на соответствие требованиям к витринам и сборке признаков.
- Как DR сочетается с пайплайнами аналитики и ML?
DR‑процедуры должны интегрироваться с пайплайнами: копии витрин и ML‑фич должны быть согласованными и доступными в DR‑кластере, чтобы эксперименты могли повторяться и результаты сохранялись. Важно сохранять зависимые конфигурации, версии моделей и окружения, чтобы воспроизводимость экспериментов не нарушалась после восстановления.
- Какие организационные практики поддерживают DR в продакшне?
Разделение ролей, чередование учений и регулярное обновление runbooks. Автоматизация процессов резервного копирования и восстановления, мониторинг статуса и аудита, а также периодические учения по сценариям аварий помогают повысить готовность команды к реальным ситуациям.
- Какие риски связаны с резервным копированием и как их минимизировать?
К основным рискам относятся задержки в копировании, несогласованные версии витрин и метаданных, а также угрозы безопасности копий. Их минимизируют через планомерную архитектуру копирования, шифрование и контроль доступа, а также через постоянную верификацию резервов и автоматические тесты восстановления.
- Как обеспечить консистентность обновлений в витринах и моделях после восстановления?
Необходимо хранить и синхронизировать версии витрин, методы расчета ML‑фич и конфигурации пайплайнов. При восстановлении повторно выполняются ключевые этапы сборки признаков, а затем сравнение результатов с контрольными показателями на целевом тестовом сегменте.
- Какие инструменты и практики можно применить для DR в StarRocks без избыточной сложности?
Использование готовых решений оркестрации (например, Airflow или Kubernetes Jobs) для планирования бэкапов и тестовых восстановлений; интеграция с существующими хранилищами объектов и политиками безопасности; применимо к гибридным средам, где часть инфраструктуры находится в облаке, а часть - в дата‑центрах. Важно держать баланс между функциональностью DR и операционной сложностью, чтобы обеспечить устойчивое сопровождение кластера в долгосрочной перспективе.


