

Self-Service Analytics в Lakehouse: семантические слои и доступ бизнес-пользователей
Современные организации стремятся сделать данные доступными не только для аналитиков и инженеров, но и для бизнес-пользователей, что приводит к развитию подхода Self-Service Analytics. В архитектуре Data Lakehouse это становится возможным благодаря созданию единого слоя доступа к данным, который сочетает масштабируемость хранения с удобством аналитики и единым бизнес-языком.
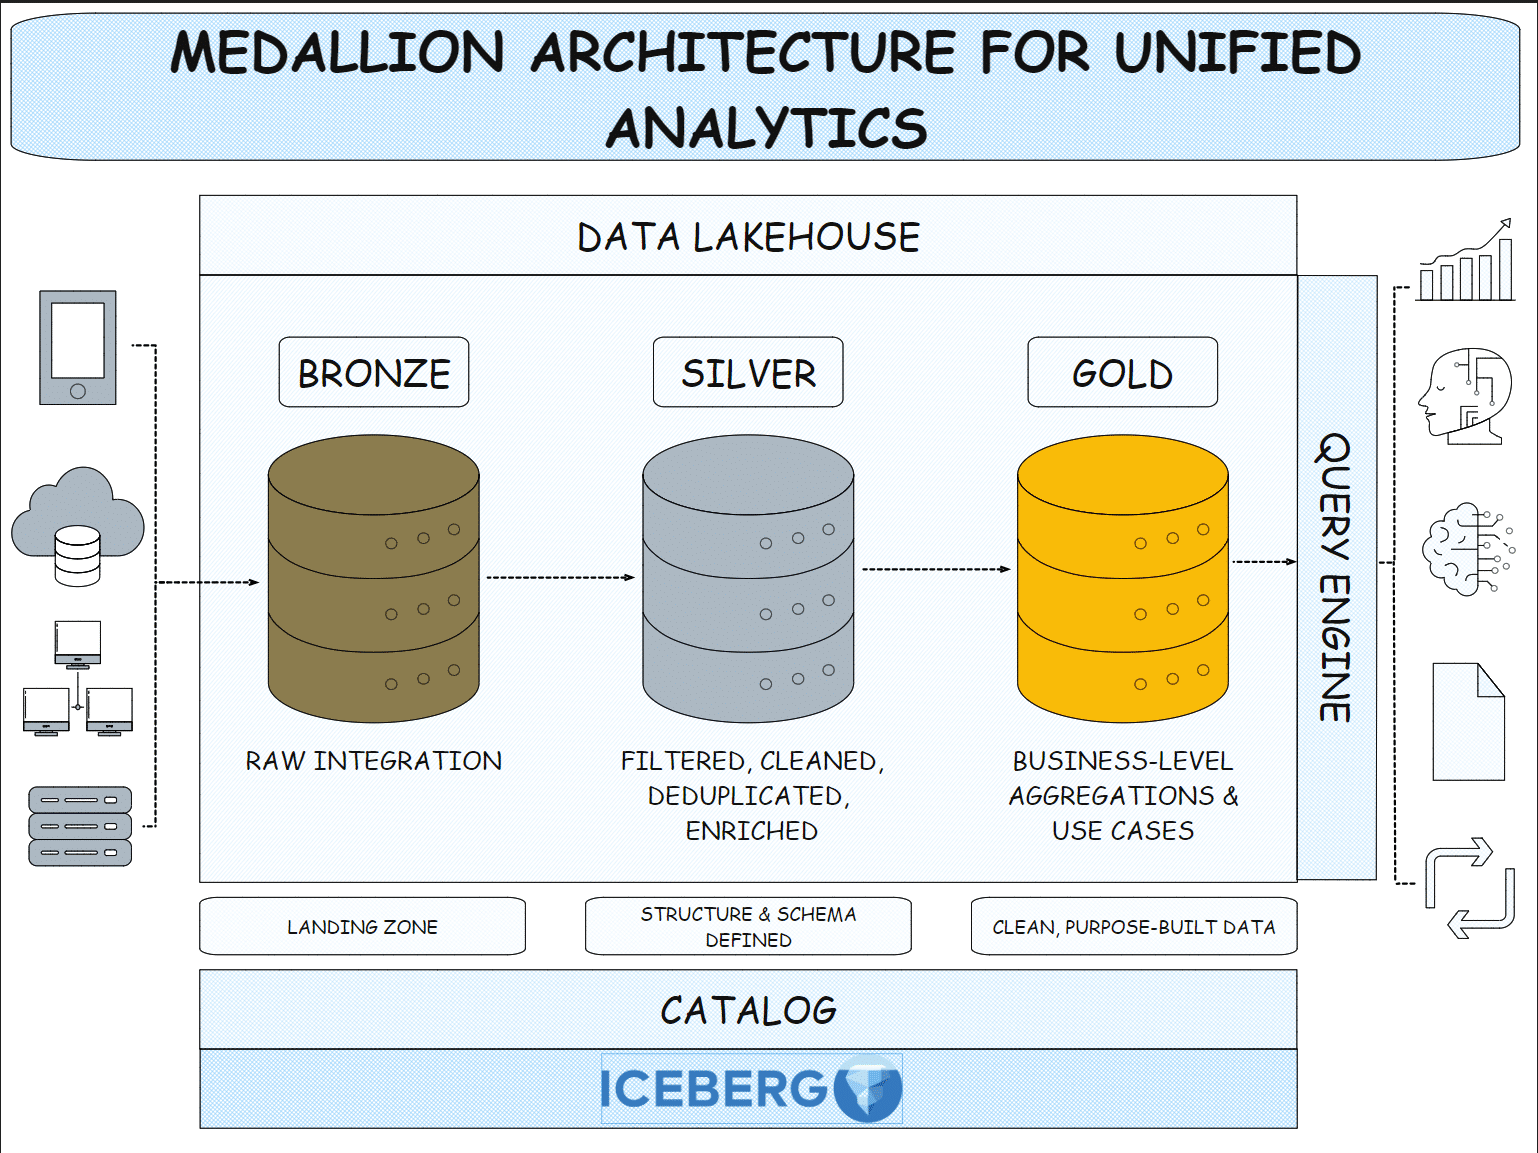
В этом разделе рассматриваются принципы построения self-service аналитики в Lakehouse: роль семантического слоя, управление метаданными и бизнес-терминами, архитектура доступа и безопасность. Особое внимание уделяется балансировке между гибкостью для пользователей и контролем качества данных, а также организационным аспектам — развитию data literacy, ролям и процессам. Такой подход позволяет компаниям ускорить принятие решений, повысить доверие к данным и масштабировать использование аналитики на уровне всей организации.
- Введение: Self-Service Analytics в Lakehouse - цели, контекст и ценности
- Терминология и базовые концепции: Lakehouse, semantic layer, self-service
- Теоретическая база Self-Service Analytics в Lakehouse: информационная архитектура и когнитивная нагрузка
- Архитектура Lakehouse: хранилище, вычисления, метаданные и оркестрация
- Роль семантического слоя: единый бизнес-язык и интерфейс к данным
- Модели данных для self-service: канонические и гибридные схемы
- Глоссарии, онтологии и управление терминами: бизнес-термины и их связь с данными
- Метаданные и управление каталогами: lineage, концепты, справочники
- Архитектура доступа и безопасность: RBAC, ABAC, маскирование, приватность
- Стандарты обмена данными и контрактов: SQL, JDBC/ODBC, REST, GraphQL, API contracts
- Интеграция источников данных: источники, коннекторы, ELT/ETL и стриминг
- Архитектурные паттерны и композиция слоев семантики: canonical model, federated access
- Инструменты и платформы: выбор стека и сервисов для lakehouse и семантики
- Инструменты подготовки данных: профилирование, очистка, трансформации, тестирование данных
- Управление качеством данных: правила, gates, мониторинг качества
- Управление изменениями схем и данных: drift, versioning, migrations
- Наблюдаемость и эксплуатация: мониторинг, журналирование, SLA
- CI/CD, тестирование и QA для данных: тест-кейсы, автоматизация развёртывания
- Управление проектом внедрения: методика phased rollout и управление зависимостями
- Организационная модель и роли: data owners, stewards, data literacy, enablement
- Метрики и оценка эффекта: adoption, доверие к данным, ROI, TCO
- Риски, антипаттерны и меры снижения в Self-Service Analytics в Lakehouse: семантические слои и доступ бизнес-пользователей
- Архитектура безопасности и соответствие: privacy, retention, auditing, DLP
- Кейсы применения: финансы и банки - риск и комплаенс
- Кейсы применения: розничная торговля - персонализация и ассортимент
- Кейсы применения: производство - операционная аналитика и качество
- Кейсы применения: телеком и здравоохранение - безопасность и сроки
- Документация, стандарты и шаблоны для повторяемости: архитектурные рецепты и шаблоны проектов
- Self-Service Analytics в Lakehouse: дорожная карта развития. Семантические слои и доступ бизнес-пользователей на горизонте 3-5 лет
- Развитие компетенций и экосистема практиков: обучение, сертификация, сообщество в Self-Service Analytics на Lakehouse


