

Риски, антипаттерны и меры снижения в Self-Service Analytics в Lakehouse: семантические слои и доступ бизнес-пользователей
Self-Service Analytics в контексте Lakehouse предлагает бизнес-пользователям прямой доступ к данным через унифицированный семантический слой. Это повышает скорость получения инсайтов, но вместе с тем требует внимательного управления рисками: от согласованности терминов и метрик до соблюдения требований безопасности и качества данных. Глава освещает ключевые риски, распознаёт наиболее распространённые антипаттерны и предлагает практические меры снижения, опираясь на современные архитектурные принципы Lakehouse, концепцию семантического слоя и практики управления данными через продукты как Databricks Unity Catalog и dbt Semantic Layer. В результате строится целостная картина: как сохранить автономию пользователей, не потеряв управляемость, доверие к данным и устойчивость операций.
Краткое содержание главы
- Роли семантического слоя и архитектурные компромиссы в Lakehouse.
- Основные антипаттерны Self-Service Analytics и их последствия для качества данных и вовлечённости бизнеса.
- Архитектура, контроль доступа и управление изменениями как мера снижения рисков.
- Практики внедрения, жизненный цикл семантического слоя и развитие организационных практик.
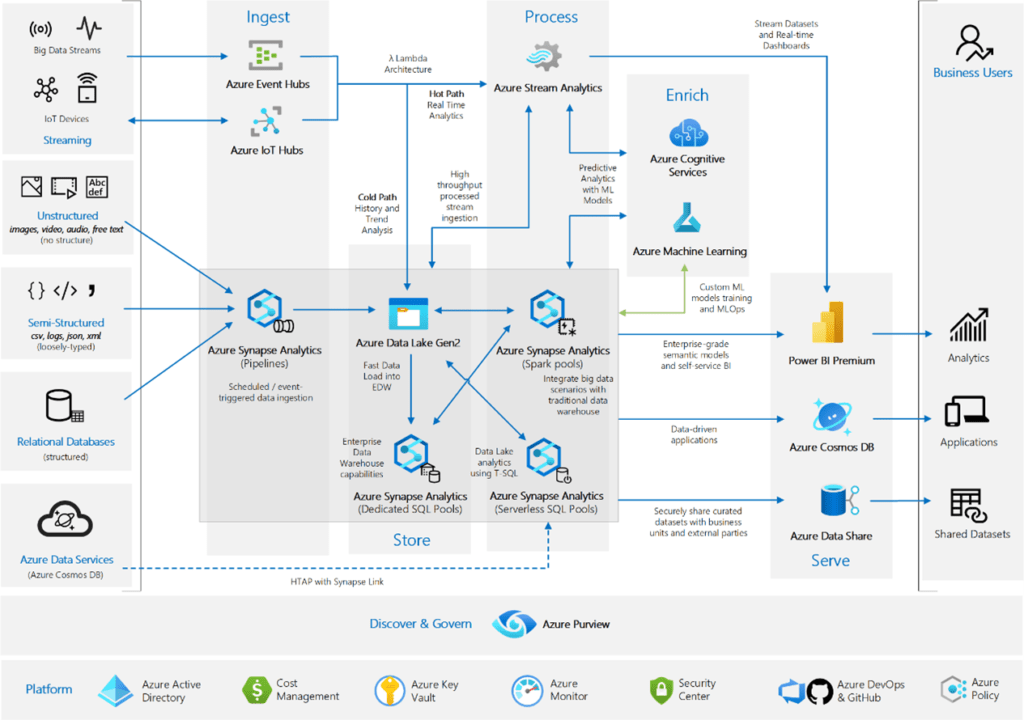
Архитектурные риски и паттерны в Lakehouse и семантическом слое
Self-Service Analytics строится на принципе предоставления бизнес-пользователям понятных и повторно используемых метрик поверх единого источника истины. Однако это сопряжено с рядом архитектурных вызовов:
-
Неполная согласованность между источниками данных и семантическим слоем. Термины, определения метрик и контексты могут расти быстрее, чем контракт качества данных. Это приводит к расхождениям между тем, что видит бизнес-пользователь, и тем, что реально хранится в дата-платформе. В Lakehouse это особенно остро, поскольку данные распределены по озерным слоям (data lake) и склада (data warehouse) с поддержкой транзакций, но без единообразного контракта на смысловую модель.
-
Риск семантического дрейфа. Необоснованные изменение термины, метрик или расчетных формул без надлежащего управления приводят к тому, что старые отчёты и новые дашборды начинают расходиться в интерпретации бизнес-значений. Особенно остро проблемы возникают при миграциях источников, обновлениях схем или изменениях алгоритмов агрегации.
-
Недостаточное управление контекстом и тонкой настройкой доступа. Бизнес-пользователи часто требуют широкий доступ к метрикам и данным, но не всегда обладают достаточной осведомлённостью о контексте, источнике, ограничениях и согласованных правах. Это создает риск неверной интерпретации и нарушения политики конфиденциальности.
-
Проблемы производительности и кеширования. Семантический слой может накапливать слой метрик поверх большого числа источников. Без продуманной стратегии кэширования, материализованных представлений и распределённых вычислений возникает задержка, которая подрывает доверие к self-service.
-
Контроль версий и согласование изменений. В условиях многопользовательской среды важны процессы версионирования схем, контрактов и метрик. Отсутствие чётких процедур влечёт за собой несовместимость между версиями дашбордов и моделями данных.
-
Интеграционная сложность и операционная устойчивость. Синергия между семантическим слоем и инфраструктурой Lakehouse (Delta Lake, Iceberg и пр.) требует чётких интерфейсов, контрактов и мониторинга. Без этого возникают узкие места на стыке источников, слоёв обработки и пользовательских запросов.
В контексте технологий сегодня реальными ориентиры являются продукты, которые поддерживают единый каталог данных и контракт на метрики и термины. Примеры: Databricks Unity Catalog для управления данными и правами доступа, а также dbt Semantic Layer как средство унифицированного определения метрик и терминов для бизнес-пользователей. Их роль в сочетании с Lakehouse заключается в поддержке единого уровня управления данными и контекстами доступа при сохранении автономии аналитиков.
Контекст и принципы взаимодействия слоёв
Чтобы снизить архитектурные риски, следует выстраивать явные границы и взаимоотношения между слоями:
- источник данных → семантический слой → представления/пользовательские отчёты. Каждый переход должен быть задокументирован в контрактах данных и метрик.
- версия и жизненный цикл контрактов. Любое изменение должно проходить через процесс согласования с участием бизнес- и IT-архитекторов.
- ясное разделение обязанностей. Аналитики и бизнес-аналитики отвечают за смысловую часть и контекст, инженеры данных - за инфраструктуру, каталогизацию и контроль доступа.
Антипаттерны и их последствия
В реальной практике встречаются характерные антиобразцы, которые подрывают доверие к self-service и снижают общую эффективность цифровой трансформации:
-
Антипаттерн: «Semantic layer как свободная зона для эксплоутинга данных» без чётких контрактов. Пользователи создают витрины на основе непоследовательных источников без документации и согласованных вычислений. В итоге возникают дубли и противоречивые показатели.
-
Антипаттерн: «Грубая, слишком крупная семантика»** - попытка собрать все возможно метрики в один слой без деления на предметные области и контексты. Это усложняет поиск нужной метрики, запутывает бизнес-пользователя и ухудшает контроль.
-
Антипаттерн: «Жёстко закодированные дашборды и экспорты»** - отчёты создаются без согласования с контекстами и без привязки к версиям контрактов. Появляется устаревшая или противоречивая визуализация, которой сложно управлять в будущем.
-
Антипаттерн: «Отсутствие управления качеством данных и метриками» - отсутствие проверок качества данных на входе в семантический слой. Это ведёт к принятию решений на основании некорректной информации и снижает доверие пользователей.
-
Антипаттерн: «Неэффективная политика доступа»** - слишком широкие или, наоборот, избыточно узкие права. Это либо опасное нарушение конфиденциальности, либо ограничивает бизнес-аналитику и снижает скорость проникновения к инсайтам.
-
Антипаттерн: «Непоследовательность версий»** - метрические контракты и определения не синхронизированы с обновлениями источников. В результате меняется смысл ключевых показателей, но отчёты и скрипты не обнавляются гибко.
-
Антипаттерн: «Игнорирование линейности данных и lineage»** - отсутствие видимости происхождения данных и изменений в источниках. Это делает невозможным повторный анализ и аудит.
Последствия перечисленных антиобразцов обычно выражаются в снижении доверия к данным, задержках в принятии решений, ошибках в бизнес-решениях и нарушении регуляторных требований.
Меры снижения рисков: архитектура, контроль доступа и эксплуатационные практики
Эффективная стратегия снижения рисков базируется на четырёх взаимодополняющих направлениях: архитектура семантического слоя, управление доступом и контекстом, управление качеством данных и метриками, а также операционные практики и безопасность.
Архитектура семантического слоя
- Определение канонических метрик и единых контекстов. Разрабатывайте набор «канонических» показателей, которые повторно используются в разных источниках, и храните их в центральном каталоге с чёткими определениями и ограничениями использования.
- Версионирование контрактов и метрик. Введите версионирование не только самих данных, но и контрактов на метрики, формулы расчёта и контексты. Это позволяет бизнесу откатываться к стабильной версии и проводить ретроспективный анализ.
- Модулеприятие принципов архитектуры. Разделяйте семантику по предметным областям и уровням абстракции: базовые уровни - низкоуровневые показатели, верхние - бизнес-ориентированные метрики. Это облегчает сопровождение и развивает повторное использование.
- Линейка изолированности и тестирования. Каждую марку метрик и набор контекстов следует тестировать на предмет согласованности с источниками, линейности и корректности расчетов.
Управление доступом и контекстом
- Гранулированный контроль доступа. Применяйте сочетание ролей и атрибутов (RBAC и ABAC) для ограничения доступа к данным и к самим вычислениям. Важно не только запретить доступ к данным, но и ограничить доступ к контексту и к вычислительным формулам.
- Контекстная безопасность и политика контента. Введите понятные правила того, какие метрики и данные доступны в каком контексте: по должности, по области ответственности, по проекту. Адекватная фильтрация контекста помогает снизить риск несанкционированного доступа и неверной интерпретации.
- Контракты на данные и согласование изменений. Любое изменение в терминах, метриках или источниках должно сопровождаться обновлением контракта и согласованием стейкхолдеров.
Управление качеством данных и метриками
- Внедрение качественных ворот (data quality gates). До загрузки в семантический слой данные проходят проверки качества: полнота, точность, консистентность, обнаружение аномалий. В случае отклонений - блокировка обновления и уведомление ответственных.
- Контроль дрейфа метрик и источников. Регулярно сравнивайте текущие расчеты с историческими версиями контрактов и данных, фиксируйте дрейф и инициируйте корректировки или исправления формул.
- Тестирование метрик и валидаторов. Разработайте набор тестов, включая граничные случаи, чтобы предотвратить неожиданные изменения в расчетах, особенно после изменений в источниках данных или правилах агрегации.
Интеграции, операции и безопасность
- Видимость наследования и lineage. Предоставляйте пользователю прозрачную трассируемость происхождения метрик: какие источники и какие преобразования влияли на конкретный показатель. Это повышает доверие и позволяет проводить аудит.
- Мониторинг и оповещения. Настройте мониторинг производительности запросов к семантическому слою, времени отклика, задержек в обновлениях контрактов и ошибок миграций. Это важно для устойчивости self-service в реальном времени.
- Защита данных и соответствие требованиям. Применяйте маскирование, анонимизацию и минимизацию данных там, где это необходимо. Поддерживайте соответствие нормативам (например, защита персональных данных) через соответствующие политики и аудит.
Практики внедрения и жизненный цикл семантического слоя
Успешное внедрение требует сочетания технических решений и управленческих практик. Ниже приведены принципы, которые хорошо работают в типичных организациях:
- Формирование общей дорожной карты семантического слоя. Определите приоритеты по предметным областям и по реальным сценариям self-service. Установите сроки, ответственных и требуемые артефакты: определения, контракты, тестовые наборы.
- Роли и ответственности. Чётко распределяйте роли между архитекторами данных, инженерами данных, владельцами контента и бизнес-аналитиками. Обеспечьте вовлечённость бизнеса на ранних этапах разработки и публикации контрактов.
- Контракты данных и метрик как артефакты продукта. Храните версии контрактов, определений метрик, источников и ограничений отдельно и версионированно. Это облегчает эволюцию без потери консистентности для потребителей.
- Обучение и поддержка пользователей. Регулярно проводите обучения по смыслу метрик, контексту использования и правилам доступа. Предоставляйте ясную дорожную карту изменений и способы запроса новых метрик или модификаций.
- Процессы тестирования и валидации. Введите регламентированные проверки новых контрактов и метрик перед публикацией. Включайте бизнес-класс в обзоры изменений, чтобы снизить риск недопонимания.
- Управление изменениями и релизы. Вводите политики остановки на выпуск изменений, ретро-совместимости и откаты. Релизы должны быть документированы и сопровождаться инструкциями для пользователей.
- Интеграция с каталогами и инструментами. Используйте открытые стандарты и интеграции с каталогами данных, инструментами мониторинга и системами защиты. Это обеспечивает единый обмен информацией и упрощает внедрение в существующую экосистему.
Мониторинг, качество данных и устойчивость
Для сохранения доверия к self-service в Lakehouse крайне важно постоянное наблюдение за состоянием данных и семантики:
- Видимость схемы изменений. Отслеживайте изменения в источниках, таблицах и представлениях. Регулярные ревизии помогают предотвратить неожиданные расхождения.
- Мониторинг использования и ценности. Анализируйте, какие метрики чаще всего запрашиваются, какие контексты доступа применяются и какие запросы требуют переработки для улучшения производительности.
- Контроль качества данных. Автоматизируйте проверки качества, включая полноту, точность и согласованность между источниками. При выявлении дефектов - инициируйте корректирующие действия.
- Производительность семантического слоя. Контролируйте время отклика, план выполнения запросов и устойчивость к нагрузкам. Оптимизируйте путём материализации, кэширования и оптимизации алгоритмов агрегации.
- Управление затратами. Мониторьте стоимость вычислений и хранения, оптимизируйте использование ресурсов, чтобы self-service не превращался в источник непредсказуемых расходов.
Key takeaways
- Семантический слой в Lakehouse повышает доступность бизнес-пользователей к данным, но требует явного управления контекстом, контрактов и качества.
- Антипаттерны, такие как свободный дрейф терминов и неуправляемые метрики, приводят к потере доверия и ухудшению качества решений.
- Эффективные меры снижения рисков включают архитектурно выверенный семантический слой, granular access control, управление качеством данных и хорошо выстроенные процессы изменений.
- Важна прозрачная трассируемость lineage и четкие контракты: источники → контекст → метрики → отчёты.
- Внедрение требует сочетания технологий (каталоги, семантический слой, управляемые данными платформы) и организационных практик (роли, процессы, обучение).
- Постоянный мониторинг и контроль производительности поддерживают устойчивость self-service и минимизируют скрытые затраты.
- Правильная комбинация технологий и процессов обеспечивает баланс между автономией пользователей и необходимостью соблюдения политики, качества и аудита.
FAQ
- Какие основные риски сопровождают внедрение семантического слоя в Lakehouse?
- Основные риски включают дрейф метрик и терминов, несогласованные контракты на данные, слабый контроль доступа и слабую видимость происхождения данных. Без ясной архитектуры и процессов эти риски приводят к дезинформации, задержкам и нарушениям комплаенса. Важная часть mitigation - внедрение канонических метрик, версионирование контрактов, четкая политика доступа и мониторинг изменений.
- Как снизить риск дрейфа метрик и терминов?
- Нужно формализовать контракты на метрики и термины, вести версионирование и проводить регулярные ревью с бизнесом и инженерами данных. Вводите тесты на корректность формул и автоматические проверки соответствия между источниками и семантикой. Регулярно синхронизируйте контракты с источниками и обновляйте документацию.
- Какие практики управления доступом наиболее эффективны для Self-Service Analytics?
- Эффективна комбинация RBAC и ABAC: роли определяют общие права, атрибуты - конкретный контекст и ограничения. Важно внедрить принцип минимального доступа и обеспечить видимость контекста (когда, какие данные, в какой форме, кем и для чего используются). Это снижает риск нарушения конфиденциальности и ошибок анализа.
- Какие идеи для архитектуры семантического слоя стоит взять за основу?
- Разделение по предметным областям, канонические метрики, версионирование контрактов, прозрачная lineage и независимый каталог метаданных. Важно обеспечить четкое соответствие между источниками и семантическим слоем, чтобы бизнес-пользователи получали единый, понятный и повторяемый контекст.
- Как обеспечить качество данных в условияхSelf-Service?
- Внедрите качественные ворота на входе в семантический слой: проверки полноты, точности, консистентности. Автоматизируйте тесты метрик и запросов, и инициируйте корректировки при выявлении дефектов. Введите регулярные аудиты и ретроспективы по обновлениям контрактов.
- Какие роли должны быть в команде по внедрению семантического слоя?
- Архитектор данных, инженер данных, владелец контента (лидер домена), бизнес-аналитик, специалист по безопасности и соответствию. Взаимодействие между этими ролями обеспечивает согласованность между бизнес-потребностями, архитектурной зрелостью и техническими ограничениями.
- Какие технологические примеры стоит рассмотреть для реализации?
- В контексте Lakehouse типичной опорой являются Databricks Unity Catalog для управления доступом и метаданными, а также dbt Semantic Layer для унифицированного определения и использования метрик в бизнес-проектах. Эти инструменты помогают структурировать данные, обеспечить контроль доступа и упростить распространение единой семантики по организации.
- Как связаны семантический слой и мониторинг производительности?
- Мониторинг производительности позволяет отслеживать время выполнения запросов, задержки и потребление ресурсов семантическим слоем. Это критично на ранних стадиях внедрения, когда структура метрик и маршрутов доступа ещё формируется. Оповещения помогают своевременно реагировать на ухудшение качества или производительности.
- Что делать, если бизнес хочет добавить новые метрики?
- Введите процесс запроса метрик через контракт данных: бизнес формулирует цель, источник, расчеты и параметры доступности. Инженеры данных оценивают влияние на существующие контракты и проводят тестирование на корректность. После одобрения новая метрика публикуется в каноническом каталоге и становится доступной для self-service в рамках установленной политики.
- Как поддерживать устойчивость и эволюцию семантического слоя?
- Регулярно пересматривайте контракты, обучайте пользователей, следите за дрейфом источников и метрик, внедряйте автоматизированные проверки качества. Обеспечьте документированную дорожную карту изменений и четко обозначенные часы поддержки и ответственных за каждую область.
Глава рассчитана на уровень профессионального методического пособия: она соединяет архитектурные принципы, организационные практики и практические рекомендации по внедрению. В тексте подчёркнуты связи между техническими решениями и бизнес-целями, а также предложены конкретные подходы к управлению рисками при работе с Self-Service Analytics в Lakehouse.


