

Введение: Self-Service Analytics в Lakehouse - цели, контекст и ценности
Self-Service Analytics в рамках концепции Lakehouse позволяет бизнес-пользователям формировать инсайты без постоянной зависимости от ИТ-подразделения, сохраняя при этом контроль за качеством данных, безопасностью и согласованностью показателей. Этот подход строится на объединении преимуществ data lake и data warehouse: единое хранилище, поддержка ACID-операций, гибкость хранения и высокий уровень управляемости. Главная идея состоит в том, чтобы превратить данные в общедоступный, понятный и управляемый продукт: бизнес-словарь, набор готовых метрик и согласованные правила расчета, доступ к которым осуществляется через безопасные, масштабируемые точки входа.
В контексте цифровой трансформации организации Self-Service Analytics становится катализатором скорости принятия решений и качественной конкуренции. Но без должных механизмов управления, семантика может распасться: дублирующиеся термины, разрозненные расчеты метрик, противоречивые данные и нарративы. Семантический слой в Lakehouse выступает связующим звеном между сырыми данными и бизнес-потребностями, переводя сложные схемы хранения в понятные бизнес-термины, дефиниции метрик и правила их вычисления. Это, в свою очередь, создает единый источник истины, который одновременно поддерживает свободу анализа и соблюдение регуляторных требований.
Приведенные ниже разделы раскрывают, зачем нужна такая архитектура, как она строится на уровне технологий и процессов, какие задачи решает и какие шаги необходимы для внедрения. Рассматриваемый контекст рассчитан на технических специалистов, архитекторов данных и методологов, отвечающих за создание устойчивой инфраструктуры для бизнес-пользователей.
-
Определение целей Self-Service Analytics в контексте Lakehouse: как обеспечить доступность без потери качества.
-
Архитектура и роль семантического слоя как мостика между данными и пользователями.
-
Практические принципы реализации и принципы управления изменениями, включая безопасность и соответствие.
-
Контекст и цели Self-Service Analytics в Lakehouse, архитектура слоев и принципы реализации.
-
Роли семантического слоя: термины, метрики, вычисления и их связь с данными источников.
-
Внедрение в организации: процессы, роли, риски и пути повышения принятия пользователями.
Контекст и целевые ориентиры
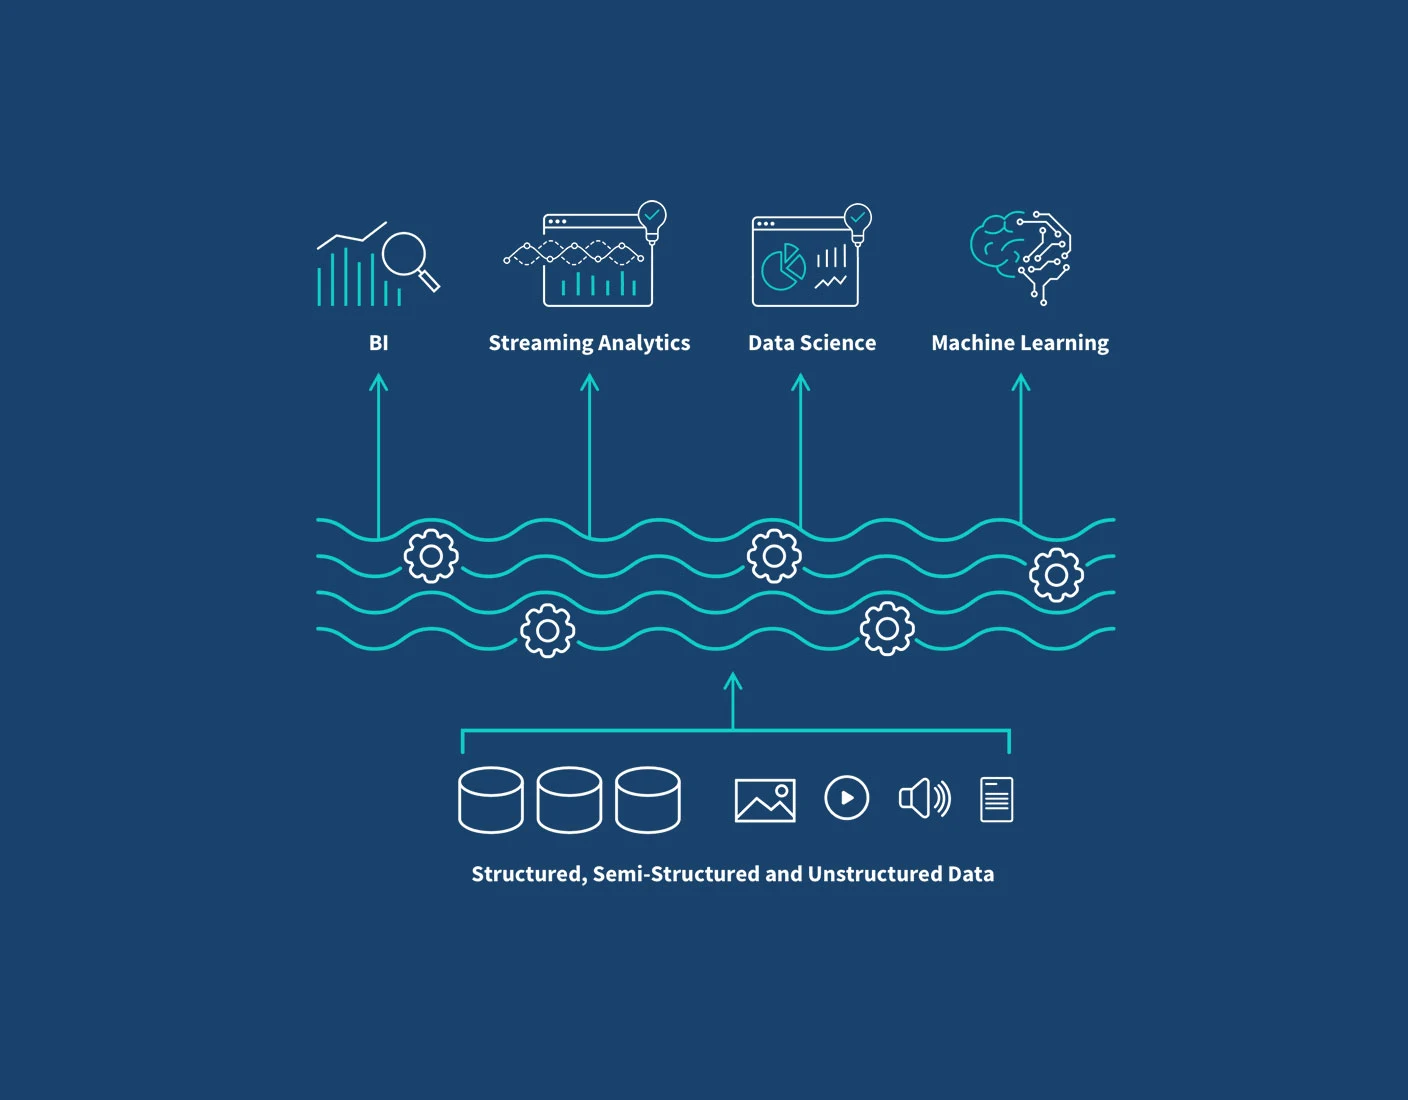
В современных организациях данные распределяются между различными хранилищами и платформами. Lakehouse предоставляет единую платформу для хранения структурированных, полуструктурированных и неструктурированных данных, объединяя возможности дата-лэйка и дата-вайхарха. В этом контекстe ключевые принципы включают:
- Конвергенцию данных и аналитики: единое хранилище упрощает соответствие между реальным состоянием данных и метриками, которые используют бизнес-пользователи.
- Управляемую автономию анализа: делегирование части аналитических задач бизнес-анализаторам без снижения уровня контроля над качеством данных.
- Гарантированную сопоставимость метрик: унификация определений, правил расчета и источников цифр.
Семантический слой в Lakehouse выполняет роль бизнес-словаря и вычислительного контура. Он переводит технические данные (таблицы, поля, источники) в понятные бизнес-термины, предоставляет готовые метрики с едиными правилами расчета и обеспечивает трассируемость: кто принял решение, какие данные и какие изменения привели к конкретному результату. Такой подход содействует доверию к аналитике, ускоряет обучение новых пользователей и снижает риск ошибок.
Основные принципы, которые мы будем разделять далее, включают: единый словарь терминов, регистр метрик, политика качества данных и прозрачная политика доступа. В сочетании эти принципы позволяют достигать цели по скорости внедрения аналитики и снижению операционных издержек на поддержание нескольких разрозненных инструментов.
Важным фактором успеха является баланс между свободой анализа и требованиями к управлению. С одной стороны, бизнес-пользователи должны иметь возможность самостоятельно формулировать запросы, проводить анализы и строить дешевые прототипы, с другой - сохранение консистентности и соответствия регламентам. Поэтому архитектура должна быть открытой и взаимосвязанной: семантический слой опирается на каталог метаданных, политики безопасности и управление изменениями, а BI-инструменты говорят на языке бизнес-терминов, которые понятны как аналитикам, так и руководству.
Архитектура Lakehouse и роль семантического слоя
Архитектура Lakehouse поддерживает модель слоистого доступа: ingestion и обработка данных, слой хранения, семантический слой и слой представления, к которым обращаются BI-системы и инструменты аналитики. В центре - семантический слой, который функционирует как мост между низкоуровневой структурой данных и бизнес-ориентированными запросами.
Ключевые компоненты архитектуры:
- Ингестионный слой: непрерывная загрузка данных из оперативных систем, журналируемых источников, SaaS-приложений; используются ELT-процессы, которые приводят данные к пригодному для аналитики состоянию.
- Хранилище Lakehouse: объединение форматов открытых файлов (Parquet, ORC и т.д.) с транзакционной поддержкой и схемной эволюцией; обеспечение ACID и временных копий (time travel) для воспроизводимости.
- Семантический слой: бизнес-термины, факты, измерения, правила вычисления и контракты качества; модули соответствия и сопоставления между терминами и физическими источниками; механизм разрешения конфликтов между различными источниками.
- Каталог метаданных и политика доступа: единая карта объектов данных, их владельцев, зависимостей и lineage; управление правами доступа на уровне строки, столбца и термина.
- Слой представления: BI-инструменты и аналитика конечного уровня через JDBC/ODBC, REST API или через специализированные адаптеры; поддержка кэширования и запросного ускорения.
- Оргполитика и операционный слой: процессы управления изменениями, контроль версий моделей семантики, аудит и соответствие.
С технической точки зрения, семантический слой реализуется как выделяемый сервис или набор сервисов, которые могут функционировать как часть единой платформы или как автономный слой на базе существующих инструментов. Архитектурно он инкапсулирует логику нормализации терминов, правила расчета, обработку синонимии и диспетчеризацию запросов, перенаправляя их на соответствующие источники или агрегированные представления. Взаимодействие осуществляется через стандартизованные интерфейсы: SQL-подключения для аналитиков, REST-эндпойнты для применения бизнес-логики и API для программного доступа к метаданным.
Преимущества такого подхода очевидны:
- Единая бизнес-терминология снижает риск расхождений между отделами, возвращая контроль в единое место.
- Встроенные контракты на метрики и правила вычисления позволяют автоматически валидировать новые источники и обновления моделей.
- Возможность кэширования и материализации популярных метрик ускоряет аналитические запросы и снижает нагрузку на источники данных.
- Поддержка регуляторных требований через прозрачную трассируемость и аудит доступа.
Пример типовой диaграммы взаимодействий: источники данных -> ELT/ETL-обработчик -> Lakehouse -> семантический слой -> BI-инструменты. Однако в реальности связки могут быть гибкими: семантический слой может выступать как автономный сервис, а BI-слой может использовать vielfältные клиенты, включая визуальные консолидированные дашборды, лабораторные ноутбуки и сервисы интеграции.
Алгоритмические аспекты семантического слоя включают:
- Разрешение терминов и соответствие между терминами и физическими столбцами, включая обработку синонимии и различий в контекстах.
- Определение и управление зависимостями между терминами, источниками и вычислениями метрик.
- Управление версиями: поддержка исторического анализа изменений в терминах и расчетах, что важно для воспроизводимости и аудита.
- Валидация данных: автоматические проверки на полноту, согласованность и временную непротиворечивость между источниками.
- Оптимизация запросов: выбор наиболее эффективного пути доступа к данным через семантические представления, их материализацию и агрегацию.
Модели семантики: бизнес-термины, показатели и правила вычислений
Семантический слой строится на трех китах: бизнес-термины (глоссарий), метрики (показатели) и правила вычислений (логика расчета). Все три компонента взаимосвязаны и поддерживают единый язык общения между бизнес-потребностями и данными.
- Бизнес-термины. Это словарь понятий, который описывает сущности, которые бизнес видит в анализе: продажи, удержание клиентов, конверсия, маржинальность и т.д. Термины должны быть однозначными, легко понимаемыми, и определяться вместе с владельцами бизнеса. Важно описывать контекст использования: гранularity, временной срез, география и т.д.
- Метрики и показатели. Это конкретные вычисления, которые зафиксированы и должным образом версионированы. Метрика может включать открытую формулу, период расчета, источники данных и линейку допущений. В идеале метрики должны иметь возможность drill-down-от общего показателя к более детализированным уровням.
- Правила вычислений. Это набор SQL-подобных выражений или вычислительных правил, которые применяются к данным источников и создают метрику. Правила должны быть инкапсулированы в контракт, доступный через семантический слой, и поддерживать перенастройку без разрушения существующих отчетов.
Эти элементы должны управляться через процессы управления изменениями и политики качества. В реальной практике чаще встречаются следующие типичные сценарии:
- Единая дефиниция ключевых метрик в разных бизнес-домах. Например, «выручка» и «маржа» должны рассчитываться одинаково по всем сегментам и каналам, чтобы сравнение было валидным.
- Поддержка альтернативных выражений той же самой метрики для отдельных источников, с сохранением связи к основному контракту. Это позволяет аккуратно мигрировать источники без потери совместимости.
- Управление версиями метрик. Ввод новой версии метрики должен быть обратно совместимым или сопровождаться миграцией дашбордов и алертингом, чтобы пользователи не столкнулись с неожиданными изменениями.
- Контроль качества через линейку валидаций: наличие пропущенных значений, несоответствий в периодах, расхождения между агрегатами.
Технически эти концепции реализуются через:
- Глоссарий и словарь термов с привязкой к источникам и вычислениям.
- Регистры метрик с декларациями версий, контекстов использования и зависимостей.
- Правила вычислений в виде машиночитаемого описания (например, выражения SQL или DSL), поддерживаемого в рамках semantic API.
- Логирование изменений и аудит через lineage и трассируемость до исходных данных.
Кроме того, важно рассмотреть алгоритмы, которые поддерживают семантическую согласованность:
- Распознавание синонимов и согласование терминов между бизнес-пользователями и техническими источниками.
- Автоматическое сопоставление полей источников с терминами через сопоставление смыслов и контекста.
- Оптимизация планов выполнения: выбор наиболее эффективного пути доступа к данным через виртуальные представления или кэш/материализованные представления.
Практические принципы разработки моделей семантики включают:
- Начинайте с минимально достаточной модели: базовый набор терминов и критичных метрик, затем расширяйте.
- Устанавливайте ответы на вопросы “когда, где и как” для каждой метрики: момент расчета, периоды, география, источник.
- Включайте бизнес-правила как часть соглашения: какие изменения допустимы, как откатывать, как уведомлять потребителей.
- Поддерживайте совместимость и прозрачность: версионирование контрактов и доступность предыдущих версий метрик.
Инструменты доступа и интеграции с BI
Для эффективной реализации Self-Service Analytics в Lakehouse необходима связочная инфраструктура между семантическим слоем и инструментами BI. Эта связка обеспечивает единый разговорный язык, безопасный доступ и управляемое расширение аналитического потенциала.
Ключевые принципы интеграции:
- Единый интерфейс доступа. BI-инструменты должны иметь возможность подключаться к семантическому слою как к источнику данных с поддержкой SQL-выражений, а также к семантическим API для вызова бизнес-логики и расчета метрик.
- Прозрачная аутентификация и авторизация. Используются SSO, OAuth2 или SAML, а также роль- и атрибут-ориентированное управление доступом к термам, метрикам и данным на уровне строк и столбцов.
- Контроль контекста. Пользователь должен видеть только те термины и метрики, для которых он имеет разрешение. Весь контент сопровождается метаданными и lineage, что обеспечивает прослеживаемость.
- Инструменты каталогизации и поиска. Каталоги метаданных (например, Amundsen, DataHub) позволяют пользователям находить термины, объяснения и зависимые источники без необходимости обращения к ИТ.
- Производительность и кэширование. Механизмы кэширования результатов, материальные представления и индексы ускоряют доступ к часто используемым метрикам и терминологии.
- Управление изменениями и журналирование. Любые изменения в терминологии, метриках и правилах должны фиксироваться, с возможностью отката и уведомления потребителей.
При выборе конкретных технологий следует учитывать баланс простоты использования и архитектурной зрелости. В рамках открытых решений можно упомянуть:
- Каталоги метаданных и глоссарии: Amundsen, DataHub. Они поддерживают поиск термина, отношение к источникам и вещественным зависимостям.
- Платформы для lakehouse и аналитической среды: Delta Lake или Apache Iceberg как примеры хранителей форматов и транзакционного слоя; Spark как движок обработки; BI-инструменты (Power BI, Tableau, Looker) с поддержкой прямых подключений и семантических адаптеров.
- Программируемые интерфейсы доступа: JDBC/ODBC для SQL-запросов, REST API для программного доступа к семантическому слою.
Важно избегать перегруженности интерфейсов и не перегружать пользователей бесчисленным количеством опций. Оптимальным является единый «точка входа» в семантический слой с настройками под роль пользователя и контекст задачи. Такой подход сокращает обучающие циклы и ускоряет внедрение.
Управление качеством данных, безопасность и соответствие
В Self-Service Analytics качество данных и контроль доступа становятся краеугольными камнями доверия к аналитике. Семантический слой должен включать механизмы обеспечения качества и регуляторной совместимости, поддерживающие прозрачность и воспроизводимость.
Ключевые направления:
- Данные и качество. Встраивание проверок полноты, согласованности и временной непротиворечивости между источниками. Регулярные регламентированные проверки позволяют выявлять расхождения на ранних стадиях.
- Линейность и трассируемость. Полная прослеживаемость от термина до исходного источника. Это позволяет объяснять пользователю происхождение цифры и автоматически проводить анализ влияния изменений.
- Безопасность на уровне термов и метрик. Правила доступа должны применяться к уровням: терм, метрическая единица, набор данных, строка и столбец. Реализация может включать маскирование чувствительных данных и динамическое ограничение данных.
- Соответствие регуляторным требованиям. Учет GDPR, CCPA и аналогичных норм через политики «прав на доступ к данным», «прав на исправление» и «прав на удаление» в рамках семантического слоя.
- Управление изменениями. Внедрение изменений в термины и метрики должно сопровождаться уведомлениями, тестами регрессионной совместимости и миграционными планами.
Эти аспекты требуют согласованной работы между бизнес-аналитиками, архитекторами данных, специалистами по безопасности и юридическим службам. Регулярные ревизии и обновления контракта на метрики, а также четкие роли ответственных за данные, помогают снизить риски утечки, ошибок в расчетах и несогласованности между подразделениями.
Путь к внедрению: фазы, риски и управление изменениями
Внедрение Self-Service Analytics в Lakehouse - это последовательная работа, требующая управляемых изменений в процессах и культуре организации. Ниже приведен типовой путь, который можно адаптировать под конкретные условия.
- Фаза 1. Стратегия и стейкхолдеры. Определение целей, формирование управляющей комиссии по данным, согласование политики семантики, безопасности и качества. Создание дорожной карты внедрения и выбор инструментов.
- Фаза 2. Инвентаризация источников и базовая семантика. Собрание существующих термов, метрик и источников. Разработка базового глоссария и регистров метрик, установка контрактов на базовые показатели.
- Фаза 3. Архитектура и интеграции. Развертывание Lakehouse, семантического слоя и каталога метаданных; настройка доступа, SSO и политик безопасности; подключение BI-инструментов через единый интерфейс.
- Фаза 4. Прототипы и ускорение внедрения. Создание пилотных доменов (например, продажи, маркетинг), построение нескольких ключевых метрик и дашбордов; сбор обратной связи и улучшение терминосистемы.
- Фаза 5. Масштабирование и образование сообщества. Расширение семантической модели на новые области, внедрение процессов обучения и поддержку «пользовательских чемпионов» в подразделениях.
- Фаза 6. Управление изменениями и устойчивость. Регулярные ревизии контрактов и инструментов, мониторинг использования, оценка эффективности и ROI; активная работа с рисками и обновление стратегий безопасности.
Риски и способы их минимизации:
- Расхождение терминов. Неправильное сопоставление терминов между отделами приводит к дезорфиями в метриках. Решение: централизованный глоссарий, ролевой доступ к термам, периодические сессии согласования.
- Перегрузка пользователей. Слишком сложная модель семантики отпугивает бизнес-пользователей. Решение: начать с базовых метрик, постепенно расширять контекст и поддержку самообучения.
- Слабая управляемость изменений. Без надлежащего контроля изменений появляется риск регресса. Решение: чёткий процесс версионирования, тестирование регрессионных сценариев и уведомления.
- Непредсказуемая производительность. Неправильная архитектура доступа к данным может приводить к задержкам. Решение: предусмотреть кэширование, матрирование и деградацию качества в случае пиковых нагрузок.
В конечном счете успех внедрения зависит от сочетания технологической зрелости и организационной готовности. Важным фактором является создание культивированной среды, где бизнес-пользователи чувствуют поддержку и ответственность за совместное использование ресурса, а ИТ-продвинутые команды сохраняют контроль над качеством данных и безопасностью.
Key takeaways
- Lakehouse объединяет преимущества data lake и data warehouse, создавая единое хранилище для аналитики и упрощая доступ к данным.
- Семантический слой служит мостом между техническими источниками и бизнес-потребностями, обеспечивая единые термины, метрики и правила вычислений.
- Эффективность Self-Service Analytics достигается через управляемый доступ, прозрачность метрик, версионирование контрактов и политики качества данных.
- Интеграция с BI-инструментами требует стабильных интерфейсов, каталогов метаданных и строгой политики безопасности.
- Управление изменениями и обучение сотрудников - критические элементы устойчивой эксплуатации аналитических платформ.
- Риск-менеджмент в рамках данных включает аудит, прозрачность lineage, маскирование чувствительных данных и соответствие регуляторным требованиям.
- Успех зависит от сочетания архитектурной зрелости и организационной культуры, ориентированной на сотрудничество между бизнес-подразделениями и ИТ.
FAQ
- Что такое Lakehouse и чем он отличается от традиционного хранилища данных?
- Lakehouse объединяет хранение больших объемов неструктурированных и полуструктурированных данных с возможностями транзакционных операций и производительных SQL-запросов. В отличие от классических data warehouses, Lakehouse сохраняет гибкость data lakes и обеспечивает управление схемами, версионирование и ACID-транзакции в едином контуре.
- Как семантический слой улучшает доступ бизнес-пользователей к данным?
- Семантический слой переводит техническую структуру данных в понятные бизнес-термины, предоставляет единые определения метрик и правила их расчета, упрощает поиск и доступ к данным через каталог терминов и контроль доступа. Это сокращает время обучения и снижает риск расхождений в отчетности.
- Какие модели данных применяются для семантики в Lakehouse?
- Чаще всего используются термины и глоссарий, регистры метрик и наборы вычислений, связанные через ясные контракты. Эти модели могут поддерживать drill-down к деталям, вариативность источников и версионирование для воспроизводимости.
- Какие риски стоит учитывать на стадии проектирования семантического слоя?
- Риски включают расхождения в терминах между отделами, противоречивые расчеты метрик, сложность управления изменениями и проблемы с безопасностью. Их следует минимизировать за счет централизованного глоссария, четких контрактов на метрики и политики доступа.
- Как обеспечить безопасность и соответствие требованиям в Self-Service Analytics?
- Реализация включает роль- и атрибут-ориентированное управление доступом, динамическое маскирование данных, аудит и журналирование запросов, а также соответствие регуляторным требованиям через политики обработки данных и возможность управления записями пользователей.
- Какие интеграционные паттерны применяются для BI-инструментов?
- Подключение через JDBC/ODBC к семантическому слою, REST API для вызова бизнес-логики, единый интерфейс доступа и использование каталогов метаданных. Важно обеспечить единый язык запросов и политику безопасности для всех клиентов.
- Каковы основные этапы внедрения семантического слоя?
- Этапы включают стратегическую настройку и согласование, инвентаризацию источников и терминов, настройку архитектуры и интеграций, создание пилотных доменов, масштабирование и формирование сообщества пользователей, а также управление изменениями и обучением.
- Как оценивать успех внедрения Self-Service Analytics?
- Основные показатели включают скорость получения инсайтов, долю пользователей, активность в создании и повторном использовании метрик, качество данных и уменьшение времени на подготовку данных, а также уровень удовлетворенности бизнес-пользователей.
- Какие техники помогают поддерживать единый словарь терминов?
- Регулярные сессии согласования, хранение метаданных в централизованном каталоге, контроль версий терминов и правил, а также автоматизированная валидация соответствий между терминами и источниками.
- Какие подходы к обучению сотрудников вы рекомендуете?
- Внедрять «популярные сценарии» (use cases) с готовыми метриками и дашбордами, создавать обучающие курсы по терминам и логике вычислений, проводить открытые сессии вопросов и ответов и развивать сетевое сообщество пользователей для обмена опытом и практиками.


