

Контекст применения песочниц: бизнес-цели и требования к изоляции и скорости доступа
Песочницы в контексте DWH и ML-аналитики становятся критическим инструментом для безопасного экспериментирования, ускорения времени получения инсайтов и соблюдения требований регуляторов. Они позволяют отделить рабочие пространства для аналитиков, дата-сайентистов и бизнес-пользователей от продакшен-сред, сохраняя контроль над данными, ресурсами и себестоимостью. Правильная реализация песочниц превращает абстрактные бизнес-цели в конкретные архитектурные решения, процессы и политики, что особенно важно в условиях роста объемов данных, разнообразия источников и усложнения моделей машинного обучения.
В этой главе рассмотрены ключевые бизнес-цели, которые обуславливают создание песочниц, и переведены в требования к изоляции и скорости доступа. Далее представлены архитектурные принципы, паттерны реализации и методы управления данными и безопасностью в песочницах, а также подходы к автоматизации жизненного цикла сред. В конце - набор практических рекомендаций и примеры типовых решений.
- Краткое содержание главы
- Определение бизнес-целей песочниц и персонификация их в архитектурные требования DWH и ML.
- Требования к изоляции: сетевые, вычислительные, данные, доступ и аудит.
- Архитектурные паттерны песочниц: разделение плоскостей управления и вычислений, жизненный цикл и интеграции.
- Метрики скорости доступа и поддержания свежести данных: баланс между скоростью, латентностью и стоимостью.
- Управление данными, безопасностью и соответствием в песочницах: маскирование, синтетические данные, линейка данных и прозрачность.
- Инфраструктура как код и автоматизация жизненного цикла песочниц: шаблоны, политики и оркестрация.
Бизнес-цели и перевод требований в архитектуру песочниц
Песочницы должны служить мостом между стратегическими целями бизнеса и инженерной реализацией. Основные бизнес-цели включают ускорение времени получения инсайтов, снижение рисков при экспериментировании с данными и моделями, обеспечение соответствия регуляторным требованиям и повышение прозрачности процессов аналитики. В техническом плане это означает создание изолированных, воспроизводимых и управляемых сред, которые позволяют безопасно:
- проводить эксперименты с новыми моделями ML, тестировать гипотезы и проводить A/B-тесты без воздействия на продакшен;
- работать с разными наборами данных: реальными, синтетическими и маскированными, при этом сохранять способности к отслеживанию происхождения данных;
- повторять эксперименты и воспроизводить результаты, обеспечивая контроль версий и трассировку зависимостей.
Чтобы связать цели бизнеса с архитектурой, требуется формализовать набор KPI и требования к средам песочниц: скоростьProvision, время развертывания, латентность доступа к данным, размер допустимого бюджета песочницы, доля автоматизированных процессов развёртывания, процент повторяемости экспериментов и доля соответствия требованиям по безопасности и аудиту. В этом контексте основное проектное решение - разделение управляемой плоскости (контроль и оркестрация) от плоскости вычислений и данных, поддерживаемой единым набором интерфейсов и политик.
Важной частью заключается в формировании политики доступа к данным и средам. Принцип наименьших прав должен внедряться на уровне IAM, сетевого сегментации и политики секретов. Необходимо обеспечить такую архитектуру, при которой:
- каждая команда или проект имеет выделенное песочное окружение с гарантированными ресурсами и ограничениями по бюджету;
- доступ к данным ограничивается контекстом проекта, роли и утверждёнными наборами данных;
- аудит и мониторинг активностей доступны централизованно и прозрачно для регуляторов и внутренних аудитов.
С точки зрения архитектуры это требует наличия единого портала управления песочницами, который агрегирует параметры среды, бюджеты, статусы обновления и требования по безопасности. Такой портал должен обеспечивать автоматическое создание и удаление окружений на основе шаблонов, а также интегрироваться с CI/CD процессами и системами мониторинга.
- Определение целевых KPI для песочниц:
- Time-to-provision и Time-to-first-result: насколько быстро можно поднять среду и получить первые аналитические результаты.
- Data freshness и latency в рабочих пайплайнах: уровень задержек между источниками данных и инструментами анализа.
- Cost-per-sandbox и контроль за перерасходом: финансовая прозрачность расходуемых ресурсов.
- Reproducibility и auditability: возможность повторить эксперимент и проследить источник данных и зависимостей.
- Уровень соответствия и seguridad: доля операций, подпадающих под регуляторные требования и политики.
Архитектурные решения в этом контексте опираются на практики модульной архитектуры: разделение контекстов данных, вычислительных задач и управляющих сервисов, применение изоляционных механизмов и последовательностей процессов, позволяющих быстро масштабировать песочницы под растущие потребности бизнеса.
- Примерная дорожная карта для перехода к целевым песочницам:
- определить бизнес-профили песочниц (размер проекта, требования к данным, требования к скорости);
- выбрать набор архитектурных паттернов и инструментов для изоляции и управления жизненным циклом;
- внедрить шаблоны сред и политики (policy-as-code);
- наладить мониторинг, аудит и отчётность.
В этом разделе можно отметить роль двух типичных технологий: оркестраторы рабочих потоков и платформы для вычислений. Они обеспечивают выполнение задач в песочницах, синхронизацию данных и согласование политик между различными средами. В качестве иллюстрации возьмём упрощённые сценарии: выделение отдельной среды под проект с ограниченным бюджетом и автоматическое масштабирование вычислительных ресурсов на основе загрузки пайплайнов. Эти сценарии показывают, как бизнес-цели переводятся в конкретные требования к управлению средой и к механикам поддержки.
Важное замечание: выбор конкретных технологий и инструментов зависит от контекста компании, инфраструктуры и регуляторных требований. Однако принципы остаются неизменными: изоляция, воспроизводимость и управляемость должны быть встроены в каждое песочное окружение, а процессы - автоматизированы и безопасно контролируемы.
В этом блоке также важно обозначить роли и взаимодействия между участниками проекта: бизнес-аналитики, дата-инженеры, дата-сайентисты, инженеры по данным, security и IT. В идеальном случае все стороны работают через единый портал управления песочницами, где политики и бюджеты фиксируются и применяются автоматически. Это снижает риск ошибок, ускоряет цикл экспериментов и обеспечивает прозрачность для стейкхолдеров.
Архитектурные принципы песочниц: разделение плоскостей и модулярность
Помощь в достижении целей бизнеса оказывается через набор архитектурных паттернов и принципов. В песочницах критически важны два плоскости: управляющая (control plane) и вычислительная (data/compute plane). Контрольная плоскость отвечает за создание, настройку и удаление окружений, хранение политик, учет расходов и аудит. Вычислительная плоскость выделяет ресурсы для обработки данных и обучения моделей, при этом данные остаются в изолированной зоне и доступны через контролируемые интерфейсы. Разделение плоскостей minimizes risk, упрощает аудит и позволяет масштабировать одну часть без влияния на другую.
Ключевые принципы:
- модульность и повторяемость: каждое песочное окружение строится по шаблону, который можно повторно использовать и адаптировать под нужды проекта;
- изоляция на уровне сети, вычислений и данных: сетевые сегменты, квоты CPU/памяти, разграничение пространств хранения, политик доступа и маскирования данных;
- единый интерфейс управления: централизованный API или портал, через который инициируются и контролируются окружения;
- политика и аудит: политики доступа, шифрование, журналирование и трассировка действий пользователей и процессов;
- автоматизация жизненного цикла: создание, настройка, обновления, teardown через IaC и CI/CD.
В качестве архитектурных элементов выделяют следующие компоненты:
- Sandbox Manager (плоскость управления): отвечает за оркестрацию окружений, хранение шаблонов и политик, выдачу доступов;
- Data Plane (плоскость данных): изолированные слои хранения и доступа к данным, обеспечивающие защиту данных в песочницах;
- Compute Plane (плоскость вычислений): вычислительные ресурсы, отдельные кластеры или ниши в рамках общего кластера;
- Policy Engine: модуль для реализации политик на различных уровнях (данные, вычисления, доступ);
- Identity and Access Management: единая система управления идентификацией и доступом, поддерживающая многоуровневый контроль.
Совокупность этих элементов должна быть реализована таким образом, чтобы обеспечить гибкость и масштабируемость. В условиях ограничений по времени разработки и ресурсам бизнеса, можно опираться на готовые платформенные решения и стандартные паттерны, которые позволяют ускорить внедрение и минимизировать риск ошибок при настройке песочниц.
Важно подчеркнуть: для технической реализации в рамках профиля technical допустимо приводить упрощённые примеры конфигураций и сценариев интеграции. Приведённые ниже примеры ориентированы на типовые решения и служат иллюстрацией подходов, а не детальной инструкцией по развёртыванию.
- В качестве примеров практических паттернов можно выделить:
- использование отдельных Kubernetes Namespaces для каждого проекта с ограничением RBAC и сетевой сегментации;
- применение данных маскирования и синтетических данных для анализа без риска утечки чувствительных сведений;
- внедрение data catalog и lineage для прозрачности источников и преобразований.
Технологии и продукты, которые часто встречаются в такого рода архитектуре:
- Kubernetes как платформа для изоляции вычислений и управления ресурсами через namespaces, quotas и RBAC;
- HashiCorp Vault как средство управления секретами и шифрования данных в песочницах;
- Kubeflow или Apache Airflow для оркестрации ML-пайплайнов и аналитических рабочих процессов.
Эти примеры не являются обязательной частью каждого проекта, но они демонстрируют реальные подходы к достижению изоляции и скорости доступа. Важнее всего - реализовать прозрачные политики, automatic lifecycle управления и структурированные данные доступа, которые легко проверять и адаптировать к меняющимся требованиям.
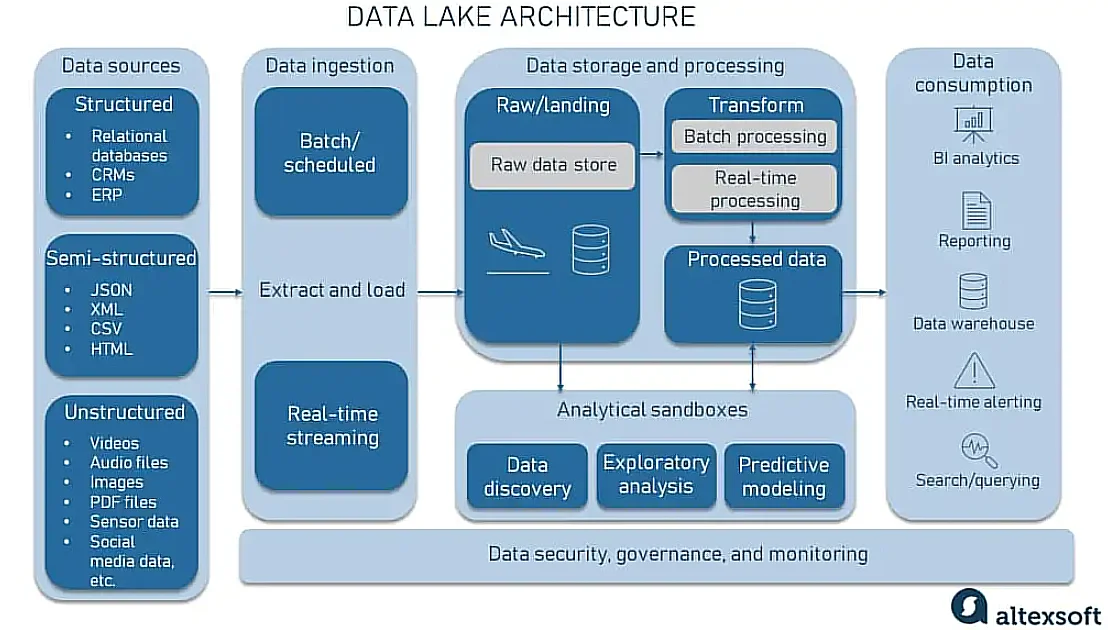
Механизмы изоляции и скорости доступа: баланс между безопасностью и agility
Изоляция в песочницах должна охватывать три ключевых направления: сетевую, вычислительную и данные. Сетевые меры обеспечивают разграничение трафика между окружениями и минимизацию риска эксфильтрации данных. Вычислительная изоляция делает так, чтобы нагрузку и влияние одного проекта нельзя было напрямую перенести на другой. Данные - наиболее чувствительная часть; доступ к ним должен быть строго ограничен контекстом проекта и разрешёнными наборами данных, с применением маскирования и синтетических данных, когда реальный доступ не нужен или риск неприемлем.
- Сетевые аспекты: сегментация, виртуальные частные сети, firewall и правила доступа на уровне подов и сервисов. Выделение отдельных подсетей и применение белых списков помогают ограничить трафик и ускоряют аудит.
- Вычислительная изоляция: квоты CPU/memory, ограничение одновременных задач и приоритизация по проектам. В облаке это может быть достигнуто через ограничения на платформе, например в Kubernetes через лимиты ресурсов и лимитные политики;
- Данные: разграничение прав доступа к наборам данных, хранение данных в изолированных экземплярах и использование маскирования и синтетических данных там, где это возможно. Линейка данных и контроль версий должны быть обеспечены для прозрачности изменений.
С точки зрения скорости доступа и свежести данных, необходимы практики, которые минимизируют задержки и упрощают доступ к данным в рамках песочниц без нарушения изоляционных требований. Это достигается через:
- локальные кеши и кэш-слои, которые ускоряют повторные запросы к данным;
- инкрементальные синхронизации и потоки данных в реальном времени (streaming) с ограничениями по доступу и безопасностью;
- использование материализованных представлений и слоёв хранения, специально подготовленных под песочницы, с учётом политики обновления и жизненного цикла;
- баланс между частотой обновления данных и затратами на их поддержание.
В некоторых случаях применение data virtualization позволяет запросам к разнородным источникам выглядеть как единый источник, что упрощает доступ и ускоряет анализ. Однако данная техника требует строгого контроля над доступом и производительностью, чтобы не привести к «поглощению» ресурсов и не снизить изоляцию.
- Примеры практик по ускорению доступа:
- создание пула зависимостей и зависимых данных для песочниц с готовыми схемами и наборами;
- внедрение механизмов автоматического управления кэшами в зависимости от профиля проекта;
- ограничение запросов к продакшен-источникам через централизованные прокси и политики доступа.
Упоминание внешних инструментов и паттернов:
- Kubernetes и Namespace RBAC - для вычислительной изоляции и управления ресурсами;
- Kubeflow и Apache Airflow - для оркестрации ML-пайплайнов и аналитических задач в песочницах.
Важно помнить, что скорость доступа не должна идти в ущерб безопасности. Принципы дизайна требуют постоянного баланса: увеличение скорости должно сопровождаться усилением мер аудита, контроля доступа и политики управления данными.
Управление данными, безопасностью и соответствием в песочницах
Работы с данными в песочницах требуют тщательного подхода к маскированию, созданию синтетических данных и управлению циклами жизни набора данных. Главный вызов - обеспечить, чтобы исследовательские команды могли полноценно работать с необходимым набором данных, не подвергнув риску конфиденциальную информацию или регуляторные требования. Для этого применяются:
- Маскирование и синтетические данные: чтобы снизить риск обнародования реальных данных, приводится параллельная подмножество, где чувствительные поля скрыты или заменяются сгенерированными значениями, не влияющими на исследование. Это позволяет сохранить смысловую полезность данных, не нарушив требования к приватности.
- Управление данными и линейка происхождения (data lineage): отслеживание источников, преобразований и зависимости даёт возможность доказать соответствие требованиям и воспроизводимость экспериментов.
- Контроль доступа и политики: least privilege и context-aware access - доступ к данным зависит от роли, проекта и стадии жизненного цикла исследования. Внедряются политики хора организаций и политики автоматического аудита.
- Обеспечение соответствия: журналы доступа, мониторинг изменений и хранение их в централизованных хранилищах, доступ к которым ограничен и проверяется аудитом.
Инструменты и подходы к реализации данных аспектов должны быть выбраны с учётом регуляторной базы и инфраструктурных ограничений. В отношении открытых решений могут применяться такие примеры как:
- Open Policy Agent (OPA) в роли централизованного движка политики;
- HashiCorp Vault для управления секретами и шифрованием данных.
Компонентная архитектура для управления данными включает в себя:
- Data Catalog и Metadata Management: каталогизация источников, атрибутов, ограничений и политики доступа;
- Data Quality и Governance: проверки качества и консистентности данных в песочницах, чтобы обеспечить валидность результатов;
- Data Masking и Synthetic Data: безопасные альтернативы для тестирования и моделирования;
- Data Lineage: прозрачность источников, преобразований и потребления данных.
Эти механизмы должны быть встроены в процесс управления песочницами и автоматически применяться к новым средам. В реальной реализации рекомендуется использовать шаблоны и политики как код (policy-as-code), что обеспечивает непрерывную проверку и соблюдение регламентов.
Инфраструктура как код и управление жизненным циклом песочниц
Эффективная автоматизация жизненного цикла песочниц достигается через использование инфраструктуры как код (IaC), шаблонов сред и интеграцию с CI/CD. Управление средами выполняется через параметры шаблонов, которые учитывают требования по изоляции, ресурсам, безопасности и доступу. Важные моменты:
- шаблоны песочниц: поддерживают набор предопределённых конфигураций для разных бизнес-профилей (например, исследователь, дата-инженер, ML-учёный);
- IaC и оркестрация: IaC позволяет быстро создавать и разрушать окружения, поддерживая воспроизводимость и безопасность. Примеры практик включают использование Terraform для инфраструктуры и Kubernetes для вычислений, а также использование контейнеризации и сервиса управления секретами;
- политика как код: политика доступа и безопасности должны быть частью цикла разработки, чтобы любые изменения в конфигурации автоматически проверялись на соответствие требованиям;
- интеграция с CI/CD: автоматизация сборки, тестирования и развёртывания пайплайнов в песочницы, включая этапы проверки соответствия и аудита;
- мониторинг затрат и производительности: отслеживание бюджета песочницы и адаптация ресурсов под загрузку пайплайнов. В какой-то мере это позволяет контролировать стоимость и избежание перерасхода.
Практический пример может включать:
- создание песочного пространства через шаблоны и параметры проекта;
- автоматическую настройку сетевых сегментов, прав доступа и секретов;
- развёртывание ML-пайплайна в песочнице через Kubeflow или Airflow;
- мониторинг и логирование действий пользователей и процессов.
Пример конфигурации IaC (упрощённая иллюстрация) в виде фрагмента
кода:
// Пример упрощённой конфигурации Terraform для песочницы в облаке
provider "aws" {
  region = "us-east-1"
}

variable "project_name" {
  type    = string
  default = "sandbox-ml-project"
}

resource "aws_vpc" "sandbox_vpc" {
  cidr_block = "10.0.0.0/16"
  tags = {
    Name = "${var.project_name}-vpc"
  }
}

resource "aws_subnet" "sandbox_subnet" {
  vpc_id            = aws_vpc.sandbox_vpc.id
  cidr_block        = "10.0.1.0/24"
  availability_zone = "us-east-1a"
  tags = {
    Name = "${var.project_name}-subnet"
  }
}

resource "aws_iam_role" "sandbox_role" {
  name = "${var.project_name}-role"
  assume_role_policy = jsonencode({
    Version = "2012-10-17",
    Statement = [{
      Action = "sts:AssumeRole",
      Effect = "Allow",
      Principal = {
        Service = "ec2.amazonaws.com"
      }
    }]
  })
}
Приведённый фрагмент иллюстрирует базовый набор действий: создание сетевой инфраструктуры и ролей доступа в песочнице. В реальной реализации этот набор расширяют до полноценных шаблонов, включающих конфигурации Kubernetes, сервисов мониторинга, политики доступа и механизмов секретов. Важно, чтобы такие конфигурации проходили проверки на соответствие политикам безопасности, а их развёртывание происходило через CI/CD пайплайны с обязательной трассируемостью и аудитом.
В отношении инструментов (open-source и российских продуктов) можно отметить два примера, которые часто применяются в рамках песочниц:
- Terraform как инструмент IaC, обеспечивающий воспроизводимость и контроль версии;
- Kubernetes как платформа вычислений и изоляции, поддерживающая namespace-based изоляцию и RBAC. Указанные инструменты хорошо подходят для основанной на принципе повторного использования архитектуры.
Key takeaways
- Песочницы должны быть проектно выстроены вокруг бизнес-целей: ускорение инсайтов, безопасность, соответствие и управляемость расходов.
- Изоляция в песочницах охватывает сеть, вычисления и данные; архитектура должна поддерживать управляемость и аудит.
- Архитектура песочниц требует разделения управляющей и вычислительной плоскостей, единых интерфейсов управления и политики.
- Для скорости доступа применяются кеширование, инкрементальные обновления, ленточная выгрузка и виртуализация данных с учётом ограничений по безопасности.
- Управление данными включает маскирование, синтетические данные и линейку данных; политики и аудит должны быть встроены в жизненный цикл среды.
- IaC и CI/CD позволяют автоматизировать создание, обновление и удаление песочниц, обеспечивая воспроизводимость и контроль затрат.
FAQ
- Что такое песочница в контексте DWH и ML-аналитики?
- Песочница - это изолированная, управляемая среда для анализа данных и обучения моделей, отделённая от продакшен-окружения. Она обеспечивает безопасное тестирование гипотез, демонстрацию результатов и обучение сотрудников без риска воздействия на работу продакшена. Ключевые преимущества - воспроизводимость, контроль доступа и возможность экспериментирования с различными наборами данных и инструментами. В рамках песочниц используются конкретные политики, которые гарантируют соответствие требованиям по безопасности и приватности.
- Какие бизнес-цели наиболее часто приводят к внедрению песочниц?
- Основные цели: ускорение цикла анализа и экспериментов, повышение воспроизводимости исследований, снижение операционных рисков и задержек, обеспечение соответствия регуляторным требованиям, улучшение прозрачности и управляемости процессов. Песочницы позволяют тестировать новые подходы к моделированию в изолированной среде, не влияя на качество и доступность данных в продакшен. Они также становятся площадкой для обучения сотрудников и развития аналитической культуры компании.
- Какие типы изоляции применяются в песочницах и зачем они нужны?
- Основные типы: сетевой, вычислительной и данных. Сетевой изоляционный слой ограничивает перемещение трафика между песочницами и продакшеном; вычислительная изоляция ограничивает ресурсы и влияние одного проекта на другой; изоляция данных обеспечивает контроль доступа к данным, защиту конфиденциальной информации, а также возможность использования масок и синтетических данных. Правильная реализация снижает риск утечки данных, упрощает аудит и обеспечивает предсказуемое поведение вычислительной инфраструктуры.
- Как обеспечить баланс между изоляцией и скоростью доступа к данным?
- Баланс достигается через архитектурные паттерны: разделение плоскостей управления и вычислений, кэширование, локальные и инкрементальные обновления данных, а также выбор подходящих слоёв хранения. Важно предусмотреть политики обновления данных и механизмы доступа к данным через единый интерфейс, который учитывает требования по изоляции. Использование data virtualization и материализованных представлений может повысить скорость доступа, не нарушив ограничения по данным и безопасности.
- Какие паттерны архитектуры чаще всего применяются для песочниц?
- Чаще встречаются: per-project песочницы (отдельные пространства для команд), ephemeral-песочницы (которые создаются и удаляются по жизненному циклу пайплайнов), және shared-data-песочницы с контролируемым доступом к наборам данных. В реализации применяются управляющие сервисы (контроллеры) и плоскость вычислений, разделение политик и интерфейсов, а также внедрение политики как код. В качестве инструментов часто используются Kubernetes для изоляции вычислений и Kubeflow или Apache Airflow для оркестрации.
- Как управлять данными в песочницах при соблюдении приватности и соответствия?
- Вопрос приватности решается за счёт маскирования, синтетических данных и ограничения доступа к чувствительным данным. Линейка данных и аудит позволяют проследить источники и преобразования. В рамках соответствия применяются политики доступа на основе ролей и контекста проекта, контроль версий и аудит действий пользователей и пайплайнов. Важно обеспечить прозрачность и контролируемость для регуляторов и аудитов.
- Какие инструменты чаще всего применяются для реализации песочниц?
- В контексте открытых решений и индустриальных практик можно отметить: Kubernetes как базовую платформу для изоляции и управления ресурсами, Kubeflow или Apache Airflow для оркестрации ML/аналитических пайплайнов, и политика как код через Open Policy Agent (OPA) или управляемые решения для обеспечения соответствия и контроля доступа. В рамках секретообеспечения часто применяют HashiCorp Vault. Эти примеры показывают реальные подходы к реализации песочниц без перегрузки перечнем инструментов.


