

Инфраструктура и технологический стек: облако, локальная платформа, гибридные решения
Песочница данных в рамках корпоративной data-платформы требует продуманной инфраструктуры, которая обеспечивает изоляцию и воспроизводимость сред, при этом оставаясь гибкой к бизнес-задачам в области SQL, BI и ML. В данном контексте критически важны выбор модели размещения (облако, локальная платформа или гибрид), архитектурные принципы слоистости и категорий услуг, а также возможность эффективной интеграции между өңисами данных, вычислительными ресурсами и инструментарием анализа. В этой главе рассматриваются архитектура, принципы развёртывания и технологический стек, который позволяет поддерживать безопасную, управляемую и экономически эффективную песочницу, пригодную для быстрого прототипирования, повторяемой разработки и контрольного тестирования гипотез.
Для успешной реализации инфраструктуры песочницы необходимо соединять технические решения с управленческими требованиями: соответствие регуляторным нормам, прозрачность затрат, контроль доступа и аудит, а также возможность масштабирования от локального стенда до глобальной облачной среды. Важно помнить, что инфраструктура не является самоценной целью: она должна обеспечить надежную основу для развёртывания SQL-скриптов, BI-пайплайнов и ML-моделей в условиях ограничений по времени отклика, объёму данных и требованиям к изоляции окружений.
- Архитектура песочницы данных: принципы, слои и контрактная совместимость между компонентами.
- Размещение и модели эксплуатации: облако, локальная платформа, гибрид и соответствующие паттерны управления затратами и латентностью.
- Технологический стек: вычисления, хранение, инструменты анализа и принципы интеграции.
- Безопасность, управление доступом и соответствие требованиям, включая аудит и ретроспективную воспроизводимость.
- Управление жизненным циклом песочницы: инфраструктура как код, развёртывание сред и контроль версий.
Архитектурные принципы инфраструктуры песочницы данных
Архитектура песочницы должна быть разделена на несколько изолированных слоёв, каждый из которых отвечает за свою роль: хранение данных, вычисления и анализ, окружения разработки и воспроизводимости, а также управление доступом и безопасностью. Основной концептуальной единицей выступает песочничный контур, который включает в себя изолированное пространство данных, вычислительную среду и набор инструментов для обработки, анализа и моделирования. Такой подход обеспечивает воспроизводимость экспериментов и защищённость данных в условиях совместной работы множества команд.
Ключевые принципы включают:
- Модульность и разделение ответственности: каждый компонент отвечает за свою задачу: хранилище - данные, вычисления - SQL-движки и фреймворки машинного обучения, аналитика - BI-инструменты и визуализация, управление окружениями - оркестрация и контроль доступа.
- Изоляция и воспроизводимость: среда разворачивается как изолированная копия рабочей среды с фиксированными версиями инструментов и данных, что позволяет проводить экспериментальные серии без риска влияния на другие проекты.
- Контракты между слоями: чёткие API и схемы данных позволяют модулям взаимодействовать без тесной связанности, упрощая миграцию, обновления и тестирование.
- Эластичность и устойчивость: поддержка горизонтального масштабирования как для вычислительных мощностей, так и для хранения данных; автоматическое восстановление после сбоев и откат к ранее зафиксированным состояниям.
- Контроль качества и соответствие: внедрение стандартов ведения данных, мониторинга качества и аудита доступа на уровне каждого окружения и всего контура.
В контексте технического решения важно подчеркнуть, что архитектура должна оставаться нейтральной по отношению к конкретным поставщикам и продуктам, чтобы не создавать жесткую привязку к одному стэку при необходимости миграции или масштабирования. При этом реальная реализация неизбежно сочетает набор конкретных паттернов и инструментов, которые соответствуют корпоративным требованиям и бюджету проекта.
Модели размещения: облако, локальная платформа, гибрид
Размещение инфраструктуры песочницы может быть реализовано в трёх базовых моделях: полностью облачное, локальное развёртывание на собственной инфраструктуре и гибридное решение, сочетающее оба подхода. Выбор модели определяется требованиями к задержке, управляемости, регуляторике, стоимости владения и уровню контроля над данными. В корпоративном контексте наиболее часто встречаются гибридные сценарии, где чувствительные данные остаются на локальном стекe, а вычислительные задачи и аналитический слой эластично масштабируются в облаке.
- Облако как платформа для быстрого масштабирования: облачные сервисы позволяют быстро разворачивать новые песочницы, предоставлять вычислительную мощность по требованию и централизованно управлять обновлениями. В этом случае рекомендуется использовать управляемые сервисы данных и аналитики, которые упрощают администрирование и снижают временные затраты на настройку окружений. Примеры паттернов включают мультиоблачную стратегию и разделение между вычислительным и хранением слоев, что позволяет оптимизировать стоимость и регуляторные требования.
- Локальная платформа для контроля над данными и соблюдения требований: on-prem-развертывания важны там, где существуют строгие требования к резидентности данных, низкой задержке и полному контролю над инфраструктурой. Здесь критически важны решения по управлению сетями, безопасному доступу и совместному использованием данных внутри корпоративного периметра. Современные локальные подходы включают использование контейнеризации и оркестрации на базе Kubernetes, а также гибридные хранилища, которые позволяют сохранять данные локально, но извлекать вычислительную мощность в облаке по мере необходимости.
- Гибридные решения как компромисс между безопасностью и масштабируемостью: они позволяют сохранить чувствительные данные внутри корпоративной сети, но выносить вычисления и экспериментальные пайплайны в облако. В таком случае важны паттерны data gravity, кэширования и синхронизации метаданных, а также единая политика Identity and Access Management (IAM) и единые протоколы безопасного доступа к данным из облачных и локальных окружений.
Примерные паттерны интеграции между моделями размещения:
- Использование облачных окружений как дополнительных сред для обучения и тестирования ML-моделей при сохранении критичных данных на локальной платформе.
- Разделение стадий пайплайна: данные в локальных сегментах, вычисления и агрегации в облаке, представление в BI-средах на краю сети.
- Воспроизведение среды на разработческих машинах через управляемые окружения, которые заранее настроены под конкретный проект и версию инструментов.
В рамках технического подхода к гибридным сценариям особое внимание уделяется согласованию версий инструментов, совместимости data contracts и согласованию политик безопасности между локальным and облачным контекстами. Ряд корпоративных клиентов выбирают стратегию использования нескольких облачных провайдеров (multi-cloud) для снижения зависимости от одного поставщика и повышения устойчивости к перебоям; это требует единых стандартов телеметрии, мониторинга и управления конфигурациями.
Технологический стек и интеграции
Технологический стек песочницы должен обеспечивать три базовых слоя: хранение данных, вычисления и аналитика, а также окружения разработки и эксплуатации. В сочетании они образуют единую экосистему, в которой SQL-слой, BI-инструменты и ML-платформы работают согласованно, хранение данных поддерживает управляемость и качество, а окружения разворачиваются быстро и повторяемо.
- Хранилище и данные: в песочнице применяются подходы к хранению данных на слое озвучивания как Data Lake/Delta Lake или аналогичные решения, поддерживающие версии данных и транзакционность. В рамках open-source и частных решений часто встречаются Apache Hudi, Delta Lake и Iceberg как слои управления версиями и патчами в большом объёме данных. Применение этих технологий позволяет осуществлять тикетный доступ к изменениям, откаты и воспроизводимость пайплайнов.
- Вычисления и движки: для SQL-анализа и подготовки данных применяют современные движки - Trino/Presto, Apache Spark и столпы облачных решений вроде Snowflake или Azure Synapse. Разумная комбинация этих движков обеспечивает баланс между производительностью, совместимостью SQL-диалектов и стоимостью эксплуатации. В локальном контексте часто применяют Spark на Kubernetes или управляемые решения, а в облаке - сервисы с быстрым временем старта и масштабированием.
- ML и аналитика: ML-платформы, например MLflow или Kubeflow, позволяют организовать жизненный цикл моделей, от прототипирования до продакшн-эксплуатации. В песочнице важна интеграция с данными слоями и возможностью переподготавливать обучающие датасеты на основе версии данных. Это обеспечивает воспроизводимость экспериментов и чистую миграцию моделей между окружениями.
- BI и представление: для визуализации и аналитических панелей применяют BI-инструменты, которые умеют подключаться к различным источникам данных: SQL-слой, датасеты и визуализации. В рамках корпоративной песочницы ценится возможность независимого доступа к данным через ETL/ELT пайплайны, а также поддержка самоподдерживаемых визуализаций в безопасной среде.
- Управление окружениями и интеграции: оркестрация и управление окружениями выполняются через инструменты инфраструктуры как код и GitOps-подходы. В реальной практике применяется Terraform, Helm и Kubernetes Operators для разворачивания песочниц; конфигурации окружающих сервисов хранятся в системах контроля версий, обеспечивая прозрачность изменений и возможность отката к стабилизированным версиям окружения.
Правильная интеграция между слоями требует формирования контрактов между компонентами: схемы данных, версии API и соглашения по форматам данных должны быть зафиксированы и документированы. Это особенно важно в многопользовательских средах, когда одновременно разворачиваются несколько проектов и версий пайплайнов. Применение унифицированных схем и контрактов упрощает миграции, обновления и совместную работу команд аналитиков, инженеров данных и специалистов по ML.
Рассматривая примеры технологий, можно упомянуть следующие: в облачном контексте - управляемые сервисы для хранения и вычислений, такие как облачные Datalake и Data Warehouse, которые поддерживают версии и безопасный доступ; в локальной платформе - контейнеризация и оркестрация на Kubernetes, локальные хранилища с поддержкой версий и репликации; в гибридном сценарии - инструменты синхронизации и кэширования, единые политики безопасности и унифицированная телеметрия.
Важно помнить о практиках оптимизации затрат и управлении латентностью. Гибридные конфигурации часто требуют стратегий, которые минимизируют перемещение больших объёмов данных между облаком и локальной инфраструктурой. Эффективные паттерны включают:
- выбор наиболее близких к источнику данных вычислительных сред, чтобы снизить задержку;
- кэширование популярных наборов данных на периферии инфраструктуры;
- использование эффективных форматов хранения и сжатия, чтобы уменьшить объём передаваемых данных;
- мониторинг и автоскейлинг для обеспечения устойчивости к пиковым нагрузкам.
Безопасность, управление доступом и соответствие требованиям
Безопасность и соответствие - это базовые требования к любой корпоративной песочнице. Архитектура должна поддерживать методологии нулевого доверия, строгий контроль доступа и безопасный обмен данными между слоями. В рамках технических решений особое внимание уделяют управлению удостоверениями, секретами и доступом к данным, а также аудиту действий пользователей и сервисов.
- Управление доступом: реализуется через централизованный IAM, способный управлять ролями и правами на уровне отдельных окружений и на уровне конкретных наборов данных. Важно внедрить RBAC для каждого слоя: данные, вычисления, пайплайны и визуализация. Дополнительно применяются политики сегментации сети и модули сетевой безопасности, которые ограничивают трафик между окружениям и уменьшают поверхность атаки.
- Безопасное хранение секретов: секреты и ключи доступа хранятся в специализированных системах управления секретами и проходят прозрачное аудирование. В корпоративной практике применяют аппаратно-защищённые модули и поддерживаются политики автоматического вращения секретов и минимизации прав доступа.
- Управление данными и аудит: данные должны иметь полную трассируемость, включая lineage, версионность и контроль изменений. Это обеспечивает возможность воспроизведения экспериментов и аудита соответствия требованиям. Хранилища и слои вычисления должны поддерживать хранение исторических копий и возможность отката к стабильным версиям данных и моделей.
- Соответствие требованиям и регуляторика: в зависимости от отрасли применяются стандарты конфиденциальности и обработки персональных данных (например, регуляции о защите данных, требования к хранению и обработке чувствительных данных). Архитектура должна обеспечивать целостность политики хранения данных, соответствие требованиям к аудиту и сохранность информации в течение заданных сроков.
Безопасность не должна сдаваться в пользу скорости развития; наоборот, безопасная по архитектуре песочница облегчает масштабирование, позволяет снизить риски и ускоряет принятие решений через уверенность в управляемости среды. В этом контексте ключевое значение имеют единые политики и прозрачность систем мониторинга и аудита, что позволяет быстро выявлять аномалии и реагировать на инциденты.
Управление данными и жизненный цикл песочницы
Управление данными и жизненным циклом песочницы включает в себя процессы развёртывания, обновления, мониторинга и закрытия окружений. Эффективная методология обеспечивает повторяемость экспериментов, упрощает передачу знаний между командами и снижает операционные риски. В практике применяют следующие принципы:
- Инфраструктура как код и GitOps: развёртывание окружений и конфигураций осуществляется через кодовые артефакты, хранящиеся в системе контроля версий. Это обеспечивает прозрачность изменений, возможность отката и воспроизводимость окружений в рамках разных проектов.
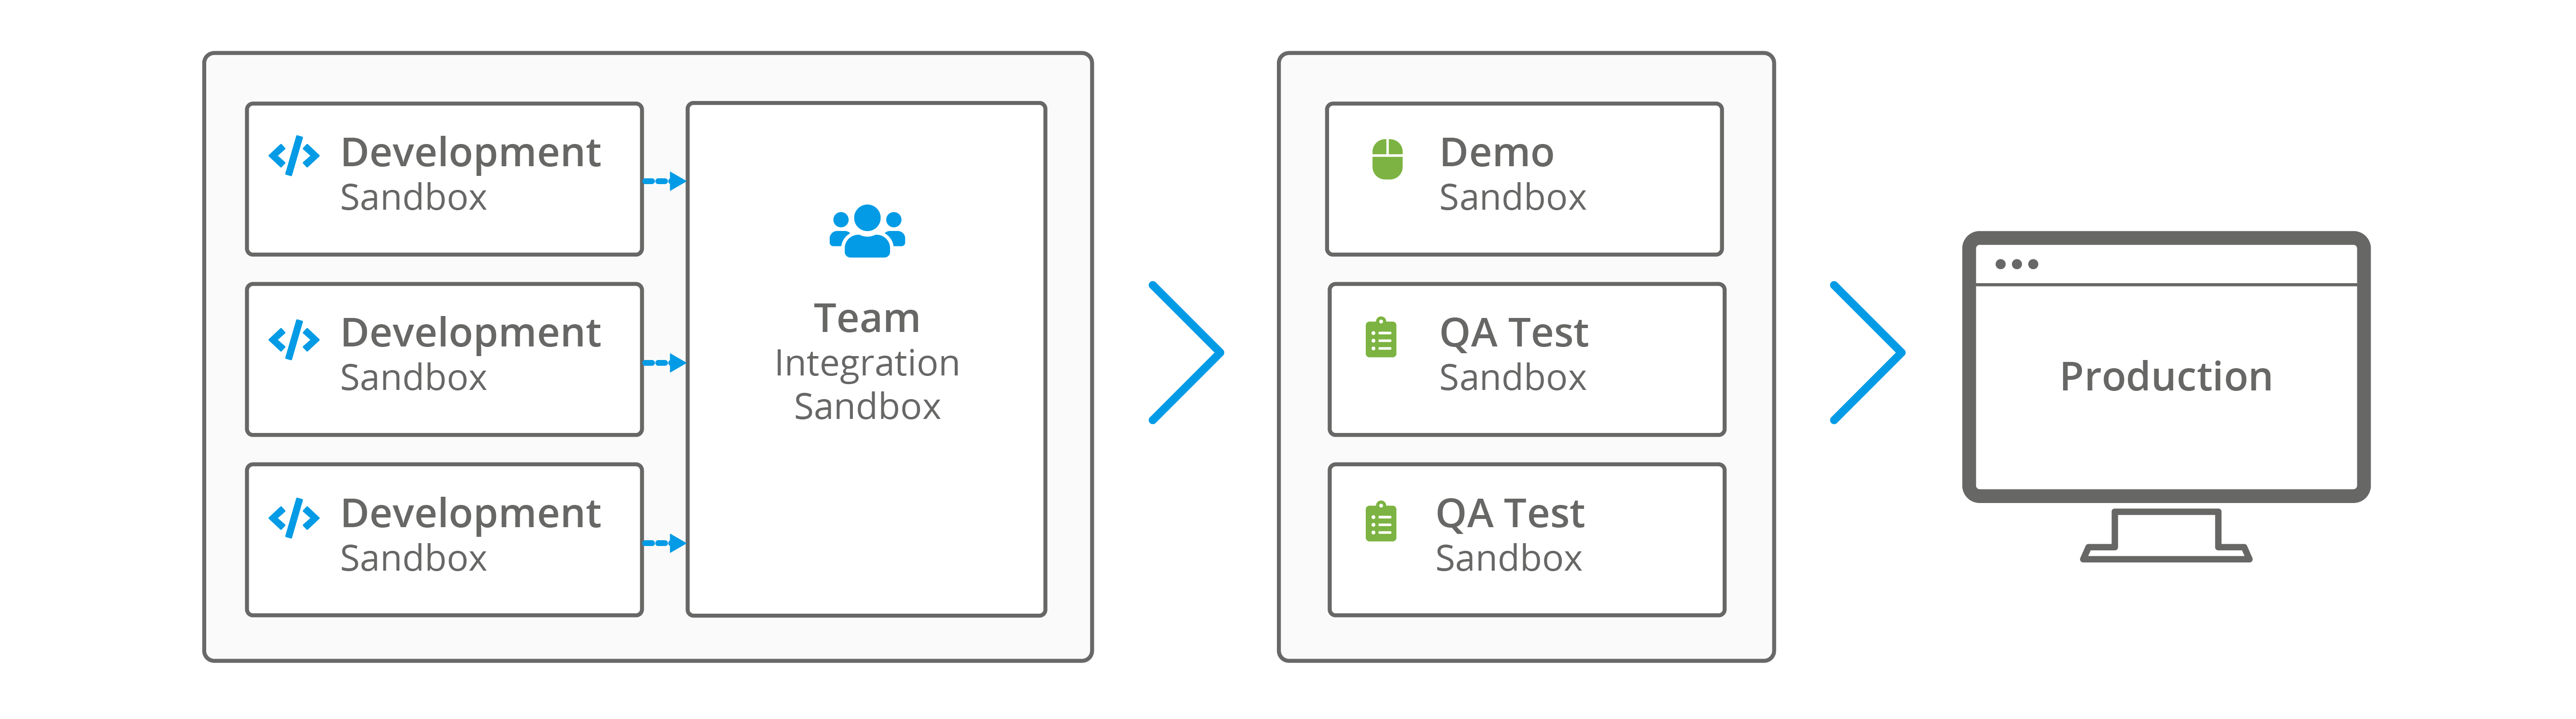
- Эпизодические окружения и ephemeral-подход: песочницы создаются по требованию и очищаются по завершению задачи. Такой подход экономически выгоден и упрощает тестирование гипотез без накопления "мусора" в инфраструктуре.
- Управление версиями данных и моделей: каждое изменение в данных и обученной модели сопровождается манифестами версий. Это обеспечивает возможность агрегации повторяемых пайплайнов и повторного воспроизведения результатов.
- Контроль затрат: внедряются политики ограничения затрат и мониторинг использования ресурсов. В гибридной и облачной среде это особенно важно для предотвращения перерасхода и для планирования бюджета.
- Автоматизация пайплайнов и CI/CD для данных: пайплайны тестируются на изолированных копиях данных, затем продвигаются в продукцию после прохождения автоматических проверок качества и соответствия требованиям.
Эти принципы позволяют поддерживать устойчивое развитие песочницы: новые источники данных, новые вычислительные паттерны и новые аналитические сценарии внедряются без нарушения существующего развёртывания, а процедура миграций и откатов остаётся понятной и контролируемой.
Key takeaways
- Инфраструктура песочницы должна быть модульной, обеспечить изоляцию и воспроизводимость окружений.
- Выбор модели размещения (облако, локальная платформа, гибрид) определяется требованиями к задержке, безопасности и регуляторике.
- Технологический стек следует строить вокруг трёх слоёв: хранение данных, вычисления и аналитика, окружения разработки - с едиными контрактами между ними.
- Безопасность и управление доступом должны быть встроены на уровне архитектуры, включая IAM, управление секретами, аудит и соответствие требованиям.
- Управление жизненным циклом окружений через инфраструктуру как код, ephemeral-окружения и версионность данных обеспечивает повторяемость и экономию.
- Гибридные стратегии требуют эффективной синхронизации данных, контроля трафика и унифицированных политик между облаком и локальной инфраструктурой.
- Применение открытых и проверенных open-source решений в рамках разумной совокупности инструментов снижает риски зависимости и ускоряет внедрение.
FAQ
- Как выбрать оптимальную модель размещения для песочницы в рамках крупной организации?
Выбор зависит от регуляторных требований, требований к задержке и доступности, а также бюджета. Если есть строгие требования к резидентности данных и низкие задержки внутри периметра, стоит рассмотреть локальную платформу с возможностью безопасного доступа к вычислениям в гибридном режиме. Для быстрой масштабируемости и экспериментов без значительных вложений в инфраструктуру - облако, с применением многоблочных паттернов развертывания и управляемых сервисов. Гибридное решение часто сочетает оба подхода, позволяя держать чувствительные данные локально, но выносить вычисления и тестовые среды в облако. Важно иметь единые контракты данных и единый подход к управлению доступом, чтобы взаимодействие между окружениями было безопасным и предсказуемым.
- Какие принципы архитектуры обеспечивают воспроизводимость экспериментов в песочнице?
Ключевые принципы включают изолированные окружения, фиксированные версии инструментов и данных, контрактные API между слоями и прозрачную систему версий. Воспроизводимость достигается через хранение метаданных об окружении, версиях пайплайнов и данных, а также через использование инфраструктуры как код и GitOps для развёртывания окружений. Это позволяет повторно выполнить пайплайны на идентичных условиях и сравнить результаты между разными экспериментами.
- Какие паттерны интеграции между SQL, BI и ML считаются самыми эффективными?
Эффективной считается связка: надежный слой хранения данных с поддержкой версий и транзакционности, мощный движок вычислений (например, Trino/Spark) для SQL-аналитики и подготовки датасетов, а также ML-платформу с полным циклом жизненного цикла моделей. Интеграция осуществляется через общие форматы данных, стандартизованные словари и контракты между слоями. BI-инструменты получают доступ к подготовленным данным через стандартизированные представления, что обеспечивает единый источник правды и упрощает аудит изменений.
- Какие подходы минимизируют задержку в гибридной инфраструктуре?
Минимизация задержки достигается за счет размещения наиболее чувствительных к latency компонентов ближе к пользователю или внутри локального периметра, применения кэширования часто запрашиваемых наборов данных, использования форматов хранения с высокой производительностью чтения и эффективного обмена данными между облаком и локальной средой. Также важно проектировать пайплайны так, чтобы вычисления с высокой задержкой выполнялись в облаке без необходимости повторной передачи больших объёмов, а результаты кэшировались локально для повторного использования.
- Как обеспечить безопасность и соответствие требованиям в песочнице без снижения скорости разработки?
Необходимо внедрить единый IAM, управление доступом через RBAC на уровне окружений и данных, а также системы аудита и мониторинга действий пользователей и сервисов. Кроме того, применяйте политики минимальных прав и секрет-менеджмент с автоматическим вращением ключей. Весь процесс разработки и развёртывания окружений следует автоматизировать через инфраструктуру как код, чтобы изменения регистрировались и могли быть откатаны при необходимости. Это сочетание обеспечивает баланс между безопасностью и скоростью внедрения.
- Какие open-source решения стоит рассмотреть в рамках российского и международного контекста?
Из открытых экосистем наиболее часто применяют Apache Spark, Apache Hudi или Iceberg для управления версиями данных, а также Trino (ранее Presto) как гибкий SQL-движок для федеративного доступа к данным в разных хранилищах. В российском контексте полезны разработки вроде Yandex DataSphere, которые предлагают интеграцию с локальными и облачными сервисами. В любом случае рекомендуется выбирать продукты с активной поддержкой сообщества, понятной документацией и совместимостью с требованиями вашего стека и регуляторной среды.
- Как организовать управление окружениями в рамках большого портфеля проектов?
Необходимо установить единый процесс развёртывания окружений через инфраструктуру как код и GitOps. Каждое окружение должно иметь чётко зафиксированные версии инструментов, конфигурации сетей и политики безопасности. Разделение окружений по проектам и по типам задач (разработка, тест, продакшн) упрощает управление ресурсами и снижает риск пересечения сред. Эффективна практика ephemeral-сред, которые создаются под конкретную задачу и удаляются по её завершению.
- Как обеспечить переносимость песочницы между облаками и локальной платформой?
Необходимо поддерживать унифицированные форматы данных, общие контракты и единое управление доступом вне зависимости от конкретного провайдера. Важно минимизировать различия в версиях инструментов между окружениями и обеспечить согласованность версий пайплайнов. Используйте инфраструктуру как код и инфраструктурные модули, которые абстрагируют конкретного провайдера, что упрощает миграцию и переносимость.
- Какие меры по мониторингу и управлению рисками критически важны?
Важны мониторинг использования ресурсов, задержек на каждом шаге пайплайна, качество данных и соответствие требованиям к аудиту. Наличие дашбордов по затратам и доступам к данным позволяет своевременно выявлять аномалии и предотвращать инциденты. Регулярные аудиты и ретроспективы по архитектуре помогают обновлять политики безопасности и соответствие меняющимся регуляторным требованиям.
- Как интегрировать песочницу с существующими корпоративными системами?
Интеграцию выполняют через принятые в организации контракты по данным и API. Необходимо обеспечить единый каталог метаданных и согласованные политики доступа между песочницей и основными системами управления данными, BI и ML. Важно поддерживать совместимость форматов и версий, чтобы данные и модели могли безопасно переходить между песочницей и производственными окружениями без потери аудита и воспроизводимости.


