

Терминология Hadoop: HDFS, YARN, MapReduce, блоки, репликация
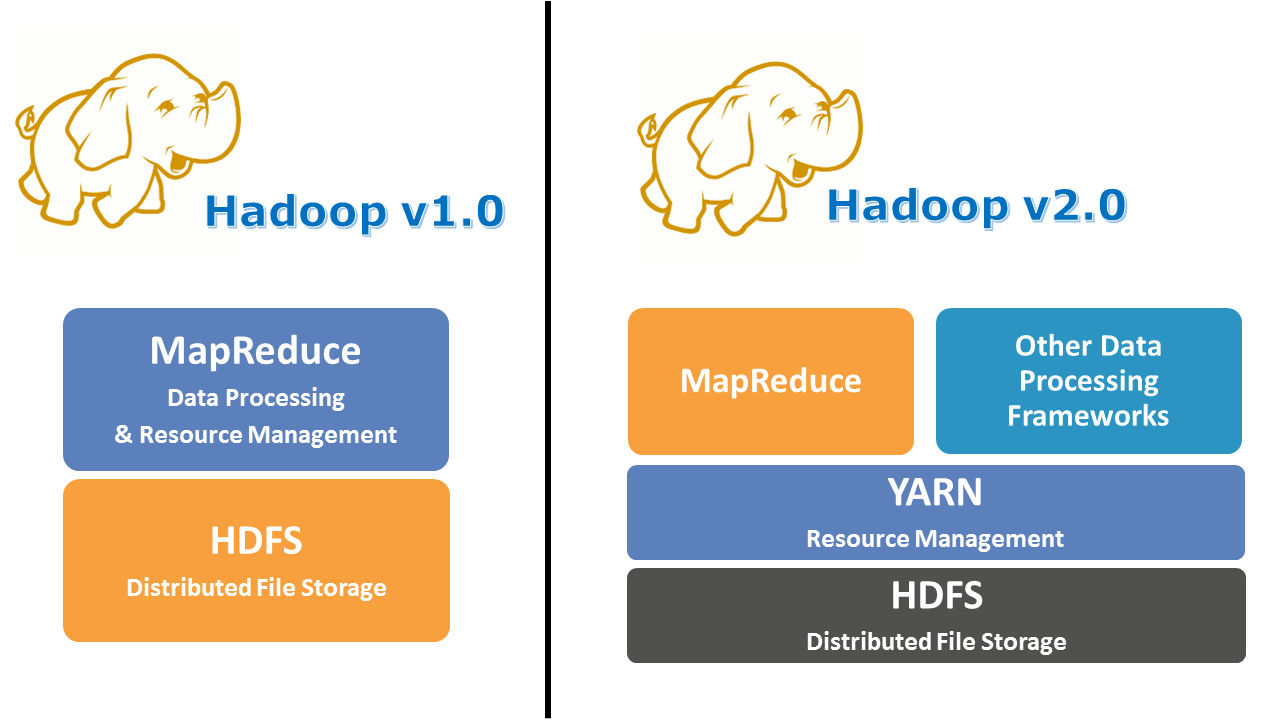
Hadoop-инфраструктура опирается на три базовых компонента: HDFS для хранения данных, YARN для управления ресурсами и выполнения задач, а также MapReduce как один из вычислительных парадигм внутри экосистемы. В данной главе рассматриваются концепции и термины, которые необходимы для понимания архитектуры Hadoop-экосистемы, с акцентом на принципы хранения, управления и исполнения вычислений. В качестве связующего элемента обсуждаются блоки данных, механизмы репликации, топология размещения и протоколы взаимодействия между компонентами, которые обеспечивают устойчивость, масштабируемость и производительность систем больших данных.
Hadoop-архитектура строится как совокупность взаимосвязанных слоев, где каждый из компонентов выполняет прикладную функцию, но без синхронной зависимости от конкретной реализации задач в приложениях. Важно понять, что выбор параметров конфигурации и стратегия размещения данных напрямую влияют на латентность доступа, пропускную способность сети и устойчивость к сбоям. Эта глава помогает выработать единый язык терминов и дать основу для принятия решений на уровне проектирования, внедрения и эксплуатации Hadoop-решений.
- Обозначение основных компонентов и их роли: HDFS, YARN, MapReduce, репликация и топологии данных.
- Понимание принципов работы блоков, их размера, репликации и влияния на отказоустойчивость.
- Взаимодействие между слоями: какие протоколы используются, как обеспечивается согласованность метаданных и данных.
- Практические аспекты конфигурации, безопасности и миграций.
HDFS: архитектура хранения, блоки и репликация
HDFS служит распределённой файловой системой, спроектированной для хранения больших файлов и обеспечения эффективного чтения больших объемов данных. Основная идея состоит в том, что файл разбивается на последовательности блоков фиксированного размера, которые хранятся на узлах DataNode. Роль контрольной «мозговой» единицы возложена на NameNode, который хранит метаданные файловой системы: маппинги путей к блокам, целостность пространства имён и состояние блоков. Такой раздел труда позволяет NameNode оперировать с малым объёмом данных в памяти для быстрого доступа к метаданным, в то же время перемещая сами блоки по DataNode в рамках заданной политики репликации.
Блоки данных и их роль
Блоки являются базовой единицей хранения в HDFS. Размер блока по умолчанию существенно влияет на пропускную способность и латентность доступа к файлам. В современных конфигурациях чаще всего используются блоки размером 128 MB или даже 256 MB, что снижает количество отдельных запросов к NameNode и упрощает управление данными. При этом большое число мелких файлов приводит к оверхеду из-за множества блоков и метаданных, поэтому практика нередко предусматривает агрегацию мелких файлов либо использование подходов, таких как SequenceFile или HAR-файлы для оптимизации.
Блоки в HDFS обладают свойствами устойчивости к нештатным сбоям: они реплицируются на несколько DataNode, чтобы обеспечить доступность данных даже при выходе из строя части узлов. Репликация идёт не только в пределах одного узла, но и по разным стойкам и/или топологиям сети, что снижает риск одновременного выхода из строя всех реплик из-за сбоя сетевой инфраструктуры или энергопитания в конкретной стойке.
NameNode и DataNode: роли и жизненный цикл
NameNode отвечает за управление файловой системой: хранит файловую таблицу, маппинг файлов на блоки и их расположение по DataNode. В традиционной реализации NameNode является критическим узлом: в случае его отказа доступ к файловой системе может быть ограничен. Управление отказами достигается через незаменяемость узла или через механизмы высокой доступности, такие как Active/Standby режим NameNode и журналирование через JournalNode (Quorum Journal Manager).
DataNode - это локальные хранилища блоков на каждом узле кластера. DataNode отвечает за запись, чтение и передачу блоков по запросам клиентов или NameNode. DataNode периодически отправляет heartbeat NameNode и сообщает о состоянии блоков посредством Block Reports. При отсутствии связи с NameNode DataNode продолжает обслуживать запросы только по локальным данным в рамках допустимого кэширования, но для полноценной корректности кластера необходим обмен метаданными и сведениями о блоках.
Репликация и размещение блоков
Репликация - механизм, обеспечивающий устойчивость к отказам и сбоям в сети и отказывающих узлах. Значение replication-factor задаёт количество копий каждого блока. Типичные значения - 3, что обеспечивает устойчивость к выходу из строя одного DataNode или целой стойки. Репликация распределяется с учётом топологии сети: блоки размещаются таким образом, чтобы реплики располагались на разных DataNode и, предпочтительно, в разных стойках. Это позволяет минимизировать риск одновременного выхода из строя нескольких копий из-за физических факторов, влияющих на конкретную стойку.
Важно отметить концепцию rack awareness: размещение реплик с учётом топологии сети, дающее преимущества при чтении данных за счёт локальности загрузки. В рамках более новых версий HDFS поддерживаютсяAdvanced функции, такие как эрозийное кодирование (erasure coding) для больших массивов хранения в отдельных условиях, где репликация становится экономически затратной. Однако эрозийное кодирование применяется не ко всем типам данных и требует иной подход к чтению и реконструкции файлов.
Высокая доступность и безопасность
Для обеспечения непрерывности бизнеса существует ряд механизмов: High Availability (HA) NameNode, журналирование изменений и синхронное переключение между активным и резервным NameNode. Журнальные механизмы, например, Quorum Journal Manager, позволяют синхронно реплицировать FSImage и EditLog на несколько узлов, что обеспечивает быстрый переход между активным и пассивным NameNode в случае сбоя. Безопасность кластера достигается за счёт аутентификации и авторизации, часто через Kerberos, а также через политические разделения доступа к данным и ключевым метаданным.
Эволюция и практики настройки
Современные кластеры Hadoop поддерживают гибкую конфигурацию параметров: размер блока, фактор репликации, политика размещения блоков и параметры HA. В практике проектировщики учитывают требования к задержке доступа и пропускной способности, а также планируемый объём данных и долговременное хранение. В крупных внедрениях допустимо сочетать HDFS с альтернативами по хранению больших данных, например, интеграции с облачными хранилищами или локальными системами хранения, чтобы обеспечить гибридную стратегию хранения. В рамках начального этапа проекта следует определить целевые требования к доступности, размеры кластера и дорожную карту миграций, чтобы минимизировать риски перехода к новой архитектуре.
YARN: управление ресурсами и планирование
YARN служит ядром вычислительной части Hadoop, разделяя роль планирования ресурсов и выполнения задач между несколькими компонентами. В этой архитектуре ресурсы распределяются и управляются независимо от конкретной модели вычисления, что позволяет интегрировать MapReduce, Spark и другие вычислительные модели под единым управлением кластера. Основная идея - эффективное использование ресурсов и координация выполнения задач в средах с большой степенью параллелизма.
Архитектура YARN
Компоненты YARN включают:
- ResourceManager - центральный компонент управления ресурсами кластера. Он отвечает за планирование задач, распределение ресурсов между приложениями и мониторинг их статусов.
- NodeManager - агент на каждом вычислительном узле, реализующий управление контейнерами, мониторинг ресурсов и выполнение задач.
- ApplicationMaster - управляющий процесс для каждого конкретного приложения. Он координирует этапы выполнения, запросы ресурсов и управление жизненным циклом контейнеров.
Очевидное преимущество YARN в том, что он отделяет обработку данных от управления ресурсами, что позволяет гибко масштабировать как локальные, так и облачные вычисления, поддерживая множество моделей выполнения.
Контейнеры и жизненный цикл
Задачи в кластере Hadoop запускаются внутри контейнеров, которые выделяются из ресурсов узла и контролируются NodeManager. ApplicationMaster запрашивает у ResourceManager необходимое количество контейнеров, затем распределяет их между задачами конкретного приложения. Этот механизм обеспечивает изоляцию процессов, контроль за использованием CPU, памяти и сетевых ресурсов, а также упрощает мониторинг и повторное выполнение в случае сбоев.
Планирование и политики
Планирование в YARN может применяться через разные политики: FIFO, Capacity Scheduler и Fair Scheduler. FIFO подходит для простых сценариев и серийной обработки, в то время как Capacity Scheduler обеспечивает продвинутую конвейерность в многопользовательских средах и обеспечивает гарантированный доступ к ресурсам для отдельных проектов. Fair Scheduler позволяет перераспределять ресурсы между запущенными задачами так, чтобы обеспечить «справедливый» доступ к ресурсам между пользователями и приложениями, предотвращая «голод» вычислительных задач.
Взаимодействие с HDFS и MapReduce
YARN не хранит данные, но управляет ресурсами, необходимыми для их обработки. В связке с HDFS он обеспечивает перенос данных в вычислительные узлы и back-end-логистику для MapReduce и других pervasive вычислительных моделей. Взаимодействие между компонентами работает через согласованные интерфейсы и протоколы: приложение регистрируется в ResourceManager, AM координирует запуск контейнеров на NodeManager, после чего задачи получают доступ к данным в HDFS через безопасные токены и сетевые протоколы. Этот уровень абстракции упрощает интеграцию с альтернативными обработчиками и позволяет компаниям разворачивать гибридные вычислительные пайплайны.
Высокая доступность и безопасность
YARN поддерживает высокую доступность для ResourceManager: дублирование компонентов, переключение между активным и резервным экземплярами, механизмы мониторинга. Безопасность достигается через механизм аутентификации и передачи прав доступа к ресурсам через контроль доступа и Kerberos-токены. В сочетании с HDFS такие меры обеспечивают целостность вычислительных пайплайнов и предотвращают несанкционированный доступ к данным.
MapReduce: модель выполнения и потоки данных
MapReduce остается одним из самых узнаваемых подходов к распределённой обработке данных в Hadoop-экосистеме. В своей базовой форме MapReduce реализует парадигму параллельной обработки, где данные проходят через этапы Map, Shuffle/Sort и Reduce. Архитектура разделяет этапы чтения, обработки и агрегации, что позволяет эффективно распараллеливать вычисления на большом количестве узлов.
Модель выполнения и потоки данных
- Map-этап: данные разбиваются на ключ-значение пары, обрабатываются функцией Map на каждом узле и формируются промежуточные пары.
- Shuffle и Sort: промежуточные пары группируются по ключам и передаются Reduce-задачам. В этот момент происходит сортировка и перетасовка данных между узлами, что обеспечивает Rocks-like эффективность агрегирования.
- Reduce-этап: итоговые значения агрегируются по ключам и пишутся обратно в HDFS.
Важно отметить, что MapReduce в классическом виде тесно связан с доступом к данным в HDFS: Map-задачи обычно работают рядом с данными на узлах DataNode, что сокращает сетевые нагрузки за счёт локальности чтения. В рамках YARN этот процесс управляется средствами ResourceManager и ApplicationMaster.
Взаимодействие с HDFS и YARN
Pартнерство HDFS и YARN обеспечивает устойчивое выполнение MapReduce-пайплайнов. HDFS предоставляет данные, YARN - ресурсы и инфраструктуру для выполнения задач, а MapReduce реализует логику обработки. При проектировании пайплайна следует учитывать такие факторы, как размер входных данных, степень параллелизма и баланс между Map и Reduce-фазами. Эффективная настройка параметров, таких как количество мапперов и редьюсеров, параметров буферов и размеров секций, влияет на производительность, но должна согласовываться с архитектурой кластера и топологией сети.
Производительность и ограничения
Производительность MapReduce зависит от нескольких факторов:
- Эффективность функции Map и распределение нагрузки по ключам - предотвращение перегрузки узлов и "hot spots" распределённых данных.
- Эффективность стадии Shuffle: сетевые задержки, размер буферов и стратегий сортировки.
- Размер входного набора и балансировка: избежание слишком большого количества редьюсеров, которые будут простаивать или перегружать узлы.
- Стратегии сохранения и формат данных: использование форматов, поддерживающих прямую сериализацию и эффективную компрессию.
Эволюция и альтернативы
С течением времени в экосистеме Hadoop MapReduce уступил место более современным вычислительным моделям, таким как Apache Spark. Spark предлагает более низкие задержки исполнения и гибкое API для работы как с пакетной, так и с интерактивной обработкой. Однако MapReduce остаётся фундаментальным элементом для понимания архитектуры Hadoop и служит основой для многих исторических пайплайнов и интеграций, а также является надёжной и предсказуемой моделью для крупных пакетных задач.
Протоколы взаимодействия и алгоритмы
Комплекс архитектуры Hadoop строится на совокупности протоколов и алгоритмов, которые обеспечивают согласованность, отказоустойчивость и безопасность. В этом разделе рассмотрены ключевые механизмы, которые лежат в основе взаимодействий между HDFS, YARN и MapReduce.
RPC-платформа Hadoop
Компоненты Hadoop общаются через удалённые вызовы процедур (RPC). RPC-платформа реализует:
- обмен метаданными и состоянием узлов (например, состояние блоков, отчёты о блоках);
- выполнение удалённых операций над файловой системой и ресурсами;
- обмен сообщениями для координации запуска задач и управления контейнерами.
Эта схема обеспечивает низкий уровень абстракций и высокую скорость обмена сообщениями между NameNode/DataNode, ResourceManager/NodeManager и ApplicationMaster.
Журналы и консистентность: FSImage и EditLog
Хранение метаданных HDFS реализуется через FSImage (полное состояние файловой системы) и EditLog (партия изменений). В HA-настройках FSImage и EditLog синхронно реплицируются между несколькими NameNode через JournalNode. При старте активного NameNode он читает FSImage и применяет изменения из EditLog, чтобы восстановить текущее состояние файловой системы. Этот механизм обеспечивает устойчивость к сбоям и целостность данных, а также позволяет быстро восстанавливаться после сбоев.
Репликация и топология сети
Топология размещения блоков и алгоритм выбора DataNode для записи/чтения - ключ к снижению латентности. rack awareness позволяет размещать копии блоков таким образом, чтобы чтение происходило с ближайших узлов. Протоколы мониторинга состояния DataNode, heartbeat и блок-отчёты обеспечивают постоянную видимость состояния кластера NameNode. В сложных кластерах используются механизмы обеспечения консистентности и согласованного состояния, включая карантин и повторную передачу данных.
Безопасность и аутентификация
Безопасность реализуется через аутентификацию и авторизацию на уровне сетевых сервисов и файловой системы. Kerberos-авторизация обеспечивает передачу доверенных токенов между компонентами и предоставляет механизм делегирования полномочий для задач в рамках кластера. Взаимодействие между компонентами осуществляется через безопасные каналы и проверку прав доступа к данным и ресурсам.
Эволюция протоколов и устойчивость к сбоям
С развитием Hadoop появились улучшения в области отказоустойчивости: улучшение механизмов планирования, поддержка HA NameNode, улучшение журналирования, улучшение отказоустойчивости при сбоях узлов и гибкости в конфигурации. Важной особенностью остается возможность горизонтального масштабирования, благодаря чему кластеры могут расти за счет добавления новых DataNode и NodeManager без значительных изменений в архитектуре.
Практические аспекты реализации и интеграции
Реализация Hadoop-решения требует аккуратной настройки параметров и продуманной стратегии интеграции между HDFS, YARN и MapReduce. В этой части освещаются практические аспекты, которые позволяют перейти от теории к реализуемой системе.
Параметры конфигурации и проектирование кластера
Ключевые параметры:
- размер блока (block size) и фактор репликации - влияют на пропускную способность, задержку и требуемое хранение;
- политики планирования в YARN - выбор между FIFO, Capacity или Fair Scheduler, что отражает требования к сервису и уровень многопользовательской эксплуатации;
- параметры HA для NameNode и соответствующая инфраструктура журналирования;
- безопасность - настройка Kerberos и делегируемых токенов для обеспечения безопасного доступа к данным и ресурсам.
Правильная настройка этих параметров требует анализа рабочей нагрузки, профилей использования и требований к доступности. Практическая рекомендация - запускать пилотный кластер с мониторингом и постепенно наращивать параметры по мере роста объёмов данных.
Архитектурные решения для высокой доступности и миграций
HA NameNode и поддержка резервного хранилища FSImage через JournalNode позволяют снизить риск простоев. При миграциях и обновлениях важно соблюдать совместимость форматов FSImage и EditLog, тестировать сценарии отката и иметь четко прописанные планы аварийного восстановления. В процессе внедрения следует предусмотреть резервирование узлов, сетевые изоляции и резервные источники данных, чтобы минимизировать простои.
Безопасность и соответствие требованиям
Безопасность в кластере Hadoop - это не только настройка Kerberos. Включаются вопросы шифрования сетевого трафика, безопасного доступа к данным на уровне файловой системы и криптографической защиты данных на диске. В крупных организациях требуется соблюдение регламентов по доступу к данным и журналированию действий пользователей, что становится частью архитектурной дисциплины.
Внедрение и мониторинг
Успешное внедрение требует прозрачной архитектуры, чётких KPI по производительности и отказоустойчивости, а также активного мониторинга. В качестве инструментов мониторинга применяются решения для просмотра использования CPU, памяти, ввода-вывода и сетевых потоков, а также метрик YARN и HDFS. Мониторинг помогает устанавливать пороги для уведомлений и планировать масштабирование, чтобы поддерживать требуемые уровни сервиса.
Интеграция с открытыми и локальными продуктами
В рамках экосистемы Hadoop возможно сочетать открытые решения, например Apache Hadoop и Apache HDFS, с коммерческими платформами для анализа данных. Нередко выбирается гибридная архитектура, где критичные данные хранятся в HDFS, а вычислительная логика исполняется в рамках Spark на YARN или через другие обработчики. Важно ограничить количество точек интеграции и обеспечить единый центр мониторинга и учёта. В отечественных проектах акцент часто делается на совместимости с локальными требованиями к безопасности и сертификации, используя открытые стандарты и совместимые протоколы.
Key takeaways
- HDFS хранит данные в виде блоков, управляемых NameNode и DataNode, обеспечивая масштабируемость и отказоустойчивость через репликацию.
- Размер блока и фактор репликации критично влияют на производительность чтения и устойчивость к сбоям; топология размещения реплик снижает сетевые задержки.
- YARN разделяет управление ресурсами и полноценно поддерживает множество вычислительных моделей; выбор планировщика влияет на справедливость и качество обслуживания.
- MapReduce реализует классическую модель Map-Shuffle-Reduce, но современная экосистема чаще включает альтернативы типа Spark; понимание основ важно для интеграции.
- Протоколы RPC, журналирование FSImage/EditLog и политики безопасности являются основой надёжности системы; HA NameNode и Kerberos существенно повышают доступность и безопасность.
- При внедрении следует учитывать конфигурационные параметры, требования к доступности, безопасность и мониторинг; разумная миграционная дорожная карта снижает риски.
- В реальных проектах важно сочетать преимущества открытых решений и корпоративных платформ, сохраняя единый подход к управлению данными и ресурсами.
FAQ
- Что такое HDFS и чем он отличается от обычной сетевой файловой системы?
HDFS - распределённая файловая система, оптимизированная под очень большие файлы и последовательный доступ к данным. Она ориентирована на высокую пропускную способность чтения больших объёмов и на устойчивость к сбоям через репликацию блоков. В отличие от обычной файловой системы, HDFS ориентирован на потоковую обработку и хранение больших массивов данных, где оптимизация мелких операций чтения и записи имеет меньшую ценность, чем надёжность хранения и эффективное масштабирование.
- Какова роль NameNode и DataNode в HDFS?
NameNode хранит метаданные файловой системы: имена файлов, их пути, расположение блоков и состояние блоков. DataNode хранит сами блоки на физических носителях. NameNode отвечает за согласованность и доступ к метаданным, тогда как DataNodes обеспечивают физическое хранение контента и взаимодействуют с клиентами и NameNode через обмен блоками и сигналами состояния.
- Что значит репликация блоков и почему она необходима?
Репликация обеспечивает отказоустойчивость: если один узел выходит из строя, данные доступны из копий на других узлах. Фактор репликации определяет число копий блока. Репликация влияет на требования к хранению и на сложность размещения блоков, но значительно повышает надёжность при сбоях оборудования или сетевых проблемах.
- Как YARN управляет ресурсами и зачем это нужно?
YARN управляет ресурсами кластера через ResourceManager и NodeManager, позволяя запускать контейнеры и координировать выполнение задач. Это позволяет поддерживать множество приложений и вычислительных моделей на одном кластере, эффективно использовать ресурсы, обеспечивать устойчивость к перегрузкам и гибкую масштабируемость.
- Какие есть сценарии использования MapReduce в контексте современной экосистемы Hadoop?
MapReduce - классическая парадигма пакетной обработки больших массивов данных. В современных условиях он часто дополняется или заменяется на такие технологии, как Spark, обеспечивающие меньшие задержки и более гибкие API. Тем не менее MapReduce остаётся надёжной базовой моделью, полезной там, где требуется строгий режим пакетной обработки и предсказуемость поведения.
- Каковы основные аспекты безопасности Hadoop-архитектуры?
Безопасность включает Kerberos-аутентификацию, делегируемые токены, контроль доступа к файловой системе и политике шифрования сетевого трафика. Важно обеспечить аутентифицированный доступ к данным и управление правами на уровне данных и вычислений, а также аудит действий пользователей.
- Какие практические шаги необходимы для внедрения HA NameNode?
Необходимо развернуть активный и резервный NameNode, настроить журналирование FSImage/EditLog через JournalNode, обеспечить синхронность между узлами и тестовые сценарии переключения. Важно проверить совместимость версий и провести репетиции восстановления на тестовом окружении.
- Какие типичные параметры конфигурации влияют на производительность кластера?
Ключевые параметры - размер блока, фактор репликации, политика планирования в YARN, лимиты памяти и CPU для контейнеров, параметры Shuffle/Sort в MapReduce, а также настройки безопасности и мониторинга. Их баланс требует анализа нагрузки и целей по времени выполнения пайплайнов.
- Как выбрать подходящую модель планирования в YARN?
Выбор между FIFO, Capacity и Fair Scheduler зависит от характера нагрузки: если нужен простой и последовательный режим, подходит FIFO; если требуется гарантированная доля ресурсов для проектов, применяется Capacity; если же приоритетом является справедливость между многочисленными задачами и пользователями - Fair Scheduler.
- Как интегрировать Hadoop с альтернативными вычислительными моделями?
Эта интеграция требует согласованной политики управления данными и ресурсами: обеспечить единый слой планирования (через YARN), общий доступ к HDFS и согласованные политики безопасности. Инструменты вроде Spark на YARN позволяют сочетать преимущества разных моделей с единым набором механизмов мониторинга и аудита.


