

Стратегия данных и целевые архитектуры: как Hadoop вписывается в корпоративную модель
Современная корпоративная аналитика требует продуманной стратегии данных и гибкой, но управляемой архитектуры. Hadoop-платформа выступает не просто набором инструментов для обработки больших данных, а фундаментом, связывающим источники данных, конвейеры обработки и принципы управления. Глава посвящена тому, как сформировать целевую архитектуру данных в рамках корпоративной модели, какие архитектурные паттерны и governance-практики применяются для устойчивой эксплуатации Hive, Impala и Spark SQL, и какие шаги предпринять для перехода к устойчивой аналитике на основе Hadoop.
Во вводной части рассматривается роль Hadoop в рамках стратегии данных предприятия: как определить домены данных, роли стейкхолдеров, какие принципы управления данными обеспечивают согласованность и воспроизводимость аналитики, какие архитектурные паттерны позволяют балансировать потребности бизнес-подразделений и требования регуляторов. Далее излагаются конкретные архитектурные решения и принципы внедрения, подкрепляемые практическими рекомендациями по выбору движков SQL, интеграции инструментов и обеспечению операционной устойчивости.
-
В рамках главы приводятся концепции, которые в корпоративной среде переходят от теории к реализации: модель данных как продукта, контрактование данных, каталогизация и управление данными, безопасность и соответствие требованиям, а также маршруты эволюции архитектуры в условиях гибридной облачной и локальной среды.
-
Применение технологий Hive, Impala и Spark SQL в корпоративной модели требует ясности по ролям и ограничениям: какие задачи решаются тем или иным движком, как обеспечить совместное использование данных и единый подход к качеству данных. В конце главы приведены дорожные карты и шаблоны архитектурных решений для реальной эксплуатации.
Краткое содержание главы
- Определение целевой архитектуры данных в корпоративном контексте и роль Hadoop как базовой платформы анализа.
- Архитектурные слои Hadoop: хранение, вычисления, конвейеры обработки и управление метаданными и безопасностью.
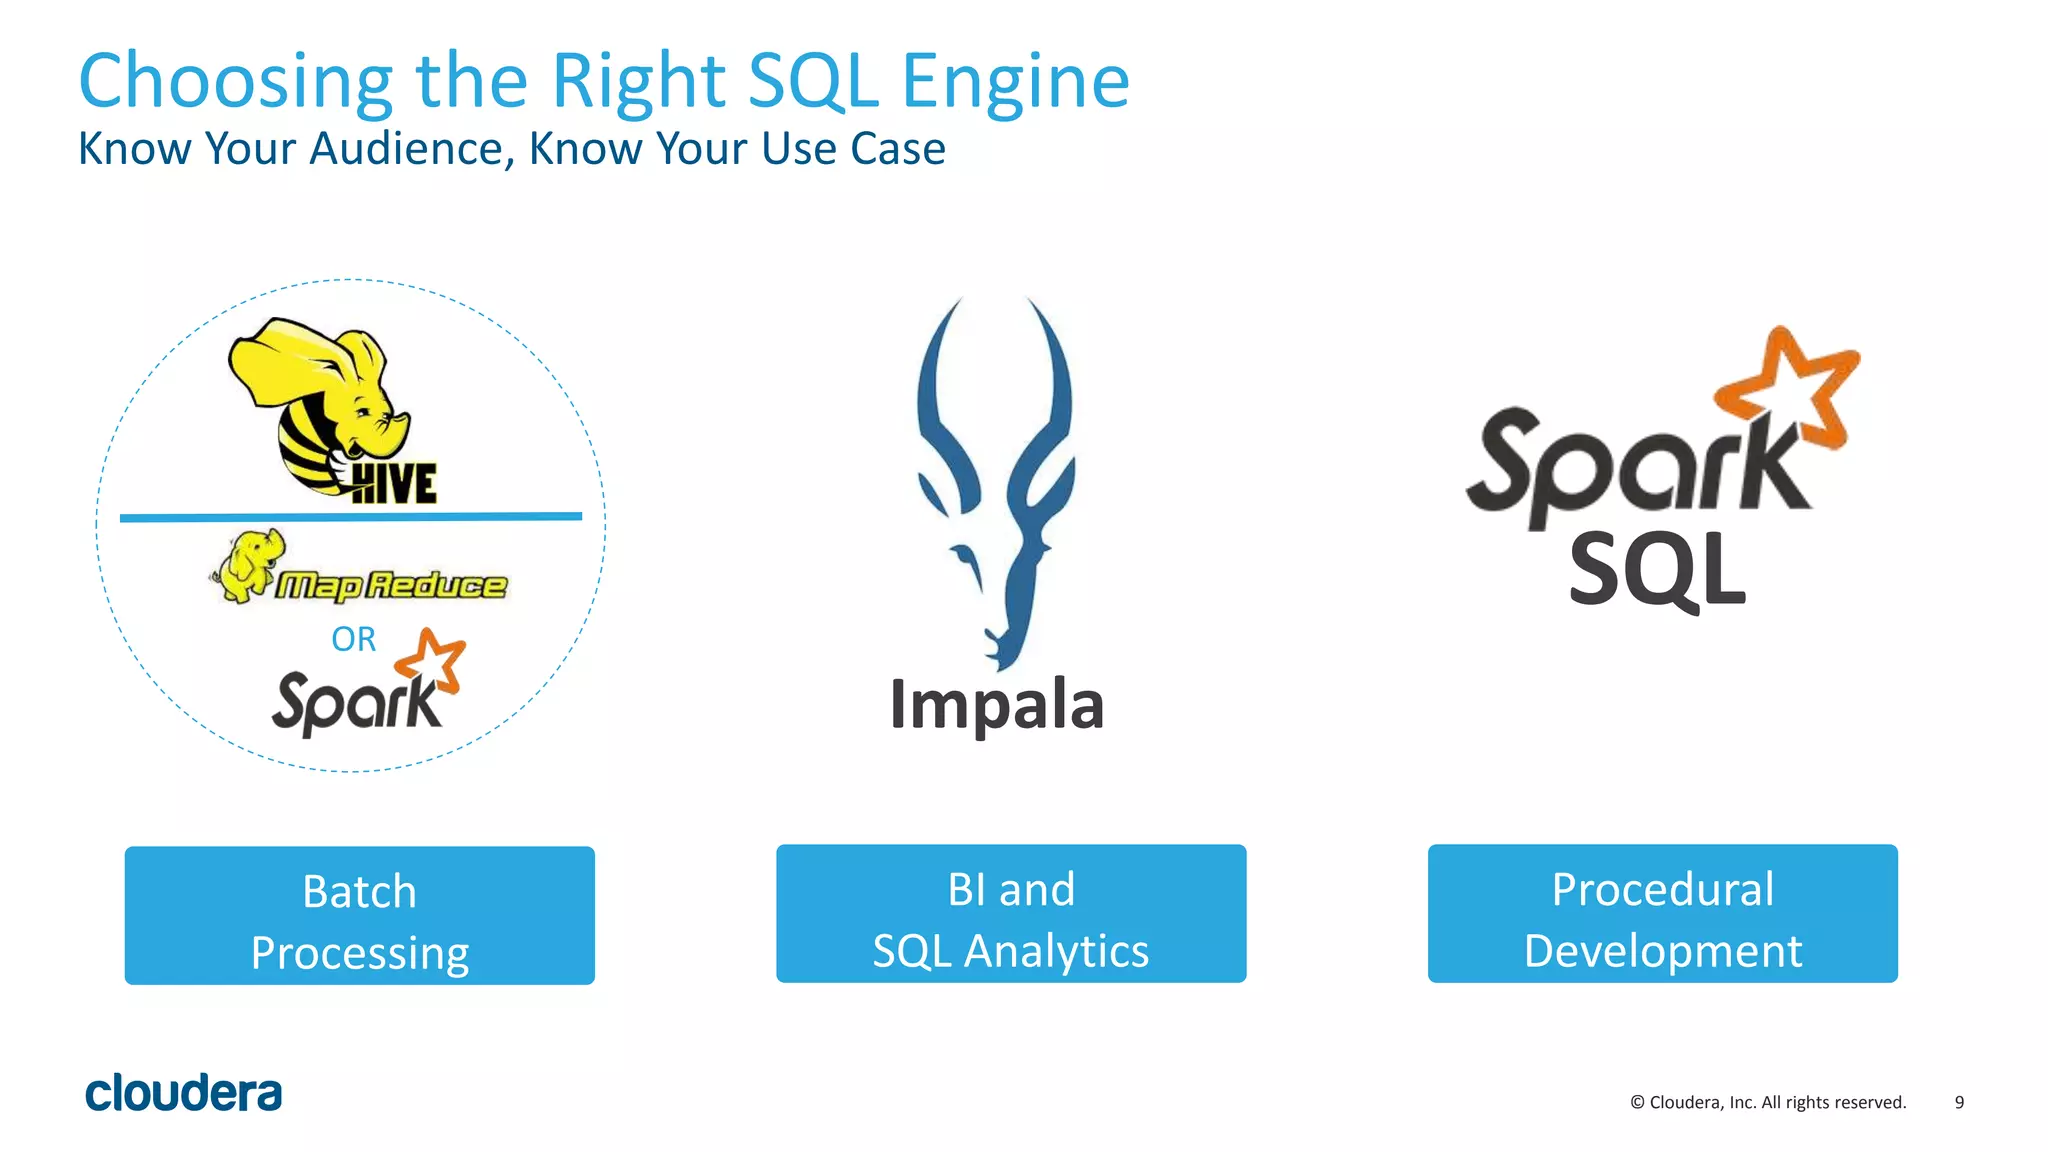
- Выбор и комбинация SQL-движков Hive, Impala, Spark SQL в зависимости от рабочих нагрузок и требований к latency.
- Путь к реализации: организация изменений, процессы внедрения, управление данными и операционная дисциплина.
- Паттерны архитектуры для больших данных на Hadoop и их применение в реальных сценариях.
Целевая архитектура в контексте корпоративной модели
Корпоративная архитектура данных должна отражать бизнес-цели и обеспечивать единый язык данных по всей организации. В рамках Hadoop это означает проектирование архитектуры, которая позволяет:
- Выстраивать домены данных и ответственность за них в виде «data products» - владение данными с четко сформулированными контрактами и метаданными. Такой подход снижает фрагментацию и упрощает совместное использование данных между подразделениями.
- Вводить семантический слой и общую модель данных, минимизируя дублирование и конфликт версий. Canonical или полевый/глобальный уровень моделей помогает согласовать бизнес терминологию и правила агрегации.
- Формировать устойчивую связь между данными и аналитическими потребностями бизнеса. Это достигается через определение сервис-уровней для данных, управление качеством, линейность данных и прослеживаемость происхождения данных.
- Интегрировать Hadoop-платформу в существующую архитектуру предприятия: процессы, платформы реального времени и инфраструктура данные-о-процессах. В рамках такой интеграции Hadoop выступает как центр обработки и хранения больших массивов данных, совместимый с облачными и локальными средами.
В качестве базовых принципов следует использовать: модульность, повторяемость, воспроизводимость и управляемость. Архитектура должна быть адаптивной, чтобы поддерживать как традиционные пакетные задачи, так и интерактивную аналитику и машинное обучение. Архитектурные решения должны обеспечивать согласование между командами данных, бизнес-единицами и регуляторами.
- Основной принцип построения архитектуры - разделение ответственности по слоям: источники данных и конвейеры на уровне Ingestion, слой хранилища и подготовки данных, слой обработки и аналитики, слой представления и экспорта данных, а также центр управления и обеспечения соответствия требованиям.
- Архитектура должна поддерживать гибридность развертываний: локальные дата-центры, частный облачный кластер и общедоступное облако. Это позволяет выбирать оптимальные решения по стоимости, требованиям к задержке и требованиям безопасности для конкретных доменов данных.
В корпоративной модели особенно важно формализовать принципы управления данными: версии схем, контракты обмена данными, управление качеством, управление жизненным циклом данных и мониторинг. Для взаимодействия между файлами Hive Metastore, каталогами Atlas или аналогичных систем метаданных и инструментами безопасности, такими как Ranger или Sentry, необходимы интеграционные принципы, позволяющие единообразно применять политики доступа и аудита по всем инструментам SQL-on-Hadoop и конвейерам обработки.
Инфраструктура Hadoop как слои архитектуры
Целостная архитектура Hadoop состоит из взаимодополняющих слоев, где каждый элемент выполняет свою роль в конвейере данных и обеспечивает требуемую производительность, безопасность и управляемость.
- Хранилище и формат данных. HDFS выступает как долговременное хранилище больших объемов данных. Для эффективной аналитики применяются колоночные форматы Parquet и ORC, оптимизирующие сжатие и скорость пропускной способности. Эти форматы обеспечивают predicate pushdown и эффективную векторизацию при работе с Hive, Impala и Spark SQL.
- Вычисления и обработка. YARN обеспечивает управление ресурсами и планирование задач. В реальном режиме применяется Tez и Spark как движки обработки. Spark SQL особенно эффективен для сложных трансформаций, объединенной обработки и машинного обучения через MLlib, тогда как Hive обеспечивает устойчивую пакетную обработку и поддержку ACID-транзакций в рамках современных версий.
- SQL-слои и ядро запросов. Hive, Impala и Spark SQL работают поверх одного и того же хранилища, но оптимизированы под разные режимы работы. Hive ориентирован на пакетную аналитику и практикуется как основа для ETL-пайплайнов, а Impala - на интерактивную аналитику с минимальными задержками. Spark SQL обеспечивает унифицированный подход к обработке данных, включая сложные преобразования и возможности ML.
- Интеграция конвейера и стриминга. Ингестия осуществляется через инструменты Flume, Apache NiFi и Sqoop, а для потоковых конвейеров - через Apache Kafka и структурированную потоковую обработку в Spark. В корпоративной среде важно сочетать пакетную обработку в рамках Hadoop и скоростную обработку для данных в реальном времени.
- Метаданные, каталогизация и безопасность. Метаданные управляются через Hive Metastore, Atlas или аналогичные каталоги. Контроль доступа реализуется через системы безопасности, такие как Apache Ranger или Sentry, с поддержкой Kerberos и политики на уровне данных. Аудит и прослеживаемость происхождения данных обеспечивают соответствие регуляторным требованиям и внутренним policy.
- Операции и мониторинг. Мониторинг производительности и использование ресурсов осуществляется через инструменты кластера Hadoop, включая Job History Server, YARN ResourceManager и мониторинговые панели. Логирование и трассировка позволяют выявлять узкие места и обеспечивать качество обслуживания.
Совокупность этих слоев в корпоративной среде требует четких правил по взаимодействию: единый контракт на данные, единообразные форматы, согласованные политики доступа и централизованное управление изменениями. Важно помнить: целевые архитектуры не сводятся к мифическим «одному инструменту». Эффективная архитектура достигается через согласование ролей, стандартов данных и эффективное взаимодействие между инжинирингом данных, аналитиками и бизнес-пользователями.
Выбор и сочетание движков SQL: Hive, Impala, Spark SQL
Успешное применение Hadoop в корпоративной аналитике требует осмысленного выбора движков SQL в зависимости от характера рабочих нагрузок, требований к latency и интеграции с конвейерами. Рассмотрим ключевые особенности и зоны применения каждого движка.
- Hive. Исторически устойчивый набор инструментов для пакетной обработки. Современные версии Hive, особенно с поддержкой LLAP и в сочетании с Parquet/ORC, позволяют снижать задержки и предоставлять часть интерактивного опыта. Hive хорошо подходит для предсказуемых пакетных пайплайнов, агрегаций по крупным дата-массивам, накопления и вычислений по регламентируемым план-чекам. В корпоративной среде Hive часто выступает основой для ETL-процессов и подготовки данных для моделей и отчетности.
- Impala. Опора на интерактивную аналитику с низкой задержкой. Impala обеспечивает быстрые ответы на стандартные SQL-запросы и подходит для BI-аналитики в реальном времени, дашбордов и исследовательской работы с данными. Однако масштабы параллельной обработки и сложность консолидации метаданных требуют продуманного управления статистикой и настройками окружения.
- Spark SQL. Универсальный движок, который объединяет обработку данных, трансформации, потоковую обработку и возможности машинного обучения через Spark MLlib. Spark SQL excels в сложных ETL-процессах, агрегациях, соединениях больших таблиц и обработке структурированных данных. Он особенно подходит для сценариев, где требуется единая платформа для анализа данных и моделирования, а также для обработки данных в реальном времени через Structured Streaming и интеграцию с ML-пайплайнами.
Оптимальная конфигурация часто предполагает совместное использование всех трех движков, где:
- Hive служит фоном для пакетной подготовки данных и регулярных БД-таблиц, обслуживаемых инфраструктурой Enterprise Data Warehouse и Data Lake.
- Impala обеспечивает интерактивную аналитику над теми же данными, ускоряя ответы BI-инструментов.
- Spark SQL выполняет данные-преобразования, интеграцию с ML и сложные сценарии обработки, где требуется гибкость и функциональность ML-пайплайнов.
Ключ к эффективной эксплуатации - единая метадательная система и конвенции по каталогу данных, которые позволяют движениям между Hive Metastore, каталоги Atlas и выбранными инструментами безопасности работать согласованно. Важным аспектом является хранение данных в общепринятых форматах Parquet или ORC и соблюдение согласованных схем и секционирования. Это позволяет обеспечить согласованность чтения и записи между Hive, Impala и Spark SQL, а также повысить предсказуемость производительности.
Рассматривая паттерны, следует учитывать:
- Архитектура «межсетевого» взаимодействия: использование каждого движка по своей сильной стороне в рамках одного источника данных с сохранением единого набора правил доступа и схем.
- Применение кеширования и статистики. Impala и Hive могут использовать обновление статистики, индексы и оптимизацию выполнения, что особенно важно для взаимного использования данных между движками.
- Управление ресурсами. Необходимо определить политики квот и пулов для каждого движка, чтобы предотвратить взаимное влияние и обеспечить предсказуемую производительность для критически важных бизнес-процессов.
Опыт корпоративной практики показывает, что сбалансированное сочетание Hive, Impala и Spark SQL требует согласованных правил обмена данными, единых контрактов и прозрачной архитектуры. В таких условиях можно обеспечить стабильность BI-аналитики, гибкость в обработке данных и возможность расширения с минимальными затратами на операционную выправку.
Путь к реализации: дорожная карта и принципы внедрения
Реализация целевой архитектуры требует последовательности шагов и изменений в организационной структуре и инфраструктуре. В отраслевых проектах применяется следующая дорожная карта:
- Этап подготовки и определения доменов. Выясняется, какие бизнес-домены являются приоритетами: клиенты, продукты, операции, финансы, риск. Определяются владельцы данных и роль data product owners, которые несут ответственность за контракты, качество и эволюцию домена.
- Разработка архитектурного базиса. Формируется reference-архитектура с чётким разделением слоев: ingestion, storage, processing, serving, governance. Разрабатываются принципы семантики, каталога и совместного использования данных между движками.
- Внедрение governance и каталога. Создаются политики доступа, аудита и качества данных. Внедряется каталог данных, регламентированный набор метаданных и контракты обмена данными, чтобы обеспечить единый источник истины.
- Пилотные проекты и масштабирование. Выполняются пилоты на ограниченном наборе доменов для проверки архитектуры, производительности и операционной устойчивости. По результатам выбираются направления для расширения и совместного использования данных.
- Архитектура безопасности и соответствие требованиям. Реализуются Kerberos-авторизация, политики Ranger/Sentry, защита данных в покое и в движении, маскирование данных и аудит. Обеспечивается соответствие требованиям по конфиденциальности и регуляторным нормам.
- Операционная дисциплина. Вводятся процессы мониторинга, SLA на данные, стандартные показатели качества и устойчивой работоспособности, включая управление версиями, тестирование схем и регрессионное тестирование пайплайнов.
- Архитектура будущего. Расширение к паттернам Data Lakehouse и Data Mesh, использование доменных данных как продукта, расширение экосистемы инструментов и внедрение соответствия бизнес-целям.
Организационные изменения являются неотъемлемой частью реализации: формируются центры данных, сообщество экспертов, политика по обмену данными и принципы повышения квалификации сотрудников. В рамках такого подхода создаются «data products» с понятной SLA и требованиями к качеству, что упрощает взаимодействие между бизнесом и IT.
- Взаимодействие с командами: бизнес-аналитики, инженеры данных, специалисты по данным и регуляторы получают четкие роли и ответственность. В рамках корпоративной модели это способствует улучшению управляемости данных и ускорению цикла поставки аналитики.
- Технологическая гибкость. Архитектура допускает адаптацию к новым подходам и инструментам, сохраняя совместимость и стабильность оперативной аналитики.
Дорожная карта не должна быть линейной: она требует периодических пересмотров, обновления контрактов и корректировок в зависимости от изменений бизнес-целей, регуляторной среды и технологических возможностей. Важной частью является формирование набора «платформенных паттернов» - готовых повторяемых решений под конкретные типы задач.
Управление данными, безопасность и соответствие требованиям
Управление данными и безопасность становятся основой доверия к аналитическим результатам и к самой архитектуре. В корпоративной среде следует внедрять системные решения и практики, которые обеспечивают:
- Контроль доступа и аудит. Реализация многоуровневого управления доступом на основе ролей, групп и контекстов данных. Внедрение Kerberos для аутентификации и Policy-based Access через Ranger или Sentry.
- Защита данных. Шифрование данных в покое и в движении, контроль над копированием и миграциями данных, маскирование чувствительных данных на этапах подготовки и анализа.
- Управление качеством и жизненным циклом. Определение контрактов на данные, формирование правил валидации, мониторинг целостности данных и устранение отклонений на ранней стадии.
- Прослеживаемость и соответствие. Наличие полной истории изменений, lineage-отслеживание происхождения данных, возможность восстановления и аудита для регуляторных требований. Это особенно критично в секторе финансов, здравоохранения и телекоммуникаций.
- Управление инцидентами. Введение процессов по обработке инцидентов, включая распознавание, эскалацию и исправление, чтобы минимизировать влияние на аналитические пайплайны и бизнес-пользователей.
- Соответствие стандартам. В рамках различных юрисдикций соблюдаются требования по защите персональных данных, конфиденциальности и правовой регуляции. Архитектура должна позволять быстро адаптироваться к изменениям регуляторной среды без разрушения бизнес-процессов.
Опыт показывает, что безопасность и соответствие должны быть встроены на стадии проектирования архитектуры, а не добавлены постфактум. Это достигается через единый контроль доступа, централизованный каталог и непрерывную проверку соответствия в рамках процессов CI/CD и операционных процедур.
Примеры паттернов архитектуры
Ниже приведены три базовых паттерна, которые часто применяются в корпоративной среде Hadoop, адаптированных под задачи Hive, Impala и Spark SQL.
- Паттерн 1: Data Lakehouse на Hadoop. Хранение данных в файловых форматах Parquet/ORC в HDFS с единым слоем обработки через Hive/Impala/Spark SQL. Такой подход обеспечивает единый источник истины для отчетности и анализа, поддерживает ACID-транзакции и производительную интерактивную аналитику при правильной настройке кэширования и метаданных.
- Паттерн 2: Lambda-архитектура на стеке Hadoop. Пакетная обработка через Hive/Tez, а «скоростной» слой через Spark Structured Streaming и, при необходимости, Impala для интерактивной части. Служит для обработки больших массивов данных и предоставления обновляемых данных в BI-системах. Важно избегать чрезмерной сложности консолидации между слоями и обеспечить согласованный контроль качества и безопасности.
- Паттерн 3: Data Mesh с доменными данными как продуктами. Архитектура, в которой домены данных управляются локальными командами: владельцы доменов формируют контракты, метаданные и наборы правил доступа. Это повышает скорость эволюции доменов и упрощает масштабирующее взаимодействие между подразделениями.
Каждый паттерн имеет свои преимущества и ограничения. Для устойчивой эксплуатации применяется гибридный подход: бизнес-потребности доменов развиваются автономно, но остаются встроенными в общую архитектуру, каталоги и политики безопасности. В реальных условиях выбор паттерна зависит от принятых бизнес-метрик, регуляторной среды и организационной готовности к изменениям.
Key takeaways
- Hadoop-платформа должна рассматриваться как ядро корпоративной архитектуры данных, интегрирующее хранение, обработку и управление данными на уровне предприятия.
- Эффективная целевая архитектура строится на разделении слоев: ingestion, storage, processing, serving и governance, с единым набором метаданных и политик доступа.
- Hive, Impala и Spark SQL дополняют друг друга: Hive - пакетная обработка и подготовка данных, Impala - интерактивная аналитика, Spark SQL - универсальная платформа для трансформаций и ML.
- Введение data contracts, data catalog и управляемых доменов данных способствует масштабируемости и повторяемости аналитических пайплайнов.
- Безопасность и соответствие требованиям должны быть встроены на ранних этапах проектирования архитектуры, включая Kerberos-авторизацию, политики Ranger/Sentry и аудит.
- Паттерны Data Lakehouse, Lambda и Data Mesh позволяют адаптироваться к различным сценариям бизнеса и технологическим условиям, сохраняя единый контроль над данными.
FAQ
- Какие ключевые архитектурные принципы следует закрепить на старте проекта Hadoop в корпоративной модели?
- Важно сформулировать единый базовый набор стандартов: канонические схемы и контракты данных, единый каталог метаданных, политики доступа и аудит. Необходимо определить целевые домены данных и владельцев, чтобы обеспечить ответственность за качество и эволюцию данных. Архитектура должна быть модульной и адаптивной, чтобы поддерживать как пакетную обработку, так и интерактивную аналитику и ML-нарешения.
- Как выбрать основную конфигурацию движков SQL в рамках одного источника данных?
- Лучше выбрать сочетание Hive, Impala и Spark SQL: Hive для пакетной подготовки и ETL-операций, Impala для интерактивной аналитики, Spark SQL для сложных трансформаций и ML. Основной фокус - единый источник истины и совместное использование данных с едиными контрактами и форматом хранения (Parquet/ORC). Правильная настройка статистики, инфраструктуры и политики доступа обеспечивает предсказуемую производительность.
- Как организовать безопасный доступ к данным в такой архитектуре?
- Необходимо внедрить Kerberos-авторизацию и централизованные политики доступа через Ranger/Sentry. Политики должны применяться на уровне файловой системы и на уровне SQL-слоя, чтобы предотвратить несанкционированный доступ к чувствительным данным. Маскирование данных и аудит должны быть частью стандартных процессов на этапе подготовки и анализа.
- Какие паттерны архитектуры особенно полезны для больших корпоративных данных?
- Data Lakehouse обеспечивает единый источник данных и ускоренную аналитическую работу. Lambda-архитектура позволяет совмещать пакетную и стриминговую обработку для оперативной аналитики и отчетности. Data Mesh фокусируется на доменных данных как продуктах и способствует масштабируемости в больших организациях.
- Какие критерии использовать для планирования внедрения и перехода к целевой архитектуре?
- Определение доменов данных и владельцев; формирование контрактов на данные; выбор паттерна внедрения; установление SLA и KPI для качество данных; создание центра управления безопасностью и соответствием; пилотирование на ограниченном наборе доменов и последовательное масштабирование.
- Как обеспечить интеграцию между Hive, Impala и Spark SQL без дублирования данных?
- Важно хранить данные в общих форматах и местах (Parquet/ORC в HDFS) и использовать единый Hive Metastore или каталог метаданных, чтобы все движки опирались на одну и ту же схему. Контроль версий и миграций схем нужен для предотвращения расхождения между движками.
- Какие организационные изменения сопровождают успешную реализацию такой архитектуры?
- Необходимо создать центр компетенций по данным и выделить data product owners для доменов. Вводятся процедуры управления изменениям и политики качества данных, обучение сотрудников, а также механизмы сотрудничества между бизнесом и IT. Включение регуляторных требований в governance-процессы позволяет поддерживать соответствие в долгосрочной перспективе.
- Какие риски характерны для перехода к такой архитектуре и как их минимизировать?
- Риск фрагментации данных и несогласованности схем. Решение - внедрять единый каталог, контрактование данных и строгие правила доступа. Риск перегрузки инфраструктуры конфликтующими запросами - ввести политики пулов ресурсов и мониторинг производительности. Риск позднего внедрения - пилоты на ограниченном наборе доменов с постепенным масштабированием и четкой дорожной картой.
- Какие индикаторы эффективности помогают оценить устойчивость архитектуры?
- Время отклика интерактивной аналитики, скорость загрузки пайплайнов, доля данных в согласованных форматах, соответствие регуляторным требованиям, уровень повторяемости аналитических результатов и процент достоверности данных по SLA.
- Как обеспечивать эволюцию архитектуры в условиях изменений регуляторной среды и бизнес-тотребностей?
- Важно поддерживать гибкую стратегию развития архитектуры через Data Mesh и контрактную модель совместного пользования данными. Регулярный пересмотр контрактах, обновление политик доступа и форматов данных, а также внедрение автоматизации тестирования и мониторинга помогают адаптироваться к изменениям без разрушения существующих пайплайнов.
Эта глава предоставляет основу для разработки целевой архитектуры данных и стратегии внедрения Hadoop в корпоративной среде. В условиях цифровой трансформации предприятия выбор правильно скоординированных паттернов и практик управления данными обеспечивает не только эффективность аналитики, но и доверие к данным на уровне всей организации.


