

Data Lakehouse и семантический слой: связка хранилищ, бизнес-трансляция
Data Lakehouse объединяет преимущества хранения больших объемов данных в виде открытых форматов и мощь управляемой аналитики, присущую традиционному хранилищу. В центре перехода к цифровой трансформации лежит семантический слой - бизнес-моделирование, стандартные определения и правила расчета метрик, которые позволяют разным потребителям анализировать одни и те же данные в единых терминах. Глава посвящена тому, как связка Data Lakehouse и семантического слоя обеспечивает устойчивый доступ к фактам и измерениям (fact & dimension) через единый бизнес-транслятор: от архитектуры и моделирования до интеграций и внедрения в реальных условиях.
В основу подхода заложен баланс между техническими требованиями к хранению и подготовке данных и потребностью бизнеса в понятной, управляемой и повторяемой аналитике. Рассмотрим архитектурные стратегии, принципы моделирования семантики, механизмы управления качеством и безопасности, а также пошаговую дорожную карту внедрения: от выбора форматов и конвейеров до формирования продуктовых данных и монетизации бизнес-терминов.
- Краткое содержание главы
- Архитектура и принципы связки Lakehouse и семантического слоя: что входит в конвейер данных, какие слои существуют и как они взаимодействуют
- Моделирование семантики: сущности факт- и измерений, бизнес-глоссарий, контракты данных и версия
- Инженерия данных и примеры реализации: интеграции источников, управление схемами, качество и безопасность
- Внедрение и операционная практика: роли, процессы, KPI, управление изменениями
- Практические сценарии: корпоративная аналитика на продажах, операционная эффективность и финансовая отчетность
- Архитектурные паттерны и риски: шанс на гибкость, устойчивость к изменениям в источниках и стандартизация
Data Lakehouse и семантический слой: базовые понятия
Data Lakehouse - это архитектурная концепция, которая стремится объединить гибкость data lake с надежностью и структурированностью хранилища данных. Ключевые элементы включают: открытые форматы хранения (например, Parquet, ORC), транзакционные guarantees через ACID, управляемую метаданные моделью и движок запросов, способный обрабатывать как сырые, так и очищенные данные. В рамках этой концепции семантический слой выступает как слой бизнес-логики и абстракций над данными: он переводит технические таблицы и поля в понятные бизнес-термины, определяет вычислительную логику метрик и обеспечивает единое словарное хозяйство. Такой подход снижает риск расхождений между отделами аналитики, снижает потребность в повторной реконструкции расчетов и упрощает доступ к данным для self-service BI и аналитиков ML.
Важно подчеркнуть: в рамках Lakehouse усилия по управлению схемами и версиям данных должны сосредотачиваться на двух взаимодополняющих целях. Во-первых, обеспечение стойкости аналитических конвейеров к изменению источников и бизнес-требований. Во-вторых, сохранение прозрачности происхождения данных и их согласованности на уровне бизнес-терминов. Именно здесь семантический слой выступает связующим звеном между техничностью хранения и интуитивной бизнес-интерпретацией.
С точки зрения технологий, в качестве примеров архитектурных паттернов часто упоминаются движки, поддерживающие открытые форматы и транзакции, а также структурированные центры управления метаданными. В рамках нашего курса целесообразно опираться на два примера открытых технологий: Delta Lake и Apache Iceberg. Они иллюстрируют концепцию «одного источника истины» для аналитики в рамках Lakehouse и поддерживают согласование схем, атомарные изменения данных и эффективную оптимизацию запросов. В рамках главы эти примеры приводятся как контекстуальные ориентиры, а не как препятствие для выбора конкретной реализации в вашей организации.
Архитектура связи между слоями данных и семантикой
Архитектура связки Lakehouse и семантического слоя строится вокруг нескольких взаимосвязанных слоев, которые обеспечивают плавный поток от исходных данных к бизнес-инсайтам.
- Raw слой: хранение источников в их естественном виде. Здесь сохраняются данные без изменений, что обеспечивает полную трассируемость и возможность повторной загрузки.
- Cleansed/Curated слой: превентивная очистка, нормализация и базовые вычисления, направленные на создание пригодной для анализа основы.
- Semantic layer (бизнес-слой): концептуальная модель, включающая факты, измерения, метрики и бизнес-правила. Этот слой предоставляет единый словарь, бизнес-термины и контрактную логику.
- Data product layer: ориентированная на потребителей доставка через готовые наборы данных, которые можно использовать в BI, отчетности и аналитике.
- Access и governance layer: безопасность, аудит, управление версиями схем, lineage и качество данных.
Единая связка достигается через четко определенные соглашения - контракты данных и контракты семантики. Контракты данных описывают наборы данных: источники, качество, частоту обновления и ответственность за доставку. Контракты семантики задают термины, согласованные определения метрик и эталонные вычисления. В идеальной реализации контракты синхронизированы и поддерживаются в реальном времени или near real-time, чтобы потребители аналитики работали с единым словарем и едиными вычислениями.
Интеграция между слоями осуществляется через единый каталожный сервис и метаданные: схемы, версии, зависимости и lineage. Каталоги должны поддерживать версионирование, чтобы можно было возвращаться к предыдущим версиям моделей и метрик при необходимости. Важной практикой является внедрение механизмов согласования имени объектов, чтобы любые изменения в названиях полей и таблиц автоматически отражались в соответствующих бизнес-терминах, снижая риск расхождений в отчетах.
-- Пример: создание бизнес-слоя через представление над фактами и измерениями
CREATE OR REPLACE VIEW fct_order AS
SELECT
  o.order_id,
  o.customer_id,
  SUM(oi.quantity * oi.price) AS total_amount,
  d.calendar_date AS order_date_key
## FROM raw.orders o
JOIN raw.order_items oi ON oi.order_id = o.order_id
JOIN dim_date d ON d.date_key = o.date_key
GROUP BY o.order_id, o.customer_id, d.calendar_date;
Такой пример иллюстрирует стиль, когда слой фактов оборачивается в представление, которое затем служит единым источником для семантики. В реальной среде кода придется учитывать специфические особенности движков Lakehouse, типовую схему именования и требования к безопасному доступу.
Моделирование семантики: факты, измерения, контракты и версии
Семантический слой строится вокруг нескольких ключевых концепций: факты, измерения, и их контекст - бизнес-термины и правила расчета. Модель должна быть не только технически корректной, но и понятной представителям бизнеса: руководству, финансистам, продакт-менеджерам. В этом контексте выделяют несколько обязательных аспектов.
-
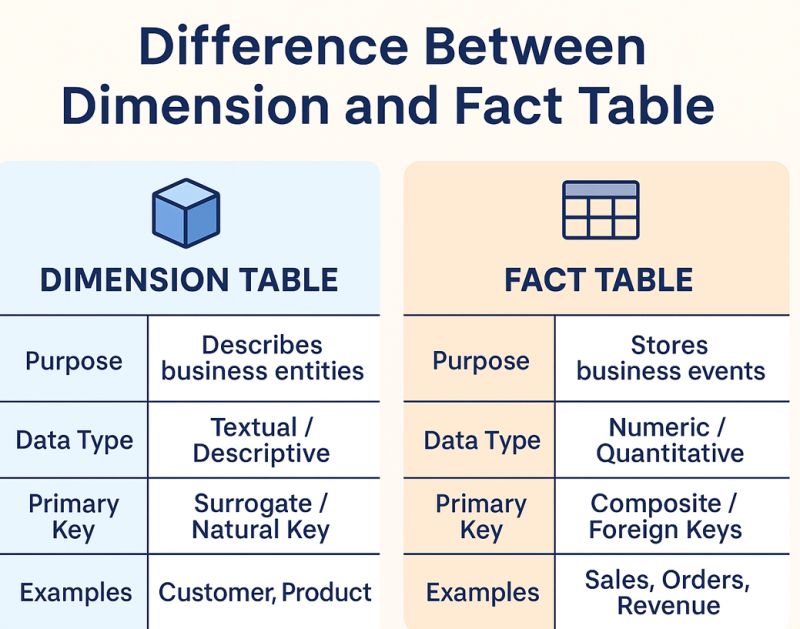
Факты: количественные показатели деятельности за определенный период. Факты должны иметь ключевые размерности для агрегации (например, заказ, клиент, дата).
-
Измерения: понятия, по которым производится анализ: сумма продаж, количество заказов, средний чек. Измерения должны иметь единый формат и единицы измерения.
-
Бизнес-термины: словарь, где каждому фактору соответствует определение, формула расчета и предполагаемый источник. В идеале словарь должен быть доступен через центральный порталментающий сервис и поддерживать межъязыковое соответствие.
-
Правила расчета и меры: вычислительная логика измерений должна быть определена явно и использоваться во всем конвейере. В отдельных случаях можно вынести логику в отдельный слой «метрик» для повторного использования.
-
Контракты данных и контракты семантики: контракты данных описывают наборы данных, их качество, частоту обновления и ответственность. Контракты семантики описывают вычисления мер, правила агрегации и параметры расчета. Оба типа контрактов должны быть синхронизированы и поддерживаться в продакшене.
-
Версии и эволюция схем: семейство версий моделей и схем позволяет отслеживать изменения и управлять совместимостью. Важно внедрять процессы уведомления об изменениях и откаты, чтобы потребители могли адаптироваться к обновлениям без потери достоверности аналитики.
-
Глоссарий бизнеса и техника: поддержка единых терминов в виде доступного глоссария устраняет двусмысленности между бизнес-терминами и названиями полей.
В практической реализации на уровне Lakehouse следует использовать централизованный каталог метаданных, в котором хранится связь между бизнес-терминами и физическими объектами, версиями схем и миграциями. Поддержка lineage - прослеживаемость данных от источников до конечной аналитики - критически важна для аудита и доверия к данным.
Если говорить об открытых технологиях, то концептуально полезно опираться на примеры безопасной и стабильной семантики: единая модель фактов и измерений, совместимые правила расчета и строгая версия. В этом плане обработка изменений в источниках и в требованиях к метрикам становится управляемым процессом, а не случайной модернизацией.
Инженерия данных и примеры реализации
Этапы реализации связки Lakehouse и семантического слоя включают: выбор форматов и движков, проектирование модели семантики, настройку конвейеров загрузки, внедрение управляемых контрактов и обеспечение безопасности.
-
Выбор форматов и движков: для Lakehouse предпочтительны форматы колоночного типа (Parquet, ORC) и управляемые транзакции через соответствующий слой хранения (Delta Lake, Apache Iceberg). Эти технологии обеспечивают ACID-совместимость и надежную работу аналитических запросов на больших объемах данных.
-
Проектирование модели семантики: требуется определить основные бизнес-объекты (факты и измерения), их атрибуты и связи между ними. Важно предусмотреть hierarchies и drill-downs, единый словарь и правила вычисления метрик.
-
Конвейеры загрузки: ELT-подходы чаще предпочтительны для Lakehouse. Необходимо разделение слоев: сырые данные попадают в Raw, очищенные - в Curated, а затем - в представления семантики и в data products.
-
Контракты и governance: созданием контрактов занимаются владельцы данных и бизнес-аналитики. Технологически это сопровождается метаданными, версиями схем и процессами уведомления об изменениях.
-
Безопасность и соответствие: на уровне Lakehouse обеспечивает управление доступом к данным, ролями и политиками. В контексте семантики следует внедрить row-level security и маскирование чувствительных данных по контексту потребителя.
-- Пример простого расчета на уровне слоя семантики
CREATE OR REPLACE VIEW v_sales_summary AS
SELECT
  region,
  SUM(total_amount) AS total_revenue,
## AVG(order_value) AS avg_order_value,
  COUNT(DISTINCT customer_id) AS active_customers
FROM fct_order
GROUP BY region;
В примере показывается, как представление на уровне семантики агрегирует данные из фактов. Реальная реализация может включать дополнительные меры качества, кросс-срезы и вкладку в глоссарий, чтобы обеспечить единообразие определения по регионам, временным периодам и валютам.
Реализация сценариев внедрения и управление изменениями
Успешный переход к Lakehouse с семантикой требует системной организации работ и согласованных ролей:
-
Роли и ответственности: Data Product Owner отвечает за семантику и качество бизнес-метрик; Semantic Modeler - за модель и соответствие терминам; Data Engineer - за конвейеры и доступ к данным; Data Steward - за качество данных и соответствие политик; QA-инженер по данным - за тестирование и проверку контрактов.
-
Этапы внедрения: диагностика текущих данных и потребностей, создание бизнес-глоссария, проектирование семантического слоя, настройка контрактов и governance, пилотный запуск, масштабирование на другие домены, постоянное улучшение.
-
Best practices: начинать с малого набора критических метрик, обеспечить быстрое получение ценности, внедрить тахометр качества и lineage с самого начала; затем расширять слой семантики на новые предметные области.
-
Риски и контрмеры: риск непоследовательности в терминах, риск рассогласования между техническими и бизнес-метриками, риск чрезмерной сложности семантики. Контрмеры включают четкую версию контрактов, процесс согласования изменений и регулярные ревью glossary.
-
Внедрение в организации: требуется культурная и организационная трансформация, в том числе внедрение роли Data Product Owner и расширение компетенций в области управления данными среди бизнес-подразделений. Важно обеспечить сотрудничество между командами BI, дата-инженерии и бизнес-аналитиками для достижения общей цели - единообразной и понятной аналитики.
Практические сценарии применения
-
Продажи и маркетинг: единый факт продаж и связанные измерения позволяют формировать KPI по регионам, каналам и продуктовым линейкам. Семантика обеспечивает согласованные расчеты маржи, повторное использование метрик в разных дашбордах и отчетах.
-
Финансовая аналитика: согласование дефиниций выручки, затрат и рентабельности. Семантический слой обеспечивает консолидацию между подразделениями и единый подход к календарной разбивке и валютным курсам.
-
Операционная аналитика: отслеживание цепочек поставок, запасов и среднего времени выполнения заказа. Семантика обеспечивает понятие статусов, этапов и бизнес-процессов, интегрируемых с BI-слоем и операционными дашбордами.
-
Подготовка данных для ML: предоставление чистых и описательных наборов признаков через semantic layer, с документированными определениями полей и расчетов, что упрощает повторяемость экспериментов и воспроизводимость моделей.
Архитектурные паттерны и организационные выводы
-
Паттерн «единый источник истины» через Lakehouse и семантику минимизирует дублирование вычислений и расхождения между отделами. Важным элементом является поддержка версий схем и контрактов, чтобы потребители могли безопасно использовать обновления без риска неверных выводов.
-
Паттерн распределения слоев: Raw, Curated, Semantic и Data Product слои разделяют ответственность за данные и позволяют бизнесу работать с понятной абстракцией, не завися от специфики технического стека.
-
Паттерн управления изменениями: внедрять процесс уведомления об изменениях в терминах и метриках, автоматическое распространение обновлений в конвейеры и отчеты. Это снижает риск низкой адаптации к изменениям и повышает доверие к данным.
-
Риск управляемости: чрезмерная сложность семантики может привести к медленному внедрению и трудностям поддержки. Рекомендуется ограничить первичную область семантики несколькими критически важными метриками и постепенно расширять coverage.
-
Взаимодействие с open-source и локальными решениями: выбор Delta Lake или Apache Iceberg в качестве ядра хранения, а также стандартизированные подходы к метаданным позволят обеспечить устойчивую экосистему и совместимое развитие. Важно не перегружать архитектуру сторонними решениями без объективной пользы для бизнес-ценности.
Key takeaways
- Data Lakehouse и семантический слой образуют единый конвейер для фактов и измерений, где хранение остается гибким, а аналитика - понятной и управляемой.
- Контракты данных и контракты семантики обеспечивают согласованность между источниками и потребителями, а также позволяют управлять изменениями версий.
- Моделирование семантики фокусируется на фактах, измерениях, бизнес-терминах и правилах расчета, что позволяет единообразно определять KPI и метрики.
- Инженерия данных требует четкой архитектуры слоев, управляемых конвейеров и строгих политик безопасности и качества.
- Внедрение - это organizational and governance challenge: роли, процессы и культура сотрудничества между бизнесом и IT критически важны для достижения устойчивой аналитики.
- Практические сценарии показывают ценность: от продаж и финансов до операционной эффективности и ML-подготовки, когда семантика упрощает доступ к данным и снижает риск расхождений в отчетности.
- Архитектурные паттерны помогают снизить риск и увеличить скорость внедрения, но требуют дисциплины в управлении изменениями и версионировании.
FAQ
- Что такое Data Lakehouse и зачем нужен семантический слой?
Data Lakehouse - это архитектура, которая совместимо хранит данные в lake-форматах с поддержкой транзакций и быстрых запросов. Семантический слой предоставляет бизнес-ориентированную абстракцию над данными, стандартизирует определения метрик и правила расчета, что снижает риск расхождений между подразделениями и упрощает доступ к данным через единый словарь и контракты.
- Какие основные слои архитектуры и как они взаимодействуют?
Слои включают Raw (сырые данные), Curated (очищенные данные), Semantic (бизнес-слой с фактами, измерениями и метриками), Data Product (готовые наборы данных для потребителей) и Governance (политики доступа и lineage). Взаимодействие строится через единый каталог метаданных и контракты данных/семантики: факты и измерения доступны через представления в Semantic слое, а Data Product - по готовым вьюхам и API.
- Какую роль играет семантический слой в бизнес-трансляции?
Семантический слой переводит технические названия столбцов в понятные бизнес-термины, обеспечивает унифицированные определения метрик и логику расчета. Он становится «переводчиком» между инженерами данных и бизнес-пользователями, позволяя строить доверительную аналитику и унифицировать отчеты.
- Какие риски связаны с внедрением и как их минимизировать?
Основные риски - несогласованность терминов, разнобой в определениях метрик, сложность поддержки семантики и сопротивление изменениям. Минимизировать можно через раннее создание бизнес-глоссария, четкие контракты данных и семантики, версионирование схем и регламентированные процессы согласования изменений.
- Какие практики помогают обеспечить качество данных в Lakehouse?
Внедрять тестирование контрактов данных и метрик, осуществлять lineage и аудит данных на всех уровнях, использовать политики качества и автоматическую валидацию данных при загрузке. Важна параллельная работа над качеством как в техническом слое, так и в бизнес-слое, чтобы определить, что именно считается «чистыми» данными.
- Как начать миграцию на Lakehouse с семантикой?
Начать можно с пилота на критических бизнес-метриках: определить 2-3 факта и соответствующие измерения, сформировать базовый глоссарий и контракты, внедрить простейший слой семантики и пару Data Product для бизнес-пользователей. Постепенно расширять охват и настраивать процессы управления изменениями и версионирования.
- Какие роли и организационные изменения требуются для успеха?
Необходимо определить роли Data Product Owner, Semantic Modeler, Data Engineer, Data Steward и QA-инженера по данным. Важно внедрить процессы кросс-функционального планирования, совместные ревью контрактов и регулярные встречи по глоссарию. Цель - создать культуру совместной ответственности за единое понимание данных.
- Какие примеры открытых технологий уместны для старта?
Как ориентиры можно рассмотреть Delta Lake и Apache Iceberg как реализации открытых форматов с поддержкой транзакций и управляемой схемой. Они иллюстрируют принципы единого источника истины и позволяют развивать архитектуру Lakehouse без привязки к конкретному поставщику.
- Какие практические ограничения стоит учитывать при дизайне семантики?
Важно избегать избыточной сложности: ограниченная начальная область семантики, понятные термины, понятие источников и версий. Ранняя фокусировка на критически важных KPI и постепенная эволюция mitigates риски дублирования расчетов и непонимания между бизнес-единицами.


