

Модели данных для запасов, партий и пространственной географии
В условиях централизованного хранения и распределения в рамках курсового проекта In&Out модели данных для запасов, партий и географии поставок становятся основой для управляемости, прозрачности и гибкости цепочек поставок. Глубокое понимание связанных концепций позволяет скоординировать операции между WMS, ERP и GIS-системами, обеспечить точное исполнение заказов, управлять ограниченными партиями и строить адаптивную географическую карту поставок. Настоящая глава предлагает методологию проектирования и внедрения моделей данных, ориентированную на практику: от принципов архитектуры и управления качеством данных до алгоритмов распределения запасов и организационных изменений.
Рациональная модель данных по запасам и партиям должна поддерживать не только текущее состояние запасов, но и динамику движений, планируемые и фактические параметры поставок, а также географическую инфраструктуру хабов и маршрутов. В условиях ограниченных партий особенно важна преемственность данных, единая лексика атрибутов, согласованные политики идентификации и механизмов согласования между источниками данных. Методология, предлагаемая в этой главе, ориентирована на создание устойчивой основы для аналитики, мониторинга и управленческого контроля в условиях изменений спроса, сезонности и географических факторов.
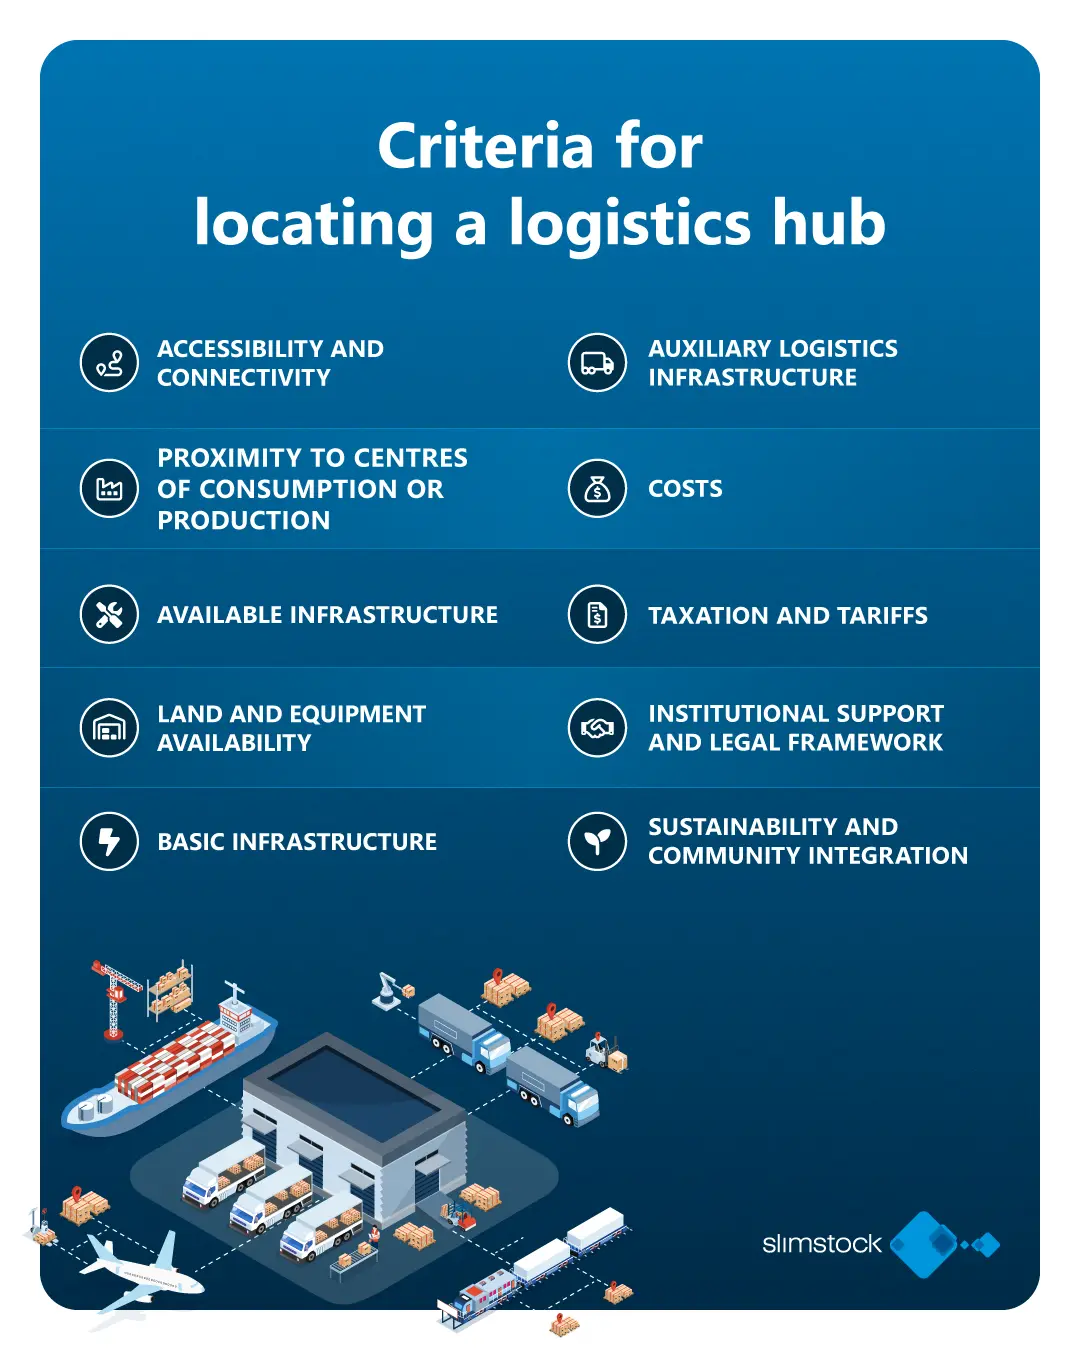
Ключевые идеи главы:
- проектирование канонической модели данных для запасов и партий; разделение бизнес-логики и физической реализации; обеспечение совместимости между WMS, ERP и GIS;
- включение пространственных данных и географических иерархий; управление точностью, обновлением и качеством геоданных;
- подходы к централизованному хранению: данные о запасах в виде омиксовой архитектуры (ядро-маркеры-умные агрегаты), обеспечение lineage и версионности;
- принципы управления ограниченными партиями: правила распределения, прозрачность исполнения, аудиты и согласование;
- план внедрения: шаги по организации данных, управлению изменениями, KPI и компетентностям команд.
Краткое содержание главы
- Определение и структурирование основных сущностей запасов и партий, их атрибутов и зависимостей, а также принципы канонизационной модели данных.
- География поставок: организационная и географическая иерархия, точность геоданных, интеграция с картографическими сервисами.
- Архитектура данных для централизованного хранения: слой хранения, процессы ETL/ELT, управление качеством и безопасностью.
- Управление ограниченными партиями: правила, алгоритмы распределения, сценарии планирования и исполнения.
- Практические подходы к внедрению: организационные изменения, процессы управления данными, KPI и методы контроля качества.
Основные концепции моделирования запасов и партий
В первую очередь следует зафиксировать бизнес-смысл двух ключевых доменов: запасов и партий. Запасы отражают текущее состояние запасаемого объема в хабах, расположеных на складе, центральном распределительном узле или зоне пополнения. Партии же описывают конкретные порции товара с уникальной идентификацией, временем выпуска, сроками годности и прочими характеристиками. Модель должна поддерживать как операционные задачи (прием, размещение, сбор заказов, отгрузка), так и аналитические задачи (планирование спроса, управление рисками истечения срока годности, оптимизация маршрутов).
Ключевые принципы здесь:
- единая идентификация и единый словарь атрибутов для запасов и партий;
- поддержка нескольких уровней единиц измерения и конверсионных правил;
- прозрачная связь между запасами на конкретной площадке и партийными характеристиками;
- поддержка исторических изменений: версии атрибутов, аудиты и lineage.
Архитектурные принципы
Целью проектирования является отделение бизнес-логики от технической реализации, чтобы можно было масштабировать хранение и анализ без потери согласованности данных. В архитектуре рекомендуется использовать каноническую модель данных для запасов и партий, где основные сущности и их атрибуты стабильно определены и согласованы между системами (WMS, ERP, TMS, WFM). Важно обеспечить:
- поддержание единого источника истины по запасам и партиям с явной линейной связью к локейшнам;
- версионность и аудит изменений атрибутов;
- модульность: ядро хранения, сервисы интеграции, слои аналитики.
Ключевые сущности и атрибуты
- Запас: sku_id, единица измерения (uom), количество_on_hand, количество_allocated, quantity_in_transit, location_id, status (на складе, зарезервирован, в создании заказа и т. п.).
- Партия: batch_id, sku_id, production_date, expiry_date, lot_attributes (температура, условия хранения), quantity, reserved_quantity, origin_supplier, quality_status.
- Локация: location_id, type (хаб, склад, точка отгрузки, терминал), география (регион, округ, город), координаты (lat, lon) и границы обслуживания.
- Операционные сигналы: inbound_batch, outbound_order, reconciliation, adjustments (возвраты, коррекции запасов).
Рационально поддерживать связь между запасами и партиями через атрибуты batch_id и sku_id, что позволяет проследить, какие партии задействованы в конкретных операциях, и как изменяются запасы по партиям во времени. Введение единых атрибутов качества и статусов упрощает контроль выполнения заказов и оптимизацию запасов.
Управление качеством данных
Качественные данные лежат в основе операционной точности. Необходимо регламентировать:
- источники данных и правила сопоставления (source-of-truth);
- процедуры дедупликации и нормализации имен и кодов;
- режимы валидации входящих данных (сопоставление SKU, соответствие batch_id, корректность дат);
- мониторинг полноты и согласованности данных, SLA для исправлений;
- ревизии и аудит изменений атрибутов.
Для поддержки аудита полезна версия атрибутивной модели, чтобы можно было отследить историю изменений и обосновать любые корректировки данных. В качестве инструментов можно рассмотреть open-source решения на базе PostgreSQL с расширением audit-логирования или коммерческие решения, предоставляющие встроенные механизмы lineage.
Пространственная география и геоданные
География поставок и распределения является критическим элементом в логистических хабах In&Out. Она обеспечивает корректное планирование маршрутов, точное распределение запасов по регионам и прозрачность исполнения заказов в разрезе локаций. В рамках методологии следует рассмотреть пространственные иерархии, точность геоданных и интеграцию с картографическими сервисами.
Географическая иерархия
Структура геоданных должна отражать реальную организацию сети: страна → регион → город → локация (хаб, распределительный центр, точка отгрузки). Каждый уровень иерархии должен иметь уникальный идентификатор и валидируемые атрибуты, связанные с запасами и партиями. Это обеспечивает корректную агрегацию запасов по регионам, планирование пополнений и оценку сервис-уровней.
Геодезическая точность и статус данных
Геоданные требуют регулярного обновления и проверки точности. Важно определить минимально приемлемый уровень точности для каждого типа локации и сценариев маршрутизации. Геокоординаты и пространственные границы (полигоны зон ответственности) должны поддерживаться в базе с версионностью. Необходимо предусмотреть источники данных: официальные реестры, картографические сервисы, геокодирование по адресам, а также процессы синхронизации и контроля качества.
Интеграция с картографическими сервисами
Для пространственного анализа применяются GIS-инструменты, которые позволяют визуализировать географическую раскладку запасов, оптимизировать маршруты и создание зон обслуживания. В ядре методологии допускается использование открытых решений: PostGIS как расширение для PostgreSQL обеспечивает мощные пространственные запросы и хранение геометрий локаций; QGIS может служить клиентской платформой для анализа и визуализации. При этом следует соблюдать баланс между открытыми технологиями и теми, что применяются в реальной среде заказчика (например, российские ERP- или WMS-решения). Интеграция может включать обмен данными через унифицированные API и событийные потоки, чтобы обеспечивать синхронизацию геометрий и запасов в реальном времени.
Архитектура данных для централизованного хранения
Централизованное хранение запасов и партий требует четко спроектированного слоя данных, который обеспечивает устойчивость к изменениям объема и сложности аналитики. В рамках методологии выделяются слои, правила интеграции и контроль доступа, которые позволяют поддерживать согласованность и управляемость.
Модели хранения
- Ядро запасов и партий: базируется на канонической модели с едиными идентификаторами SKU и batch_id; хранение атрибутов в нормализованной форме для оперативной эффективности.
- Слои аналитики: дата-слой и витрины данных (data marts) по запасам, партиям и географии, поддерживающие оперативную аналитику и планирование.
- Архитектура событий: потоковые решения (например, событийный шина) для передачи изменений от WMS/ERP к центральному хранилищу и обратно.
Рекомендуется избегать избыточного дублирования данных в каждом источнике, вместо этого применять концепцию единого источника истины и сопоставления через мастер-данные (MDM).
Примечание: использование открытых технологий, таких как PostgreSQL с расширением PostGIS для пространственных данных, обеспечивает устойчивость и гибкость. Для интеграции источников данных можно рассмотреть открытые брокеры сообщений (например, Apache Kafka) или российские корпоративные решения, если они соответствуют требованиям по безопасности и совместимости.
Интеграционные протоколы
Стратегия интеграции должна охватывать:
- единый API контракта между системами (ERP, WMS, TMS, GIS) с версиями и схемами;
- подходы к синхронной/асинхронной синхронизации данных;
- согласование кодов и справочников (единицы измерения, статусы запасов, коды лотов);
- обработку конфликтов и линеек изменений с журналированием.
Безопасность и соответствие
Обеспечение доступа к данным, их защиты и соответствия требованиям регуляторов является неотъемлемой частью проекта. Рекомендованы:
- многоуровневое управление доступом и ролями;
- аудит действий пользователей и изменений данных;
- шифрование чувствительных полей и обеспечения целостности данных.
Управление ограниченными партиями
Ограниченность партий требует четких политик и алгоритмов распределения запасов. Эффективное управление этими аспектами снижает риски дефицита, улучшает обслуживание клиентов и снижает себестоимость запасов.
Правила и политики
Необходимо формализовать политики allocation (распределения) и reservation (резервирования) по следующим параметрам:
- приоритеты по клиентам, географии, срочности заказов и срокам годности;
- правила резервирования на стороне склада и в системе планирования;
- политики обработки дефицита (когда запас ограничен и как распределять остатки).
Эти политики должны быть документированы, прозрачны и поддаваться аудиту. Важно внедрить механизмы эскалации и согласования в случаях конфликтов между заказами.
Алгоритмы распределения запасов
Алгоритмы могут быть простыми или комбинированными в зависимости от бизнес-правил:
-Priority-based Allocation: распределение по критериям срочности, клиентскому сегменту и региону.
-Expiration-aware Allocation: учет срока годности, предпочтение партиям с близким сроком годности.
-Restrictions-aware Allocation*: учет ограничений по условиям хранения, температурам и требованиям к перевозке.
Комбинация алгоритмов может строиться через весовые функции, позволяя адаптировать логику под конкретные сценарии.
Процессы планирования и исполнение
Операционная часть включает:
- планирование пополнения и ревизий запасов по партиям в разрезе локаций;
- управление резервами и отменами резерва в случае изменений спроса;
- контроль исполнения заказов в рамках географической структуры и маршрутов;
- аудит и мониторинг исполнения для выявления узких мест и некорректностей.
Практики внедрения и организационные изменения
Переход к новой архитектуре данных требует не только технических решений, но и организационных изменений. Внедрение методологии предполагает совместные усилия: ИТ-отдел, операционные команды, аналитики и руководство.
Организационные изменения
- выработка общей лексики и стандартов для запасов, партий и географии;
- формирование команд ответственности за данные (data owners, data stewards) с четкими KPI;
- создание механизма управления изменениями: ревизии моделей, тестовые стенды, регламенты миграции;
- внедрение культуры данных: регулярные обзоры качества данных, обучающие программы.
Процессы внедрения
- начальная диагностика существующих источников данных и профилей качества;
- проектирование канонической модели, согласование атрибутов и взаимоотношений;
- миграция данных с минимальным простоем, этапность и валидация;
- настройка процессов ETL/ELT, мониторинга и алертов;
- пилотные сценарии на ограниченном наборе локаций и партий, затем масштабирование.
Контроль качества и KPI
Ключевые KPI для методологии включают:
- точность запасов (inventory accuracy);
- полнота партийной информации (batch completeness);
- время цикла инвентаризации и регламенты рассчитанной скидки на просрочку;
- доля запасов по партиям с высокой степенью просрочки;
- качество геоданных (гео-актуальность, точность координат);
- время обработки изменений и редактирования данных;
- согласованность данных между системами (MDM lineage).
Взаимодействие с командами
Необходимо обеспечить четкую коммуникацию и совместную работу между:
- ИТ-архитекторами и инженерами данных;
- операционными менеджерами складов и логистики;
- аналитиками и бизнес-аналитиками;
- руководством по рискам и комплаенсу.
Key takeaways
- Каноническая модель данных для запасов и партий обеспечивает единый источник истины и упрощает интеграцию между системами.
- География поставок требует формализации географической иерархии, точности геоданных и поддержки пространственных запросов через GIS-инструменты.
- Архитектура централизованного хранения должна включать ядро запасов и партий, слои аналитики и событийную инфраструктуру с версионностью.
- Управление ограниченными партиями требует прозрачных политик, алгоритмов распределения и прозрачной аудируемой эксплуатации.
- Внедрение методологии требует управленческих изменений, четких процессов управления данными и определения KPI для устойчивого эффекта.
FAQ
- Что такое каноническая модель данных и зачем она нужна в рамках In&Out?
- Каноническая модель данных - это согласованный набор сущностей, атрибутов и связей, который служит единственным источником истины для запасов, партий и географии. Она упрощает интеграцию между системами (WMS, ERP, GIS), уменьшает дубликаты данных и облегчает масштабирование. В контексте In&Out такая модель позволяет точно отслеживать, какие партии задействованы в конкретных заказах, и как запасы перераспределяются между хабами, при этом сохраняется возможность детального аудита и аналитики.
- Какие атрибуты критичны для партий и почему?
- Критичные атрибуты партии включают batch_id, sku_id, production_date, expiry_date, quantity, reserved_quantity, origin_supplier и quality_status. Они необходимы для контроля срока годности, планирования пополнений, анализа убыточности и соответствия требованиям к условиям хранения. Наличие этих атрибутов позволяет автоматически применять алгоритмы перемещения и распределения, минимизируя риск истечения срока годности или дефицита в определённых локациях.
- Как интегрировать геоданные с запасами без потери согласованности?
- Интеграция геоданных строится вокруг единой географической иерархии и единых идентификаторов локаций. Геоданные должны храниться в каноническом виде с поддержкой версионности и обновляться через ETL/ELT-цепочки. Важно обеспечить единый набор геокоординат и границ для каждой локации, синхронизируемых с GIS-инструментами (PostGIS, QGIS). Это позволяет видеть карту обслуживания, планировать маршруты и анализировать влияние географии на исполнение заказов.
- Какие архитектурные паттерны применяются для централизованного хранения?
- Рекомендуются слои: ядро хранения запасов и партий, слой аналитики (data warehouse и data marts), и событийный слой для передачи изменений между системами. Архитектура должна поддерживать версионность атрибутов, lineage и четко заданные API между системами. Выбор технологий может включать PostgreSQL с PostGIS для хранения данных и геометрий, а также брокеры сообщений (например, Kafka) для событийной синхронизации.
- Как организовать управление изменениями и качество данных?
- Важна роль data stewards и clear governance. Необходимо регламентировать источники данных, правила сопоставления кодов и атрибутов, процедуры валидации входящих данных, мониторинг полноты и согласованности, а также аудит изменений. Внедряются тестовые стенды и пилоты, чтобы проверять новые модели на реальном наборе локаций и партий без риска для основной системы.
- Какие подходы к управлению ограниченными партиями наиболее эффективны?
- Эффективность достигается через прозрачную политику распределения: учитывать приоритеты клиентов и регионов, срок годности и условия хранения. Алгоритмы могут комбинировать правила и использовать взвешенные функции, которые адаптируются под сценарий (верховенство срочности, ограничение по ресурсам, сезонные пики спроса). Важно держать верифицированные результаты и возможность аудита исполнения.
- Какие KPI полезно использовать для контроля модели данных?
- Точность запасов, полнота партийной информации, скорость обновления данных, доля партий с просрочкой, точность геоданных и согласованность между системами. KPI должны связывать операционные показатели с данными и архитектурными элементами, чтобы управлять качеством, эффективностью и рисками.
- Как организовать миграцию данных на новую модель?
- Вначале выполняется аудит текущих источников и атрибутов, формируется план миграции с поэтапной реализацией, проводится тестирование на пилотной зоне, затем - поэтапное развёртывание. Важно поддержать откаты и регламенты валидации на каждом этапе, чтобы минимизировать downtime.
- Какие риски связаны с внедрением модели данных и как их минимизировать?
- Основные риски: несогласованность кодов, низкая качество данных, задержки обновления, сопротивление изменениям со стороны сотрудников. Их минимизируют через вовлечение бизнес-пользователей в процесс проектирования, качественные политики управления данными, автоматизированные проверки и постоянную коммуникацию между подразделениями.
- Какую роль играют открытые и российские продукты в реализации методологии?
- Открытые решения (например, PostgreSQL с PostGIS для хранения и геопространственных запросов, QGIS для визуализации) дают гибкость и активное сообщество поддержки. Российские продукты могут применяться там, где требуется соответствие требованиям локального регулирования или интеграция с существующей инфраструктурой заказчика (например, 1С: ERP в рамках отраслевой цепочки). В любом случае следует соблюдать баланс между технологической эффективностью и требованиями безопасности, совместимости и поддержки.


