

Apache Spark для Data Engineer
Apache Spark остаётся одним из ключевых инструментов для разработки ETL и ELT-пайплайнов, обработки больших данных и подготовки аналитических витрин. Он особенно полезен там, где нужно работать с большими объёмами данных в Parquet, S3, ADLS, GCS, Lakehouse и корпоративных аналитических платформах.
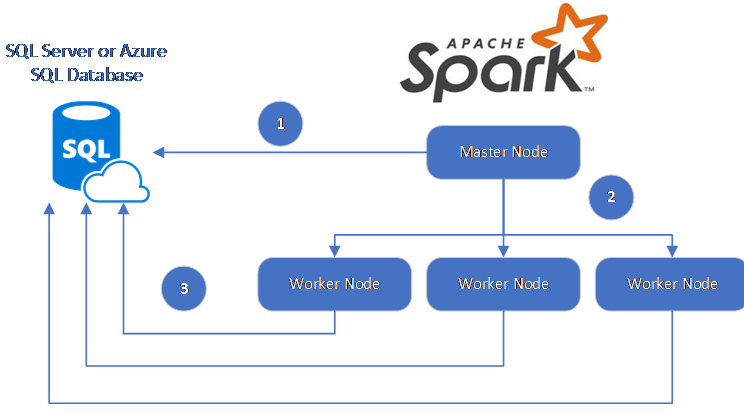
Описание ориентировано на практические задачи дата-инженера: Spark SQL, DataFrame API, оптимизация запросов, работа с форматами Parquet, ORC, Avro, проектирование batch- и streaming-пайплайнов, интеграция с Hive Metastore, Glue, Iceberg, Delta Lake и BI-системами. Отдельный акцент — производительность: партиционирование, кэширование, сериализация, статистика, план выполнения и настройка кластеров.
Такой материал помогает проектировать Spark-пайплайны как промышленный компонент data-платформы: с тестированием, data quality, CI/CD, observability, безопасностью, обработкой ошибок, SLA, runbooks и контролем стоимости владения.
- Введение: Spark и экосистема
- Архитектура Apache Spark: компоненты, роли, жизнь задач
- Spark SQL и DataFrame API: концепции моделирования данных
- Хранение данных: Parquet и другие форматы, компрессия, схемы
- Lakehouse и Data Lake: принципы интеграции
- ETL и ELT: стратегии преобразования данных и вычислений
- Архитектурные паттерны пайплайнов: модульность, повторное использование, конвейеры
- Облачные хранилища и интеграция с облаком: S3/ADLS/GCS и др.
- Каталоги и метаданные: Hive Metastore, Glue, Iceberg
- Оптимизация Spark SQL: планировщик, статистика, обеспечение качества
- Производительность и настройка: конфигурации, сериализация, кэширование
- Расширенный DataFrame API: операции, UDF, функции, агрегаты
- Форматы данных и сериализация: Parquet, ORC, Avro, nested
- Стратегии обработки потоковых данных: Structured Streaming, watermarking, windowing
- Управление кластерами: YARN, Kubernetes, Standalone
- Мониторинг и observability: UI, метрики, tracing
- Разработка и тестирование пайплайнов: unit/integration tests, data quality
- Управление качеством данных: схемы эволюции, валидация, drift
- Безопасность, конфиденциальность и соответствие: IAM, шифрование, аудит
- CI/CD для Spark пайплайнов: репозитории, пайплайны, инфраструктура как код
- Устойчивость и обработка ошибок: retries, идемпотентность, exactly-once
- Batch против Streaming: гибридные сценарии и консистентность
- Архитектура Lakehouse и отраслевые шаблоны: semantic layer, governance
- Интеграция с BI и аналитическими платформами: коннекторы и визуализация
- Интеграция ML: feature store, онлайн и оффлайн службы
- Масштабирование пайплайнов: партиционирование, кластерная эластичность
- Выбор инструментов и технологий: критерии, trade-offs
- Практические кейсы по отраслям: банки, телеком, ретейл
- Миграции и эволюция существующих пайплайнов
- Экономика Spark: стоимость владения и оптимизация затрат
- Эксплуатация и операционная модель: SLA, runbooks, управление инцидентами
- Рубеж зрелости и дорожная карта: maturity model, KPI


