

Apache Spark с нуля
Apache Spark — платформа для распределённой обработки данных, которая позволяет строить ETL-процессы, аналитические расчёты, batch-обработку, streaming-сценарии и ML-пайплайны на больших объёмах данных. Эта тема подходит для тех, кто хочет понять Spark не только на уровне кода, но и на уровне архитектуры: как выполняются задачи, почему одни запросы работают быстро, а другие становятся дорогими и нестабильными.
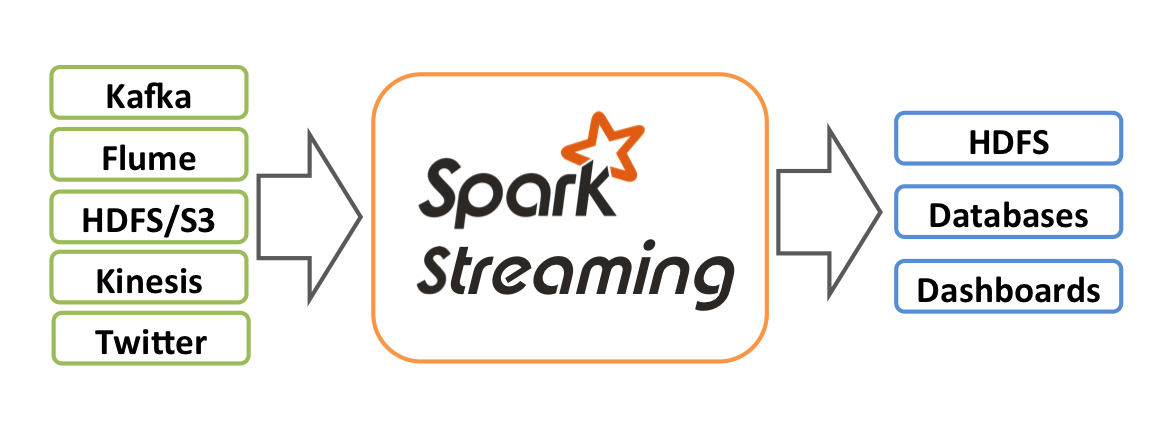
Описание охватывает базовые принципы Spark: драйвер, executors, кластеры, менеджеры ресурсов, Spark SQL, DataFrame, DataSet API, Catalyst, Tungsten, UDF, оконные функции, форматы Parquet, ORC, Avro, JSON, CSV и интеграции с HDFS, S3, Delta Lake, Iceberg и Hudi. Через эти темы становится понятнее, как строить повторяемые ETL-пайплайны и аналитические процессы для больших данных.
Материал постепенно переходит от основ к реальным инженерным задачам: развёртывание Spark в кластере, Kubernetes и облаке, мониторинг, диагностика, безопасность, data governance, тестирование, оптимизация производительности и миграция legacy ETL на современную Spark-архитектуру.
- Введение в Apache Spark и роль в экосистеме больших данных
- Основы распределенной обработки данных: принципы, модели и парадигмы
- Архитектура Spark: драйвер, исполнители, кластеры и менеджеры ресурсов
- Spark SQL и DataFrame: структура данных, API и сценарии использования
- Теоретические основы производительности Spark: модель вычислительных затрат, планирование и сложности
- Catalyst и Tungsten: механизмы оптимизации запросов
- Архитектурные паттерны Spark: пакетная и потоковая обработка
- Хранилища данных и интеграции: HDFS, S3, Delta Lake, Iceberg, Hudi
- Форматы данных и кодеки: Parquet, ORC, Avro, JSON, CSV
- Управление схемами и обеспечение качества данных
- DataFrame API: выборки, агрегации, соединения и оконные функции
- DataSet API и статическая типизация
- UDF и встроенные функции: расширение возможностей Spark
- MLlib: машинное обучение в Spark, пайплайны и подбор параметров
- Конвейеры ETL: конвейеры зависимостей, репликация и повторяемость
- Реализация и внедрение ETL-пайплайнов на Spark
- Развертывание Spark: кластеры, конфигурации и версии
- Spark на Kubernetes и в облаке: подходы к развёртыванию
- Безопасность и соответствие требованиям: IAM, аудит и защита данных
- Мониторинг и диагностика: метрики, логи и инструменты observability
- Надёжность и отказоустойчивость: резервное копирование и восстановление
- Управление данными и data governance в Spark-проектах
- Масштабирование и зрелость Spark-инфраструктуры
- Тестирование Spark-приложений: unit, integration и data quality tests
- Практические кейсы: ETL и аналитика больших данных в бизнесе
- Риски и типовые ошибки в Spark-проектах
- Архитектура потоковой обработки: Structured Streaming и режимы обработки
- Data lakehouse и современные архитектурные паттерны
- Оптимизация затрат и производительности Spark-пайплайнов
- Развитие команд: навыки, процессы и управленческие практики
- Миграции и переход на Apache Spark: миграция legacy ETL и данных
- Современная экосистема Spark: новости версий и совместимость
- Дорожная карта к мастерству в Spark: компетенции, сертификации и планы развития


