

Хранилища и форматы данных: Delta Lake, Iceberg, Parquet, ORC
Хранилища и форматы данных выступают фундаментом архитектуры Data Mesh. Они определяют не только стоимость хранения и скорость обработки, но и контракт между доменными командами и платформенными слоями: как выражать схемы, как обеспечивать целостность данных, как эволюционировать модели данных без нарушения потребителей. В рамках этой главы рассмотрены ключевые форматы и подходы к их применению в архитектурах Data Mesh: Parquet и ORC как эффективные колоночные форматы; Delta Lake и Apache Iceberg как современные табличные форматы с транзакциями, версиями и управлением схемами; принципы выбора и миграций, а также способы интеграции с DWH/Lakehouse и платформами данных.
Структура главы ориентирована на инженеров-архитекторов: от концепций и контрактов между доменными командами к конкретным решениям по хранению, управлению метаданными и миграциями. В глубине рассматриваются механизмы обеспечения согласованности, схемной эволюции, времени путешествия и работы с большими объемами данных в условиях распределенной организации.
- Краткое содержание главы
- Архитектурная роль форматов данных и контрактов между доменными командами
- Сравнение Parquet, ORC, Delta Lake и Iceberg: свойства и типовые сценарии
- Технологии транзакций, эволюции схем и времени путешествия
- Интеграция с DWH/Lakehouse, каталоги и управление данными
Архитектурная роль форматов данных и контрактов между доменными командами
В Data Mesh каждый домен выступает поставщиком и потребителем data products. Форматы и хранилища должны служить единым контрактом: структура данных, семантика полей, согласованные версии и гарантии доступа. Ключевые архитектурные требования к форматам и хранилищам включают:
- ACID-свойства и консистентность на уровне таблиц в условиях параллельных записей и обновлений. Это критично для транзакционных операций над данными домена и для корректной агрегации на уровне сервиса.
- Эволюция схем без прерывания потребителей. Возможность добавлять или изменять столбцы, переименовывать поля, мигрировать данные без ошибок чтения у существующих потребителей.
- Время путешествия и версия данных. Возможность возвращаться к конкретной версии таблицы для воспроизведения инцидентов, аудита и отката изменений.
- Эффективная организация хранения и индексации. Колоночные форматы и продуманное разбиение данных улучшают чтение и фильтрацию, что критично для доменных сценариев, где запросы выполняются часто и на больших объемах.
- Управление метаданными и каталогами. Единый источник истины о структурах данных и их версионировании, совместимый с инструментами анализа и оркестрации.
Эти принципы диктуют выбор конкретных форматов и подходов к хранению. Например, для домена с частыми обновлениями и строгими требованиями к консистентности может быть предпочтительно использование форматов с поддержкой транзакций и схемной эволюции на уровне таблиц (Delta Lake или Iceberg). Для больших архивов и аналитических сценариев, где важна совместимость с различными аналитическими движками, параллельные колоночные форматы Parquet и ORC остаются базой хранения, но требуют обвязки для поддержки изменений схем и изменений метаданных.
Parquet и ORC: сравнение форматов и типовые сценарии
Parquet и ORC - два наиболее распространенных колоночных формата, применяемых в Data Lake и Lakehouse-практиках. Они оптимизированы под считывание больших наборов столбцов и эффективную компрессию, что делает их хорошей основой для аналитических нагрузок. При выборе между ними ориентируйтесь на совместимость стека инструментов, требования к производительности и характер обновлений данных.
- Parquet выигрывает в широкой совместимости и зрелости экосистемы: он поддерживается практически всеми движками обработки данных и языками программирования. В сегментах, где доминируют Spark и Presto/Trino, Parquet часто становится удобной отправной точкой.
- ORC показывает преимущества в сжатии и скорости чтения в некоторых Hadoop-ориентированных окружениях и при работе с большими образами данных. Он часто применяется вместе с Hive и аналитическими пакетами на JVM, где оптимизированы конкретные операции сканирования и фильтрации.
Важно помнить, что сам по себе формат - только часть решения. Контракт на схему, способы партиционирования, а также метаданные и уровень поддержки изменений существенно влияют на общую производительность и эволюцию.
- Условия использования Parquet и ORC зависят от каталога данных и исполнительной среды. В Data Mesh целесообразно держать корректные walkthrough-процедуры для доменных команд: как добавлять новые поля, как тестировать совместимость и как документировать изменения для потребителей данных.
| Формат | Преимущества | Ограничения | Типичные сценарии |
|---|---|---|---|
| Parquet | Широкая поддержка, хорошая компрессия, простая интеграция | Ограниченная поддержка транзакций на уровне таблиц; эволюция схем может требовать контроля версий вне ядра формата | Аналитическая обработка, отчеты, кэширование слоев, совместимость с различными аналитическими инструментами |
| ORC | Эффективная компрессия и скорость в некоторых стэках; хорошо подходит для Hadoop-экосистем | Меньшая кросс-экосистемная совместимость по сравнению с Parquet | Хранилища больших объемов в Hadoop-средах, библиотеки на JVM, BI- и аналитические процессы |
| Delta Lake | ACID-транзакции, схема-эволюция, time travel, upserts/deletes | Требуется поддержка инфраструктурного слоя и ноты для логирования | Ведущая роль в Lakehouse как данные продукта, обновления домена, консистентная интеграция |
| Apache Iceberg | Встроенная версия и транзакционность схем, управление метаданными, безопасные обновления | Сложность внедрения в ограниченном стеке, потребность в каталоге | Масштабируемые Lakehouse-проекты, эволюция таблиц, сложные миграции по версиям |
Delta Lake: транзакции, эволюция схем и время путешествия
Delta Lake предоставляет единый уровень ACID-транзакций поверх существующего data lake. Это особенно важно в Data Mesh: доменные команды могут публиковать обновления о своих data products, не опасаясь конфликтов с потребителями из других доменов. Основные концепции Delta Lake включают:
- Транзакции на уровне таблиц. Любая операция записи - вставка, обновление, удаление - выполняется в рамках атомарной транзакции. Это обеспечивает согласованность данных даже при высоких нагрузках и параллелизме.
- Эволюция схем. Возможность прибавлять новые столбцы без прерывания эксплуатации и без принудительной миграции потребителей. Функциональность merge и schema evolution позволяют адаптировать структуру данных к меняющимся требованиям домена.
- Время путешествия. Поехали во времени к конкретной версии таблицы, что упрощает аудит, репликацию ошибок и регрессионное тестирование анализа.
- Upserts и deletes. Delta Lake поддерживает набор операций, позволяющий реализовать логику обновления бизнес-событий и коррекции данных без необходимости создания новых копий таблиц.
- Управление чистотой данных. Политики vacuum, временные логи и управление старше данных позволяют держать lake-clean и сводить к минимуму нагрузку на метаданные.
// Пример: запись в Delta Lake с поддержкой схемной эволюции
spark
  .readStream.format("kafka").option("topic","domain-events").load()
  .writeStream
  .format("delta")
  .option("mergeSchema","true")
  .save("/data/warehouse/domain_events_delta")
Дальнейшие практики включают управление версионированием при публикации data product: оговорить минимальные требования к контрактам, определить политику публикации версии, обеспечить обратную совместимость там, где возможно, и документировать миграции для потребителей.
Apache Iceberg: управление метаданными, эволюция таблиц и безопасные обновления
Iceberg проектирует таблицу как набор слоёв метаданных, хранящихся отдельно от самих данных. Это реализует масштабируемость и упрощает управление большим количеством версий во времени. Основные особенности Iceberg:
- Модульная архитектура метаданных. В таблице Iceberg существуют корневые файлы метаданных и множество манифестов, которые позволяют быстро находить нужные разделы и столбцы без сканирования всей таблицы.
- Эволюция схем и разделов. Iceberg поддерживает добавление и удаление столбцов, изменение типов и переопределение разделов без блокирования операций чтения. Это критично для разворачивания новых доменных моделей без разрушений для существующих потребителей.
- Мгновенные снимки и временные запросы. Время путешествия доступно через снимки, что обеспечивает ретроспективное владение данными и воспроизводимость анализа.
- Безопасность обновлений. Поддержка атомарных операций над несколькими партициями и транзакционностями при объединении данных из разных доменных источников.
- Совместимость с большим количеством движков. Iceberg рассчитан на работу через Spark, Flink, Trino и другие движки, что облегчает интеграцию в многообразные стеки.
// Пример: создание Iceberg-таблицы и запись данных
spark
  .readStream.format("kafka").option("topic","domain-events").load()
  .writeStream
  .format("iceberg")
  .table("warehouse.domain_events")
Эти возможности позволяют организовать эволюцию данных так, чтобы новые продукты могли внедряться независимо, но при этом сохранять историческую целостность и согласованность с потребителями по другим доменам.
Интеграция с DWH/Lakehouse и платформами данных
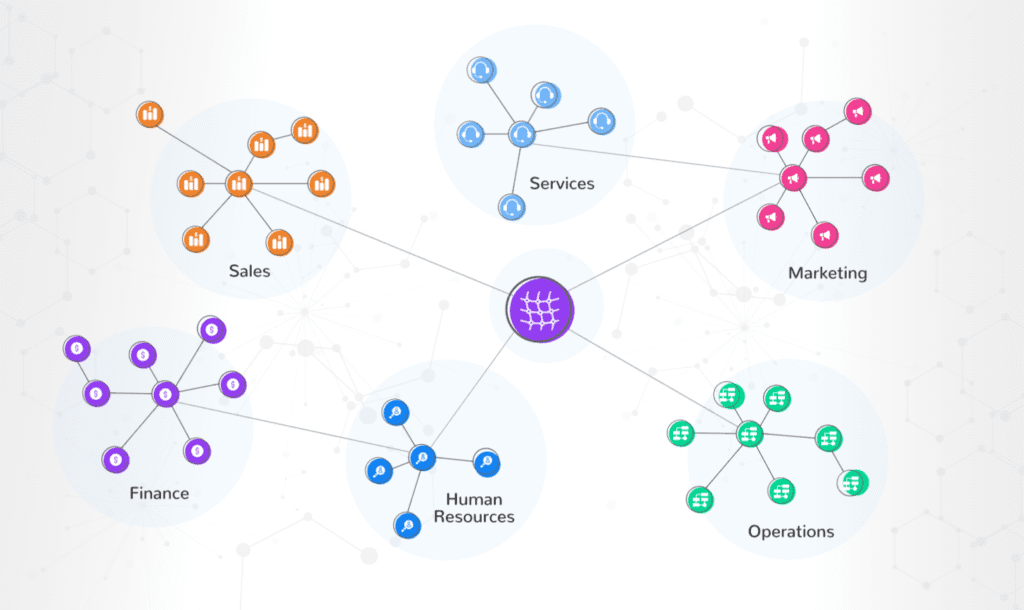
Эффективная интеграция форматов и хранилищ в контексте Data Mesh требует внимания к управлению метаданными, каталогами и контрактами между доменами. В этой части рассматриваются ключевые паттерны и практики:
- Каталоги и управление метаданными. Использование единого каталога (например, Hive Metastore, AWS Glue, Unity Catalog) обеспечивает единый слой аутентификации, версий и доступа. Это упрощает междоменные потребления и упорядочивает политики доступа.
- Контракты данных. Для каждой data product фиксируйте схему, ожидаемые версии, требования к совместимости и время жизни данных. Это позволяет доменным командам быстро выявлять несовместимости и планировать миграции.
- Выбор формата в зависимости от стека. В Lakehouse-архитектурах - Delta Lake или Iceberg - чаще выступает как основа таблиц с транзакциями; Parquet/ORC остаются основой для анализа и архивов. Важно обеспечить согласованный набор инструментов для чтения и записи между доменами.
- Миграционные стратегии. При переходах между форматами или версиями таблиц используйте тестовые наборы данных, обкатку на копиях (staging) и контрольные точки для оценки влияния на потребителей. В Data Mesh такие миграции требуют четких процессов API-объявлений и контрактов.
- Безопасность и комплаенс. Включайте требования к аудитам, хранению долговых копий и политкам доступа в спецификацию data products. Эволюции не должны приводить к утрате контроля над чувствительной информацией.
- Инструменты интеграции. В реальных проектах часто сочетание Spark/Presto/Trino, Databricks или собственных конвейеров с Delta Lake и Iceberg. Важно обеспечить совместимость форматов, возможность обмена таблицами между системами и централизованное управление версиями.
Практические аспекты проектирования и миграций
- Выбор форматов и стратегий. Для новых data products чаще рекомендуется Iceberg или Delta Lake из соображений контроля версий и транзакционности, особенно если домены требуют сложных сценариев обновления. Parquet и ORC чаще служат слоем хранения и аналитическими слоями, где критично эффективность чтения.
- Соглашения по схемам. Ведите строгие схемные конвенции: именование столбцов, типы, нотации временных полей. Разделяйте поля бизнес-логики и технические поля для снижения риска расхождений между доменами.
- Разделение по доменным границам. Моделируйте данные как data products с четкими контрактами на вход и выход. Схема эволюции должна позволять доменным командам расширять набор полей без принудительных изменений у потребителей.
- Мониторинг и качество. Внедрите метрики качества и непрерывный мониторинг изменений структуры данных, частоты ошибок конвертации и задержек между публикацией и потреблением.
- Документация. Автоматизируйте документацию по схемам и версиям таблиц. Обеспечьте доступ к истории изменений и примерам запросов для потребителей.
Key takeaways
- Форматы и хранилища определяют контракт между доменными командами и платформенными слоями Data Mesh, включая согласованность, эволюцию схем и доступ к истории данных.
- Parquet и ORC остаются эффективной основой простого хранения и анализа, но требуют обвязки для полной поддержки схемной эволюции и транзакций.
- Delta Lake и Apache Iceberg добавляют уровни транзакций, схемной эволюции и времени путешествия, существенно упрощая управление данными как продуктами доменов.
- Архитектурные решения должны учитывать стэк инструментов, каталоги метаданных и политики доступа, чтобы обеспечить единый контракт и упрощенную миграцию между версиями и форматами.
- В рамках Data Mesh рекомендуется четко определять data contracts, регламентировать миграции и предусмотреть процессы аудита и контроля качества данных.
- Эволюцию схем и обновления данных лучше внедрять через staged и тестовые окружения перед публикацией в продуктивную среду.
- Интеграция с DWH/Lakehouse требует выбора каталогов и инструментов, обеспечивающих единое управление метаданными, безопасный доступ и поддерживаемые сценарии времени путешествия.
FAQ
- Какие ключевые факторы влияют на выбор между Delta Lake и Iceberg для Data Mesh?
Delta Lake удобнее, если нужна сложная поддержка ACID, time travel и upserts в рамках единого канала хранения. Iceberg обеспечивает более гибкое управление метаданными, масштабируемость и независимость схем, что полезно при большом количестве доменов и сложных эволюциях. Выбор часто зависит от существующего стека, требований к миграциям и необходимости независимости схем между доменами.
- Как реализовать схему эволюции без нарушения потребителей?
Определите политику обратной совместимости до мягкого перехода: добавление столбцов без удаления существующих; использование опциональных полей; документирование изменений и распространение контрактов. В Delta Lake и Iceberg реализуйте безопасную миграцию через свой механизм: merge/alter для таблиц, поддержка новых версий и временных снимков. Tests и staged environments помогут выявить несовместимости до их применения в проде.
- Как организовать совместное использование форматов между доменными командами?
Задайте единый контракт data product: схему, требования к версии, ожидания по времени жизни данных и политикам доступа. Для каждого домена выбирайте подходящие форматы и режим доступа: например, запись в Delta Lake через общий конвенционный слой и потребление через Parquet/ORC в отдельных аналитических конвейерах. Каталог метаданных должен поддерживать просмотр версий и аудита изменений.
- Какие практики миграции данных особенно важны в Data Mesh?
Планируйте миграции как управляемый процесс: сначала в staging, затем в пилотную группу потребителей, затем в прод. Включите контрольные точки для тестирования совместимости, регрессионные тесты и документацию изменений. Автоматизируйте публикацию контрактов и уведомления потребителей.
- Какие риски связаны с некорректной эволюцией схем?
Основной риск - несовместимость потребителей и потеря качества или целостности данных. Чтобы снизить риск, используйте строгие политики контроля версий, метаданные и тестирование на реальных сценариях, внедрите time travel для отката и регрессий, а также поддерживайте оперативную коммуникацию между доменами и платформенными командами.
- Как обеспечить эффективную интеграцию с DWH/Lakehouse?
Выбирайте форматы и каталоги, которые поддерживают единый доступ и консолидацию метаданных. Обеспечьте совместимость между движками аналитики (Spark, Trino, Flink) и платформой хранения. Включите в архитектуру механизмы аудита, мониторинга и контроля доступа к данным.
- Что учитывать при выборе между Parquet и ORC как базовым форматом?
Ориентируйтесь на экосистему и требования к совместимости: Parquet лучше для широкого набора инструментов и языков, ORC может давать преимущества в некоторых Hadoop-ориентированных контекстах. В рамках Data Mesh форматы чаще дополняются механизмами транзакций и схемной эволюции через Delta Lake или Iceberg.
- Как влияют метаданные на производительность анализа?
Ключевые факторы - размер и структура каталога, количество версий и манифестов, способ хранения схем. Эффективная работа метаданных сокращает время сканирования и ускоряет время реакции доменных потребителей на изменения.
- Как организовать политику доступа к данным в контексте форматов?
Разделите данные по каталогу и таблицам по уровням доступа, применяйте политики на уровне каталога и таблиц, используйте централизованные механизмы аутентификации и авторизации. Контроль версий и время путешествия должны соответствовать требованиям аудита и комплаенса.
- Какие лучшими практики в отношении документации форматов можно применить в Data Mesh?
Автоматизируйте документацию по схемам, версиям и контрактам. Обеспечьте доступ к истории изменений и примерам запросов. Поддерживайте living documentation, обновляемую при каждой эволюции схем и при публикации новых data products.


