

DuckDB с нуля: встроенная аналитическая база данных
DuckDB — это лёгкая и мощная аналитическая база данных, которая позволяет выполнять SQL-запросы прямо на локальных данных без развёртывания сложной инфраструктуры. Курс помогает разобраться, как использовать DuckDB для анализа Parquet-файлов, CSV и других форматов, а также для быстрой обработки больших датасетов на ноутбуке или сервере.
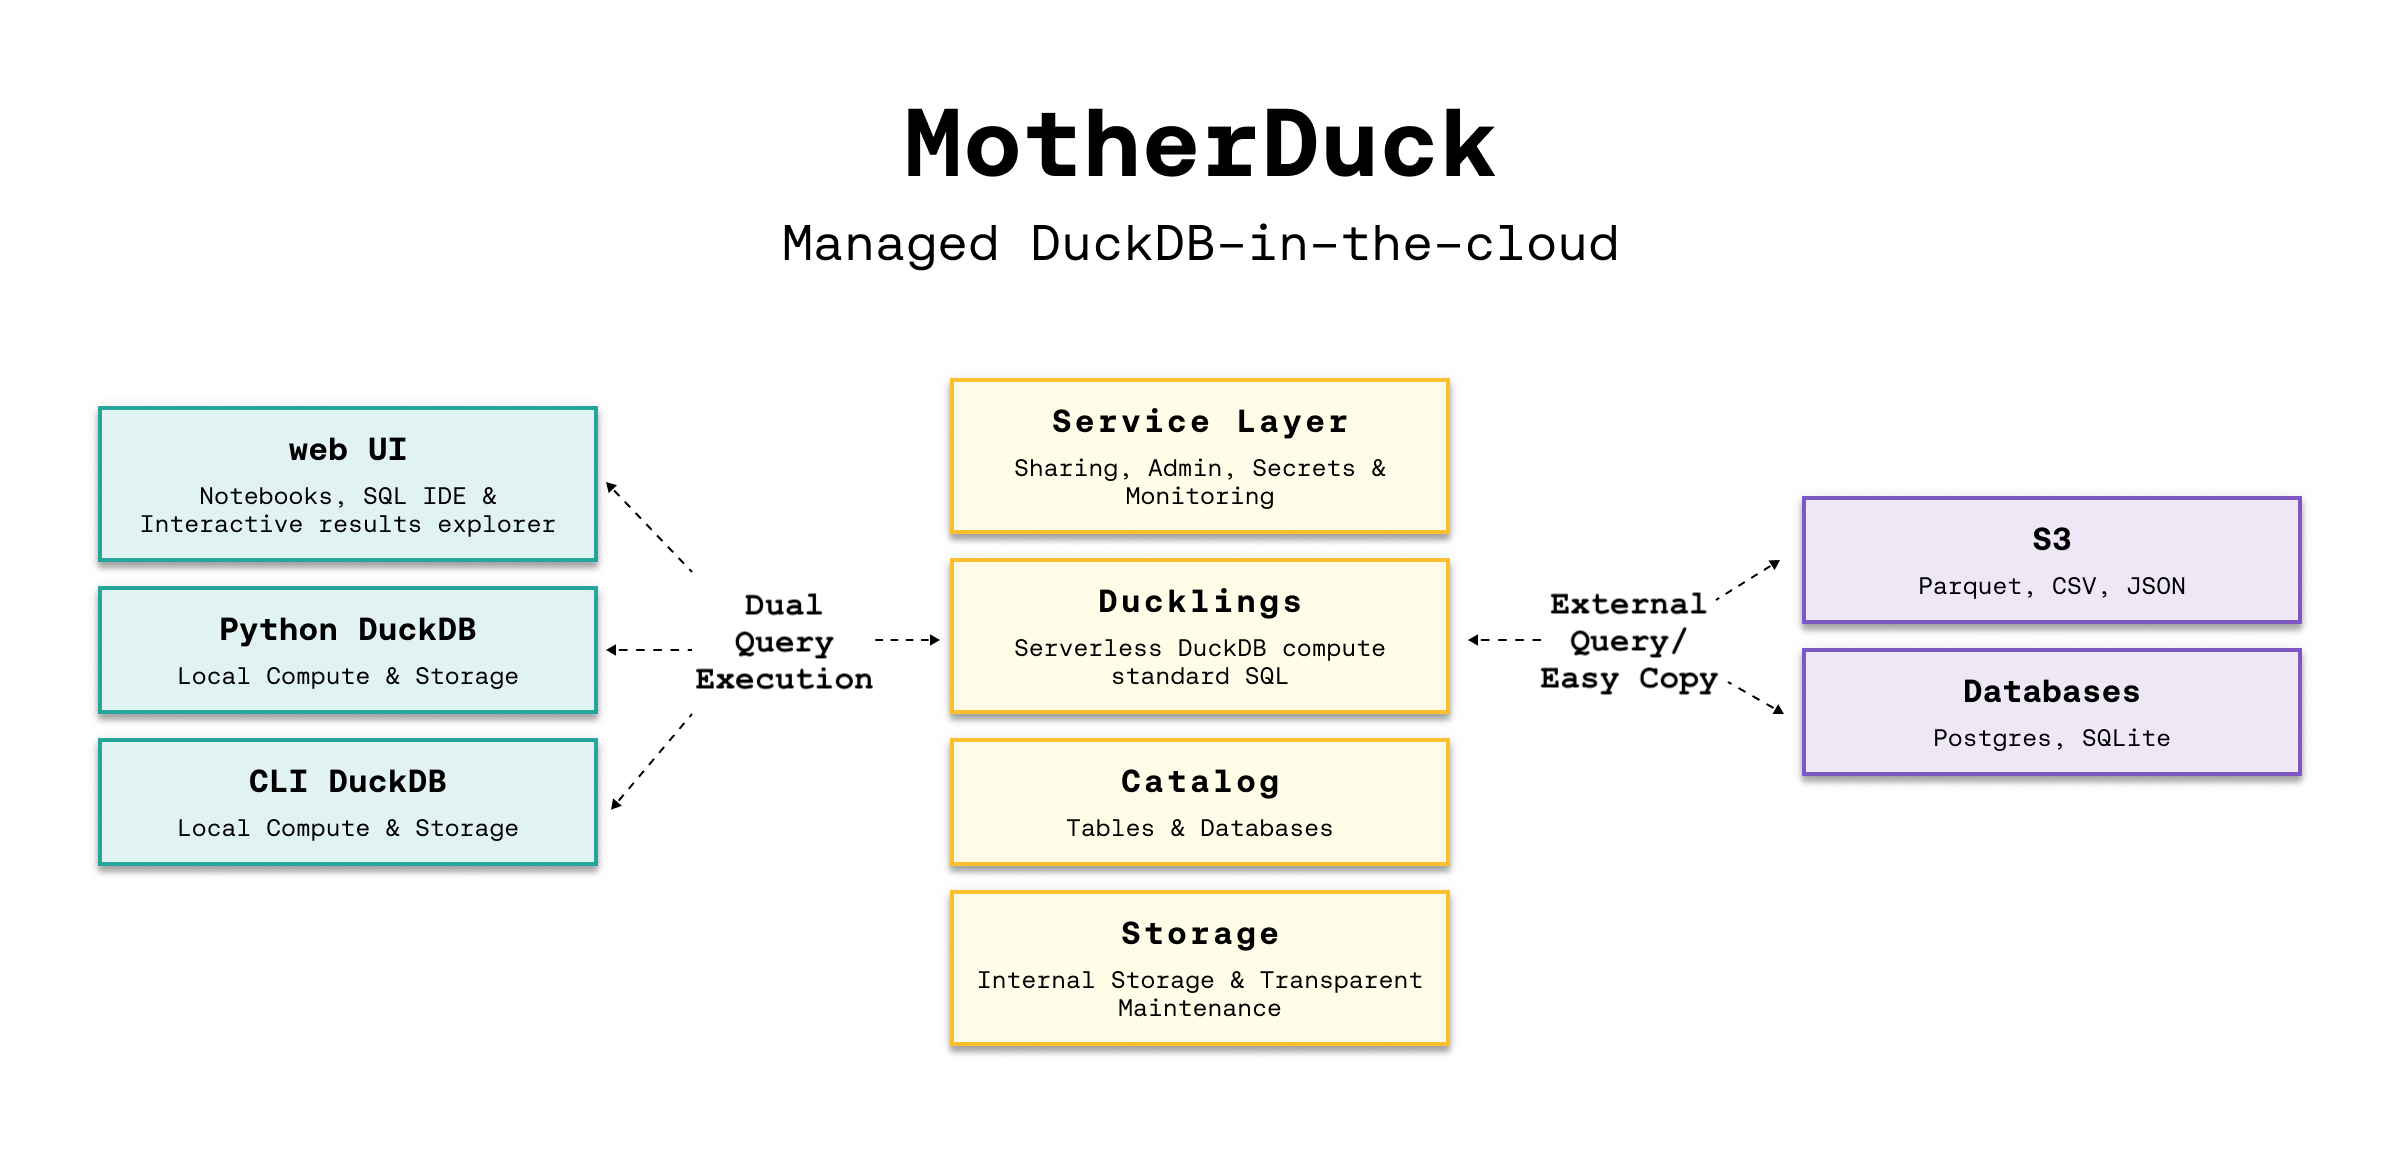
Вы изучите архитектуру DuckDB, принципы columnar хранения и векторизованного исполнения, а также оптимизацию SQL-запросов. Отдельное внимание уделяется интеграции с Python (pandas, Polars, Arrow) и построению аналитических сценариев без полноценного DWH.
Курс подходит для старта в embedded analytics и позволяет быстро начать работать с данными без лишней инфраструктуры.
- Введение: DuckDB как встроенная аналитическая база и контекст применения
- Терминология и концепции: embedded analytics, OLAP, Parquet и Arrow
- Архитектура DuckDB: обзор слоёв и взаимосвязей
- Хранение данных в DuckDB: колоночная модель, сегменты и компрессия
- Управление данными и типами: схемы, метаданные, поддерживаемые типы
- Транзакции, консистентность и устойчивость: MVCC и durability
- Планирование запросов и статистика: статистика, cardinality, выбор плана
- Векторизованное исполнение и параллелизм: принципы и преимущества
- Оптимизация выполнения запросов: predicate pushdown, join стратегии, агрегации
- Память, кэширование и управление ресурсами: конфигурация и режимы
- Поддержка SQL аналитики: оконные функции, аналитические выражения, агрегаты
- Расширяемость: UDFs, встроенные функции и механизмы расширений
- Работа с Parquet: чтение, запись, схемы и метаданные
- Интеграция Parquet: фильтрация на чтении, статистика файлов и pushdown
- DuckDB с нуля: импорт и экспорт данных. Parquet, CSV, JSON и источники HTTP/FS
- Язык запросов DuckDB: синтаксис, совместимость и примеры
- Работа с DataFrames и аналитическими библиотеками: pandas, Polars, Arrow
- DuckDB в Python: интерфейс duckdb-py и кейсы аналитики
- DuckDB в R: интеграция и сценарии использования
- DuckDB в JVM и Java экосистеме: JDBC/ODBC и внедрение
- Встраивание DuckDB в приложения: библиотечный режим и API
- Архитектурные паттерны внедрения: embedded analytics и data layer patterns
- BI и ETL интеграции: как DuckDB взаимодействует с инструментами
- Безопасность, доступ и управление данными: роли, аудит и управление правами
- Мониторинг, операционная модель и эксплуатация: наблюдаемость и операции
- Развертывание и конфигурация: сборка, версии и окружения
- Тестирование и обеспечение качества: регрессионное тестирование и планы
- Риски, ограничения и типичные ошибки: память, совместимость, зависимости
- Практические кейсы: локальная аналитика больших Parquet наборов
- Практические сценарии: ETL-lite, аналитика на локальных данных и репозитории
- Практические лабораторные задачи: проекты и лаборатории
- Эволюция, зрелость и дорожная карта DuckDB
- Масштабирование и архитектура зрелости: миграции и устойчивость
- Развитие сообщества и экосистемы: вклад и обновления
- План внедрения в организации: стратегия, управление изменениями
- Будущие направления: тренды и исследовательские направления
- Заключение: как продолжать обучение и развивать компетенции


