

Тестирование ETL и качество кода: unit, integration, data tests
Эффективное тестирование ETL-процессов в экосистеме Hadoop требует стройной методологии, которая охватывает не только базовые юнит-тесты трансформаций, но и интеграционные проверки взаимодействия компонентов, а также валидирующие тесты самих данных. Разработка ETL в контексте Hive, Spark и работы с большими данными сопряжена с уникальными вызовами: распределённость исполнения, характер данных, частые изменения схемы и ограниченная осязаемость промежуточных результатов. Цель главы - сформировать архитектуру тестирования, предлагаемые практики и конкретные техники реализации, позволяющие обеспечить надёжность пайплайнов, прозрачность качества данных и устойчивость к изменениям в коде и конфигурациях.
В условиях цифровой трансформации качество кода и корректность данных становятся критерием конкурентоспособности. Без системного подхода к тестированию риск ошибок растёт пропорционально объему обрабатываемых данных, а скорость внедрения изменений может обернуться деградацией качества. Глава ориентирована на инженеров по данным, архитекторов решений и DevOps-инженеров, работающих с Hadoop-экосистемой: Hadoop Distributed File System (HDFS), Hive, Spark, а также инструментами оркестрации вроде Airflow или Oozie. В ней представлен баланс между архитектурными принципами, практическими тестовыми паттернами и требованиями к технологическим стекам, с акцентом на реальное внедрение в корпоративные пайплайны.
- Краткое содержание главы
- Архитектура тестирования ETL в Hadoop-экосистеме: принципы, уровни тестирования, окружение и артефакты.
- Единичные тесты трансформаций: как тестировать бизнес-логику и трансформации Spark/Hive без загрузки больших данных.
- Интеграционные тесты и тестирование пайплайна: проверка взаимодействий между компонентами, внешними источниками и оркестрацией.
- Data-тесты и проверки качества данных: валидирование правил, контрактов и предикатов на больших объёмах, инструменты для автоматизации.
- Практические паттерны и управление качеством кода: CI/CD, контроль качества, мониторинг тестирования и поддерживаемость.
Архитектура тестирования ETL в Hadoop-экосистеме
Эффективная архитектура тестирования должна опираться на три взаимодополнительных уровня: unit-тесты для трансформаций, интеграционные тесты для взаимосвязей между компонентами и data-тесты, направленные на качество данных на выходе пайплайна. В контексте Hadoop это требует моделирования распределённой среды, где тесты выполняются на подмножествах данных и в условиях близких к боевой конфигурации.
Ключевые принципы:
- Изоляция и повторяемость: тесты должны быть детерминированы и независимо воспроизводимы между средами разработки, тестирования и продакшен.
- Контракты между компонентами: формализация интерфейсов между извлечением, преобразованием и загрузкой (Extract-Transform-Load) и фиксация ожиданий на входе и выходе.
- Эмпирика распределённости: для приближённых сценариев применяются мини- или локальные кластеры, а для критических кейсов - тестовые имитации HDFS/Metastore через контейнеры или локальные реализации.
- Контроль качества на каждом уровне: юнит‑тесты покрывают логику отдельных трансформаций, интеграционные тесты валидируют совместимость узлов пайплайна, data-тесты подтверждают соответствие бизнес-ограничениям и качеству данных.
Архитектурный шаблон для тестирования ETL включает следующие компоненты:
- Тестовый набор данных: управляемые подмножества данных, реплики реальных сценариев и синтетические данные с контролируемыми свойствами (карта распределений, редкие значения, граничные случаи).
- Эмуляторы внешних систем: заглушки и моки для источников и приёмников (HDFS, Hive Metastore, внешние сервисы) для детерминированного тестирования без зависимости от окружения.
- Тестовый стенд: локальное исполнение Spark/Scala/Python-пайплайна либо мини-кластер на основе локального Hadoop/контейнерной инфраструктуры (например, LocalStack-принципы в эмбеддинге данных, Docker-компоновки).
- Инструменты тестирования качества данных: набор проверок и валидаторов, которые выполняются над данными на разных этапах пайплайна.
- CI/CD-настройки: автоматизация запуска тестов в конвейерах Git (GitHub Actions, GitLab CI, Jenkins) с разделением уровней тестирования и фиксацией артефактов.
Типовая структура тестового пространства в Hadoop-проектах может выглядеть так:
- tests/unit: тесты отдельных функций, трансформаций и UDFs.
- tests/integration: тесты взаимодействий между компонентами.
- tests/data: проверочные датасеты и data-driven тесты.
- tests/quality: тесты качества данных и контракты.
- tests/ci: скрипты и конфигурации для CI/CD.
В части реализации важно выбрать подходящие технологии и минимально достаточные инструменты, которые соответствуют языку разработки проекта (Python/Scala/Java). Например, для unit-тестирования трансформаций на Spark часто применяют Spark Testing Base или аналогичные библиотеки, а для контроля качества данных - Deequ (Scala/Java) или Great Expectations (Python). Эти инструменты позволяют не только формулировать тесты, но и наглядно описывать правила качества и контрактов между компонентами.
## Пример: тест для трансформации Spark на Python (pytest)
from pyspark.sql import SparkSession
import pytest

@pytest.fixture(scope="session")
def spark():
    return SparkSession.builder.master("local[2]").appName("UnitTest").getOrCreate()

def test_uppercase_transform(spark):
    df = spark.createDataFrame([("alice", 1)], ["name", "cnt"])
    df2 = df.selectExpr("upper(name) as name", "cnt")
    rows = df2.collect()
    assert rows[0]["name"] == "ALICE"
    assert rows[0]["cnt"] == 1
В примере приведён минимальный unit-тест для трансформации, осуществляющей изменение регистра имени. Такой тест подтверждает корректность базовой логики без обращения к большому объёму данных и внешним системам.
Принципы выбора инструментов на архитектурном уровне:
- Для unit-тестов трансформаций на Spark удобен PyTest с локальным SparkSession или Scala/Java-юнит-тесты с ScalaTest/JUnit и Spark Testing Base.
- Для интеграционных тестов целесообразно моделировать взаимодействие между компонентами через тестовый Hive Metastore и временный HDFS, используя локальные кластеры или контейнерные решения.
- Для data-тестирования применяются специализированные инструменты валидации данных: Netflix Deequ (Scala/Java) для Spark-пайплайнов и Great Expectations (Python) для декларативной валидации данных, их интеграция с пайплайном упрощает поддержание контрактов.
Таким образом, архитектура тестирования строится на трёх уровнях: изоляция бизнес-логики через unit-тесты; проверка связности и корректной передачи данных между компонентами через интеграционные тесты; валидирование самих данных и соблюдения бизнес‑правил через data-тесты.
Единичные тесты трансформаций
Единичные тесты должны охватывать конкретные функции и трансформации, реализованные в Spark-коде или в UDF. Основная идея состоит в том, чтобы убедиться, что каждый элемент логики работает независимо от внешних факторов, таких как сеть, файловые системы или конфигурации окружения. В рамках Hadoop-пайплайнов unit-тесты применяются к:
- функциям трансформаций и чистке данных (например, нормализация строк, приведение типов, агрегации на уровне одной строки);
- UDF (пользовательские функции) и их поведения в различных сценариях;
- небольшой набор операций Spark DataFrame, где вход и выход известны и могут быть детерминированы.
Рекомендации по реализации unit-тестов:
- Тестируйте чистые функции, в том числе правила валидации и конвертации типов, отдельно от инфраструктуры.
- Используйте in-memory DataFrame-данные как входной набор и проверяйте ожидаемые выходы с помощью простых утверждений.
- Избегайте обращения к реальному HDFS или внешним сервисам в unit-тестах. Для этого применяйте заглушки и фиктивные данные.
Подход к тестированию трансформаций
- Фокус на детерминированности: тесты должны давать одинаковые результаты при каждом прогоне.
- Контроль над схемами: тесты должны явно фиксировать ожидаемую схему выходных данных.
- Пределы и крайности: тестируйте граничные случаи, такие как пустые входы, нулевые значения и дубликаты по ключу, чтобы убедиться в корректной обработке.
- Эффективность тестов: избегайте чрезмерной сложности тестов и больших тестовых наборов; применяйте малые, но репрезентативные наборы.
Данные принципы облегчают сопровождение, позволяют быстро локализовать проблему и дают уверенность в том, что любая рефакторинг или переработка трансформаций не сломает существующую логику.
Интеграционные тесты и тестирование пайплайна
Интеграционные тесты проверяют взаимодействие между компонентами ETL: извлечение данных из источников, трансформацию и загрузку в целевые хранилища. В Hadoop‑контексте особенно важно валидировать сценарии, где данные проходят через Hive Metastore, Spark-вычисления и операции записи в HDFS или Hive‑таблицы. Такие тесты позволяют убедиться в корректности orchestration и в том, что изменения в одной части пайплайна не приводят к непредвиденным побочным эффектам.
Ключевые сценарии интеграционных тестов:
- End-to-end: данные проходят через заданную последовательность операций и загружаются в целевые таблицы, с проверкой итоговых результатов.
- Интеграция с метаданными: тестирование схемы, разделов (partitions), типов данных и совместимости между версиями схем.
- Оркестрация пайплайна: проверка корректности расписания, зависимостей и повторного выполнения после сбоев.
- Взаимодействие с внешними системами: источники/приёмники данных, которые моделируются через заглушки или тестовые сервисы.
Технические рекомендации:
- Используйте тестовые стенды, которые близки к боевой конфигурации: локальный Spark, окружение с Hive Metastore, небольшой тестовый кластер Hadoop.
- Применяйте "test doubles" для внешних систем: фиктивные источники данных, стабилизирующие значения, контролируемые наборы partition, временные таблицы.
- Включайте проверки конфигураций пайплайна: параметры шага, параметры к загрузке в Hive, пути к данным, контроль версий схем.
## Пример интеграционного теста в PySpark (условная конфигурация)
from pyspark.sql import SparkSession

def run_end_to_end_pipeline(spark: SparkSession, input_path, output_path):
    ## Имитация шага Extract/Transform/Load
    df = spark.read.parquet(input_path)
    df2 = df.filter("amount > 0").selectExpr("customer_id", "amount", "timestamp")
    df2.write.mode("overwrite").parquet(output_path)

def test_end_to_end_pipeline(spark: SparkSession, tmp_path):
    input_path = f"{tmp_path}/input"
    output_path = f"{tmp_path}/output"
    ## Подготовка тестовых данных
    spark.createDataFrame([(1, 100, "2023-01-01")], ["customer_id", "amount", "ts"]) \
        .write.parquet(input_path)
    run_end_to_end_pipeline(spark, input_path, output_path)
    ## Проверка результатов
    df_res = spark.read.parquet(output_path)
    rows = df_res.collect()
    assert len(rows) == 1
    assert rows[0]["amount"] == 100
Интеграционные тесты позволяют проверить связность слоёв и корректность данных на выходе на уровне всей цепи пайплайна, а не только отдельной функции. В реальном проекте такие тесты могут потребовать использования тестовых Hive Metastore, временных баз данных или контейнеризированных окружений, чтобы повторить сценарии продакшена.
Data‑тесты и проверки качества данных
Data‑тесты направлены на верификацию соответствия данных бизнес‑правилам, контрактам и требованиям к качеству в рамках распределённых пайплайнов. Это критически важно в больших данных, где ошибка в одном участке пайплайна может привести к искажению миллионов строк и неверным выводам для анализа.
Кадры data‑тестирования включают:
- Контракты данных: декларативные правила на уровне схемы, типов данных, допустимых значений, уникальности и заполненности.
- Валидаторы качества данных: проверки бизнес‑правил, например, доля пустых значений по критическим полям, распределение значений, частоты встречаемости.
- Мониторинг и регрессионные тесты: фиксация показателей качества и пороговых значений, которые требуют внимания при изменении пайплайна.
Инструменты и подходы:
-
Netflix Deequ: декларативный подход к качеству данных на Spark; позволяет задавать правила и автоматически выдавать отчёты о соответствии.
-
Great Expectations: декларативный фреймворк для валидации данных на Python; хорошо подходит для DataFrames в PySpark и интеграции с Data Quality dashboards.
-
Spark‑Testing‑Base: упрощает написание unit‑тестов для Spark, позволяет работать с тестовыми данными в Spark без подключения к внешним хранилищам.
## Пример data‑test в Deequ (Scala) import com.amazon.deequ.constraints._ import com.amazon.deequ.VerificationSuite import com.amazon.deequ.checks.Check val check = Check.Check(VerificationSuite().onData(dataFrame)) .hasSize(_ >= 1000) .isComplete("user_id") // без null .isComplete("order_id") VerificationSuite().onData(dataFrame).addCheck(check).run() -
Контракты и сигнатуры: формируйте контракт на входе трансформации и ожидаемые свойства на выходе. Это позволяет автоматически обнаруживать нарушение правил после вмешательства в код.
-
Стратегия подотчётности: сочетайте data‑test с обычными unit- и integration-tests для полного цикла контроля.
-
Масштабируемость: для больших объёмов данных применяйте выборочные проверки, статистические тесты на плотности распределения и устойчивость результатов при повторном прогоне.
Практически data‑тесты должны быть тесно связаны с бизнес‑контекстом: например, проверка того, что продажи за период не уменьшаются после переработки источников данных, или что новые записи сохраняются с корректной временной меткой и коррелирующими полями. Важнейшим аспектом является создание устойчивых репортов об качестве данных, чтобы аналитики и бизнес‑пользователи могли доверять пайплайнам и быстро локализовать проблемы.
Код и управление качеством кода
Качество кода - неотъемлемая часть устойчивых ETL‑пайплайнов. Неформализованные изменения, слабое тестирование и плохие практики кодирования приводят к техническому долгу и снижению способности к масштабированию. В контексте Hadoop‑стека особое внимание следует уделять:
- Лучшему стилю кода и аудиту: соблюдение стандартов оформления кода, единообразие именования функций, модульность и повторное использование трансформаций.
- Статическому анализу и качеству: внедрение инструментов статического анализа (например, SonarQube, детально настраиваемые правила для Scala/Java и Python) и мониторинг скорости сборки.
- Контроль версий и CI/CD: тестовая среда, где изменения в коде проходят последовательность юнит-интеграционных и data‑тестов перед мержем в основную ветку; настройка уведомлений и понятий об ошибках.
- Управление тестовыми данными: создание и поддержание синтетических наборов данных, параметризация тестов и централизованное хранение тестовых ресурсов.
Как минимум следует внедрить:
- Линтинг и стиль кода: гарантировать единообразие кода и раннее обнаружение потенциальных проблем.
- Нормализованные тестовые окружения: изолированные стенды для тестирования (локальные SparkSession/mini cluster) без привязки к продакшн‑кластеру.
- Непрерывная интеграция тестов: каждый коммит должен запускать комплексную цепочку тестов, с порогом прохождения и отчётами.
- Метрики качества и видимость: создание дашбордов по покрытию тестами, скорости выполнения тестов, частоте сбоев пайплайна и времени реакции на дефекты.
Для иллюстрации возможностей интеграции в CI/CD можно привести подход с контейнеризированной средой и тестовым стендом:
- Собирайте тестовую среду как образ, содержащий Spark/Scala/Python и необходимые зависимости.
- Запускайте unit‑ и integration‑tests локально в рамках конвейера, а data‑testы - на подмножество производственных данных или на синтетическом наборе.
- Включайте автоматическую генерацию артефаков и отчетов качества, чтобы аналитики могли увидеть прогресс и докладывать о дефектах.
Примеры инструментов, уместных в рамках перехода к полноценной системе обеспечения качества:
- Netflix Deequ: мощная платформа для описания и выполнения data‑quality checks на Spark.
- Great Expectations: декларативная валидация данных в пайплайнах Python/ Spark.
- Apache Spark Testing Base: облегчает создание unit‑тестов для Spark‑приложений.
Практические паттерны и внедрение
- Паттерн "контракты данных": формализуйте контракт на вход и выход каждой трансформации, фиксируйте ожидаемую схему, формат и валидируемые свойства данных.
- Паттерн "idempotent writes": проектируйте операции записи так, чтобы повторный прогон пайплайна не приводил к дубликатам и неконсистентности.
- Паттерн "репликации источников": создавайте тестовые источники данных, близкие к реальным сценариям, с заранее известными характеристиками и распределением значений.
- Паттерн "обратной совместимости": при изменении схемы сперва добавляйте совместимую миграцию, затем разворачивайте новую логику в отдельных ветках, чтобы тянуть за собой минимальные риски.
Практические рекомендации по внедрению:
- Определите минимальный набор тестов на каждом уровне: unit, integration и data‑testы, который обеспечивает базовую устойчивость пайплайнов.
- Нормализуйте процесс тестирования в CI/CD: при каждом коммите запускаются все уровни тестирования; результаты фиксируются в артефактах и уведомлениях.
- Разделяйте данные тестов по ролям: устойчивые фиксированные данные для unit‑тестов и более репрезентативные наборы для data‑тестов.
- Обеспечьте доступность тестовых отчетов: отчёты по качеству данных и тестированию должны быть доступны аналитикам и разработчикам, чтобы быстро распознавать источники дефектов.
Key takeaways
- Эффективное тестирование ETL в Hadoop требует системного подхода к трем уровням: unit-тесты трансформаций, интеграционные тесты взаимодействий компонентов и data-тесты качества данных.
- Архитектура тестирования должна предусматривать тестовые стенды, эмуляцию внешних систем, использование заглушек и безусловную повторяемость тестов.
- Для data‑тестов полезны Deequ и Great Expectations для декларативной валидации данных и контрактов между частями пайплайна.
- Юнит‑тесты должны быть детерминированными, легко воспроизводимыми и фокусироваться на логике трансформаций и UDF.
- Интеграционные тесты требуют моделирования реальных сценариев пайплайна, включая Hive Metastore и оркестрацию, чтобы проверить совместимость и корректность выполнения.
- Управление качеством кода должно сопровождаться статическим анализом, linting, CI/CD‑процесcами и мониторингом тестовых метрик.
- Внедрять data‑тесты и контрактную проверку в рамках CI/CD, чтобы обеспечить быстрый отклик на регрессию и поддерживаемость.
- Правильный выбор инструментов (Deequ, Spark Testing Base, Great Expectations) помогает систематизировать тестирование и повысить прозрачность результатов.
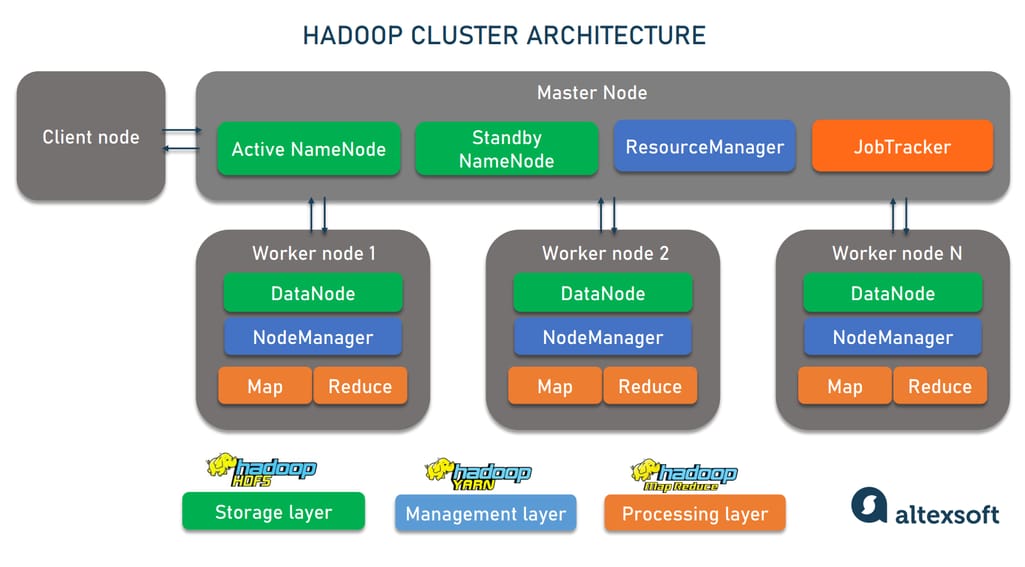
FAQ
В этом разделе даны ответы на часто встречающиеся вопросы практикующих инженеров по данным и архитекторов решений в контексте тестирования ETL в Hadoop‑среде.
1: Как выбрать уровень тестирования для конкретной задачи в ETL-пайплайне?
- Ответ: Выбор уровня следует осуществлять от бизнес‑ценности и риска коду. Для критических бизнес‑правил и трансформаций, влияющих на финансовые показатели, важны data‑тесты и интеграционные тесты, подтверждающие корректность данных на выходе. Юнит‑тесты эффективны для изоляции логики трансформаций и UDF, что ускоряет цикл разработки и локализацию дефектов. В рамках CI/CD следует автоматизировать выполнение всех уровней тестирования, но при частых изменениях можно ранжировать тесты по приоритетности.
2: Какие инструменты предпочтительнее для data‑тестирования в Spark?
- Ответ: Для языковых экосистем Python и Scala существуют две мощные опоре: Deequ и Great Expectations. Deequ хорошо подходит для декларативного описания контрактов и автоматической проверки качественных свойств данных в Spark, особенно там, где требуется интеграция с пайплайнами на Scala/Java. Great Expectations удобен для Python‑ориентированных проектов и позволяет легко описывать ожидания данных и создавать отчёты в виде понятной документации. В зависимости от стека проекта можно комбинировать оба подхода.
3: Как минимизировать влияние тестовых данных на продакшн‑кластере?
- Ответ: Применяйте тестовые данных в изолированном окружении: локальный Spark/мини‑кластер или контейнеризированная тестовая среда. Для интеграционных тестов можно использовать тестовые версии Hive Metastore и HDFS внутри изолированных сред, а данные подменять на синтетические. В продакшн‑кластере тесты должны выполняться на копиях данных или в staging‑окружении, чтобы исключить влияние на боевые пайплайны.
4: Как организовать CI/CD для ETL‑проектов на Hadoop?
- Ответ: Включите в конвейер этапы: 1) юнит‑тесты TRANSFORM-логики и UDF; 2) интеграционные тесты на ограниченном стенде; 3) data‑тесты для контрактов качества; 4) сборка артефактов и развёртывание в staging/продакшн после прохождения тестирования. Рекомендуется использовать контейнеризацию и инфраструктуру как код для воспроизводимости окружения, а также поддерживать версионирование схем и миграционные паттерны для minimization риска.
5: Как обеспечить повторяемость тестов в распределённой среде?
- Ответ: Повторяемость достигается через детерминированные тестовые данные, фиксированные временные метки и управляемые конфигурации окружения. Поддерживайте стабильные seed‑значения для любых генераторов данных и используйте фиктивные источники данных. Тесты должны быть независимыми и не полагаться на сетевые ресурсы.
6: Какие подходы применяются для мониторинга качества тестирования в продакшене?
- Ответ: В продакшене важно не только запускать тесты, но и собирать метрики: процент прохождения тестов, время выполнения, частота ошибок, доля некорректных выходных данных. Визуализация через дашборды помогает своевременно распознавать отклонения. Непрерывное улучшение достигается за счёт анализа причин дефектов и пересмотра контрактов данных.
7: Каковы лучшие практики для поддержания тестовой базы данных и тестовых датасетов?
- Ответ: Разделяйте тестовые данные по типу контента и обновляйте их по мере изменения бизнес‑логики. Поддерживайте версионирование тестовых наборов, используйте синтетические данные с детерминированной структурой и фиксированными распределениями. Для крупных пайплайнов полезны подмножества данных и стратегическое уменьшение объёма данных в тестах без потери репрезентативности.
8: Что делать, если тесты начинают медленно выполняться из-за увеличения объёма данных?
- Ответ: Разделите тесты по уровням и используйте выборочные проверки для data‑тестов; применяйте мотивацию к параллелизму и распараллеливанию тестов, а также кеширование и повторное использование тестовых наборов. Оптимизируйте конфигурации Spark (память executors, число параллельных задач) и избегайте тестирования через реальные большие данные там, где можно обойтись малыми, детерминированными наборами.
Эта глава предлагает систематизированный подход к тестированию ETL‑пайплайнов в Hadoop‑экосистеме и формирует прочный фундамент для методического внедрения практик качества кода и данных в корпоративной среде. Реализация на практике требует сочетания методологии, инструментов и управленческих процессов, чтобы обеспечить устойчивость, повторяемость и прозрачность развёртываемых решений.


