

Загрузка и потоковая загрузка: Batch Load и Stream Load
Загрузка данных в аналитическую платформу Doris является критическим элементом любой стратегии BI и данных. В рамках этой главы рассматриваются две парадигмы загрузки - Batch Load и Stream Load - их архитектура, протоколы взаимодействия, параметры настройки и подходы к мониторингу. Акцент сделан на сбалансированном подходе: с одной стороны - прочность и предсказуемость пакетной загрузки больших данных, с другой - способность обеспечивать низкую задержку и непрерывную подачу данных в OLAP-платформу.
Batch Load и Stream Load являются двумя тесно соседними, но разноплановыми механизмами загрузки. Batch Load ориентирован на массовые загрузки из внешних хранилищ (HDFS, S3, локальные файловые системы) и обеспечивает высокую пропускную способность за счет параллелизма и агрегации данных. Stream Load реализует потоковую подачу через REST/HTTP-интерфейс, позволяя обновлять табличные данные в реальном времени или near-real-time режиме. Понимание того, когда применять одну парадигму или другую, напрямую влияет на архитектуру кластера, требования к хранению данных и подходы к мониторингу.
Краткое содержание главы
- Отличия Batch Load и Stream Load по задержке, пропускной способности и guarantees консистентности.
- Архитектура загрузки в Doris: роли FE, BE, брокеров и точек интеграции с внешними источниками данных.
- Основные настройки и параметры загрузки, их влияние на производительность и устойчивость.
- Практические подходы к оптимизации загрузки: форматы данных, партиционирование, параллелизм и управление ресурсами.
- Мониторинг загрузок и сценарии эксплуатации: отслеживание статусов, обработка ошибок, восстановление.
- Интеграции и сценарии внедрения с внешними источниками: HDFS, S3, локальные хранилища, сервисы потоковой передачи данных.
- Рекомендации по выбору подхода в зависимости от бизнес-целей и требований к SLA.
Введение в Batch Load и Stream Load
Batch Load и Stream Load представляют две парадигмы загрузки, которые обеспечивают интерпретацию данных в Doris на разных временных масштабах. Batch Load традиционно применим к крупномасштабным загрузкам исторических данных: данные собираются в файлы в внешнем хранилище, затем Doris читает их и инкрементно добавляет в таблицы. Важно отметить, что Batch Load может быть ассоциирован с концепцией «постепенной загрузки» в рамках заранее заданного окна времени, что позволяет тщательно контролировать качество данных, проверять схемы и выполнять полноценную предобработку.
Stream Load ориентирован на минимальную задержку между появлением данных и их доступностью в аналитических запросах. Потоки публикуются через HTTP-интерфейс, данные могут приходить по мере готовности источника, а Doris стремится минимизировать задержку между событием и аналитическим результатом. В рамках Stream Load целостность данных достигается через гарантии транзакционности на уровне загрузок и повторной попытки при сбоях.
Понимание этих различий позволяет проектировать конвейеры данных с учётом требований к латентности, пропускной способности и устойчивости. В практических сценариях часто присутствуют и сочетания подходов: исторические архивы загружаются пакетно, а текущие события - через потоковую подачу с периодическими батч-бранчами для кросс-временных аналитик.
Архитектура и протоколы загрузки
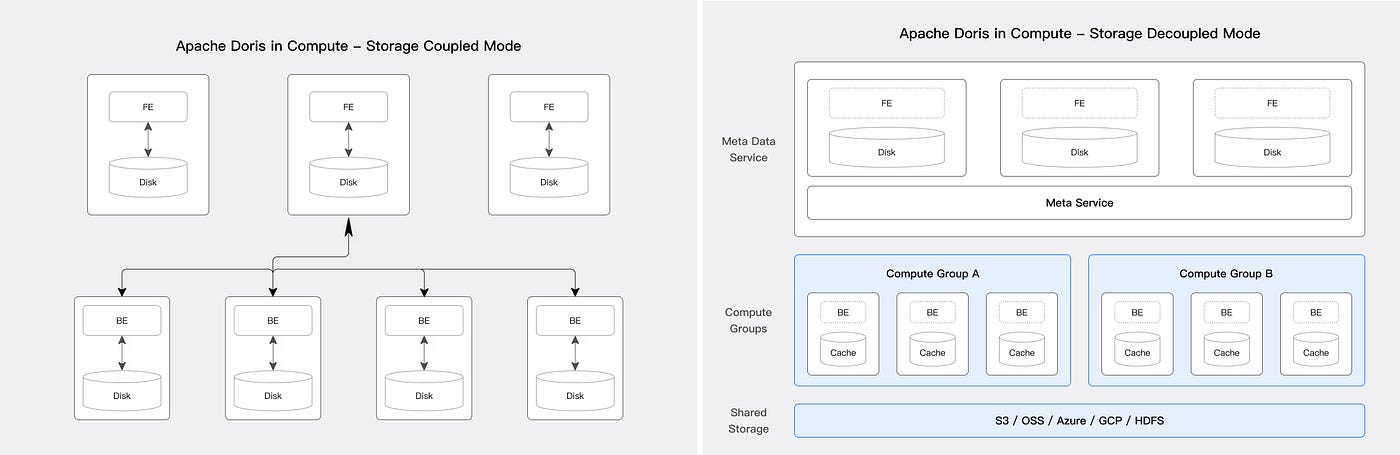
Архитектура загрузки в Doris опирается на три ключевых компонента: управляемые узлы Frontend (FE) и Backend (BE), а также специализированные узлы брокеров или интерфейсные точки для обращения к внешним системам хранения данных. В контексте Batch Load FE и BE выполняют координацию загрузок, управление схемами и транзакциями, тогда как источники данных - внешние хранилища или файловые системы - снабжают Doris пакетами данных. В случае Stream Load управление осуществляется через HTTP-API, через который клиент отправляет данные и получает статусы выполнения загрузки.
Основные сценарии передачи данных:
-
Batch Load:
- Данные извлекаются из внешнего хранилища (например, HDFS, S3) и читаются брокерами Doris или непосредственно FE/BE в процессе загрузки.
- Загрузка осуществляется пакетно; данные разбиваются на параллельные потоки по разделам таблиц и партициям для максимального использования вычислительных узлов.
- Варианты форматов - колоночные форматы (например, Parquet) и текстовые форматы (CSV/JSON) с поддержкой схем и правил преобразования.
- В рамках транзакций доступна консистентность на уровне загрузок (commit/abort) с возможностью повторной попытки.
-
Stream Load:
- Данные отправляются через REST/HTTP к API Doris, где они разбиваются на пакеты и применяются к целевой таблице с минимальной задержкой.
- Поддерживаются форматы JSON, CSV, а также бинарные или параллельные форматы данных в зависимости от реализации.
- Впереди на уровне транзакций обеспечивается гарантированная атомарность загрузки в пределах одной загрузки (или повторная попытка в случае ошибок).
- Обеспечение idempotency для повторных отправок - критически важный аспект.
Технические детали каждого пути зависят от конфигураций кластера, версии Doris и выбранных внешних хранилищ. Важными элементами являются:
- Правильная настройка схемы и соответствие между источниками данных и целевыми таблицами Doris.
- Нормализация схем, чтобы предотвратить несоответствия типов и нарушений ограничений.
- Управление параллелизмом в рамках кластера, чтобы избежать перегрузки BE и дискового ввода-вывода.
## Пример упрощённой REST-запросной модели Stream Load (псевдокод, иллюстративно)
POST http://doris-fe:8040/api/stream_load
Content-Type: application/json
{
  "db": "analytics",
  "table": "orders",
  "format": "json",
  "columns": ["order_id","customer_id","amount","ts"],
  "data": [
    {"order_id": 1001, "customer_id": 501, "amount": 123.45, "ts": "2024-06-01T12:01:00Z"},
    {"order_id": 1002, "customer_id": 502, "amount": 67.89, "ts": "2024-06-01T12:01:05Z"}
  ]
}
Стратегия взаимодействия между компонентами должна обеспечивать устойчивость к сбоям, возможность повторных попыток и контроль над порядком обработки. Важными аспектами являются:
- Идентификаторы загрузок (Label/LoadId) для детерминированности повторных процедур.
- Механизмы повторной отправки данных и схемы дедупликации.
- Логирование статусов загрузок, включая время начала и окончания, а также причины ошибок.
Настройки и параметры загрузки
Эффективность загрузки во многом определяется параметрами конфигурации и их согласованной настройкой в рамках всего кластера.
-
Параллелизм и пакетизация:
- Уровень параллелизма для Batch Load: стоит ориентироваться на способность BE обрабатывать несколько файлов одновременно без перегрузки CPU и сети.
- Размер пакета и количество файлов, обрабатываемых параллельно при Stream Load: баланс между задержкой и пропускной способностью.
-
Форматы данных и схемы:
- Выбор форматов: Parquet/ORC для Batch Load обеспечивает эффективное сжатие и схему, а для Stream Load - текстовые JSON/CSV форматы упрощают инкрементальную подачу.
- Валидация схемы на стадии загрузки: предотвращает несоответствия типов и столбцов, снижая риск ошибок во встроенной аналитике.
-
Время жизни и транзакции:
- Параметры времени ожидания загрузок, лимиты по времени жизни транзакций и политики повторной попытки.
- Гарантии консистентности: атомарность одной загрузки на уровне таблицы или партии, детальная логика отката.
-
Безопасность и доступ:
- Аутентификация и авторизация для доступа к источникам данных и API загрузки.
- Шифрование данных на пути передачи и, при необходимости, шифрование на хранении в промежуточных буферах.
-
Производительность ввода-вывода:
- Размер буфера и лимиты сетевых сокетов, управление очередями.
- Ограничения по пропускной способности на узле и в кластере в целом с учётом других рабочих нагрузок.
-
Мониторинг и диагностика:
- Метрики загрузок (скорость, задержка, пропускная способность, количество ошибок).
- Пороги алертов, механизмы диагностирования проблем в процессе загрузки.
Практический подход к настройке предполагает последовательное изменение параметров с валидированием изменений в тестовой среде, затем ступенчатое внедрение в прод, с использованием мониторинга и отзывчивого управления.
Производительность, оптимизация и архитектурные решения
Производительность загрузки зависит не только от скорости передачи данных, но и от того, как данные интегрируются в существующую схему, как обрабатываются параллельные потоки и как управляется ресурсоемкая обработка. Основные принципы оптимизации:
-
Выбор форматов и параллелизм:
- Batch Load выигрывает за счет использования колоночного формата и продуманного партиционирования. Parquet и ORC уменьшают размер данных и ускоряют считывание.
- Stream Load выигрывает в задержке; для штатной работы лучше выбрать форматы, легко обрабатываемые при порционном добавлении (JSON/CSV) и обеспечить эффективную десериализацию.
-
Партиционирование и схему таблицы:
- Разумное партиционирование по ключам и датам позволяет равномерно распределить нагрузку и уменьшить страдания от hot partitions.
- Валидная и согласованная схема снижает количество ошибок на входе и позволяет Doris выполнять оптимизацию чтения (pruning, column pruning).
-
Ведение контроля за качеством данных:
- В процессе Batch Load полезно выполнять базовую проверку качества: уникальность ключей, отсутствие дубликатов, валидность дат и числовых диапазонов.
- Для Stream Load важно обеспечить идемпотентность повторных загрузок и корректную обработку повторяющихся событий.
-
Непрерывная загрузка и буферизация:
- Streaming буферы помогают сгладить пики нагрузки и обеспечить устойчивость к всплескам трафика.
- В случае Batch Load целесообразно предусмотреть буферы на уровне внешнего хранилища и промежуточного слоя, чтобы смежная обработка не тормозила основной конвейер.
-
Применение фильтров и преобразований на входе:
- Фильтрация лишних записей и ранняя агрегация на этапе загрузки может снизить общий объем данных и ускорить последующую аналитическую работу.
- Преобразование типов и нормализация на стадии загрузки предотвращают неоднозначности в дальнейшем использовании.
-
Контроль качества после загрузки:
- Встроенные проверки количества записей, сверка суммарных метрик и контроль точности данных - фундаментальные элементы процесса.
- Встроенные проверки количества записей, сверка суммарных метрик и контроль точности данных - фундаментальные элементы процесса.
Практические рекомендации:
- Начинайте с параллелизма, который можно объяснить и воспроизвести в тестовой среде, и постепенно увеличивайте его в проде, отслеживая метрики задержки и пропускной способности.
- Включайте мониторинг загрузок (например, по latency, throughput, error_rate) и настраивайте алерты для критических состояний.
- Регулярно выполняйте репликацию и контроль целостности данных между Batch и Stream путями, чтобы не возникало противоречий между контурами данных.
Мониторинг, эксплуатационные сценарии и устойчивость
Эффективный мониторинг загрузок - фундамент стабильности аналитической инфраструктуры. В Doris набор ключевых метрик для Batch Load и Stream Load охватывает время отклика, throughput и качество данных.
-
Основные метрики:
- Время начала и окончания загрузки, задержка (latency) между передачей данных и их доступностью в таблицах.
- Пропускная способность (rows/second, MB/second) и использование ресурсов узлами BE и FE.
- Процент ошибок, повторных попыток и среднее время восстановления после сбоев.
- Число открытых загрузок и очередей, время ожидания в очереди.
-
Архитектурные аспекты мониторинга:
- Логирование на уровне загрузок (запросы, параметры, форматы, источники).
- Зависимости от внешних хранилищ, включая доступы, политику кэширования и задержки сети.
- Мониторинг целостности схем и соответствия между источниками данных и целевыми таблицами.
-
Эксплуатационные сценарии:
- Обработка ошибок: повторные попытки, дедупликация повторных записей, откат транзакций при критических сбоях.
- Восстановление после сбоев: перезапуск загрузок с сохранением контекста, использование логов изменений.
- Управление качеством данных: периодические контрольные проверки и сигналы об отклонениях.
-
Безопасность и аудит:
- Контроль доступа к источникам данных и интерфейсам загрузки, аудит действий по загрузкам и хранение журналов доступа.
- Шифрование данных в пути и, по необходимости, на промежуточных буферах.
Интеграции и сценарии внедрения
Интеграция Batch Load и Stream Load с внешними источниками данных требует ясной картины доступа, форматов и требований к SLA. Практические сценарии внедрения включают:
-
Интеграция с хранилищами данных:
- HDFS и S3 как источники Batch Load: регулярные пакетные загрузки архивов и исторических наборов.
- Локальные файловые системы как пути для тестирования и промежуточной подготовки данных.
-
Интеграция с поточными платформами:
- Потоковая подача через Stream Load в реальном времени, использование REST API для отправки компактных порций данных.
- Применение конвейеров обработки в реальном времени (например, Flink, Spark Structured Streaming) для подготовки событий к загрузке.
-
Рекомендованные сценарии внедрения:
- Стратегия слоя данных: разделение зоны архивов Batch Load и зоны оперативных данных Stream Load.
- Непрерывная доставка с периодическими валидирующими батчами - чтобы обеспечить согласованность между двумя путями и предотвратить дублирование.
-
Примеры интеграций:
- Интеграция с облачными хранилищами (S3) для Batch Load и локальными HTTP-источниками для Stream Load.
- Связь с системами уведомления и мониторинга для автоматического запуска загрузок по расписанию или по событиям.
## Пример архитектурной схемы конфигурации (описательно)
- **Источник данных**: S3 (Batch Load) + источник потока: сервис событий (Stream Load)
- **Doris**: FE-узлы и BE-узлы, брокерская координация Batch Load
- **API Stream Load**: REST-вызовы к Doris FE для потоковой подачи
- **Мониторинг**: Prometheus + Grafana для загрузок, алертинг по SLA
Практический подход к внедрению следует сочетать стратегию планирования загрузок, тестирование изменений в среде QA и минимизацию влияния на текущие бизнес-процессы. Важной частью является определение границ ответственности между командами: источники данных, инфраструктура хранения, сервисы загрузки и аналитики должны иметь чётко прописанные SLA и процедуры эскалации.
Key takeaways
- Batch Load и Stream Load представляют две разные парадигмы загрузки: пакетная массовая загрузка и потоковая подача с низкой задержкой.
- Архитектура Doris предусматривает координацию между FE, BE и внешними источниками данных, а также наличие интерфейсов для загрузки через брокеры и REST API.
- Выбор между Batch Load и Stream Load зависит от требований к задержке, объему данных и частоте обновления аналитических моделей.
- Оптимизация загрузки достигается через разумное партиционирование, выбор форматов, управление параллелизмом и фильтрацию данных на входе.
- Мониторинг загрузок, управление транзакциями и устойчивые процедуры восстановления критически важны для обеспечения SLA.
- Интеграции с внешними хранилищами и потоковыми платформами требуют согласованных процедур доступа и проверки целостности данных.
- Регулярная валидация данных после загрузки и автоматизированные сценарии реакции на ошибки являются основой надёжной аналитической инфраструктуры.
FAQ
- Что такое Batch Load и Stream Load в контексте Apache Doris?
Batch Load - это метод загрузки больших объёмов данных из внешних хранилищ в Doris пакетами через брокера, оптимизированный под пропускную способность и параллелизм. Stream Load - это потоковая загрузка через REST API, обеспечивающая минимальную задержку между появлением данных и их доступностью в таблицах Doris. Оба метода дополняют друг друга и позволяют строить конвейеры данных с различными требованиями к задержке и объему.
- Какие форматы данных поддерживаются для Batch Load и Stream Load?
Batch Load традиционно лучше всего работает с колоночными форматами и сериализованными файлами Parquet/ORC, обеспечивающими эффективное считывание и валидацию схемы. Stream Load чаще ориентирован на текстовые форматы, такие как JSON и CSV, что упрощает десериализацию при порционной подаче. В реальных сценариях форматы можно комбинировать в зависимости от источника и требований к задержке.
- Как выбрать между Batch Load и Stream Load для конкретного конвейера?
Выбор зависит от бизнес-целей: если необходима высокая пропускная способность при обработке исторических данных, Batch Load - предпочтительный выбор. При необходимости минимальной задержки и реального времени внедряются Stream Load или гибридная архитектура: потоковая подача с периодическими батчами для нормализации данных и обеспечения согласованности.
- Какие ключевые параметры влияют на производительность загрузки?
Ключевые параметры включают уровень параллелизма, размер пакета в Batch Load, форматы данных и схему таблицы, политики повторной попытки и времени жизни транзакций, а также настройки буферов и очередей в Stream Load. Важно поддерживать баланс между задержкой и пропускной способностью и избегать перегрузки BE-узлов.
- Как обеспечивается консистентность и идемпотентность загрузок?
Консистентность достигается за счет механизмов транзакций на уровне загрузки, а идемпотентность - через идентификаторы загрузок (Label/LoadId) и повторную попытку без дублирования данных. В практике следует реализовать дедупликацию на уровне источника данных и/или на уровне Doris.
- Какие шаги следует предпринять для мониторинга загрузок?
Необходимо централизовать сбор метрик по времени начала/окончания загрузки, latency, throughput и error rate, а также собирать логи загрузок и статусы обработки. Настраиваются алерты на задержки выше порога SLA, а также уведомления об ошибках и повторных попытках.
- Какие риски связаны с Batch Load и как их минимизировать?
Риски включают задержки, связанные с обработкой больших пакетов, несоответствие схем, дублирование данных и отказоустойчивость внешних хранилищ. Минимизация достигается через тестирование в QA, верификацию схем, параллелизм с контролируемыми лимитами, а также мониторинг и автоматические процедуры восстановления.
- Как обеспечить безопасность при загрузке данных?
Необходимо настроить аутентификацию и авторизацию на уровне источников данных и API загрузки, использовать шифрование данных в пути, ограничивать доступ к ключевым узлам Doris и хранить логи загрузок для аудита.
- Какие интеграции с внешними системами наиболее распространены?
Наиболее распространены интеграции с HDFS и S3 для Batch Load и REST API Stream Load. Часто встречаются коннекторы к потоковым системам ( Kafka/Flume/Продукты облачных провайдеров) для инициирования потоковой подачи и формирования конвейеров обработки.
- Какие лучшие практики применимы к внедрению загрузки в прод?
Организуйте четкую схему контроля версий схем таблиц, реализуйте тестирование на данными наборах, применяйте поэтапное внедрение с rollback-планами, используйте мониторинг и алерты для раннего обнаружения проблем, поддерживайте документацию по процессам загрузки и ответственности команд.


