

Соответствие требованиям и регуляторика: GDPR/CCPA, retention политики
Современная архитектура корпоративного хранилища данных должна эффективно сочетать требования регуляторов и операционные потребности бизнеса. В контексте Data Vault это означает прозрачную трассируемость источников данных, детальную ориентацию на метаданные, безопасное управление PII и регламентами по хранению и уничтожению данных. Глава рассматривает архитектурные принципы, политики и практики реализации хранения, доступа, уничтожения и аудита, которые обеспечивают соответствие GDPR и CCPA в рамках модульной и масштабируемой DV-архитектуры, а также взаимодействие с BI-системами и процессами управления данными.
С учетом растущего спроса на персональные данные к регуляторам предъявляются требования к минимизации обработок, явной цели использования данных и возможности доказать соблюдение. Data Vault, при грамотной реализации, выступает не только как модель хранилища, но и как инфраструктура для управления данными в контексте регуляторики: хранение атрибутов атрибутов, детальная история изменений, поддержка запросов субъектов данных и встроенная поддержка аудита. Однако для полного соответствия необходимо рассмотреть вопросы классификации и маркировки данных, управления ключами, политики доступа, а также механизмов уничтожения и псевдоанонимизации данных.
Краткое содержание главы
- Обзор регуляторной базы GDPR/CCPA и роли Data Vault в обеспечение соответствия
- Архитектура хранения, защиты и политики retention с учётом требований регуляторов
- Метаданные, аудит и lineage как основа для доказательства соблюдения
- Процессы управления запросами субъектов данных и жизненного цикла данных
Регуляторика и концепции в Data Vault
GDPR и CCPA устанавливают базовые принципы обработки персональных данных: законность, минимизацию, ограничение целей обработки, точность, целостность и конфиденциальность. В контексте Data Vault это означает:
- явную маркировку и классификацию полей как PII или чувствительные данные;
- обеспечение возможности извлечения и карантинизации данных по субъекту;
- хранение достаточной информации для аудита и доказательства соблюдения, даже если сами данные требуют удаления.
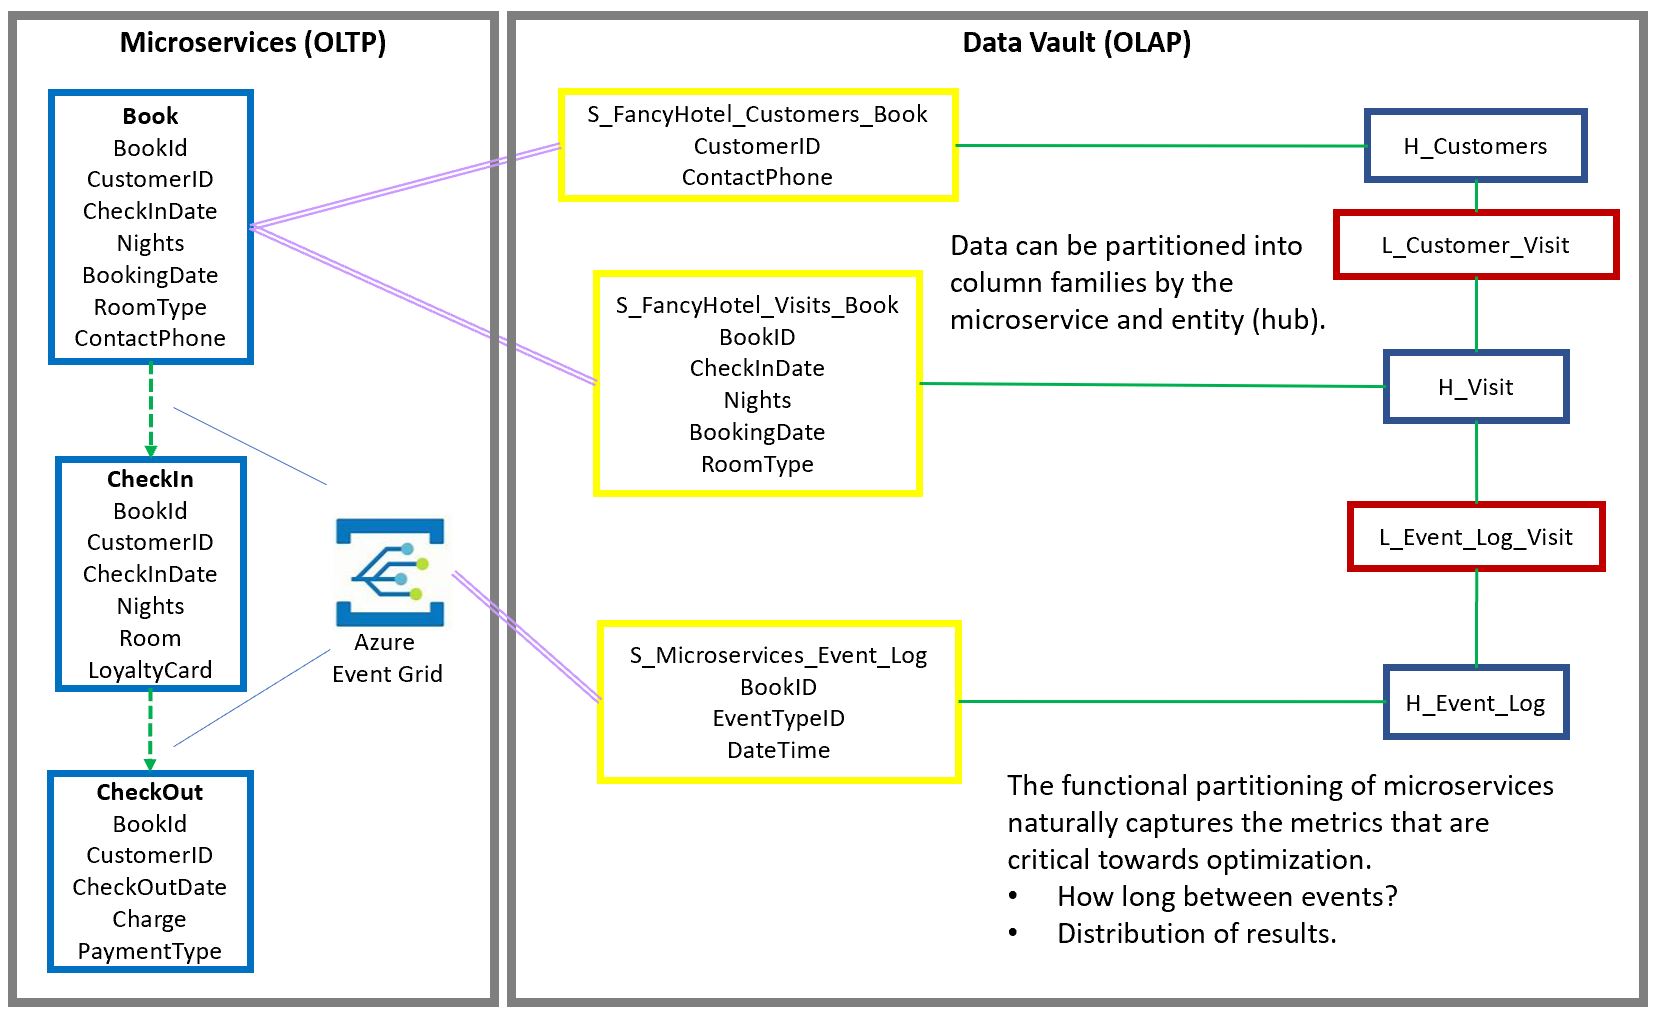
Data Vault естественно разделяет данные на хабы (бизнес-ключи), линк-таблицы и сателлиты. Это дает шанс минимизировать воздействие регуляторных требований на исторические данные: в случае необходимости удаления данных можно ограничиться уничтожением или псевдоанонимизацией конкретных полей в сателлитах, сохранив при этом целостность бизнес-ключей и связь между сущностями. В то же время регуляторика требует не только удаления данных, но и аудита действий, связанных с персональными данными. Поэтому в DV целесообразно проектировать архитектуру с учётом следующих принципов:
- маркировка данных: каждое поле, содержащее PII, должно иметь атрибут классификации в слое метаданных (например, “PII: email, phone, address”);
- хранение минимально необходимой информации: если возможно, хранить идентификаторы в зашифрованном или псевдонимизированном виде, чтобы предотвратить несанкционированный доступ к реальным значениям;
- подготовка к запросам субъектов: архитектура должна поддерживать локализацию данных по субъекту и их удаление или обезличивание без разрушения аналитической ценности моделей DV;
- аудит и прозрачность: должна быть детальная запись доступа к данным и изменений, связанных с PII, включая операции удаления, исправления и экспорта.
Роль DV в реализации прав субъектов данных здесь состоит в том, чтобы предоставить управляемую и прослеживаемую структуру для locate-and-act: оперативная идентификация мест хранения PII, применение политик удаления или псевдонимизации без нарушения целостности хранилища и обеспечения аудита. В качестве опорной модели можно рассмотреть использование внешнего реестра метаданных и политики доступа, связываемых с DV через уникальные маркеры и политики хранителя ключей.
Примечание по контрактам и правовым основаниям: GDPR требует наличия законной основы для обработки данных и документирования цели обработки. В DV это может быть отражено в наборах атрибутов в таблицах метаданных: правовая основа, цель обработки, срок хранения, согласие, дата согласия, дата изъятия согласия и т.д. В рамках CCPA особую роль играет право потребителя на отказ от продажи и на доступ к персональным данным; для этого необходимо обеспечить доступ к данным субъекта и возможность их удаления или анонимизации по запросу.
В контексте технологий можно указать две концептуальные реализации:
- использование псевдонимов и токенов: заменять реальные значения чувствительных атрибутов на безопасные токены, сохраняемые в контролируемом окружении ключей; это облегчает аналитическую выборку без раскрытия реальных данных;
- разделение слоев данных: PII хранится в отдельных сателлитах или в специализированном сегменте хранилища и подвергается более жестким требованиям доступа и защиты. Это упрощает применение политики удаления и аудита на чувствительных данных без влияния на нерелевантные бизнес-ключи.
В контексте выбора технологий стоит упомянуть подходы и инструменты, которые применяются для поддержания регуляторики. В рамках открытого ПО хорошо зарекомендовали себя инструменты для каталога данных и политики управления доступом. Например, Apache Atlas может служить каталогом метаданных и регистрировать данные источников, классификацию и lineage, а Apache Ranger - как механизм политики и контроля доступа. Как дополнительные решения можно рассмотреть Amundsen для каталога данных и интеграцию через API-доступ к DV-слою. Приверженность практикам governance и аудита поможет обеспечить доказуемость соответствия.
Применение правил хранения и уничтожения
- Нормативные сроки хранения должны быть прописаны в политике и привязаны к каждому классу данных. DV может хранить данные в историческом виде, но политики retention должны управлять сроками жизни и уничтожением PII.
- Уничтожение и псевдоанонимизация должны быть выполнены централизованно и документированно. Необходимо поддерживать журнал действий по удалению и обезличиванию.
- При необходимости можно внедрить отдельный “анонимизационный слой”, где по истечении retention-слой соответствующие поля обнуляются или заменяются токенами; при этом сохраняются связи hub-link-satellite для аналитической целостности.
Архитектура соответствия: хранение, безопасность и retention
Эта часть касается технических решений по защите данных, их классификации и управлению сроками хранения. Основной задачей является обеспечение необходимого уровня защиты и возможности выполнения регуляторных действий без разрушения архитектурной целостности DV.
Ключевые принципы:
- защита данных на уровне хранения и передачи: шифрование на диске и в пути, управление ключами, ограничение доступа на уровне атрибутов и ролей;
- классификация и маркировка PII на семантическом уровне; хранение метаданных о целях обработки и юридических основаниях;
- политика retention, охватывающая как операционные, так и нормативные сроки, включая ситуации с юридическими задержками (holds), архивирование и уничтожение;
- поддержка аудита и трассируемости операций с данными, включая доступ и изменения, связанные с PII.
Техническая реализация архитектуры соответствует нескольким взаимосвязанным слоям:
- слой данных DV: hubs, links и satellites с сохранением полной истории изменений;
- слой защиты: шифрование данных как в спринге, так и на уровне столбцов, управление ключами (KMS/Key Vault), маскирование и псевдонимизация;
- слой управления доступом: централизованные политики доступа, разделение ролей, ABAC/ RBAC, аудит доступа;
- слой политики retention: централизованный движок для определения сроков хранения, механизмы реализации удаления или обезличивания;
- слой архивации и уничтожения: отдельная подсистема для архивирования не-PII данных и безопасного уничтожения PII в срок или при запросе.
Упрощенный сценарий реализации политики retention в DV может выглядеть так:
-
настраивается центральный регистр политик хранения, связывающий каждый атрибут с правилами хранения и типами данных;
-
создаются процедуры для обработки удаления или обезличивания PII по запросу;
-
на уровне ETL/ELT добавляются шаги по верификации соответствия и учёту аудита;
-
применяется периодический процесс, который сканирует SATELLITE-таблицы на предмет устаревших записей и выполняет соответствующие действия: удаление, обнуление или миграцию в архив.
-- Пример псевдокода для обезличивания PII в satellites -- Цель: удалить или обезличить PII по субъекту в рамках retention-политики -- Предположим, что subject_id является внешним идентификатором субъекта FOR EACH satellite IN SATELLITES_PI I: UPDATE satellite SET pii_email = NULL, pii_phone = NULL, pii_address= NULL WHERE hub_subject_id IN ( SELECT hub_subject_id FROM hub_subject WHERE subject_id = :subject_id ) AND effective_fromОграничения и компромиссы
-
Data Vault в условиях регуляторики требует баланса между полнотой истории и требованиями к удалению. Полная историчность может препятствовать выполнению прав на удаление, поэтому архитектура должна поддерживать альтернативные пути: обезличивание и/или хранение неPII копий.
-
Ключи и идентификаторы: в HDP/EDW хранение реальных PII может быть заменено на псевдонимы. В таком случае важно управлять ключами доступа и повторной идентификацией, чтобы не потерять способность к аналитической маршрутизации.
-
Архивирование vs удаление: хранение длительных периодов жизни данных, не являющихся PII, может быть оправдано бизнес-аналитикой, однако регуляторика требует точного контроля над временем хранения PII и его уничтожения.
Безопасность и управление доступом
- Использование шифрования на уровне столбцов или таблиц, контроль камер и журналирование.
- Управление ключами с помощью централизованных сервисов (KMS/KMS-like), регулярная смена ключей и проконтроль доступа к ключам.
- Разделение прав доступа: операции по управлению PII ограничены узким кругом привилегированных пользователей и сервисов.
Метаданные и аудит (значение для регуляторики)
- В DV хранение информации о сущности, связывающей данные (кто и зачем обрабатывает) критически важно. Метаданные должны включать: категорию данных, юридическую основу, срок хранения, согласие, и дату его отзыва.
- Линейность и lineage позволяют проследить, как данные перемещаются через систему, какие источники применялись и какие трансформации выполнялись. Это является ключом к аудиту и доказательству соответствия.
- Применение каталогов метаданных как Apache Atlas или Amundsen упрощает поисковую работу, обеспечивает единый источник истины и упорядочивает запросы на доступ.
Управление мастер-данными и права доступа
В рамках DV возможно создание отдельного слоя управления правами и согласиями. Включение контроля доступа к PII и к чувствительным данным на уровне политик с использованием механизмов ABAC/RBAC позволяет централизованно применять регуляторные требования и оперативно адаптироваться к изменениям в законодательстве.
Метаданные, аудит и lineage
Метаданные в DV выступают не просто как вспомогательная информация, а как основу для соответствия требованиям. Включение детального описания цели обработки, правовых оснований и сроков хранения в реестр метаданных позволяет приводить аргументацию по регуляторике на уровне аудита и регуляторных запросов.
- Категоризация данных: каждый атрибут должен иметь классификацию (PII, чувствительные данные, общедоступные данные и т. д.). Это позволяет быстро определить перечень данных, требующих повышенного уровня защиты и особой осторожности при обработке.
- Идентификация источников и lineage: DV строит линейку от источника к конечной аналитике; мониторинг цепочек данных необходим для доказывания того, какие источники питания используются для конкретной аналитической задачи.
- Логирование доступа и изменений: для соблюдения GDPR/CCPA критически важно регистрировать действия с данными, особенно с PII и данными, подвергающимися удалению.
Инструменты и практики
- Каталоги метаданных: Apache Atlas, Amundsen. Они позволяют централизованно фиксировать классификацию, линейность, цели обработки и прочую регуляторную информацию.
- Инструменты контроля доступа: Apache Ranger или аналогичные решения, которые позволяют задавать детальные политики доступа к данным на уровне колонок, таблиц и пользователей.
- Встраивание аудита в процессы ETL/ELT: включение аудита в конвейеры данных, автоматическое документирование изменений и действий по удалению.
Управление запросами субъектов данных и жизненный цикл
Гражданские регламенты требуют эффективной поддержки запросов субъектов данных: доступ к своему набору данных, исправление ошибок, удаление и переносимость. В Data Vault задача усложняется тем, что данные историализированы, а структура DV ориентирована на сохранение связей между сущностями.
Процессы
- Инвентаризация и идентификация: при запросе необходимо локализовать данные субъекта в DV-структуре: какие hubs/links/satellites связаны с данным субъектом, какие поля несут PII, какие версии данных существуют.
- Верификация личности: процесс, требующий надёжной идентификации запрашивающего, чтобы предотвратить несанкционированный доступ к данным. Это может включать многократное факторное аутентифицирование и контекстуальные проверки.
- Реализация rights: реализовать право на доступ, исправление, переносимость и удаление. Для удаления - определить, можно ли выполнить полное уничтожение или обезличивание, и какова политическая трактовка «право быть забытым» в рамках аналитических целей.
- Обеспечение прослеживаемости: хранить доказательства выполнения запроса, журналирование и создание аудиторских следов.
Механизмы реализации
- Корректировочные слои: для выполнения запросов субъектов может быть разработан специальный слой услуг (service layer) со стандартными API для доступа и редактирования данных субъекта.
- Обезличивание и удаление: обезличивание PII в satellites при необходимости, или удаление записей, если закон это требует. Уничтожение должно сопровождаться обновлением метаданных и аудита.
- Согласие и его управление: интеграция с системами управления согласием, чтобы срок хранения и обработка соответствовало данному согласию, и чтобы в случае отзыва согласия данные были немедленно удалены или обезличены.
Интерфейсы и интеграции
- REST/GraphQL API поверх DV-слоя для обработки запросов субъектов. API обеспечивает верификацию, доступ к данным в безопасном виде и возврат результатов пользователю.
- Процедуры и веб-хуки для уведомления BI-пользователей об изменении данных, влияющих на существующие отчеты.
- Каналы уведомления и журналирования: оповещения об удалении/изменении, журнал аудита и мониторинг событий.
В контексте BI
- На уровне BI-слоя следует избегать вывода полного набора PII. Реализация принципов маскирования и ограничение набора данных, доступного в отчетах.
- Механизмы соответствия должны быть прозрачны для пользователей BI: dashboards должны показывать только допустимую долю данных и демонстрировать, что доступ к PII ограничен и защищен.
- Эффективная архитектура позволяет BI-инструментам ранжировать данные по чувствительности и безопасному доступу.
Интеграция с BI и операционные процессы
Для обеспечения регуляторной совместимости требуется тесная связка DV с BI и операционными процессами. Важны:
- прозрачность и контроль доступа к данным в BI: настройки маскирования, ограничение доступа к чувствительным полям, обеспечение аудита использованием журналируемых процессов.
- согласование между бизнес-правилами и регуляторикой: цели обработки, сроки хранения и обязанности, которые должны быть очевидны в BI-слое для аудитов.
- мониторинг и аудит: постоянный мониторинг доступа к данным, анализ попыток доступа и выполнение действий по удалению, чтобы демонстрировать соблюдение.
Операционные процессы должны быть эволюционными: внедрять governance-метрики, автоматизировать сбор доказательств соответствия и обновлять политики в ответ на изменения законодательства. Встроенный набор процессов по управлению данными и регуляторикой должен соответствовать требованиям аудирования и демонстрации соответствия.
Key takeaways
- Data Vault предоставляет архитектурную основу для управления данными в рамках регуляторики, обеспечивая трассируемость, гибкость и масштабируемость.
- Внедрять регуляторные требования следует через маркировку PII, контроль доступа, политики retention и механизмов удаления/обезличивания без потери аналитической ценности.
- Метаданные и lineage в DV критически важны. Каталоги метаданных и политики доступа (например, Apache Atlas, Apache Ranger) помогают обеспечить прозрачность и доказательность соответствия.
- Управление запросами субъектов данных требует интеграции между DV-слоем, сервисами согласия и BI-системами; это должно быть реализовано через API и сервисы обработки запросов.
- Безопасность: шифрование, управление ключами, маскирование и разделение доступа должны быть встроены в архитектуру с учетом регуляторных требований.
- Архивирование и уничтожение данных должны проводиться централизованно, с надлежащим аудитом и сохранением линейности для аналитических целей.
- В BI ограничение доступа к PII и маскирование должны быть неотъемлемыми частями архитектуры, чтобы гарантировать конфиденциальность и соответствие.
FAQ
- Что такое GDPR и CCRP и чем они отличаются в контексте Data Vault?
GDPR применим к гражданам Европейского Союза и устанавливает принципы законности обработки, минимизации, цели и срока хранения, права субъектов и требования к аудиту. CCPA - к гражданам Калифорнии - фокусируется на правах на доступ к данным, праве на удаление и запрете продажи данных. Оба требуют прозрачности, аудита и возможности осуществления прав субъектов, однако детализация исполнения различается, особенно в отношении право на удаление и переносимость. В DV это достигается через маркировку PII, контроль доступа, централизованные политики retention и механизмы обезличивания, что позволяет соблюдать обе регуляции при сохранении аналитической ценности данных.
- Как Data Vault помогает обеспечить соответствие требованиям регуляторов?
DV обеспечивает трассируемость цепочки данных (линейность) и хранение полной истории изменений. Это важно для аудита и доказательства соблюдения. При этом следует реализовать маркировку PII, управление доступом и политики удаления/анонимизации в рамках metadata-layer. В DV можно разделить PII от остальной информации и применять политики на уровне satellites, сохранив при этом целостность бизнес-модели.
- Какие данные считаются PII и как их идентифицировать в DV?
PII обычно включает идентификаторы, которые могут идентифицировать субъекта напрямую (имя, email, телефон) или косвенно через уникальные идентификаторы. В DV их следует маркировать в реестре метаданных и хранить в отдельных слоях или в зашифрованном виде. Важно определить набор полей, которые подпадают под PII и чувствительные данные, чтобы корректно применять политики доступа, маскирование и удаление.
- Как реализовать право на удаление в DV?
Реализация требует сочетания обезличивания и удаления. В частности можно:
- обезличить PII в satellites (установить значения NULL или заменить токенами);
- удалить связанные записи из линков/хабов, если данные не являются необходимыми для бизнес-аналитики;
- сохранить аудит и историю действий;
- обеспечить возможность восстановления данных при ошибке или запросе на переносимость.
Важно документировать процесс и хранить доказательства выполнения.
- Какие технические средства обеспечивают безопасность данных в DV?
Шифрование данных на уровне хранения и передачи (TLS, бесшовное шифрование таблиц/столбцов), управление криптоключами (KMS/Key Vault), маскирование и псевдонимизация, детальное управление доступом (RBAC/ABAC), аудит и журналирование всех действий с PII, а также разделение ролей между операторами, аналитиками и администраторами.
- Как обеспечить ретенцию и архивирование в DV с учётом регуляторики?
Необходимо определить сроки хранения для разных категорий данных и держать политически регламентированные сроки в дефинициях политики retention. Данные старше срока хранения могут быть архивированы для аналитики без прямого доступа к PII или обезличены. Регулярные проверки соответствия и механизмы уничтожения должны быть встроены в конвейеры данных.
- Как организовать аудит и доказательства соблюдения?
В DV следует хранить детальные журналы доступа к данным, операции по удалению и обезличиванию, связь между субъектами и их данными, а также версии правил и политик. Использование реестра метаданных и инструментов каталогизации (например, Apache Atlas) помогает поддерживать доказательства. Встроенный аудит должен покрывать все операции с PII и хранение их для регуляторного анализа.
- Какие подходы использовать для интеграции с BI-системами без риска нарушения приватности?
Применять маскирование, ограничение доступа, фильтрацию по ролям, а также использовать обезличенные или псевдонимизированные данные там, где это возможно. BI-слой должен опираться на агрегации и обезличенные наборы данных, а доступ к PII - через контролируемые API и сервисы, обеспечивающие аудит и соответствие.
- Какие кейсы или практики стоит взять за основу при внедрении?
Начинать стоит с доказываемой политики учёта и классификации данных, создания реестра метаданных, проектирования политик retention и удаления, и внедрения слоев обезличивания и шифрования. Платформа должна поддерживать гибкие политики, чтобы можно быстро адаптироваться к изменениям законодательства и бизнес-правил.
- Что важнее в выборе инструментов для регуляторики в DV?
Важны возможности для маркировки и классификации данных, управления доступом, аудирования, поддержки безболезненного удаления или обезличивания, а также интеграции с каталогами метаданных. Открытые решения (например, Apache Atlas/Ranger) и современные решения для каталогов данных помогут создать устойчивую и прозрачную инфраструктуру, которая может адаптироваться к изменениям регуляторного ландшафта.
Глава рассчитана на профессионалов, которые реализуют Data Vault в крупных корпоративных средах, где соблюдение GDPR/CCPA и регуляторных требований требует чётких процессов управления данными, надёжной архитектуры и интегрированной поддержки метаданных и аудита.


