Концепции Data Mesh компании Intuit
Для создания интеллектуальных продуктов компании были нужны передовые системы, основанные на данных. Data mesh, которую удалось построить в Intuit, внесла значительный вклад в достижение этих амбициозных целей.
Созданное нами решение позволило достичь следующего:
1. Повышения производительности на 26 %, что позволило командам по работе с данными посвятить больше времени поиску и изучению данных для новых проектов;
2. Значительного повышение уровня безопасности (прошу прощения за отсутствие конкретики, но показатели безопасности Intuit являются конфиденциальной информацией);
3. Уменьшилось количества галлюцинаций LLM в наших внутренних чат-ботах для разработчиков на 44 %.
Примечание: достижения были определены при помощи сравнения итоговых показателей (производительность, безопасность, галлюцинации LLM) в среде, где данные, системы и люди использовали платформу data mesh, с такими же показателями в среде, где data mesh не использовалась. Эти цифры дают нам уверенность в том, что мы сможем расширить область применения новых принципов до всего Intuit и увидеть те же преимущества, обеспечив тем самым гораздо более значительные результаты для компании в целом.
В этой статье мы подробно рассмотрим концепции, которые лежат в основе реализации data mesh компании Intuit. Содержание этой статьи основано на внутренних документах, презентациях и диаграммах, фиксирующих архитектуру целевого состояния data mesh организации.
Я надеюсь, что Вы сможете использовать эти данные в качестве руководства по внедрению сервисов и процессов, необходимых для реализации всех преимуществ data mesh.
Чуть позже, отчасти в зависимости от отзывов о данной статье, я планирую выложить в открытый доступ внутренние определения API и принципы реализации сервисов Intuit, чтобы разработать общий стандартный подход к внедрению data mesh во всей отрасли.
Концепции
В этом разделе перечислены все важнейшие термины и их взаимосвязи друг с другом. Там, где это действительно целесообразно, приводятся диаграммы отношений между сущностями, позволяющие наглядно показать, что именно означает тот или иной термин и как он используется.
1 — Бизнес-подразделение (business-unit)
Отдельная часть организации, отвечающая за конкретные функции или цели, состоящая из одной или нескольких команд. Бизнес-подразделения несут ответственность за оплату использования определенных ресурсов или услуг. Такая финансовая ответственность обеспечивает подотчетность каждого подразделения и стимулирует более эффективное использование платформы данных и ее услуг.
2 — Команда (team)
Группа людей, формирующая бизнес-подразделения, сотрудничающие меду собой для достижения общих целей. Данная группа людей активно использует портал разработчиков Intuit (Intuit Dev Portal).
3 —Проект портала разработчиков Intuit (Intuit Dev Portal Project)
Портал разработчиков Intuit (Intuit Dev Portal) - это внутренний инструмент, предназначенный для команд разработчиков, призванный помочь им в создании новых продуктов и услуг.
Проект портала разработчиков Intuit (Intuit Dev Portal Project) - это основная организационная единица портала разработчиков Intuit. Это пространство, предназначенное для совместной работы команд. Как правило, проект представляет собой конкретную инициативу, принадлежащую команде в рамках бизнес-подразделения.
3.1 — Человеческая роль (human role)
Роль представляет собой группу лиц в составе команды Проекта портала разработчиков Intuit (Intuit Dev Portal Project), выполняющую определенные функции в рамках проекта. Каждая роль тесно связана с учетными данными, которые предоставляют авторизованный доступ к потреблению и/или созданию данных.
4 — Распорядители данных (data stewards)
Распорядители данных отвечают за создание, эксплуатацию и управление данными в соответствии с руководством по управлению данными компании Intuit. Существует два типа распорядителей данных:
4.1 — Распорядитель бизнес-данных (business data steward)
Отвечает за определение и обеспечение качества данных, которые производит система.
4.2 — Распорядитель операционных данных (operational data steward)
Отвечает за создание и развертывание систем, производящих данные в соответствии с заявленными определениями данных и ожиданиями качества. Распорядители операционных данных исполняют человеческую роль "Разработчик".
5 — Домен (domain)
Объединение связанных логических границ. Домены обеспечивают стандартизированный подход к организации данных в Карте данных (Data map).
6 — Ограниченный контекст (bounded context)
Логические границы внутри определенного домена или субдомена, изолирующие его данные от других контекстов. Ограниченные контексты также служат основным способом просмотра и обнаружения данных на Карте данных, облегчая пользователям навигацию и понимание взаимосвязей между различными элементами данных.
7 — Модель данных (data model)
Модель данных - это формальное описание связанного набора понятий и определений и их отношений друг с другом.
7.1 — Семантическая модель ( semantic model)
Особый вид модели данных, передающий семантическое значение данных и отношений в ограниченном контексте. Данная модель отделена, но при этом тесно связана со схемой данных, описывающей представление данной модели данных в определенном месте хостинга.
Эти модели следуют методологии проектирования, ориентированной на домен, и обычно определяют сущности, объекты значений и т. д.
7.2 — Схема данных (data schema)
Формальное представление структуры модели данных при хранении в определенном месте хостинга. Схемы данных основываются на семантической модели и должны соответствовать ей, но могут и отклоняться от нее для того, чтобы соответствовать требованиям к формату и шаблонам доступа в хостинге, где хранятся данные. Схема данных может содержать семантические аннотации и аннотации соответствия, которые обеспечивают дополнительный контекст. Схема данных помогает обеспечить надлежащее управление и обработку данных, сводя к минимуму риски, связанные с нарушением нормативных требований или политик. Примерами схем данных являются JSON-Schema, Hive DDL и т. д.
8 — Ресурс данных (data resource)
Ресурс данных относится к данным, управляемым системой хранения данных. В частности, это может быть таблица в базе данных, файл в файловой системе, тема в системе обмена сообщениями и т. д. Как только ресурс данных зарегистрирован и ему присвоен IRN, он автоматически становится активом данных.
9 — Расположение хостинга (hosting location)
Система, облегчающая хранение и обслуживание активов данных за счет соблюдения требований к месту размещения данных, что обеспечивает контролируемый и безопасный обмен данными с другими командами и способствует эффективному сотрудничеству и управлению данными в рамках компании.
В качестве хостингов используются такие системы, как Intuit Customer Data Lake, Operational Data Lake, Event Bus и Customer Data Profile Store.
9.1 — Протоколы данных (data protocols)
Поддерживаемые способы взаимодействия с хостингом для хранения и получения данных. К ним, в частности, относятся протокол Kafka, протокол GraphQL RPC, протокол HTTP+REST, протокол HTTP+S3 и т. д.
9.2 — Каталог (catalog)
Каталог расположения хостинга содержит реестр схем, используемых для описания хранящихся в нем активов данных. Каталог позволяет пользователям и системам быстрее понимать данные, хранящиеся в расположении хостинга, и работать с ними. Например, часть метахранилища Hive Metastore - это каталог озера данных компании Intuit.
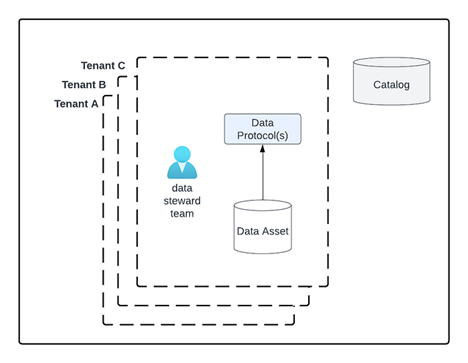
9.3 — Арендатор (tenant)
Под арендатором хостинга понимается команда, получившая доступ к управлению ресурсами данных в среде виртуального хостинга. Каждый арендатор обладает выделенными ресурсом данных, портами и политиками контроля доступа, что обеспечивает полную изоляцию от процессов других арендаторов.
На данной схеме Вы сможете увидеть расположение хостинга, команду, ресурс данных и порт данных, обслуживающий данные:
10 — Доступ к данным (data access)
Доступ к данным - это процесс и ресурсы для предоставления (или ограничения) права на взаимодействие с определенными данными. Он учитывает человеческий и машинный доступ, обеспечивая четкий и последовательный подход к управлению привилегиями доступа.
10.1 — Список доступа к данным (data access list)
Список доступа к данным - это набор записей доступа к данным, определяющих привилегии доступf к определенному активу данных. В нем указываются разрешенные человеческие и машинные учетные данные и соответствующие привилегии доступа к активу данных.
10.2 — Запись доступа к данным (data access entry)
Запись доступа к данным - это отдельная запись в списке доступа к данным. Она перечисляет набор определенных учетных данных и соответствующих привилегий доступа, предоставленных субъектам, обладающим этими учетными данными. Каждая запись содержит следующую информацию: идентификатор учетных данных, тип (например, роль AWS) и уровень предоставляемого доступа (например, чтение или запись).
10.3 — Учетная запись (credential)
Учетная запись - это уникальный идентификатор, присвоенный системе обработки данных или роли человека в проектной группе портала разработчиков Intuit. Учетные записи способствуют безопасному и контролируемому обмену данными между производителями и потребителями данных.
11 — Актив данных (data asset)
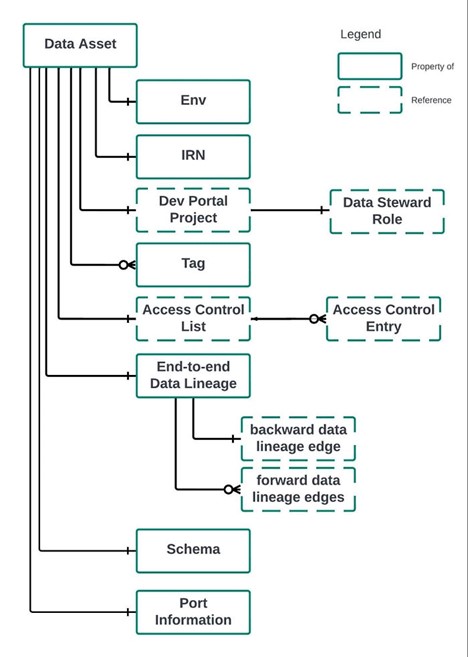
Формально актив данных представляет собой ресурс данных, который объединяет такую важную информацию, как право собственности, список контроля доступа, ссылку на data lineage, а также информацию о порте данных.
11.1 — IRN
IRN (Intuit Resource Name) - это уникальный идентификатор, используемый в экосистеме данных Intuit для идентификации активов данных. IRN разработан для обеспечения стандартного подхода к присвоению наименований, что значительно облегчает поиск, управление и отслеживание активов данных в различных системах и службах.
11.2 — Порт данных (data port)
Описание интерфейса, предоставляемого хостинговыми площадками, позволяет осуществлять контролируемый обмен данными с определенным активом данных, принадлежащим конкретной команде распорядителей данных. Порт данных значительно облегчает этот обмен за счет соблюдения политик доступа, управляемых и регулируемых центральной платформой данных. Этот интерфейс может обслуживать данные из портов данных (например, конечную точку GraphQL или тему Kafka) или получать данные из портов данных (например, команды через HTTP API).
12 — Сводный Data Lineage (end-to-end data lineage)
Сводный data lineage - это направленный граф, отображающий связи и зависимости между активами данных и активами разработки. Он обеспечивает наглядность потока, преобразования и происхождения данных на протяжении всего их жизненного цикла, вплоть до уровня атрибутов. Подобное целостное представление обеспечивает лучшую прослеживаемость, понимание и управление данными в системах и командах.
12.1 — Обратный data lineage (backward data lineage)
Под обратным data lineage понимается возможность проследить происхождение, перемещение и преобразование данных на протяжении всего их жизненного цикла - от создания до конечного использования в продуктах данных. Это включает в себя отслеживание того, как данные собирались, преобразовывались и интегрировались с другими источниками для создания конечного продукта данных.
12.2 — Прямой data lineage (forward data lineage)
Под "прямым data lineage" понимается отслеживание потока данных от момента их возникновения (через различные процессы, преобразования и интеграции) до факта их потребления в корпоративных системах. Данный процесс позволяет ответственным за управление данными понять влияние изменений на зависимые системы, потребляющие данные, что обеспечивает эффективное управление качеством данных и соответствие нормативным требованиям.
12.3 — Заявленный Data Lineage (declared data lineage)
Заявленный data lineage - отслеживание заявлений об использования данных согласно правилам, зафиксированным в в списках управления доступом к данным.
12.4 — Наблюдаемый Data Lineage (observed data lineage)
Отслеживание активности чтения и записи данных, полученной из журналов доступа систем обработки и хостинга, которые являются источником истины для графа данных.
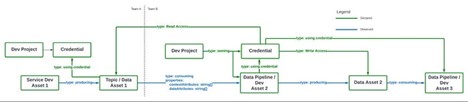
На данной диаграмме изображен прототип графа линии данных:
13 — Рецепт данных (data recipe)
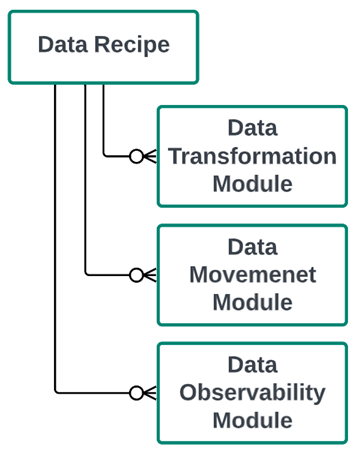
Рецепт данных формально представляет собой операции развертывания, необходимые для настройки системы обработки данных с целью получения продукта данных. Рецепты данных ссылаются на модули данных. Модули данных описывают, как необходимо обеспечить и подключить места размещения и инфраструктуру обработки данных.
13.1 — Модуль преобразования данных (data transformation module)
Модули, определяющие, как данные должны обрабатываться, преобразовываться и передаваться на хостинг для удовлетворения определенных бизнес-требований. Сюда входят задачи обработки обучения или задачи вывода.
13.2 — Модуль движения данных (data movement module)
Модули, определяющие, как данные передаются между хостингами (но не преобразовываются).
13.3 — Модули наблюдаемости данных (data observability module)
Модули, устанавливающие механизмы мониторинга, регистрации и оповещения для отслеживания производительности, качества и состояния процессов обработки данных и активов данных. К ним относятся правила качества данных, нарушения политики безопасности и т. д.
Данные модули данных работают совместно в рамках рецепта данных. Это позволяет оптимизировать и автоматизировать задачи обработки данных, что значительно облегчает разработку системы обработки данных.
На диаграмме ниже отображены рецепт данных и три типа модулей данных:
14 — Продукт данных (data product)
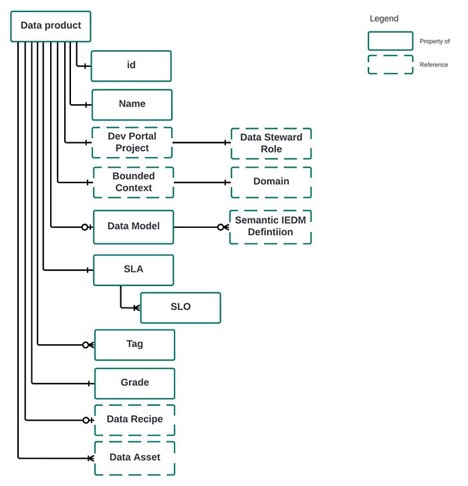
Продукты данных являются основополагающей единицей данных в data mesh и организованы по ограниченному контексту и областям данных. Продукт данных состоит из одного или нескольких активов данных. Он объединяет такую важную информацию, как право собственности, семантическая модель, схема данных, соглашения об уровне обслуживания (SLA), теги и рецепт данных. Важно также отметить, что продукты данных могут быть обнаружены только после того, как они удовлетворят требования минимального трехзвездочного порога чистоты данных. Данный рейтинг гарантирует, что продукт данных описан должным образом и управляется в соответствии с требованиями эффективного межкомандного сотрудничества и надежного обмена данными. Определение продукта данных необходимо для каждого потребляемого актива данных. Примером продукта данных может быть "Продукт данных о клиентском счете", описывающий семантическую модель "клиента", реализованную в виде потока событий, созданных в режиме реального времени.
14.1 — Наименование (name)
Атрибут наименования продукта данных - это отображаемое имя, позволяющее легко понять содержание и назначение продукта.
14.2 — Тег (tag)
Теги - это описательные метки или ключевые слова, связанные с продуктом данных, используемые для облегчения его поиска и идентификации в процессе открытия Карты данных.
14.3 — Цель уровня обслуживания (service level objective, SLO)
SLO - это измеряемая цель, определяющая ожидаемый уровень производительности или надежности для конкретного аспекта продукта данных. К общим целям SLO относятся качество х, свежесть и доступность данных. SLO позволяет заинтересованным сторонам устанавливать четкие и количественно измеримые цели, отслеживать выполнение этих целей и принимать решениядля повышения производительности и надежности.
14.4 — Соглашение об уровне обслуживания (service level agreement, SLA)
SLA - это контракт между администратором данных и их потребителями, который определяет набор SLO для продукта данных. SLA позволяет потребителю данных отслеживать эффективность продукта данных и принимать решения, основанные на данных, для управления бизнес-процессами.
14.5 — Ссылка на рецепт данных (data recipe reference)
Ссылка на рецепт данных, который представляет собой производственную задачу, связанную с перемещением, преобразованием и наблюдением данных продукта данных.
Ниже представлены различные компоненты сущности продукта данных:
15 — Типы активов данных (data asset kinds)
Типы активов данных классифицируют данные в зависимости от их назначения, уровня доступа и потенциальных потребителей. К типам активов данных относятся:
15.1 — Внутренние активы данных (internal data assets)
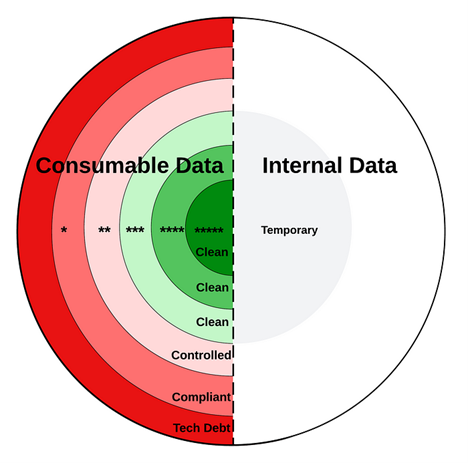
Внутренние активы данных - это данные, созданные, управляемые и потребляемые в рамках конкретной команды. Этот тип данных часто используется для операционной деятельности. Доступ к внутренним данным ограничивается уполномоченными членами команды и не предназначен для внешнего потребления. Внутренние данные должны соответствовать двум звездам в модели зрелости чистых данных, что требует наличия соответствующих метаданных для решения проблем соответствия и безопасности, которым подвержены все данные.
15.1.3 — Временные данные (temporaty data)
Временные данные - это данные, которые не предназначены для длительного хранения. Как правило, они создаются в процессе изучения данных для принятия внутренних решений и анализа. Зачастую это данные, которые не связаны с регулярным конвейером, не отслеживаются и не потребляются (или не должны потребляться). В качестве примера можно привести данные, созданные с помощью разовых запросов "CREATE TABLE" во время исследования данных, или разовые эксперименты с моделями, которые генерируют данные, но не переходят в производственную модель. Временные данные должны соответствовать двум звездам в модели зрелости чистых данных, что требует наличия соответствующих метаданных для решения проблем соответствия и безопасности, которым подвержены все данные.
15.2 — Потребляемые данные (consumable data)
Потребляемые данные - это данные, доступные для межкомандного обмена данными. Они должны быть понятными, долговечными и пригодными для использования различными потребителями, как внутренними, так и внешними по отношению к команде. Эти данные оценивается в соответствии с моделью зрелости чистых данных и с учетом описанных в ней ограничений по открываемости и потреблению. Потребляемые данные облегчают совместную работу команды, обмен данными и интеграцию с другими системами или приложениями.
Тиды и подвиды данных:
16 — Регистрация данных (data registration)
Рабочие процессы, связанные с регистрацией активов данных и их продвижением в продукты данных. Сюда входят рабочие процессы для внутренних и потребляемых данных.
16.1 — Жизненный цикл продукта данных (data product lifecycle):
Жизненный цикл продуктов данных включает в себя следующие стадии:
- в разработке
- выпуск
- устаревшие данные
16.2 — Назначение продукта данных (data product intent)
Продукты данных могут быть предназначены для всеобщего потребления или для внутреннего использования.
- Внутренние
- Потребляемые
16.3 — Управление чистыми данными (clean data governance)
Для управления и оценки данных регистрация данных использует модель зрелости чистых данных. Управление данными зависит от их вида.
16.3.1 — Порог потребляемых данных (consumable data threshold)
Продукты данных, предназначенные для использования, считаются выпущенными и имеют звездный рейтинг зрелости чистых данных, равный 3 или выше.
16.4 — Звездный рейтинг зрелости чистых данных (clean data maturity star rating)
Количественная метрика, рассчитываемая на основе модели зрелости чистых данных, которая оценивает качество, надежность и удобство использования продукта данных. Данный рейтинг учитывает различные аспекты, такие как чистота данных, схема, семантический контекст и соблюдение соглашений об уровне обслуживания (SLA). Звездный рейтинг зрелости чистых данных создает четкий базовый уровень ожиданий для управляющих данными, а также предоставляет потребителям четкое понимание в отношении сильных и слабых сторон продукта данных, чтобы они могли принимать обоснованные решения при выборе продуктов данных для последующего потребления.
16.5 — Чистые данные (clean data)
Данные, соответствующие порогу "3 звезды", определенному в модели зрелости чистых данных для потребляемых данных.
17 — Карта данных (data map)
Поиск потребляемых продуктов данных организован по доменам, поддоменам и ограниченному контексту. Обратите внимание, что внутренние данные не могут быть доступны широкому кругу лиц, как правило, их может обнаружить только команда, владеющая ими. Таким образом, при создании любой Карты данных, помогающей обнаружить внутренние данные, необходимо учитывать профиль сотрудника, осуществляющего поиск, и набор активов данных, которыми он владеет.
17.1 — Реестр карты данных (data map registry)
Реестр внутренних и потребляемых активов данных включает в себя граф заявленных и предполагаемых data lineage, внутренних и потребляемых активов данных, продуктов данных, доменов, субдоменов, ограниченных контекстов и моделей данных.
17.2 — Таксономия карты данных (data map taxonomy)
Домен данных, поддомен и ограниченный контекст определяют таксономию, организующую все продукты данных в Карте данных.
18 — Время выполнения процесса обработки данных (data processing runtime)
Под временем выполнения процесса обработки данных понимается любое время, обеспечивающие выполнение задач по обработке данных, таких как ввод, преобразование, анализ и хранение данных. Многие решения(например, пакетная обработка Spark,микросервисы Kubernetes и т.д.) предоставляют своим пользователям множество инструментов, библиотеки и самые разнообразные ресурсы для эффективной обработки и манипулирования большими массивами данных в режиме реального времени или в пакетном режиме.
19 — Клиентская среда (customer environment)
Клиентская среда включает в себя компоненты производственного уровня, которые активно используются командами для разработки и тестирования своих продуктов данных. Среда включает в себя рабочие режимы обработки данных и хостинг, позволяющие клиентам развертывать, тестировать и публиковать продукты данных. Режимы обработки данных в клиентской среде стабильны и надежны, что обеспечивает стандартизированный и масштабируемый подход к управлению развертыванием и эксплуатацией продуктов данных.
20 — Экспериментальная сессия (experimentation session)
Экспериментальная сессия позволяет командам проверить жизнеспособность новых идей с помощью данных. Как правило, такое тестирование представляет собой итеративный процесс анализа и доработки, который позволяет получить четкое представление об оптимизации бизнес-процессов, продуктов, услуг и функций. Он включает в себя сбор и анализ данных, проведение экспериментов и формулирование выводов для принятия решений. Данная сессия контролируется центральной платформой данных, что обеспечивает соответствие требованиям и надлежащее управление активами данных и процессами.
21 — Система обработки данных (data processing system)
Развертываемая единица кода и инфраструктуры, которая может потреблять и создавать активы данных.
21.1 — Система, производящая данные (data-producing system)
Система, генерирующая внутренние или потребляемые активы данных. Примеры подобных ситсем: микросервисы, конвейеры ETL и т.д.
21.2 — Система, потребляющая данные (data-consuming system)
Система, потребляющая данные, - это компонент, имеющий доступ к массивам данных. Эти системы могут потреблять внутренние активы данных, созданные этой же системой, а также продукты данных, созданные другими системами.
Примеры использования
Информация, содержащаяся в данном разделе, позволит Вам лучше понять взаимосвязь между различными концепциями.
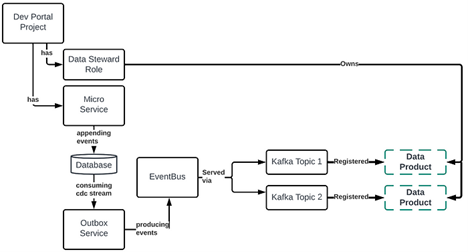
Пример № 1— Микросервис публикует события на хостинге
Данная система, производящая данные, генерирует данные о событиях, обычно описывающих конкретные бизнес-операции, которые были осуществлены сравнительно недавно. Затем микросервис публикует эти события в определенных местах хостинга, делая их доступными для использования другими системами или командами. На диаграмме, представленной ниже,упоминается "сервис outbox", который представляет собой модуль рецепта, реализующий транзакционный паттерн outbox для надежной отправки событий в распределенной и согласованной архитектуре микросервисов.
Пример № 2— Внешнее приложение публикует данные о потоке кликов на хостинге
Эта система, производящая данные, фиксирует действия пользователей в веб-приложении, такие как клики, прокрутки и события навигации. Затем приложение публикует собранные данные о потоке кликов на хостинге, предоставляя ценные сведения о поведении и предпочтениях пользователей.
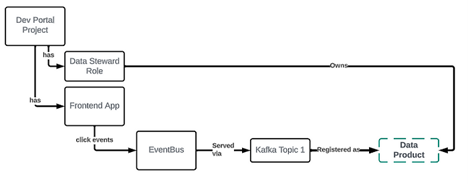
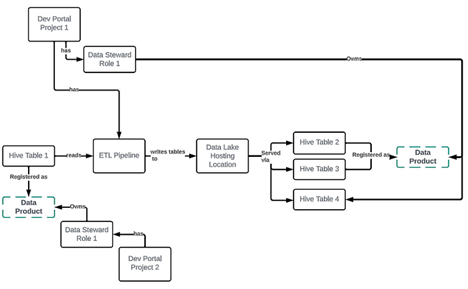
Пример № 3— Конвейер ETL преобразует существующий продукт данных для создания нового продукта данных
Эта система, производящая данные, преобразует существующие продукты данных в производные, адаптированные для каждого конкретного варианта использования. Затем конвейер перемещает преобразованные данные на хостинг, делая их доступными для дальнейшего анализа и потребления другими командами или системами.
Архитектура
Системный контекст
Следующая диаграмма иллюстрирует системный контекст модели С4 в домене data mesh (в Intuit мы официально называем этот домен "L0 Data", отсюда и ссылки на "L0 Data", присутствующие в некоторых последующих диаграммах):
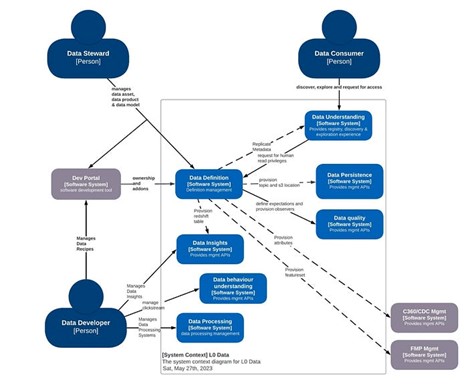
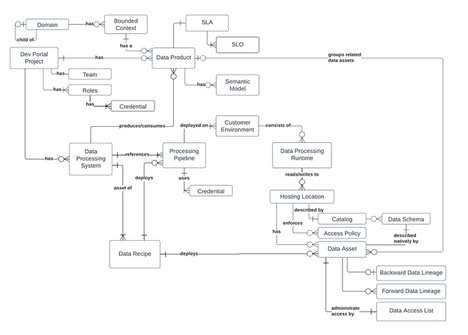
Диаграмма отношений между сущностями
На следующей диаграмме представлены ключевые понятия домена и их взаимосвязи. Эта диаграмма помогает лучше понять, как именно различные компоненты домена взаимодействуют друг с другом. Эта диаграмма служит руководством для дальнейшего изучения и уточнения базовой структуры и взаимозависимостей в домене data mesh:
Руководство по внедрению
Блокировка хостингов (lockdown hosting locations ) — платформа должна сохранять административный контроль над хостингом, чтобы доступ к данным (или его отсутствие) можно было использовать для обеспечения соответствия определенным стандартам. Как мы любим говорить в Intuit, "если Вы не следуете установленным правилам, Вы не имеете никакого права прикасаться к данным".
Разработка стандартов зрелости данных — разработайте и задокументируйте комплексную систему оценки зрелости данных, включающую описание управления схемами, моделями данных, политиками доступа, качеством данных и контролем наблюдаемости данных. Эти рамки будут служить путеводителем по продуктам данных.
Упрощение процесса регистрации данных — разработайте и внедрите архитектуру для облегчения регистрации доменов, ограниченных контекстов, моделей данных, активов данных и продуктов данных, позволяющую ответственным за данные определять и документировать свои данные. Кроме того, предусмотрите систему проверок, чтобы новые домены и новые продукты данных не противоречили и не дублировали существующие домены и продукты данных. Мы обнаружили, что дублирование продуктов данных является одной из основных причин путаницы среди пользователей, потребляющих данные, поэтому данный критерий был добавлен в стандарты зрелости данных.
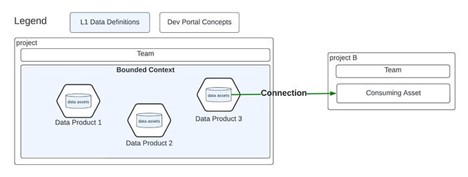
Ограниченные контексты и сущности используются для придания семантического смысла продуктам данных.
Упрощение перехода от существующих данных к активам данных и продуктам данных — Упростите процесс перехода существующих производителей данных на систему зрелости данных, предоставив им четкое руководство и интерфейсы для создания продуктов данных на основе имеющихся активов данных. Упрощение этого перехода будет способствовать соблюдению стандартов зрелости данных, которые поддерживают надежную интеграцию данных и сотрудничество между командами.
Упрощение процесса регистрации data lineage — Упорядочьте процесс регистрации data lineage для каждого продукта данных, чтобы потребители данных смогли проследить их происхождение, а управляющие - понять, как они потребляются и используются.
Упрощение интерфейсов рецептов данных для ускорения разработки данных — Для обеспечения внедрения и использования рецептов данных, разработайте интуитивно понятные и простые в использовании интерфейсы для создания, управления и развертывания рецептов данных. Эти интерфейсы должны позволять распорядителям данных, разработчикам сервисов, инженерам по данным и аналитикам легко определять и настраивать преобразования и перемещения данных, используя принципы low-code или no-code.
Поддержка обмена и сохранения внутренних данных — Предоставьте производителям данных возможность создавать и хранить безопасные и высококачественные внутренние данные на хостинге, способствуя эффективному обмену данными внутри одной команды.
На следующей диаграмме изображена прототипическая архитектура системы, производящей внутренние данные:
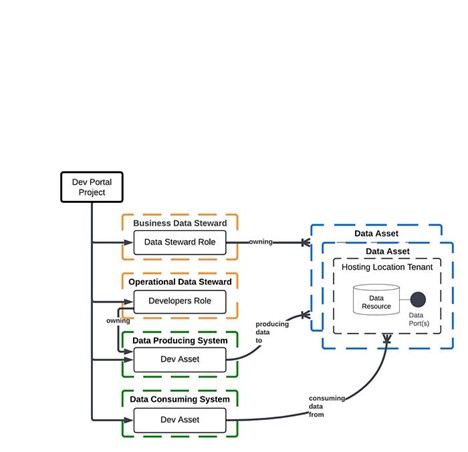
Иллюстрация того, как внутренняя система, производящая данные, обменивается данными только с системами, принадлежащими той же команде.
Применение принципа наименьших привилегий доступа — Убедитесь в том, что учетным данным сотрудника (или машины) предоставлен минимальный набор разрешений, необходимый для выполнения поставленных задач. Постоянно пересматривайте и обновляйте роли, а также разрешения пользователей, чтобы обеспечить соблюдение PLAP. Предоставление распорядителям данных простых в использовании интерфейсов и процессов, позволяющих им легко отзывать и предоставлять доступ потребителям данных, имеет решающее значение для обеспечения эффективного и безопасного управления доступом к данным.
Ключевые показатели эффективности
Для измерения положительного (или отрицательного) эффекта от внедрения data mesh был разработан следующий набор показателей эффективности.
Коэффициент соблюдения чистоты данных (Clean Data Adherence Rate, CDAR)
Эта метрика измеряет степень, в которой производители данных в компании придерживаются модели зрелости чистых данных. Данный показатель рассчитывается как отношение общего количества подключений к продуктам данных к общему количеству подключений к данным между различными командами в компании за определенный период времени. Более высокий показатель CDAR указывает на безукоризненное следование модели зрелости чистых данных, что значительно улучшает общее качество данных и снижает риск внутреннего потребления данных людьми или машинами из разных команд. Кроме того, с помощью CDAR можно определить потенциальные области для улучшения.
Эффективность управления схемой (schema management efficiency, SME)
Эта метрика отображает эффективность моделирования данных. Ее можно измерить путем мониторинга времени, затрачиваемого на задачи управления схемами, а также количества модификаций схем и степени удовлетворенности пользователей, связанных с управлением схемами.
Принцип наименьших привилегий (principle of least privileges score, PLAP)
Эта метрика оценивает то, насколько политики доступа к данным в организации соответствуют принципу наименьших привилегий доступа. Этот принцип требует того, чтобы людям и машинам предоставлялся только минимум разрешений, необходимых для выполнения требуемых задач, что значительно снижает риск несанкционированного доступа и повышает безопасность данных. PLAP оценивает соблюдение организацией данного принципа, измеряя общее количество привилегий, предоставленных учетным данным, в сравнении с фактическим использованием доступа для этих учетных данных.
Показатель блокировки хостинга (hosting location lockdown score, HLLS )
Эта метрика оценивает степень соблюдения политик контроля доступа к данным. Она рассчитывается путем сравнения количества учетных данных, которые строго придерживаются правила, позволяющего системам, производящим данные, записывать данные только в активы данных, связанные с тем же проектом, что и учетные данные и система, производящая данные, с общим количеством учетных данных, которые могут записывать данные в те же активы данных. С помощью данного показателя Вы сможете оценить эффективность применения политики доступа к данным и выявить области, которые необходимо «подтянуть» для того, чтобы обеспечить выполнение операций по чтению и записи данных надлежащим способом.
На диаграммах, представленных ниже, Вы увидите пример незаконного чтения и записи данных, который существенно снижает показатель блокировки хостинга.
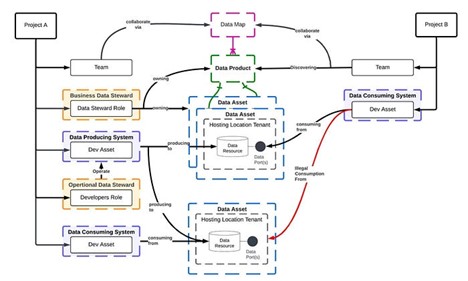
Системы, производящие данные, генерируют и хранят активы данных на хостингах. По умолчанию данные считаются внутренними, и любые несанкционированные попытки потребления данных с этих портов могут привести к удалению доступа центральной платформой. Однако потребление продукта данных всегда разрешено, поскольку продукты данных придерживаются установленных политик контроля доступа и способствуют безопасному обмену данными внутри и между командами.
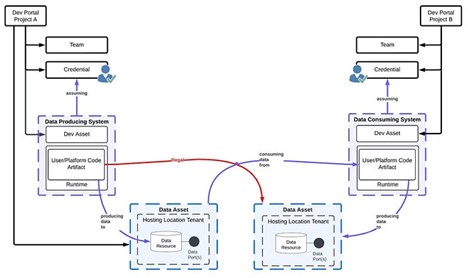
Системы, производящие данные, могут записывать данные только в связанные с проектом активы. В отличие от этого, системы, потребляющие данные, могут читать из активов данных независимо от того, какому проекту они принадлежат при условии, что владельцы одобрили официальный запрос на доступ к чтению. Красная линия обозначает доступ на запись, который запрещен при любых условиях.
Скорость разработки (Developer Velocity, DPV)
Эта метрика измеряет скорость и эффективность, с которой разработчики могут регистрировать определения данных, управлять запросами доступа и выпускать системы, производящие данные. Данная метрика особенно важна для определения общей производительности команды разработчиков и обеспечения того, чтобы архитектура поддерживала гибкость процессов разработки, позволяя командам быстро адаптироваться к меняющимся требованиям или новым задачам.
Время запроса доступа к данным (Data Access Request Time, DART)
Метрика производительности, измеряющая время, необходимое сотруднику для получения доступа к запрошенным данным. Рассчитывается как время, затраченное на обработку запроса на доступ к данным, с момента подачи запроса до момента получения разрешения на доступ. Низкое значение DART указывает на быстрый доступ к данным и более эффективный процесс управления данными в целом.
Приложение
Модель зрелости чистых данных
Модель зрелости чистых данных описывает систему рейтингов для активов данных и политику, определяющую то, как можно или нельзя использовать данные.
0 звезд (0-star)
Критерии - Данные существуют, но информация по их описанию отсутствует.
Политика использования - Обнаружению или использованию не подлежат.
1 звезда - Данные соответствует требованиям (1-star,Compliant)
Критерии - Определен владелец, есть информация, позволяющая понять его требования к безопасности данных.
Политика использования - Обнаружению или использованию не подлежат.
2 звезды – Данные под контролем (2-star, Controlled)
Критерии - те же, что и выше + наличие документации, описывающей значение данных. Данные хранятся в системе, соответствующей стандарту размещения, которая жестко контролирует условия доступа к данным.
Политика использования - Обнаружить можно, использование разрешено в исключительных случаях.
3 звезды – Чистые данные ( 3-star, Clean)
Критерии - те же, что и выше + определена подотчетность владельца данных (т. е. ему присвоено звание "управляющего данными"); соблюдаются стандарты языка моделирования; мониторинг качества данных обеспечивает эксплуатационную надежность; data linaege описывает предшествующие и последующие зависимости; процесс контроля изменений гарантирует отсутствие опасных изменений; в целом, данные готовы к использованию большой аудиторией.
Политика использования – потребление данных разрешено.
4 звезды –Чистые (4-star , Clean)
Критерии - те же, что и выше + продукт данных полностью соответствует стандартам моделирования, что значительно облегчает процесс их обработки любым количеством систем, существующих в компании.
Политика использования - потребление данных разрешено.
5 звезд – Чистые (5-star, Clean)
Критерии - те же, что и выше + точно определены связи с другими продуктами данных; продукт данных уникален и не противоречит другим продуктам данных, существующих в компании.
Политика использования - потребление данных разрешено.
Пример модели данных
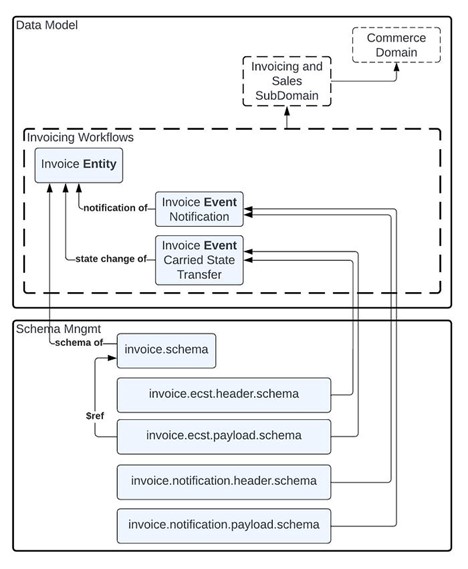
Диаграмма, представленная ниже, описывает то, как модель данных используется для моделирования домена "Invoicing Workflows".
Ограниченный контекст "Invoicing Workflows" состоит из схемы сущностей домена и двух событий: события Invoice notification - уведомление об изменении состояния Invoice, и события State Transfer - перенос всего состояния, которое изменилось.